ARTICLE · 1086677
未来的软件没有固定界面,只有为你生成的那一帧|12个前沿场景深度推演
前段时间,Andrej Karpathy(OpenAI 创始成员、特斯拉前 AI 负责人)讲了一个自己的故事。
他之前做过一个小 App,叫 MenuGen:在餐厅拍下菜单,它帮你识别每道菜,再给每道菜配一张图。为此他写了识别文字的代码,接了画图的接口,做了一套界面,搭了一个后台。
后来他看到了另一种做法:直接把菜单照片丢给 Gemini,说一句"把菜画到菜单上"。几秒钟后,模型返回一张图。还是他拍的那张菜单,但每道菜旁边,已经出现了那道菜的样子。
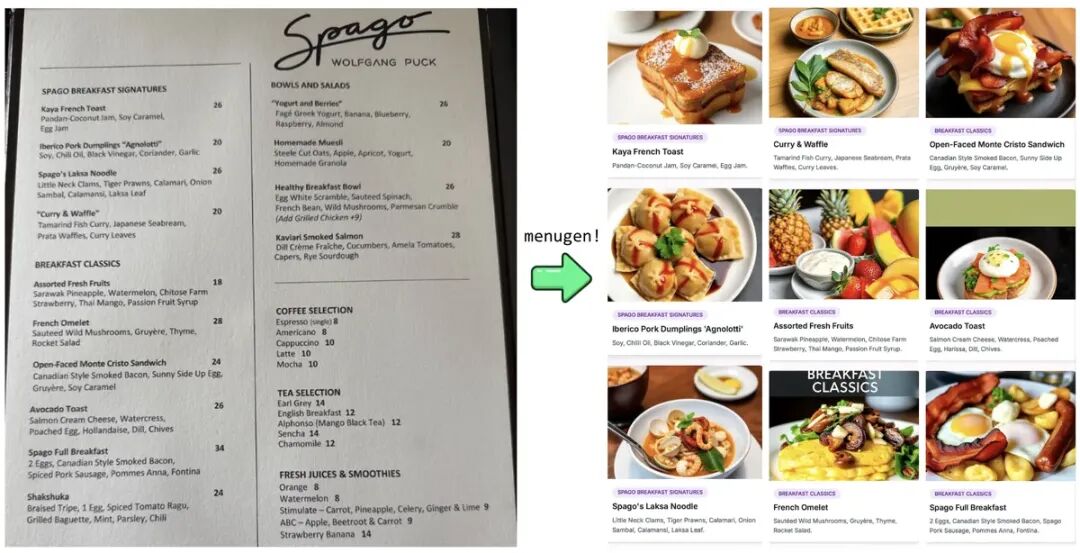
Karpathy 说这一幕让他大受震撼:"我的 MenuGen 整个都是多余的,它活在旧范式里。这个 App 本不该存在。"
这句话值得每个做软件、用软件的人想一想。按钮、菜单、页面、App,我们一直以为它们就是软件本身。其实它们只是人和机器之间的"翻译层":机器听不懂人话,所以我们发明了按钮;机器没法理解你此刻想干什么,所以设计师提前把所有可能画成了页面。
当机器能直接听懂你、直接给出结果,这层翻译会变成什么样?
先把结论放在前面:
1界面正在从"设计师提前画好的产品",变成"为你当场生成的东西"。
2生成界面有三条路:拼积木、写代码、画像素。 今天能用的是前两条,最有想象力的是第三条。
3千人千面不是换皮肤,而是界面的主导权从公司回到个人手里。
4未来使用界面最多的,可能不是人,而是替你办事的 AI。
5最后的形态是"骨架固定、血肉生成"。 常用的东西待在老地方,其余的随你而变。
下面一个一个说。
· · ·
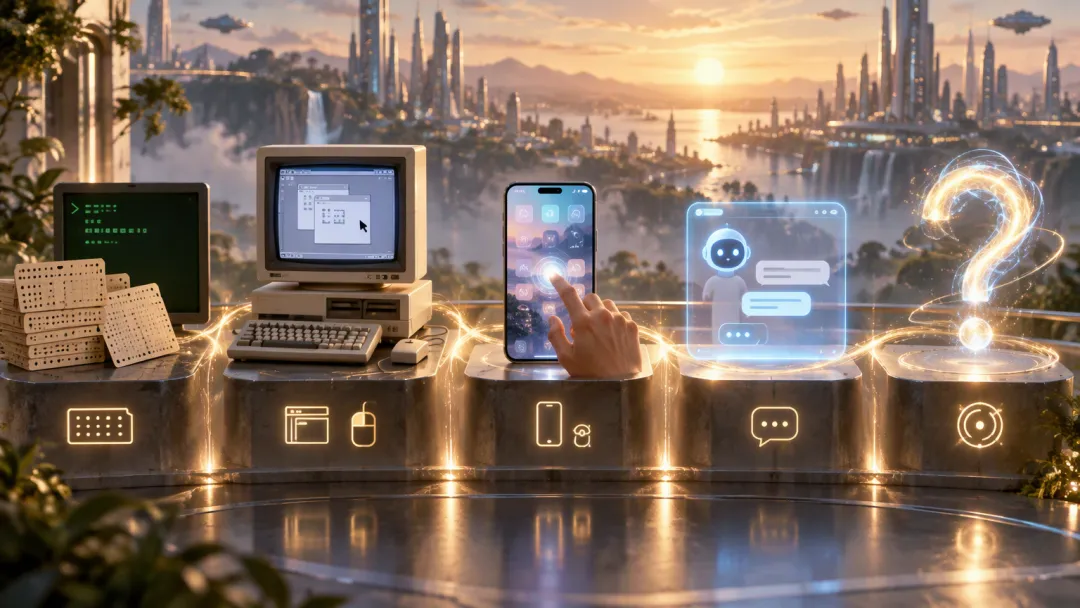
▍ 一、软件界面 50 年,只换过两次"脸"
最早的电脑,你得说机器的语言:敲命令、记参数,错一个字母就报错。这是命令行。
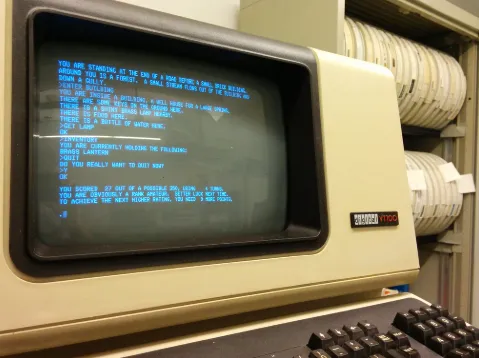
1984 年,苹果 Macintosh 把图形界面带进了普通人的生活:窗口、图标、菜单、鼠标,看见什么就点什么。之后 40 年,从 Windows 到 iPhone,本质上都是这张"脸"的变体。触屏只是把鼠标换成了手指。
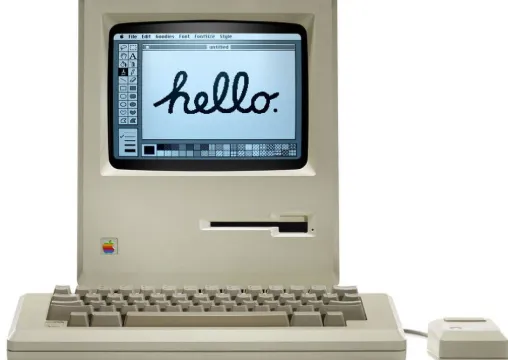
2022 年底,ChatGPT 来了。我们得到了一个聊天框。
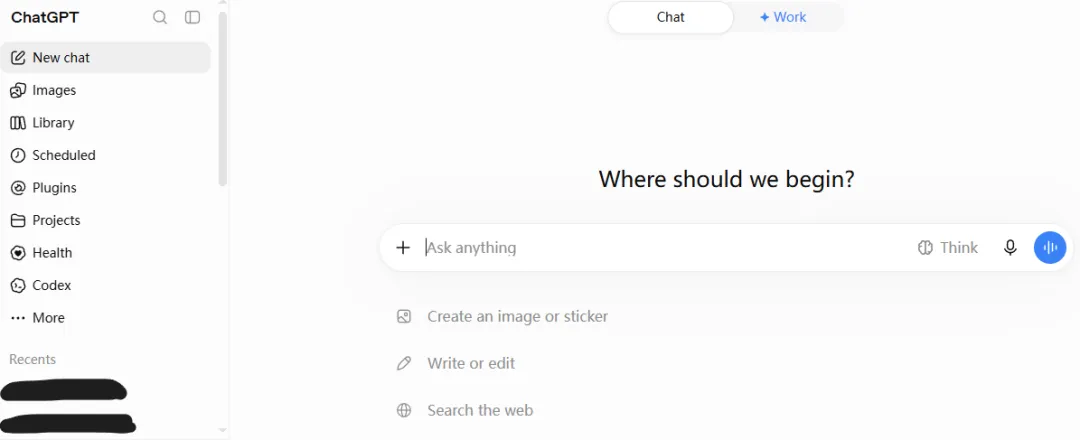
很多人觉得聊天框就是 AI 时代的界面。Karpathy 的看法正相反:他说每次在聊天框里和大模型打字,都感觉像是在用终端和一台操作系统对话。大模型相当于一种新的计算机,而我们正处在它的"1960 年代":能力惊人,界面原始,真正通用的图形界面还没被发明出来。
想想你每天用 AI 的体验:想要一个旅行计划,得到的是一大段文字;想比较三款手机,得到的是一张 Markdown 表格。Google 的研究团队在论文里直接管这个叫"一堵文字墙"。
所以,聊天框不是 AI 时代的终点,而是它的命令行。 下一张"脸"正在长出来。
· · ·
▍ 二、下一代软件界面的三条路线:拼积木、写代码、画像素
让 AI 给每个人生成界面,今天大致有三种做法。
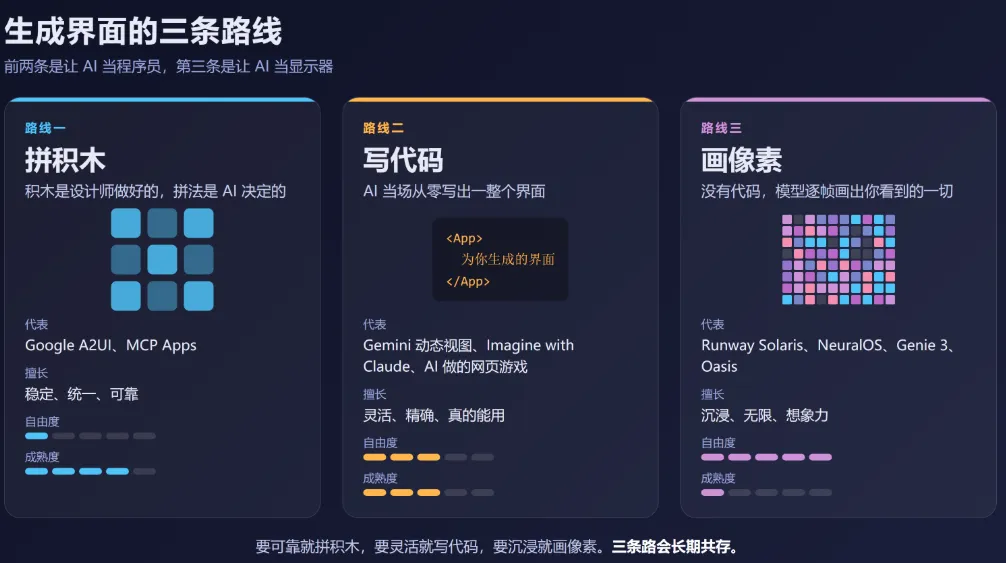
第一条路:拼积木
开发者先准备好一盒"积木":按钮、卡片、表单、图表、日历。AI 根据你的需求,决定用哪几块、怎么摆,App 再用自己原生的组件把它渲染出来。
Google 推出的 A2UI 协议就是这个思路:AI 不直接画界面,而是发出一份"搭建说明书",手机、网页、桌面端各自照着搭。2026 年 1 月正式成为标准的 MCP Apps,则让一个服务能把自己的小界面直接"嵌"进 ChatGPT 这类 AI 助手里,ChatGPT 已经支持。
打个比方:积木是设计师做好的,拼法是 AI 决定的。 好处是稳定、好看、品牌统一;局限是永远跳不出这盒积木。
第二条路:写代码
更大胆的做法是:没有积木,AI 当场从零写出一整个交互界面。
2025 年 11 月,Google 随 Gemini 3 推出了"动态视图"。你问一个问题,Gemini 不再回一段文字,而是当场设计并写出一个专属的交互页面。同样是解释"肠道微生物",给 5 岁孩子的是一个会动的卡通小世界,给成年人的是一份可以交互的科学图解。
Google 在配套论文里做了测试:如果不考虑生成速度,在 83% 的情况下,人们更喜欢这种生成出来的界面,而不是传统的文字回答;在 44% 的情况下,它的质量已经能和人类专家做的页面打个平手。更关键的发现是,这种能力是"涌现"的:老一代模型做不好,新一代模型突然就会了。
Anthropic 在 2025 年 9 月做过一个更激进的实验,叫 Imagine with Claude:没有任何预先写好的功能,你点哪里,Claude 就当场把那里的软件"长"出来。
说到这里,要讲清一个很多人误会的事。最近 X 上刷屏的那些 AI 游戏,比如 Opus 5 做的第一人称射击游戏、一句话生成的《我的世界》复刻版,画面惊艳,但它们不是模型"画"出来的视频,而是模型写出来的代码。
以网友做的射击游戏 Claude of Duty 为例:大约 5.5 万行代码,没有用任何一张外部图片、一个外部模型或一段外部音频。地形是算出来的,材质是着色器代码,连声音都是现场合成的。另外,"一句话生成"背后往往有大量打磨:一个沙漠探索游戏的作者说,他的初始提示词只贡献了最终效果的两成,整个项目做了约 14 个小时、花了约 500 万个 token;一个《我的世界》复刻版消耗了 2500 万个 token。
这条路的好处是精确:文字清晰,按钮真的能按,逻辑真的能跑。局限是慢,Google 自己承认生成一次有时要一分钟以上,而且每次生成都像完成一个小项目。未来随着模型生成速度的提高,这一局限也将不再存在。
第三条路:画像素
第三条路最科幻:没有代码,没有按钮,没有网页。 模型看着你的鼠标、键盘和手指,直接预测下一帧画面应该长什么样。
这条路先在游戏里被走通了。2024 年,Google 的 GameNGen 用神经网络"跑"起了经典游戏《毁灭战士》(DOOM);同年 10 月,Decart 发布的 Oasis 实时生成了一个《我的世界》式的世界,每秒 20 帧,官方原话是"没有物理引擎,只有一个基础模型";微软随后在 Copilot Labs 里放出了一个完全由模型生成、可以实时玩的《雷神之锤 II》。
然后,它开始进入软件界面。
入选 ICLR 2026 的 NeuralOS 用大量 Ubuntu 桌面的操作录像训练出一个模型,它能根据你的鼠标和键盘,"画"出整个操作系统:打开窗口、启动程序,全是预测出来的像素。研究者甚至教会了它"运行"一个根本没装过的程序。
2026 年 8 月 31 日,Runway 发布了 Solaris,称之为第一个"界面世界模型"。它提出的问题是:如果操作系统在你使用的同时,把 App 和网站生成出来,会怎样? 它的分工很有意思:一个大语言模型负责决定"接下来应该发生什么",一个世界模型负责把这件事"画"成每一帧。目前 Solaris 还处在申请试用阶段。
一句话总结三条路:前两条是让 AI 当程序员,第三条是让 AI 当显示器。
它们不会互相取代,就像今天网页、原生 App 和游戏引擎各司其职一样:要可靠就拼积木,要灵活就写代码,要沉浸就画像素,但很有可能今天的边界在未来被打破。
· · ·
▍ 三、千人千面,"千"的到底是什么
说到"千人千面",很多人想到的是换主题、换头像、首页推荐不一样。那只是表层。
第一层:结构不同
同一个产品,新手需要引导、更少的按钮、更大的提示;老手想要密集的数据、快捷键和高级筛选。过去只能一刀切,给所有人同一套界面,然后指望新手自己去看教程。
生成式界面改变的是结构本身:该出现哪些功能、信息密度多大、操作分几步,都可以因人而异。就像前面那个例子,给孩子和给成年人讲微生物,不只是用词不同,而是完全不同的两个"应用"。
第二层:主导权反转
更深的变化,是界面由谁说了算。
用户体验领域的泰斗 Jakob Nielsen 有一条著名的"雅各布定律":用户大部分时间都在别人的网站上,所以你的网站最好和别人的一样。过去几十年,是用户去适应每家公司的界面。
在 2026 年的一篇文章里,Nielsen 提出了一个反过来的设想,叫 "自带界面"(Bring Your Own Interface):你的 AI 助理学会了你的习惯,比如导航放哪、表格怎么排、"撤销"对你意味着什么,然后把每一个服务都渲染成你熟悉的样子。你的肌肉记忆不再依赖厂商别乱改按钮,因为你的界面跟着你走。
Nielsen 的评价是:这将是自图形界面诞生以来,界面主导权从公司转向个人的最大一次迁移。
但不是什么都该变
Nielsen 同样清醒。2026 年年中复盘自己的年度预测时,他给"生成式界面取代静态软件"这一条打了 47 分:生成式界面在新手引导、数据看板、搜索小组件这些场景里很成功,但专业软件依然依赖固定布局。如果一个常用按钮每天换个位置,没人受得了。生成式界面最大的挑战是人类的习惯。
所以,更合理的形态是:骨架固定,血肉生成。 就像一座城市,道路和地铁线不会天天变,但街边的橱窗每天都可以不一样。高频的操作待在老地方,低频的、跟情境有关的部分,按你此刻的需要当场生成。
· · ·
▍ 四、软件界面最大的用户,可能不是人
这是一个很少被讨论、但可能最重要的变化。
Karpathy 说,数字世界现在有了第三种"用户":人用图形界面,程序用 API,而现在多了 AI 智能体,一种"像人一样的计算机"。它会像人一样看网页、点按钮、填表单,但速度快得多,数量也多得多。
数据已经在说明这件事。安全公司 HUMAN Security 的 2026 年报告显示,智能体流量一年增长了约 7851%。Google 的 Chrome 从 2026 年 1 月起在电脑上提供"自动浏览":Chrome 可以自己浏览、点击、填表,替你完成多步骤任务;6 月底,这项功能来到了安卓手机。Google 还推出了 WebMCP,让网站直接把"下单""查库存"这类功能以工具的形式交给浏览器里的 AI,而不是让 AI 去猜按钮在哪。
这意味着,软件会长出两张脸:
●一张给机器:结构清晰、稳定可靠,让 AI 能准确调用;
●一张给人:按需生成,只在你需要看、需要决定的时候出现。
就像一家餐厅,后厨讲究标准流程,前厅讲究让客人舒服。以后每个软件都会有自己的"后厨"和"前厅"。
那么,人在界面上做什么?Nielsen 的判断是:人的角色从"操作员"变成了"监工"。 你不再一步步点击,而是说出想要的结果,让 AI 去规划和执行。他把未来的界面分成三层:
1意图层:你说想要什么。它会越来越懂你,甚至根据你的日程和习惯,提前把请求草拟好,你只需要点头。
2编排层:AI 把计划摆出来给你看、征求你同意;做完之后,给你一张"回执":改了什么、用了哪些信息、哪些还能撤销。
3直接操作层:传统的按钮和菜单并没有消失,它们退到后面,当你想亲手调整时随时可用。
Karpathy 补充了另一个角度:图形界面反而变得更重要了。因为 AI 负责生成,人负责确认,而"看"比"读"快得多,图形是通往大脑的高速公路。他还提出了一个很形象的设计:"自主性滑杆"。就像钢铁侠的战衣,可以只帮你增强力量,也可以完全自主行动;放手多少,由你来拨。
所以,未来屏幕上最常用的,也许不是"开始"按钮,而是"批准"和"查看回执"。
· · ·
▍ 五、从屏幕走进世界
界面还有一个更大的变化方向:它不再只待在一块屏幕里。
2025 年 8 月,DeepMind 发布了 Genie 3:输入一句话,它就生成一个可以实时漫游的世界,720p 分辨率、每秒 24 帧,能保持几分钟的连贯。你还可以边走边改:"下雨吧",天就下雨;"来一只鹿",鹿就从树林里跑出来。要知道,2024 年初的第一代 Genie 还只能生成低分辨率的 2D 小游戏,前后只用了一年半。2026 年 1 月,Google 已经把基于它的原型开放给了部分付费用户。
李飞飞创办的 World Labs 走的是另一条路。2025 年 11 月,他们开放了 Marble:用一句话、一张照片或一段视频,生成一个可以保存、编辑和导出的 3D 世界。生成的世界可以直接用 VR 进入,在 Apple Vision Pro 上打开浏览器就能走进去。2026 年 1 月,他们又开放了 World API,任何开发者都能把"生成一个世界"做进自己的产品。
另一头,眼镜正在变成新的屏幕。Meta Ray-Ban Display 在镜片里藏了一块小显示屏,配一个能读取手腕肌肉电信号的腕带:手放在口袋里,捏一捏手指就能操作。Google 说安卓 XR 是"第一个诞生于 Gemini 时代的安卓平台",眼镜上的 AI 能看懂你眼前的东西,并替你采取行动。
有一个细节很有意思:给眼镜设计界面时,Google 要求开发者背景必须是纯黑色。因为在透明镜片上,黑色等于"透明",任何别的颜色都会挡住真实世界。界面设计的基本规则,已经在被改写。
这一切指向同一个方向:"应用"会变成"场景",界面会溶解进环境里。 图形界面的核心隐喻是"窗口",你透过它看数字世界;空间界面的核心隐喻是"地方",你直接走进去。
当然,这还是早期。Genie 3 目前的"记忆"大约一分钟,眼镜上的应用也还不多。但正因为早,想象的空间才足够大。
· · ·
▍ 六、脑补一下:你每天用的软件,10 年后长什么样
前面讲的都是趋势,趋势总是有点抽象。我们换个玩法:把你手机和电脑里最常用的 12 个软件挨个拎出来,想象当"会生成界面的 AI"、"世界模型"和"随身 AI 助理"都成熟之后,它们会长成什么样(欢迎在评论区留言,分享你对未来软件的想象)。
先立一个规矩:凡是今天已经能做到的或者做成熟的,都不算。
· · ·
1. 微信:聊天记录,变成一个可以回去的地方
今天:聊天是一条往上滚的文字流。约个饭,群里来回拉扯半小时。
未来的一天:
周三晚上,你在六个人的大学群里说了一句"周五聚一下?",然后就去忙别的了。
每个人的 AI 助理在后台碰了个头:老张周五加班到八点,小李最近在控糖,阿May 只方便在地铁 2 号线附近。十秒钟后,群里长出一张卡片:三家餐厅、一个时间、人均预算。
你点开第二家,不是翻照片,而是直接"走"了进去。那是世界模型根据店铺照片生成的空间,你能看到靠窗那张大桌傍晚的光线。六个人的头像浮在这个空间里,谁点了"就这家",谁的头像就坐到桌边。
聚完饭,群里多出一个"回忆":用当晚大家拍的几十张照片生成的立体场景。半年后你想起那一晚,点进去,还能绕着那张桌子走一圈。
群里的妈妈呢?同一场对话,在她那边自动变成大字号和语音按钮。她什么新功能都不用学。
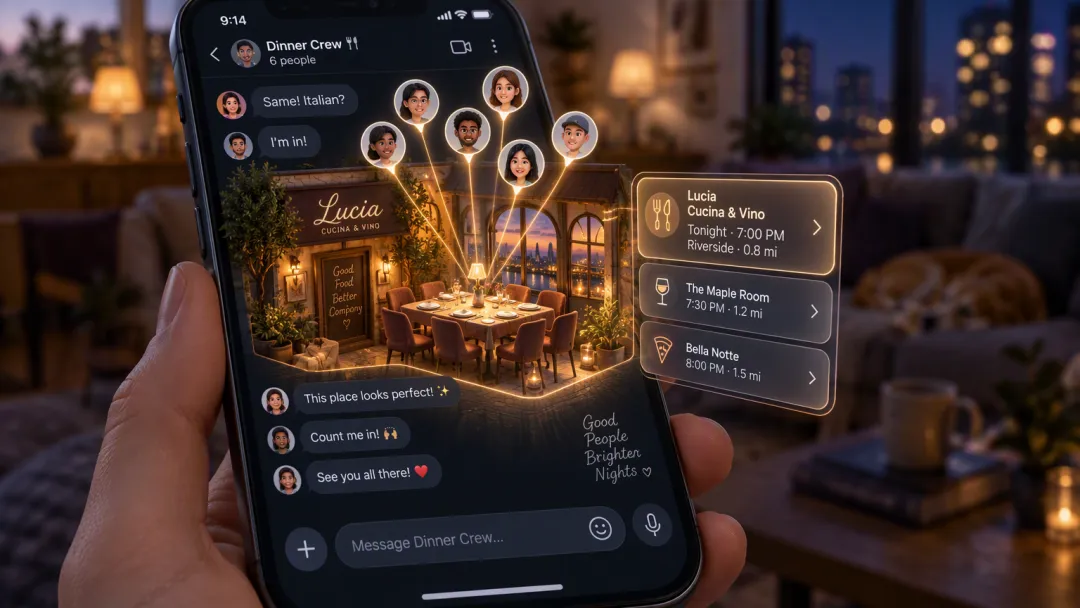
交互变化:从"在群里聊着把事办了",到"说一句话,各自的 AI 把事办完";照片从一张平面,变成一个可以回去的地方。
· · ·
2. 小红书:从"种草",到"先活一遍"
今天:刷笔记、点收藏。收藏夹里躺着三百篇大理攻略,真到了大理,一篇也想不起来。
未来的一天:
你收藏的三百篇笔记不再是一个列表,而是被 AI 融合成了一座"你的大理":每篇笔记是这座城里亮着的一盏灯。
出发前一晚,你花五分钟把三天行程"先活一遍"。清晨走进洱海边那家民宿,世界模型按你出发那一周的天气,渲染出湖面上的晨雾;中午那家被夸爆的菌子火锅,门口会不会排长队,AI 用往年同期的数据帮你模拟出来。你觉得第二天太赶,直接把"喜洲古镇"那盏灯拖到第三天,整条路线跟着重排。
穿搭笔记也不再是商家和模特的身材。点一下,那套衣服就穿到了你的数字分身上,在你家的穿衣镜前转一圈给你看。
更有意思的是反过来。旅行回来,你不用绞尽脑汁写笔记了:AI 把你三天拍的东西整理成一篇别人能"走进来"的空间笔记,你只需要决定分享哪几个角落。
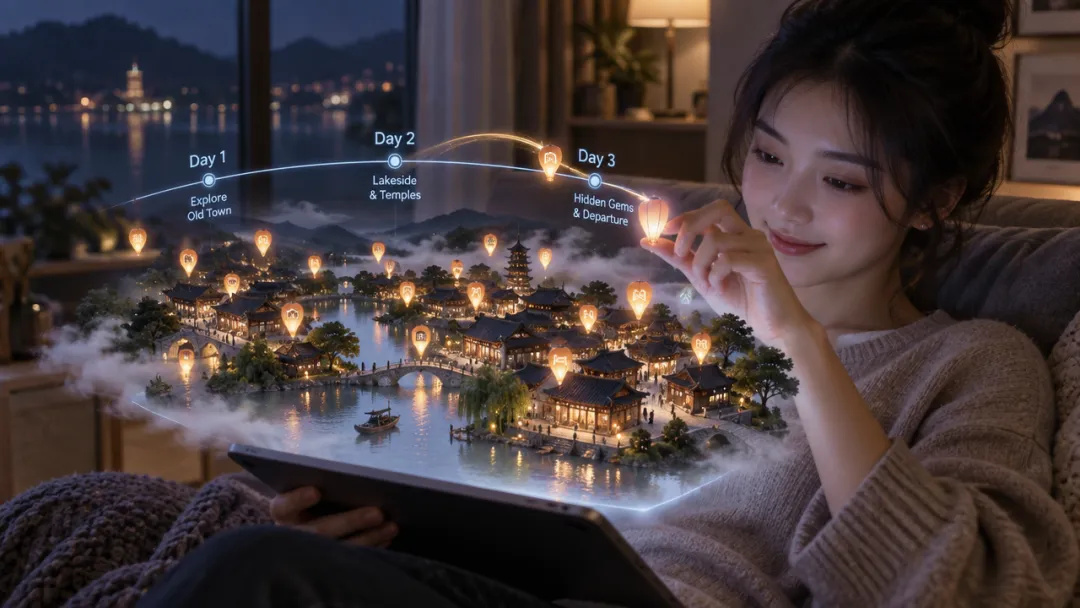
交互变化:从"看别人的生活",到"先试一遍自己的生活"。
· · ·
3. 淘宝 / 京东:货架消失,你家就是样板间
今天:搜索、筛选、比价、翻评论。一张沙发比一个星期,买回来发现颜色和客厅不搭。
未来的一天:
你拿手机绕客厅扫一圈,你的家就有了一个"数字孪生",也就是一个一模一样的虚拟副本。
你说:"想换个沙发,五千以内,家里有猫。"
你的购物助理出门了。它去和几百家店铺的 AI 导购谈:哪款面料抗猫抓,哪家周六前能送到,能不能再便宜两百。
你看到的不是一页商品列表,而是你自己的客厅,里面已经摆好三个候选沙发,可以一个个"换上"。戴上眼镜,你坐下去,看看从沙发上看电视的角度对不对。下午四点的阳光打在那块燕麦色布料上,比任何商品图都真实。
想要的颜色没有?"那就做一个。"设计当场生成,直接下单给工厂。这张沙发,全世界只有你家有。
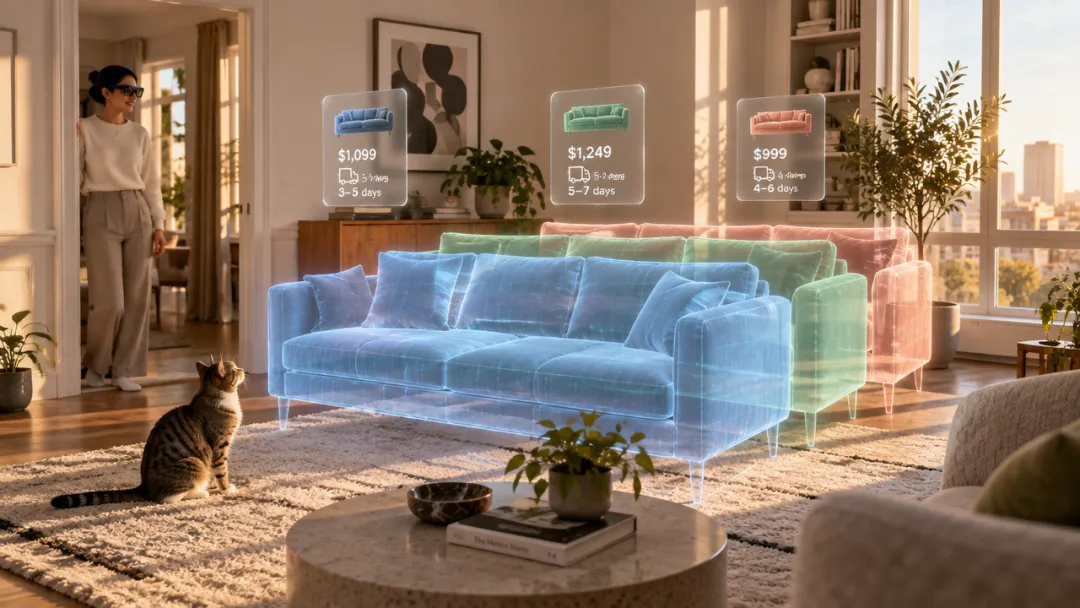
交互变化:从"人去逛货架",到"货走进你家";讨价还价交给两边的 AI。
· · ·
4. 抖音:从"刷视频",到"走进视频"
今天:手指一滑,下一个。
未来的一天:
你刷到一条京都小巷的旅行视频,觉得好看,按住屏幕。视频停住,然后"打开"了:你可以离开博主的镜头,自己拐进旁边那条巷子,看看巷子尽头是什么。那里原本没有被拍到,是世界模型"续写"出来的。
短剧也变了。男主正要做出那个愚蠢的决定,你说一句"别去",剧情就在你这里拐了个弯,之后每一集都是为你一个人实时演出来的。你还可以把自己放进去,当那个配角。
同一条爆款视频,一百万人走进去,走出了一百万条不同的路。创作者做的不再是"一条视频",而是"一个可以被探索的世界"。
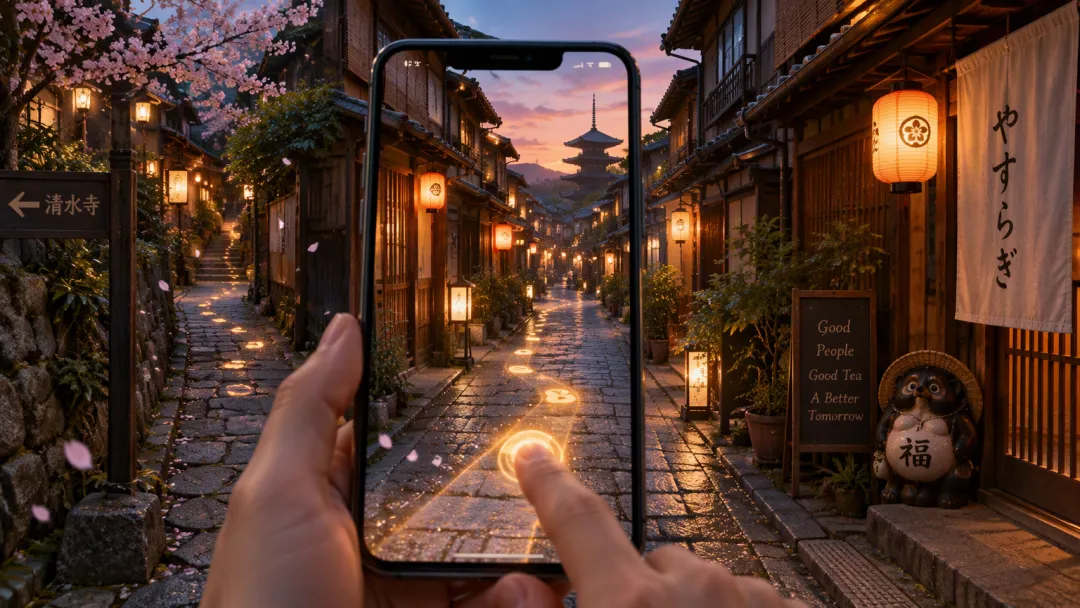
交互变化:从"看"到"进入",从"看完"到"演下去"。
· · ·
5. 王者荣耀:每个人都带着一支 AI 小队
今天:五个陌生人,一张固定的峡谷地图,打完一局看一眼数据。
未来的一天:
开局前,你像配铭文一样,给自己带上三个 AI 助理:
●教练:只在你耳边说话。"对面打野五秒前在上路消失了,别压线。"它会在你视野里画出一条半透明的"最优走位"虚影,想跟就跟,不想跟就关。
●替补:队友掉线了?他的 AI 助理立刻接管,按他平时的打法和英雄习惯继续打。再也没有"4 打 5"。
●参谋:团战前把整张地图拉成沙盘,推演三种开团方案的胜率。你喊一句"打龙",全队的 AI 同步调整站位。
更激进的模式里,一个真人带四个 AI 英雄,五个真人各带一支 AI 军团互相对抗。你从"操作一个英雄"变成了"指挥一支队伍"。
每个人的界面也不一样。新手屏幕上按钮少、提示多;老玩家的屏幕干干净净,只留技能和小地图。
峡谷也不再是那张一成不变的地图:每局由世界模型现场生成地形和天气,下雨天草丛更深,视野更短。打完之后,回放是一个可以走进去的 3D 现场。你可以站到对面打野的位置,看看他当时看到了什么。
还有一个彩蛋:和"巅峰期的自己"打一局。AI 用你三年的对局数据,复刻出那个赛季最强的你。
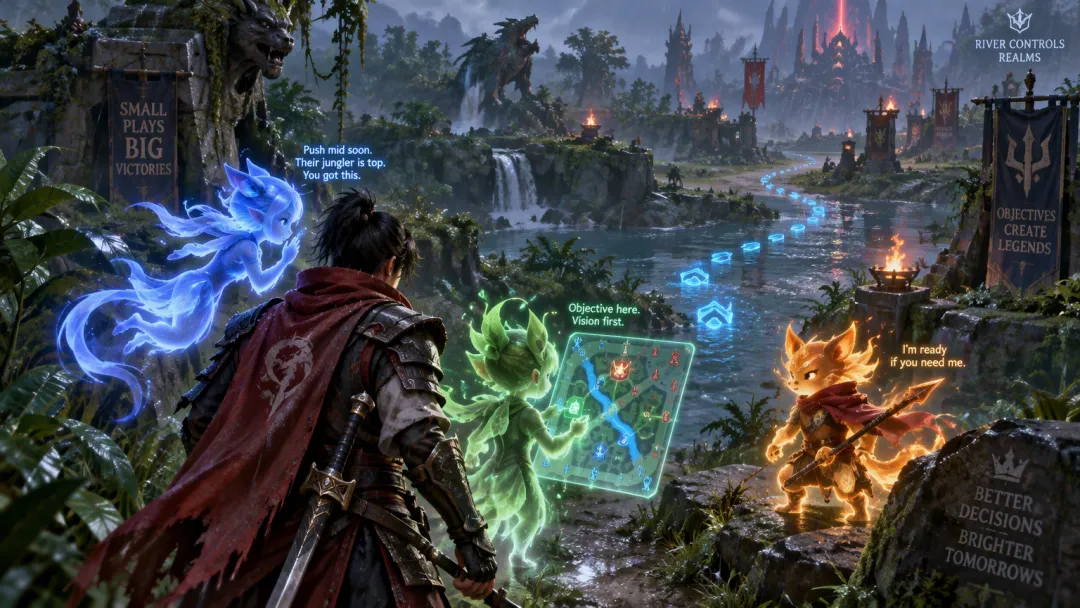
交互变化:从"一个人操作一个英雄",到"一个人带一支 AI 小队"。
· · ·
6. 高德地图:出发之前,先把路走一遍
今天:盯着手机上的蓝色箭头,在十字路口原地转圈找方向。
未来的一天:
第一次去一座陌生城市开会。前一晚,你在酒店里把明早的路线"走"了一遍:世界模型根据街景生成了那条街,你看清楚了地铁出口出来是一家便利店,右转过天桥,写字楼的正门其实在侧面。(DeepMind 的 Genie 3 已经在用谷歌街景数据来"锚定"它生成的世界。)
第二天早上戴上眼镜,路线直接画在路面上,写字楼正确的那扇门在远处微微发光。
出行目的不同,地图也完全不同。赶时间时,界面只剩一条线和一个倒计时;周末闲逛时,它会轻声说:"左边小巷里有家开了四十年的面馆,绕过去只多走三分钟。"
开车更彻底。车里的 AI 提前和停车场的 AI 订好了车位,导航的终点不是"某某大厦",而是"B2 层 137 号车位"。
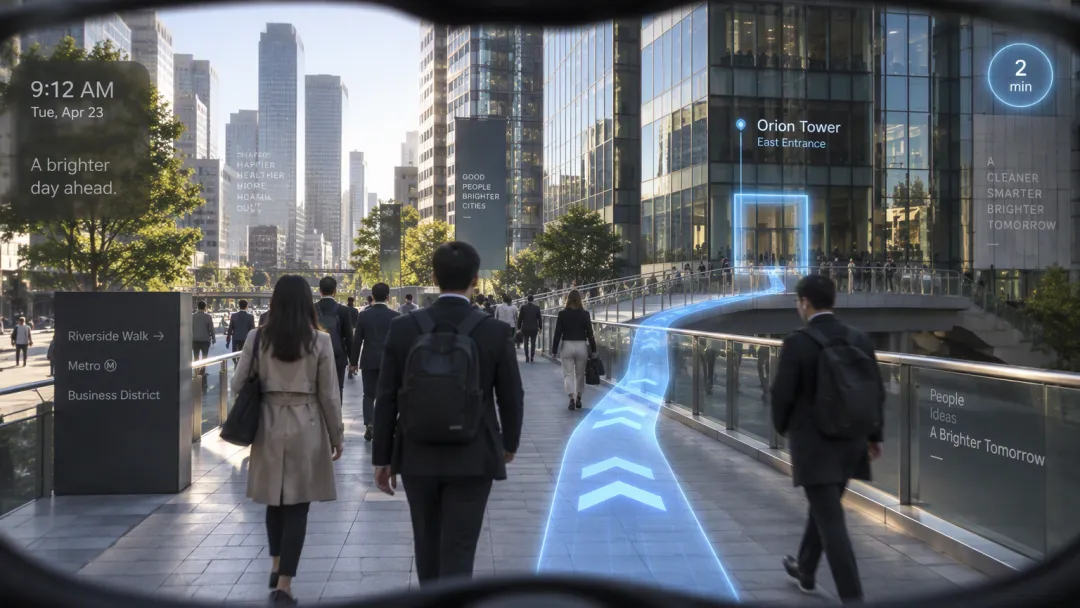
交互变化:从"看地图找路",到"路就画在眼前"。
· · ·
7. 携程 / 12306:整个旅程,只剩一条可以拖动的时间线
今天:机票、酒店、高铁、门票分散在四个 App 里,改签一次,重新操作一遍。
未来的一天:
你告诉助理:"国庆带爸妈去趟西安,他们腿脚不太好。"
你看到的不是搜索结果,而是一条时间线:五天,每天几个节点。每个节点都能点进去"预览"。酒店房间可以走进去看看卫生间有没有扶手,去兵马俑那天的人流会被模拟成一段画面。你把第三天整块拖到第四天,所有票自动跟着改。
旅途中高铁晚点四十分钟。你还没收到通知,助理已经把接站的车改了时间,把晚饭订位往后推了一小时。你唯一看到的界面,是一张"已处理"的回执:改了什么、多花了多少钱、哪些还能撤销。
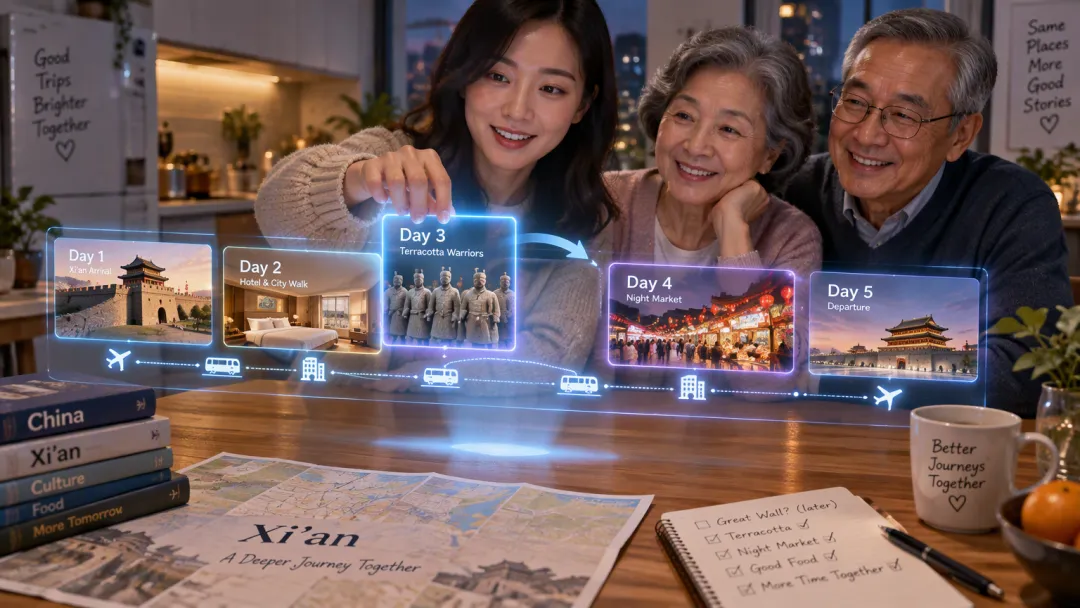
交互变化:从"在四个 App 之间来回操作",到"只看计划和回执"。
· · ·
8. Excel / WPS:表格背后,是一座可以走进去的仓库
今天:库存表几千行。盘点时,拿着打印出来的表格,一格一格对。
未来的一天:
你打开库存表,点一下"进入仓库"。表格翻转成一座仓库的数字孪生:每个货架、每个格子都和表里的一行一一对应,数据来自仓库里的摄像头和传感器,是实时的。
账实一致的货架是安静的灰色,数量对不上的格子在发红光。仓库内的机器人走到 C 区第三排,发现那一格"蓝色保温杯"账上 120 个,摄像头只数到 96 个。你点一下,现实仓库里的巡检机器人开过去复核,二十秒后传回一张照片:有两箱被错放到了 D 区。你在虚拟仓库里把那两箱"拖"回 C 区,现实中的机器人就去搬。
一年一度的大盘点,变成一个下午在虚拟仓库里散步。
财务模型也一样。你说"如果原材料涨价 10%",整个公司的沙盘就分叉出一个平行世界。现金流像河流一样在里面流动,哪条支流会先变细,一眼就能看见。
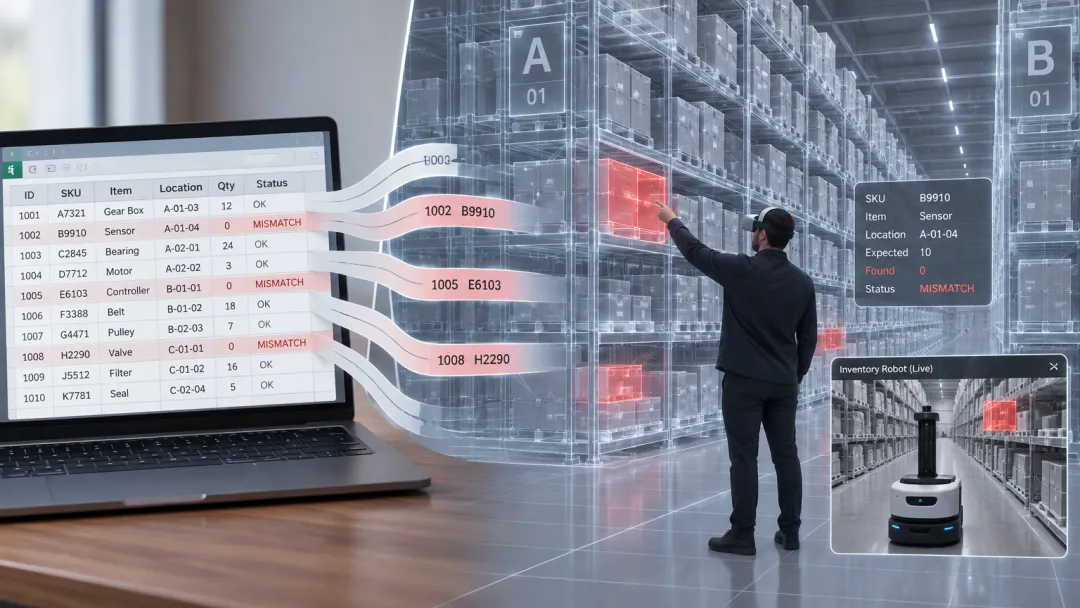
交互变化:从"对着数字想象现实",到"走进现实核对数字"。
· · ·
9. Photoshop / 美图秀秀:照片拍完了,机位还能再换
今天:修图,就是在一张平面上涂涂抹抹。
未来的一天:
照片不再是一张平面,而是一个被"冻结"的场景。
你给朋友在海边拍了张照,回家发现角度不好。没关系,你"走进"照片,往左挪两步,重新取景。(World Labs 的 Marble 今天已经能从一张照片生成一个可以走动的 3D 世界。)太阳太硬?把太阳拖低一点,变成傍晚。朋友闭眼了?让她睁开,因为模型记得这个场景里的她。
设计师的工作也变了。给客户做一张海报,AI 会生成一群"模拟观众",你能看到他们的视线先落在哪里、在第几秒划走,改完再看一遍。
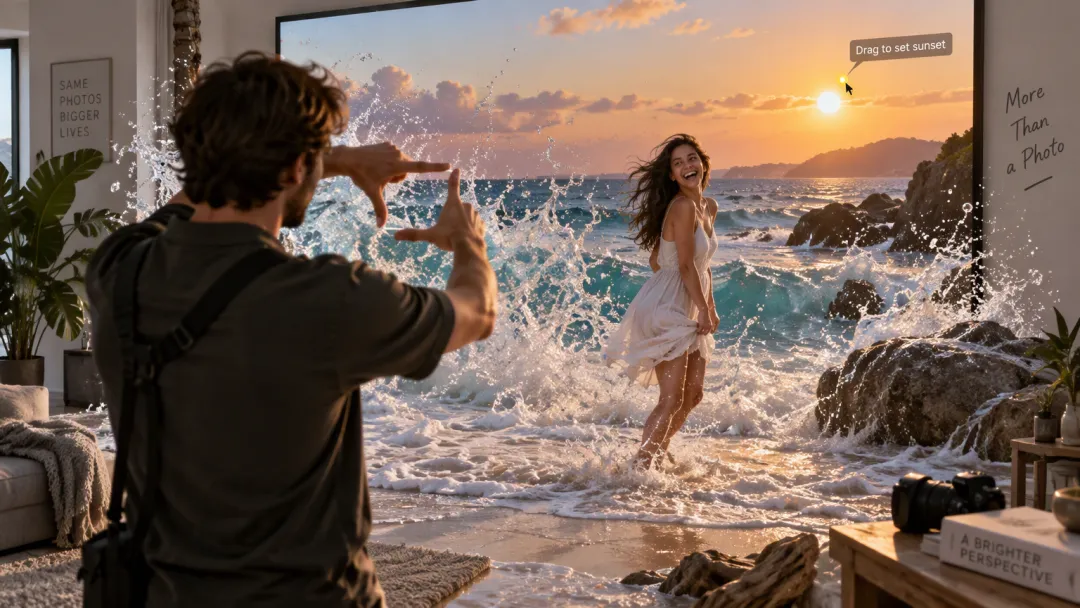
交互变化:从"修一张图",到"重拍一个场景"。
· · ·
10. 浏览器 / 搜索:网页消失,每个网站都长成你习惯的样子
今天:每个网站一套布局。每次搜索,要么十条蓝色链接,要么一段 AI 总结。
未来的一天:
你不再"访问"网站。你的 AI 助理替你去访问,再把内容按你的习惯重新摆一遍:所有购物网站的"退货"都在同一个位置,所有新闻都按你喜欢的密度排版;给视力下降的父亲用,字号自动放大。这就是 Jakob Nielsen 说的"自带界面":不是你去适应每个网站,而是每个网站来适应你。
搜索也不再是十条链接。你问"罗马帝国为什么会衰落",得到的是一条可以走进去的时间走廊:左手边是公元 100 年的罗马广场,右手边是公元 400 年的同一个广场,一位历史学家陪你边走边讲。你随时可以打断他:"那时候一块面包多少钱?"
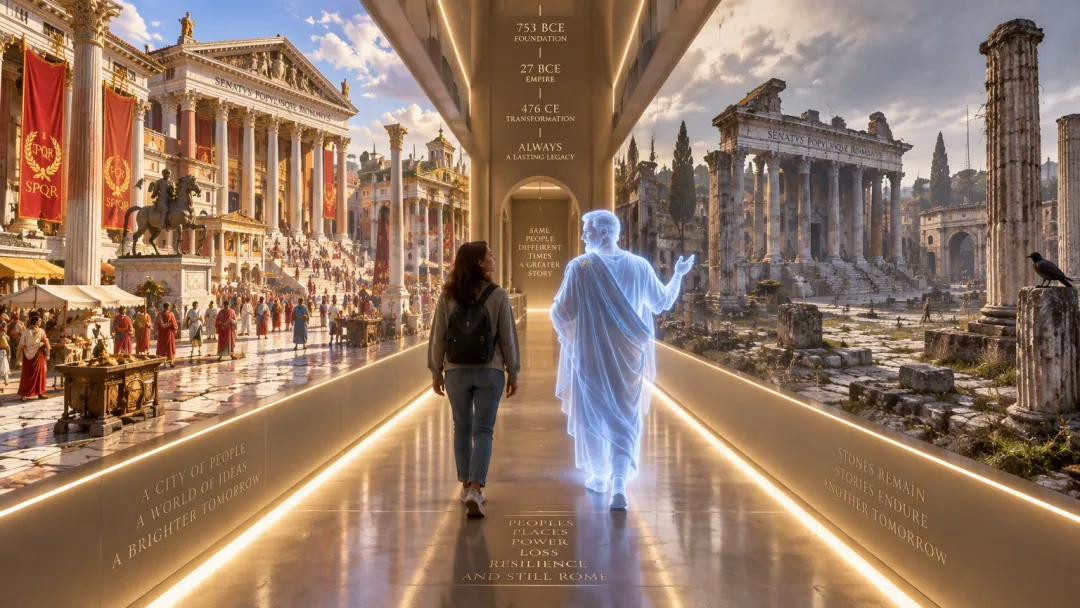
问一个真正复杂的问题,比如"我该不该在这座城市买房",你会看到一间"作战室":几个 AI 研究员正在分头查政策、查房价、查通勤时间。你可以走到其中一个身边,看它查到了什么,给它换个方向。
交互变化:从"人去找信息",到"信息按你的方式来找你"。
· · ·
11. Windows 桌面:没有图标的桌面
今天:满屏图标,几十个窗口,开会前找一份文件要十分钟。
未来的一天:
早上开机,桌面上一个图标都没有。电脑问你:"今天先做什么?"
你说:"准备下午的季度汇报。"
屏幕当场"长出"一个工作间:上季度的数据、三封相关邮件、同事昨晚改过的 PPT、下午要见的三个人的资料,按你最顺手的方式摆好。这不是打开了哪个 App,而是为这件事现场生成的界面。(Runway 今年 8 月发布的 Solaris,就是在逐帧生成这样的界面,背后没有一行界面代码。)
做到一半,你说:"我需要一个工具,把这三份合同的条款差异对比出来。"一个世界上原本不存在的小软件出现了,用完就消失。软件变成了一次性的,像纸巾一样。
戴上头显,这个工作间就成了一个真正的房间:数据贴满一面墙,PPT 悬在面前,同事的分身坐在对面。
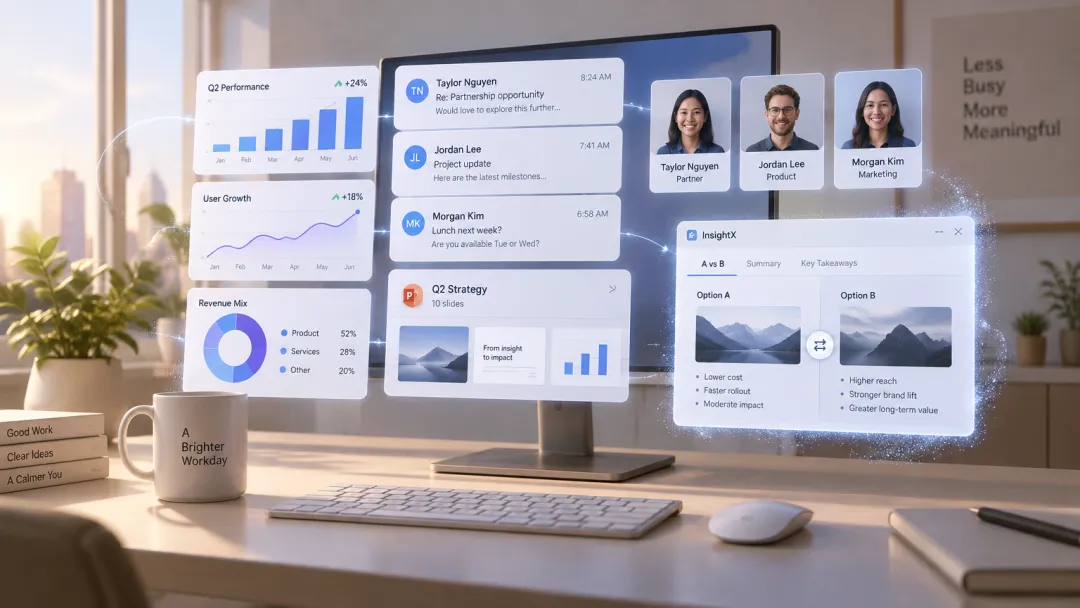
交互变化:从"先找到软件,再做事",到"说出要做的事,软件当场长出来"。
· · ·
12. 多邻国:学西班牙语,就去马德里的咖啡馆
今天:连线题、选择题,一只绿色猫头鹰每天催你打卡。
未来的一天:
你的第 30 课,是走进马德里街角的一家咖啡馆。
服务员是世界模型生成的,她记得你上周来过,会因为你点错了单露出困惑的表情,也会在你卡住时悄悄放慢语速。你的水平越高,店里越热闹:邻桌开始聊足球,老板凑过来讲一个你只听懂一半的笑话。
走在真实的街上,戴着眼镜,路边的招牌和菜单会悄悄浮现出你还没学会的单词。今天学的词,明天就在现实里遇见。
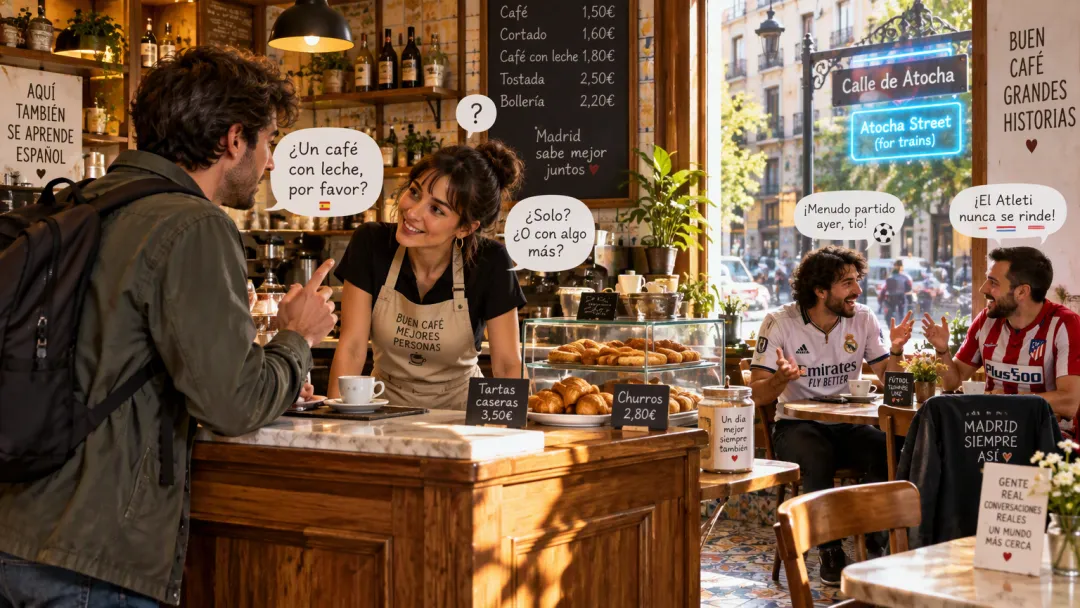
交互变化:从"做题",到"住进那门语言里"。
· · ·
小结:12 个未来,其实是 3 件事
把这 12 个场景放在一起,会发现它们说的其实是同样三件事:
1从"看"到"进入"。 视频、照片、笔记、表格,背后都变成了可以走进去的空间。
2从"操作"到"委托"。 你说出目标,各自的 AI 去谈、去跑、去办,你只看计划和回执。
3从"一个界面"到"每人一个界面"。 同一个群聊,妈妈和你看到的不一样;同一局游戏,新手和老手看到的不一样。
过去,我们花大量时间学习怎么使用软件。接下来,软件要学的是怎么变成你需要的那个样子,而不只是设计者想要的样子。
· · ·
▍ 七、还差几步
上面这些场景,有的两三年内就会出现,有的还要更久。它们之间隔着几道技术门槛,而每一道都在被快速跨过。
第一步:速度。 Google 的生成式界面,生成一次有时要一分钟以上;而要"画像素",模型必须每 0.04 秒左右生成一帧。Decart 在发布 Oasis 时算过一笔账:当时主流的视频模型生成 1 秒视频要 10 到 20 秒,实时交互需要快 100 倍以上。他们靠专门的推理优化做到了,专为这类模型设计的芯片也在路上。MiniMax H3权重开放以后,社区已经可以做到用1.653 秒生成5秒768P音画同步的视频,随着技术的进步,未来生成速度将不再是挑战。
第二步:记忆。 Genie 3 的世界能连贯几分钟,能记住大约一分钟前发生的事。要支撑一个你每天都用的软件,这远远不够。但别忘了,从只能生成 2D 小游戏的 Genie 1,到能实时漫游 3D 世界的 Genie 3,只用了一年半。随着模型和智能体记忆能力的不断升级,记忆的瓶颈将会被解决。
第三步:精确。 像素世界目前最不擅长的,恰恰是软件最需要的东西:清晰的文字、精确的输入、每次都一样的行为。NeuralOS 的研究者承认,精确模拟键盘输入仍然很难。所以近期最可能的形态是混合:文字和关键操作交给代码,空间感和氛围交给像素。Solaris 也采用了类似的分工:一个语言模型负责判断,一个世界模型负责渲染。
第四步:成本。 每一帧都要消耗算力。但过去几年,同等能力的模型调用价格一路下降,今天几分钱能办到的事,几年前要花几块钱。成本曲线一直站在想象力这一边。
· · ·
▍ 八、一张时间表
以下是我的个人判断,不是预言,仅供参考。
▎ 1–2 年(2027–2028)
● "拼积木"和"写代码"成为 AI 助手、搜索和办公软件的标配,AI 的回答不再是一堵文字墙,而是一个能用的小界面。
● 大多数主流 App 都会长出一张"机器脸",方便 AI 调用,未来不利用AI访问的APP的价值可能也会逐步变弱。
● 让手机助理跨多个 App 办完一件事,会变得很平常。
▎ 3–5 年(2029–2031)
● "自带界面"出现雏形:你的个人 AI 成为所有服务的"前台"。
● 眼镜成为很多人的第二块屏幕。
● 世界模型全面进入电商、内容和旅行:可以走进去的视频、样板间和目的地预览开始普及。
▎ 5–10 年(2031–2036)
● 逐帧生成的界面先在娱乐、创作和教育领域普及。
● 操作系统出现"生成式桌面",一次性软件成为日常。
● 涉及钱和身份的环节依然保持固定、可预期的骨架,血肉则随你而变。
▍ 九、写给三类人
▎ 如果你是设计师或产品经理
你的交付物会从"一张张页面",变成规则、组件库和评判标准:什么情况下该生成什么,好坏由什么来衡量。Google 为了评估生成式界面,专门整理了一套由专家制作的参考答案库。两项新手艺会越来越值钱:设计"骨架",也就是哪些东西永远不该动;以及设计"回执",让人一眼看懂 AI 替他做了什么。
▎ 如果你是开发者
把自己的软件做一张“脸”和地图给AI使用。MCP、结构化数据、WebMCP 这些"给 AI 用的接口",会像当年的移动端适配一样,从加分项变成必选项。你的产品被 AI 调用的次数,可能会远多于被人打开的次数。
▎ 如果你是普通用户
你的习惯和偏好,会变成一份随身携带的"界面档案"。它越懂你,所有软件就越顺手。而比"学会用某个软件"更重要的能力,是清楚地说出你想要什么。
· · ·
▍ 结语
回到开头 Karpathy 的那句话:"这个 App 本不该存在。"
它说的不是软件会消失,而是软件的形状会改变:从一个等着你去学的产品,变成一个随你而变的东西;从一块你盯着看的屏幕,变成一个你可以走进去的地方;从你亲手点完的每一步,变成一张你只需确认的回执。
过去 40 年,是人学会使用软件。
接下来,是软件学会长成你的样子。
欢迎在评论区留下你对未来软件形态演进的看法。