ARTICLE · 1090534
AI 视频工具把一句话做成几分钟成片,我踩过的坑你还想试吗?
我为什么盯上了这种长片
我是在手机上刷到一条讲故事的片子,画面基本不动,几张图缓缓放大,声音在讲一件事,我居然从头看到了尾。关掉之后我第一反应不是这故事真好,而是这活儿我是不是也能干。我做短视频最卡的地方一直很固定:想清楚要说什么,半小时就够;把画面做出来,一整天都不够。如果真能靠图片加配音拼出几分钟的成片,我那几个写了半年没拍的稿子就有出路了。我用几个晚上把这条路自己走了一遍,过程比我想的碎,也比我想的省。
我的总看法是:AI 视频工具现在已经能把从一句话到几分钟成片这条路走通,但它省掉的是拍摄和找画面,省不掉的是判断。脚本怎么写、分镜怎么切、旁白和画面对不对得上,这些还是我的活。做完一条五分钟的片子,真正花在生成上的时间不到三分之一,剩下的都在改文字和调节奏。所以我的结论很明确:这条路值得试,别指望它替你想事,它替我干活,稿子写成什么样,出来的就是什么样。
先把旁白文本写出来,画面是后面的事
我第一次上手的时候顺序是反的,先想画面,想到哪儿算哪儿。结果做到一半,发现自己在给一堆好看的图硬编故事,叙事线是散的。后来我改了自己的做法:先定旁白文本,一句一个镜头,一句话不超过两行,读出来三十秒以内能念完。
我用的那套流程是先用一份主提示词生成选题方向和完整脚本,再从脚本往下拆成一个个分镜。这一步我返工过两次,体会很直接:文字这块要是糊弄过去了,后面每一层都得陪着返工。
现在我判断一条片子能不能做,就看旁白文本写完以后我读着顺不顺。读着别扭的,画面再漂亮,我自己心里也过不去。
角色表救了我的画面一致性
第一条片子做到第八张图的时候,主角的脸变了。倒不是一下子换了个人,是眉毛、发际线、下颌线各差一点,单看两张还行,连着看十张就成了两个人。我把那一段反复看了三遍,越看越出戏。问题出在我没把角色定死。
我后来用上了角色表这套东西:给每个角色写一段固定的描述,包括五官、发型、衣服的颜色和款式,之后每生成一张图,都把对应角色的这段描述原样带进去,而不是让模型自己回忆。角色描述本身也可以交给提示词去写,把角色的名字记牢,后面每一步都对着名字调。
硬信息是这样的:我那条五分钟的片子一共十八张图片,里面只有两个角色。角色一多,我这种手工核对的方式就开始吃力,所以我到现在还尽量把角色控制在两三个以内。角色的描述最好在开工前就写清楚,等画面出来了再去补,花的工夫要多好几倍。
提示词一次只出十条,我就一批批接着要
图片提示词这块有个设定我一开始不适应:一次只给十条。想继续,就回一个 next,它再给下一批十张。我嫌麻烦,试过让它一次把整条片子的提示词全写完,结果是提示词之间开始串味,人物的动作在几张之间反复,节奏也乱。分成几批要,前后就顺多了。
每条图片提示词里写的东西比我预想的多:这一张画面停留多久、画面里要出现哪几个角色、这一段对应的旁白文本是什么。我那条片子的设定是每张图停留十五秒,十八张正好拼够五分钟。旁白文本就贴在提示词下面,我直接复制去配音,不用再回头翻脚本。
长片得拆段生成,时长不够就拉长画面
如果整条片子都用图片,做起来最省事,但纯图铺满十分钟,我自己看着会走神。我采纳的做法是开头用一小段真动的画面把人拉住,剩下的交给图。那条五分钟的片子,我把开头四五张图转成了视频,每条十秒,凑出来接近一分钟的活动画面。
时长这件事得算着来。做十分钟的片子,开头至少要生成五到七条视频,而生成视频的额度是每天五十个积分,用完了就得等第二天。我不太喜欢被额度牵着走的感觉,所以现在习惯先把图片全部做完,再按优先级去生成开头那几条。
还有一个常踩的坑是画面撑不满。旁白念了二十秒,手头这张图我只找到十秒的用法,硬切就会空。我的处理是把这张图在时间线上拉长,让它慢慢放大一直撑到旁白念完。听上去像凑,实际观感反而比频繁切图舒服。
首尾帧接得上,镜头才不跳
镜头衔接是我花心思最多、也觉得最有意思的一步。同一段里从一张图切到另一张图,如果人物的朝向、光线、景别全变了,观众的眼睛会被拽一下,说不上哪里不对,就是不舒服。
我的办法是把上一段画面的尾帧存下来,当成下一段的首帧喂进去。这样两段之间的色调和构图是连着的,动起来就像同一个镜头在继续。我用这招之后,同一段里连切五六个画面也不再跳。
中间有过反复。有一次我图省事,跳过了这一步,直接从第二张图开始生成,结果那一段里主角从左边走到右边又走回左边,看着像在原地打转。我把那三条镜头全部重做了一遍,那天晚上重做完,我给自己定了一条固定动作,后面每次都老老实实存尾帧。
配音铺上去,剪辑才是我最花时间的
配音本身不难。把旁白文本复制进文字转语音的工具,选好性别、语言、音色和语速,点生成,试听,下载。语速我一般保持在正常档,故事类的片子念快了我听着累。音色我会先试几条再定下来。想要更好的音质,可以用更专业的付费配音服务;免费那条也能用,但人声的厚度确实差一点,这点我自己对比着听过。
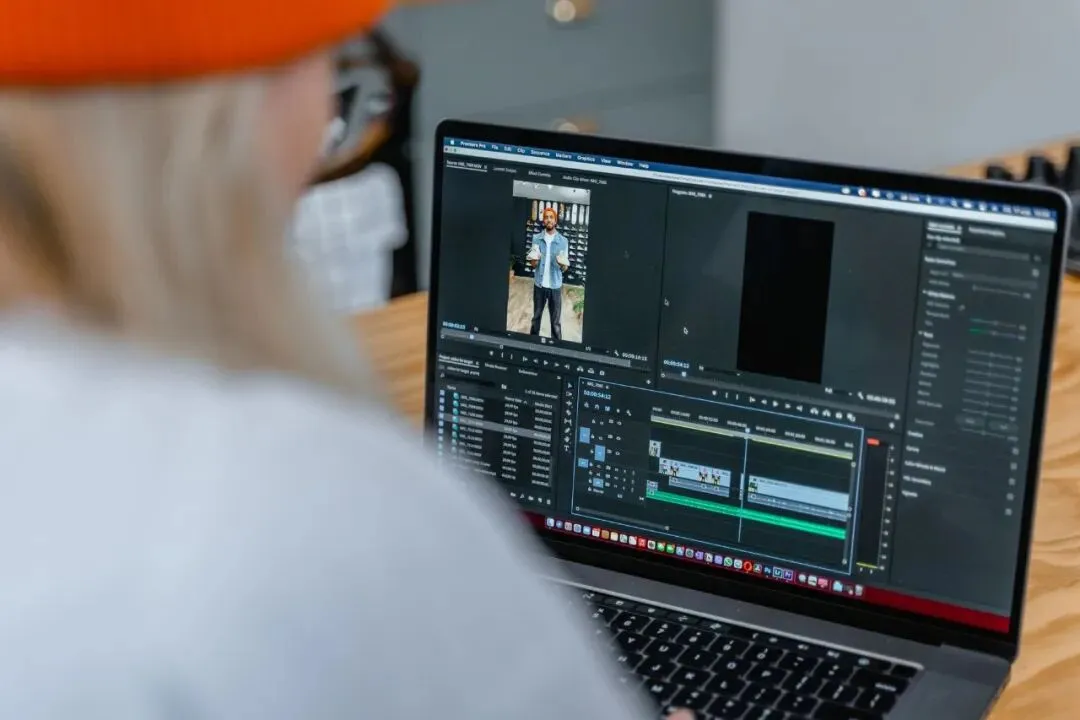
真正费时间的是对齐。我把画面自带的声音全部调到最低、彻底静音,再把一条条配音铺到时间线上,一句一句对。判断标准很简单:旁白里说到什么,画面里就得让人看到那个东西。有一处我念到下雨,画面里却是大晴天,我看回放的时候愣了一下,只能回去把那张图换掉。
对齐之后再补一点动画:在图片的开头和结尾各放一个点,把结尾稍微放大一点,画面就有了缓慢推进的感觉。用同一手法把每张图都过一遍,整条片子看起来会顺很多。背景音乐我用生成的,主要是省事,不用再满世界去找一段能用的。
我从头到尾的取舍其实就一条:先跑通,再谈好坏。有人建议这类片子至少做到二十到二十五分钟,我第一条只做了五分钟,因为我想先确认这条路在我手上能不能走完。十分钟到一刻钟就能出一条的说法,我这个手速做不到,第一条花了一整晚,熟练之后也还是要两个小时上下。至于订阅和播放的数字,我看过好几种说法,说几十条就能攒到上万关注,但我没找到确切说法,也就不拿它当论据。
画面能生成,判断生成不了。这类工具把做视频的门槛降到了会写字就能开工,可它同时把一件事顶到了最前面:你到底想说什么。
如果你也在纠结要不要碰这类长片,我的建议是先做一条五分钟的,把旁白文本写到读着顺,再往下走。你在这一步遇到过什么怪毛病,是角色中途变脸,还是画面和旁白打架,评论区一起聊聊,我踩过的坑都摆在这儿了。
这条流程我还会接着试下去,后面做了更长的片子,我会把新的踩坑记录写出来。原创不易,如果这篇对你有用,点个关注,公众号:智慧数码体验,我会把这类自己上手过的东西一篇篇写下来。
|来源:互联网|编辑排版:小四|说明:本文由智慧数码体验整理创作,转载请注明来源
免责声明:本文仅供学习交流参考,不构成医疗、投资、法律等专业建议,亦不代表本公众号立场。部分文字、图片、音视频来源于网络,版权归原作者所有,如涉侵权请及时联系,我们将第一时间删除。读者据此操作风险自担,本公众号不承担相关责任;留言评论仅代表发布者个人观点。特此声明。