ARTICLE · 1092098
为什么一次 AI 回答不能代表品牌表现:GEO 诊断要看样本,而不是截图
品牌团队做 GEO 调研时,很容易出现这样一幕:同事在某个 AI 产品里输入“推荐几款适合中小团队的某类工具”,发现自家品牌排在第一,于是截图发到群里,宣布“AI 已经开始推荐我们了”。
第二天,换个人再问,品牌却没有出现;换个平台,答案里的候选名单又完全不同。团队开始争论:到底哪张截图是真的?
其实每张截图都可能是真的,但它们都不足以代表品牌的整体表现。
GEO 诊断的基本单位不是“一次回答”,而是一组带有平台、入口、问题、时间和原始证据的样本。单次回答只能证明某一时刻发生过什么,不能直接证明品牌稳定可见。
这也是 GEO 和传统页面检查很不一样的地方。网页内容可以反复访问同一个 URL,生成式回答却受平台、入口、上下文、模型更新和生成过程影响。要从偶然现象走向可执行结论,必须先设计样本。
一、一次回答为什么不够
1. 问法稍有变化,任务就可能变了
“有哪些工具”“最适合小团队的工具”“预算有限时怎么选”,看起来都在问推荐,实际约束不同。AI 可能在第一个问题里罗列知名品牌,在第二个问题里强调易用性,在第三个问题里优先比较价格。
如果只拿其中一个问题代表全部用户意图,结论会天然偏向那种问法。Prompt 在 GEO 中不是一个关键词,而是一个具体决策场景。
2. 同一品牌在不同平台的可见性并不等价
不同 AI 产品使用的检索机制、知识来源、引用展示和产品入口并不相同。即使品牌在一个网页端被提及,也不能推断它在另一个平台、移动端或官方 API 中同样可见。
入口本身也是诊断口径。网页端结果不能静默冒充桌面端,官方 API 结果也不能替代真实用户正在使用的产品界面。
3. 生成式回答存在时间波动
即使问题文字完全相同,平台的模型、检索结果和公开信息都可能变化。一次被推荐,可能只是一个时点的观察;一次未被提及,也不等于品牌永远没有机会。
因此,单次结果适合做线索,不适合直接做趋势。要判断改善是否稳定,至少需要在采样配置一致的前提下进行周期性观察。
二、真正需要的不是“多问几遍”,而是可审计的样本设计
最粗糙的补救方式,是让几个人随手多问几次。但如果大家使用不同平台、不同问题、不同账号和不同时间,最后只是得到更多截图,仍然无法比较。
一个可用的采样框架,至少要固定五个维度:
• 平台与入口:到底观察哪个 AI 产品的网页端、移动端或其他入口; • 用户意图:每个 Prompt 对应什么真实问题,不能事后随意改写; • 执行时间:回答何时采集,是否属于同一轮诊断; • 原始证据:回答正文、平台原生引用和截图是否能够回查; • 采样版本:目标平台、Prompt 集合和指标规则是否与历史一致。
这些信息共同决定一个样本能回答什么。缺少其中任何一项,结论都容易越界。
三、我们在项目里怎么把“回答”变成“证据”
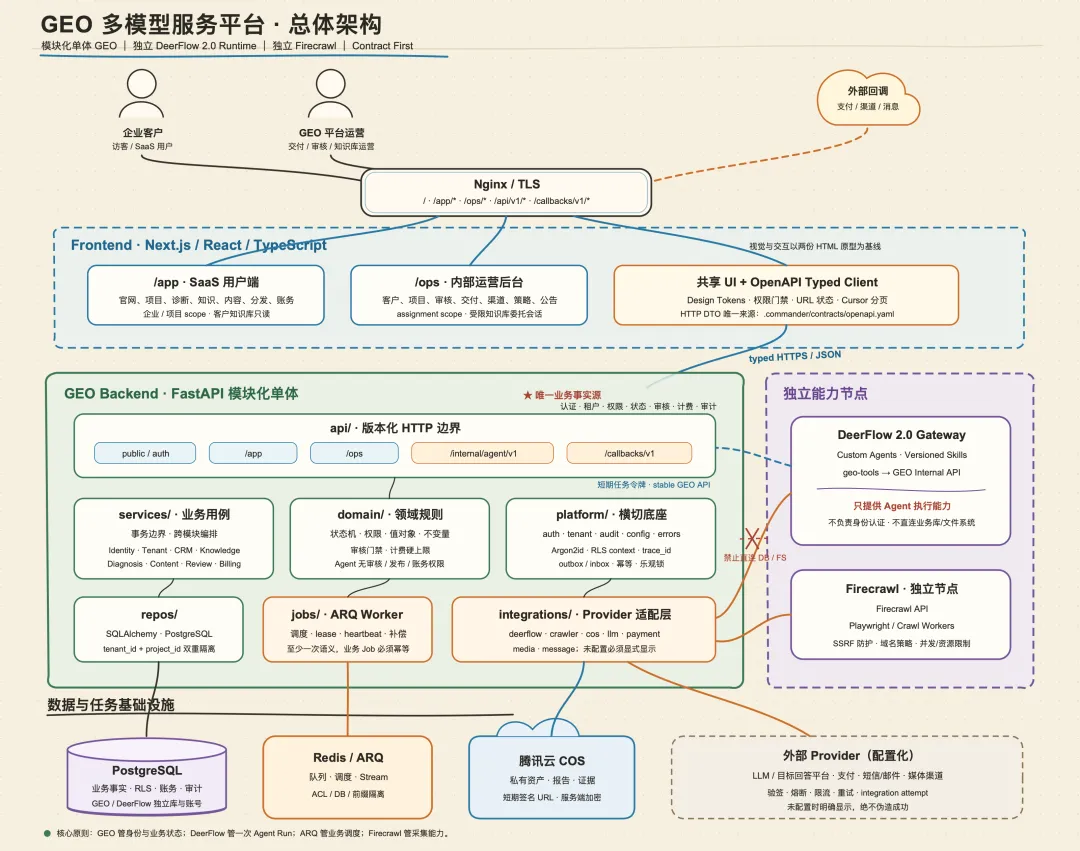
在 Nexpia GEO 的实践中,诊断创建时会先冻结品牌、产品、目标平台和 1—5 条已选择的问题。执行系统再按“目标平台 × Prompt”生成计划样本位,而不是让执行程序临时决定问什么。
每个成功样本都要保存目标入口、Prompt 标识、回答正文、采集时间、能力版本和平台原生引用;截图与原始产物用于复查。平台登录凭证、Cookie 等敏感信息不会进入证据或日志。
这里有四个关键约束。
第一,计划分母不能随着失败变小。如果选择了四个平台,其中一个没有采集成功,平台覆盖率不能只在三个成功平台里计算。失败与缺失必须继续留在计划分母中,否则系统越不稳定,指标反而可能越好看。
第二,一个平台成功不等于多平台诊断完成。项目的覆盖门禁要求每个目标至少存在成功样本,并对全部计划样本设置版本化成功率阈值;证据仅部分返回时必须标记为部分报告,而不是用网页搜索材料补成“平台回答”。
第三,回答事实与 AI 标注分层保存。回答正文、引用、时间是原始事实;提及次数、引用数量和覆盖率由固定版本的代码计算;情感、完整度等语义判断属于派生标注,必须绑定具体样本。报告生成器只能解释这些结果,不能重新发明数字。
第四,趋势只比较同口径样本。项目中的趋势规则要求历史执行属于同一诊断计划,并且采样配置指纹和指标版本一致。平台集合或 Prompt 集合变化后,新的结果可以展示,但不能硬接成一条“增长曲线”。少于两个可比周期,也不画趋势。
四、从样本到判断,应该怎样说话
假设一轮诊断计划采集 4 个平台、5 个问题,共 20 个样本位。最终 17 个成功,3 个失败,其中品牌在 9 个成功回答中被提及。
严谨的表达不是“品牌在 AI 中的曝光率为 45%”,更不是“AI 市占率 45%”。首先要说明采样范围、成功与失败数量,再根据获批口径报告品牌提及、平台覆盖和场景覆盖。失败样本是否进入某个指标的分母,也必须由指标定义明确规定。
如果某个平台的 5 个问题全部失败,最重要的结论可能不是品牌表现差,而是本轮对该平台没有足够证据。把“没采到”写成“没有被提及”,同样是在制造假精确。
五、团队可以直接使用的采样清单
准备做一次 GEO 诊断前,建议逐项确认:
• 目标用户真正会问的 1—5 个问题是否已经明确? • 每个问题代表的决策场景是否不同,而不是同义改写? • 平台与入口是否被分别记录,是否存在口径冒充? • 计划样本数、成功数、失败数和未知数是否同时展示? • 原始回答、引用、截图和采集时间是否可以追溯? • 品牌提及、明确推荐、正向情感是否被分开判断? • 缺失平台是否仍保留在计划覆盖率的分母中? • 历史趋势是否只比较相同采样配置和指标版本? • 当证据不足时,报告是否敢于写“无法判断”?
如果团队只能拿出一张截图,却回答不了这些问题,那张图可以作为观察记录,但不应该成为预算决策、内容策略或季度复盘的唯一依据。
写在最后
GEO 诊断不是寻找一条最有利的 AI 回答,而是建立一套能抵抗偶然性的观察方法。
一次回答告诉我们“发生过什么”;一组设计清楚、证据完整的样本,才有机会告诉我们“品牌在哪些平台、哪些场景下稳定出现,哪里仍然缺证据”。
当团队开始尊重样本边界,GEO 才从截图竞赛变成可复查、可比较、可改进的工程系统。
下一篇:GEO 诊断必须回答的四个问题——可见性、引用、覆盖与情感。