ARTICLE · 1092108
日增1050星:把Office运行时交给Agent
结论先行:今天 GitHub 日榜上值得工程团队停下来看的不是又一个 Agent 管理台,而是 dream-num/univer——它不提供「AI 生成 Excel」这类一次性魔法,而是把表格/文档/幻灯片的运行时做成了插件化 SDK,让 Agent 和人走同一条命令管道去修改同一份文件。这个取舍很贵,但它是目前唯一能把「语义一致性」做对的路线。
01一、榜单现场
抓取时间:2026-09-26 12:20 GMT+8,来源 GitHub Trending 日榜(since=daily)。
今日主角:dream-num/univer,日榜第 5,当日 +1,050 星,总星 18,700(API 实时值),TypeScript,Apache-2.0。
▪︎ paperclipai/paperclip(+2,109 / 85,195):把 Agent 当员工管——组织、审批、预算、连接授权一整套控制平面,热度最高,形态偏上层应用。
▪︎ vectorize-io/hindsight(+1,653 / 29,956):Agent 记忆层,本号昨日已单独拆解。
▪︎ google/ax(+1,379 / 11,584):Go 写的 agentic 编排运行时,Google 官方出品。
▪︎ rohitg00/ai-engineering-from-scratch(+1,177 / 57,635):学习路线型仓库,热度高但不是工具。
▪︎ pbakaus/impeccable(+306 / 71,253):给 Agent 用的设计语言约束,做 UI 生成的值得跟。
▪︎ openbao/openbao(+49 / 7,770):Vault 的社区硬分叉,日增不高但工程价值长期稳定。
整体判断:今天日榜里过半条目与 Agent 相关,但它们几乎都在同一个位置动手——给 Agent 加外壳(编排、技能、记忆、管理台)。只有 Univer 动的是内容表示层:它要解决的是 Agent 究竟应该在什么对象上工作。这是两类完全不同的问题。
02二、项目定位
官方一句话定义:The Office Harness for AI Agents — Spreadsheets, Docs, Slides, Canvas, Relational Tables, and PDF in one runtime.
文档站的另一句更完整:Univer Office SDK brings a unified Office runtime into your product, enabling humans and AI agents to work together with freely composable and embeddable spreadsheets, documents, presentations, Bases, Boards and PDFs.
交互模型是理解它的关键:它不是「你调用 SDK 导出一个 xlsx」,而是 SDK 内部存在一个活着的文档单元(Unit),你通过 Facade API 对它下发操作——Univer 实例 → 注册插件 → createUnit(UniverInstanceType.UNIVER_SHEET, {}) → univerAPI.createWorkbook({})。此后所有读写,不论来自鼠标点击还是来自大模型,都收敛到同一个 Unit 的命令管道上。
▪︎ dream-num/univer:核心 SDK,本文主角。
▪︎ dream-num/univer-mcp:MCP Server,把 Agent 的工具调用代理到运行中的 Univer 实例(MIT,早期阶段)。
▪︎ dream-num/univer-sdk-skills:给编码 Agent 用的集成指令。
▪︎ dream-num/univer-mcp-start-kit:自托管起实例的模板。
▪︎ Server SDK / Univer Pro:协作服务、文件转换等服务端能力与商业层。
03三、为什么需要它
项目自己的问题陈述比任何评测都清楚。README 里有一句定位性的否定:Univer is not a spreadsheet file viewer only. It is a framework for building your own productivity surface.
以及:Across the Univer product family, Office tools share a runtime for storage and computation. Content can be composed and embedded across tools, with linked data and references updating together. People and AI agents can work in the same files.
Headless 章节则明确点了 AI 场景:LLMs and agents can directly call the Facade API for automated document read/write and analysis.
这三条陈述映射到设计上,正好解释了四个此前没被定义清楚的问题。
▪︎ 文件格式表达不了「意图」。生成一个 xlsx 只是一次快照;setValue 和「把这个单元格的引用从 A1 改成整列」在文件层是同一结果,在运行时层是两种不同语义。Univer 的解法是命令 + mutation,让写操作自带语义。
▪︎ 人和 Agent 双写会把状态撕成两半。只要 Agent 走的是解析文件→改数据→写回这条旁路,公式重算、条件格式、撤销栈、协作变更集就全部失效。Univer 让二者共用一条管道。
▪︎ 浏览器一套、服务端一套必然漂移。同构设计让 Node 进程和浏览器标签跑的是同一份模型代码,而不是两套方言。
▪︎ Office 是全栈怪兽,不能整包吞。插件化让你可以只装 sheets 核心,也可以按需懒加载、甚至替换某个能力的实现。
04四、核心原语与设计拆解
▪︎ Unit + UniverInstanceType:一切围绕文档单元——UNIVER_SHEET / UNIVER_DOC / UNIVER_SLIDE,同一进程可开多实例。
▪︎ 微内核 + 插件体系:官方插件 100+,装载方式分 Preset 模式(开箱即用)与 Plugin 模式(逐个 registerPlugin,可裁剪、可懒加载、可替换实现)两档。
▪︎ 命令与变更(command / mutation):所有写操作统一过这条管道,因此 undo/redo、编辑历史、协作变更集、权限钩子都是同一个事实来源,而不是各自实现。
▪︎ Facade API:FUniver / FWorkbook / FRange 等门面类,跨浏览器与 Node 一致。这是给集成者与 Agent 用的稳定层,内部重构不应当影响它。
▪︎ Canvas2D 渲染引擎:放弃 DOM,换来官方标称「600 万单元格滚动 50–60 FPS」的大数据量表现;代价是文本选区、复制粘贴、输入法(IME)这些浏览器免费给你的东西,全部要在 canvas 上重新实现一遍。这是它有门槛的根本原因。
▪︎ 公式引擎:500+ 内置函数、跨表引用、数组公式、命名区域、自定义函数。这是它和「表格 UI 库」的分水岭——公式是计算图,不是字符串。
05五、上手路径
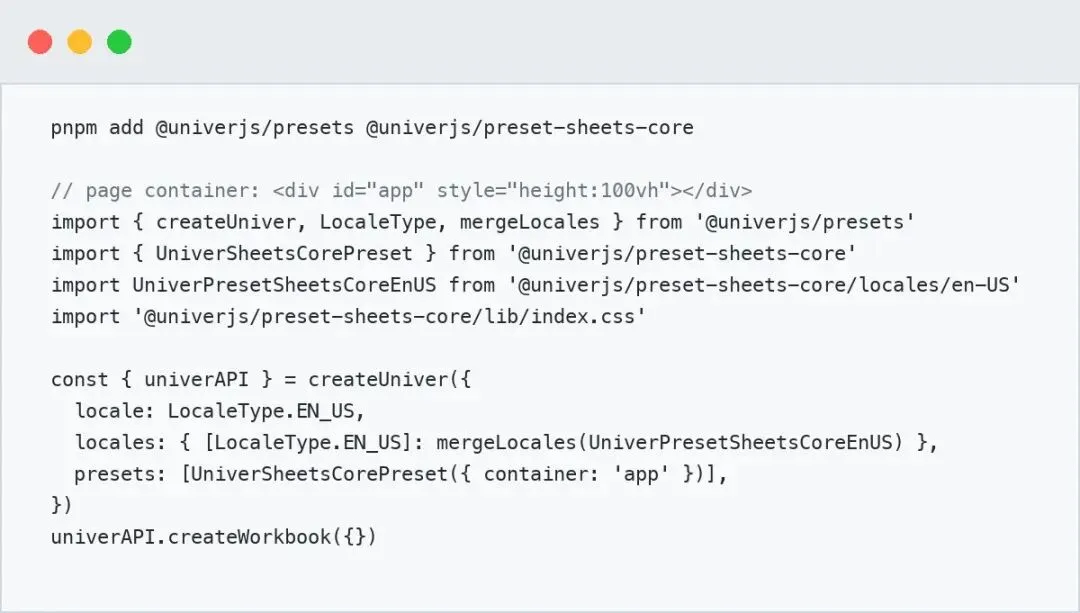
路线 A,浏览器里最快跑起来(Preset 模式):安装两个包,页面放一个 id 为 app 的容器,十几行代码出一张可编辑的表格——安装、容器、初始化全在下面这张图里:
路线 B,Node.js 无头(这才是给 Agent 用的形态):删掉 UI 插件、保留模型与计算层,注册 @univerjs/core、sheets、sheets-formula、sheets-numfmt、engine-formula、engine-render,然后 univer.createUnit(UniverInstanceType.UNIVER_SHEET, {})。整个过程不需要浏览器。
路线 C,让大模型直接驱动(univer-mcp):先在 console.univer.ai/apikeys 取 API Key,再用 console.univer.ai/playground 或 univer-mcp-start-kit 起一个 Univer 实例,最后接入 MCP 客户端——Claude Code 一条命令与 mcpServers 配置都在下面这张图里:
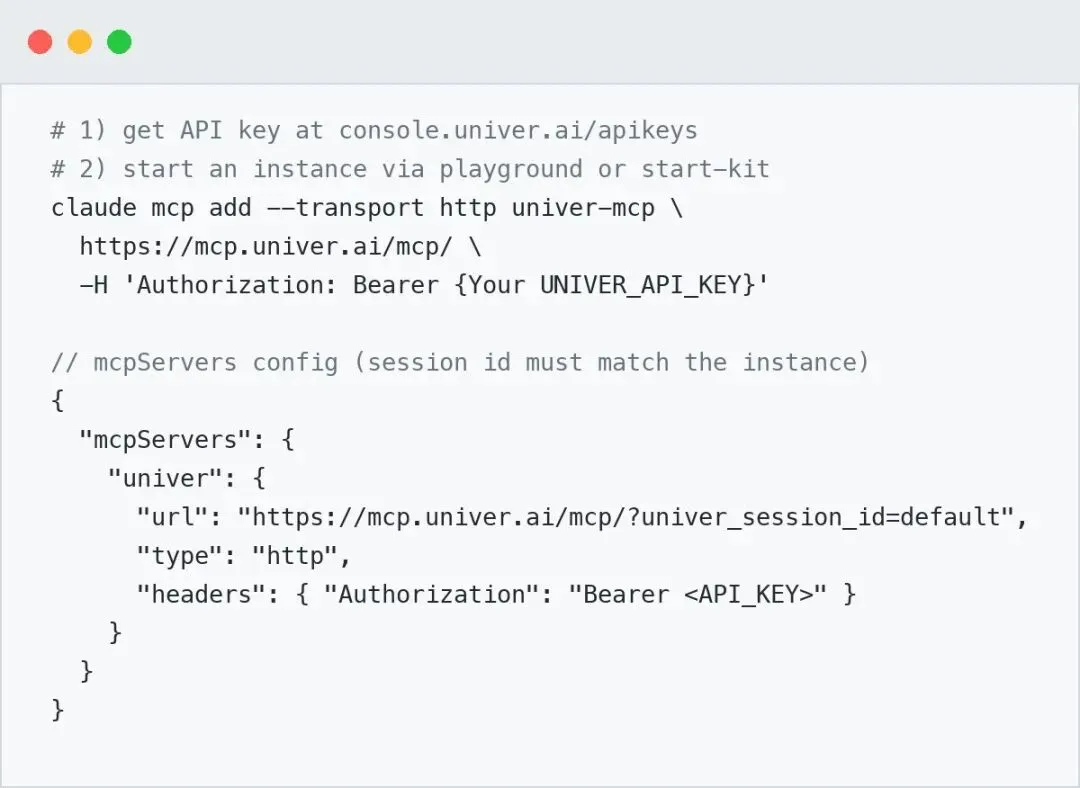
注意 univer_session_id 必须与 Univer 实例的 session id 保持一致,否则工具调用落不到你的文档上。
06六、最反直觉的一点
Node 无头模式下,你仍然要注册渲染引擎插件 UniverRenderEnginePlugin。直觉上服务端不画界面,为什么需要渲染引擎?原因恰恰是它整套设计的核心:渲染层承载的度量信息本身就是数据的一部分——列宽自适应、富文本换行、单元格自动撑高、打印分页,这些量都要由渲染引擎算出来再写回文档模型。如果为 Node 再造一套精简版模型,那浏览器和服务端就从第一天起变成两套方言,退回到第三章的第三个问题。
所以 Univer 明确选择了另一种代价:不做 Node 专用精简实现,服务端每次调用都要付出加载整套引擎的启动与内存成本;换来的是语义完全一致——同一个 FRange.setValue() 在浏览器里和在 Node 里产生的 mutation、触发的公式重算、写入的历史记录完全相同。
一句话概括这个取舍:牺牲单次调用的轻量性,换取双端语义的同一性。这在「Agent 要长期与人共写同一份文件」的场景里是划算的;在「批量转格式、跑完就扔」的场景里则不划算——那种活儿用文件解析库更合适。
07七、现实约束
第一,成熟度不均。官方明确写着 Sheets 是当下最成熟的产品面,Docs / Slides 在同一架构上持续演进(能力矩阵把 Slides 的开源部分标为 under active development),PDF 仍标注 coming soon。仓库另有 API Stability Policy,把 API 区分为 stable / experimental / internal / deprecated——这本身就是尚未完全收敛的诚实信号。版本方面,文档站当前公告为 v1.0.2,1.0 才刚落地不久。
第二,开源版有明确的商业边界。实时协作、编辑历史、xlsx/docx/pptx/pdf 导入导出、打印、图表、透视表、sparklines 等都在 Univer Pro 商业层,不在开源仓库里。这意味着做一个能赚钱的 Agent 表格产品,大概率会撞到 Pro 边界;另外服务端还要自己接认证、权限、存储。配套的 univer-mcp 官方文档自带 Early Development 标记,图表、透视表、跨平台、实时协作四项仍是 WIP,且明确要求接入多模态模型——部分工具返回图片,纯文本模式尚未支持。
第三,生态尚未形成惯性。100+ 官方插件、React/Vue/Angular/Next.js/Web Components 适配器都齐备,框架侧门槛已被削平;但项目 2022-09 创建,四年积累 18.7k 星、1,589 fork、146 个 open issue,社区讨论主要在 GitHub Issues 与 Discord。中文文档完善、团队在国内是优势,英文侧的第三方经验沉淀还薄。
08八、一句话建议
如果你的产品要让 Agent 真正「编辑」而不是「生成」Office 文档,Univer 是当下最值得技术验证的一个;如果你的需求只是批量读写表格文件,请不要用它——那是把运行时当解析器用。
▪︎ 先做一件小事验证能力边界:用 Node headless 模式加载你手头最复杂的一份工作簿,检查其中的业务函数是否被那 500+ 内置函数覆盖(不支持的走自定义函数补齐)。这一步不需要 Pro,半小时内能出结论。
▪︎ 再验证 Agent 通路:确认第一步通过后,接 univer-mcp 打通大模型侧。注意它的早期阶段状态与多模态模型要求,务必确认 univer_session_id 与实例一致。
▪︎ 提前做商业边界盘点:把协作、导入导出、打印、图表、透视表列一张表,逐项确认是否落在 Pro。这决定了成本模型,而且应该在写代码之前做,不要等产品成形才发现。
项目地址:https://github.com/dream-num/univer 配套:univer-mcp(MCP Server)· univer-sdk-skills(Agent 集成指令)· docs.univer.ai(文档与 API 参考) 许可证与语言:Apache-2.0 / TypeScript
数据来源与时效性说明:榜单数据与 star 数取自 GitHub Trending 日榜(2026-09-26 12:20 GMT+8 抓取)与 GitHub REST API 实时返回(18,700 星 / 1,589 fork / 146 open issue)。产品能力边界、安装命令与版本信息取自项目 README、dream-num/univer-mcp README 与 docs.univer.ai 同时点位的快照。日榜为滚动窗口,不同时间抓取的当日新增 star 会有差异;Univer 仍在快速迭代,正文中的能力矩阵与 Pro 边界以官方文档为准。
THE END