ARTICLE · 1107480
Cloudflare 推出 ADLC:AI 智能体要重写软件工程
图 1|Cloudflare 对智能体开发生命周期的视觉表达。来源:Cloudflare 官方博客。
AI 工程观察
过去,软件工程最昂贵的环节是“实现”:需求要排期,代码要手写,功能要逐行调试。
现在,AI 把写代码压缩成了分钟级任务,却没有同步压缩测试、审查、发布、观测和事故响应。于是,一个反直觉的结果出现了:代码产能越高,系统后端的人类瓶颈越严重。
2026 年 8 月,Cloudflare 提出 Agent Development Lifecycle(ADLC,智能体开发生命周期),并直言传统 Software Development Lifecycle(SDLC)已经不足以承载“软件工厂”。它要解决的,不是如何让模型再多写一点代码,而是如何让智能体对软件的完整生命周期负责。
01
ADLC 不是给 SDLC 换名字
传统 SDLC 通常包含计划、设计、实现、测试、部署、维护和停用。Cloudflare 的判断是:这些阶段并没有消失,真正改变的是执行者、控制方式和反馈速度。
今天许多团队的做法,仍是“人类管理流程,智能体承接任务”:人给提示词,智能体写代码;人审查,智能体修改;人点击部署;出问题后,再由人把日志贴给智能体。智能体看似参与了每一步,却没有真正拥有上下文、权限和反馈回路。
更准确的理解:Cloudflare 所说的“取代”,是把以人为中心的流程控制面,改造成以智能体为执行主体、以人类策略为边界的工程系统。
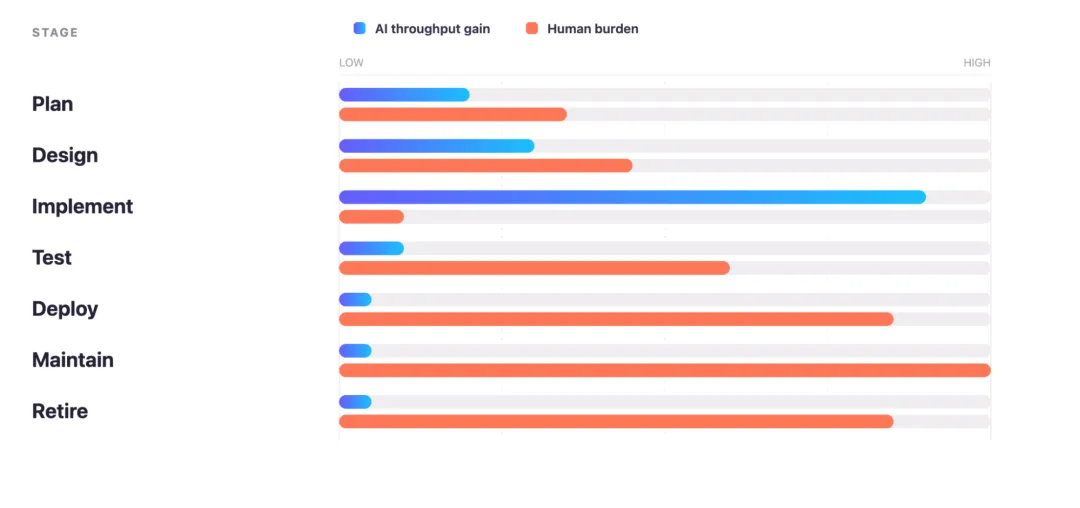
图 2|官方示意图强调“实现”提速后,测试、部署和维护成为新瓶颈;该图是概念示意,并非实测数据。来源:Cloudflare 官方博客。
02
真正的变化:从流水线走向动态工作流
CI/CD 擅长确定性步骤:安装依赖、编译、测试、部署。可一旦任务变成“复现某个地区、某种网络条件下的错误,修复后给测试用户灰度发布,并根据指标决定继续还是回滚”,线性 YAML 就不够了。
这类任务需要的是一个能保存状态、调用工具、生成子任务、等待外部事件,并在失败后恢复的动态工作流。Cloudflare 因此把 Workflows 放在 ADLC 的编排核心:它可以运行数分钟、数小时甚至数周,自动重试失败步骤,也能生成智能体或其他工作流。
1. 可执行:Workflows + Artifacts + @cloudflare/ci
Artifacts 提供版本化代码存储,CI SDK 负责把存储、构建、测试和部署串起来。官方列出的能力包括隔离构建、依赖缓存、类型检查、单元测试、条件部署,以及让 AI 审查智能体尝试修复失败步骤。
图 3|@cloudflare/ci 基于 Cloudflare Workflows 组织构建、测试与部署。来源:Cloudflare 官方博客。
2. 可感知:Local Traces + Agent Traces
智能体若看不到运行时,就只能猜。Cloudflare 已让 wrangler dev 和 vite dev 自动捕获本地 Worker 调用的 OpenTelemetry 追踪;在识别到受支持的编码智能体会话后,开发服务器还会提示可查询的 Local Explorer API。
到了线上,Agent Traces 继续记录模型调用、工具执行、Token 与成本。换句话说,可观测性不再只服务人类排障,也成为智能体的“传感器”。
图 4|本地追踪让编码智能体在部署前获得结构化运行反馈。来源:Cloudflare 官方博客。
3. 可控制:预览、灰度、权限与回滚
Cloudflare 将预览 URL、Browser Run、功能开关、渐进式部署、Workers Logs、MCP Server 等能力纳入同一张 ADLC 工具图谱。共同目标只有一个:让每次变更都能独立验证、逐步放量、持续观测,并在越界前被阻断或回滚。
03
ADLC 对工程组织提出七项硬要求
Cloudflare 在文章中列出了软件工厂所依赖的平台属性。它们也可以直接转化为一份团队自检表:
01 程序化关键操作必须有稳定 API,不能依赖只能由人点击的控制台。
02 可横向扩展每个智能体都能获得接近生产环境的独立预览,而不是共用一台预发服务器。
03 可重现设备、网络、地理位置和依赖状态都能被描述并重新创建。
04 事件驱动错误、指标变化和用户反馈能够主动触发智能体,而不是等待人盯仪表盘。
05 原子性变更可单独测试、发布、观测和回滚。
06 分级授权智能体默认最小权限,必要时通过可审计流程提升权限。
07 自我改进把运行轨迹、失败模式和人工修正沉淀为评测、策略与新的工作流版本。
这里最容易被低估的是授权。一个能自动修复生产问题的智能体,也可能自动放大错误。ADLC 的成熟度,不应以“无人介入率”衡量,而应看越权是否可阻断、决策是否可解释、失败是否可恢复。
04
一个更接近现实的案例:Astro 问题分诊
Cloudflare 同期公开了一个 Astro 开源项目的软件工厂案例。系统会读取新提交的错误报告,在沙箱中复现问题、诊断根因,并生成预览版本交给报告者验证。
需要注意的是,官方文章标题用了“将问题数降到零”,但正文更谨慎:截至 2026 年 8 月 4 日,团队称已把开放问题从 200 多个降到约 30 个,并预计随后一个月内清零。这个差异很重要——它提醒我们,软件工厂不是一次提示词工程,而是持续迭代的生产系统。
图 5|Cloudflare 为 Astro 构建自动分诊、复现与验证流水线。来源:Cloudflare 官方博客。
这个案例的价值,不只是“处理了多少 Issue”,而是展示了一条更稳妥的落地路径:从高频、边界清晰、结果可验证的维护任务开始,让智能体先成为可靠的操作员,再逐步扩大权限。
05
团队现在可以怎么做?
如果你负责 AI 工程平台或研发效能,不必立刻重建整套工具链。可以先完成下面五步:
第一步:选一个低风险闭环。从 Issue 分类、依赖升级、测试补全或文档修复开始,确保输入明确、验收可自动化。
第二步:消灭关键 ClickOps。盘点任务链上仍需人工点击的环节,为它们补齐 API、幂等性和审计日志。
第三步:让环境可复制。为每次任务创建隔离沙箱、独立预览和固定依赖,避免智能体在共享环境中互相污染。
第四步:把追踪当成产品能力。统一记录模型调用、工具参数、权限变化、成本、测试结果和发布指标,让每次决策都可回放。
第五步:设计升级与刹车。明确哪些动作可自动执行,哪些必须人工批准;设置预算、时限、重试上限和自动回滚条件。
最终,衡量指标也要变化。不要只看生成了多少代码,而要看端到端交付时间、一次通过率、回滚率、人工接管次数和单位有效变更成本。
结语:AI 工程的下一站,是责任闭环
ADLC 目前仍是 Cloudflare 提出的工程主张,而不是已被行业普遍接受的标准。它也没有消灭 SDLC 的计划、测试、部署与维护阶段。
它真正击中的问题是:当“写代码”不再稀缺,工程优势将来自谁能更安全地验证、更细粒度地授权、更完整地观测,并把失败转化为下一轮改进。
所以,智能体开发生命周期的终点不是“没有人”。恰恰相反,人类会从逐步点击和搬运上下文中退出,把时间放到目标、约束、品味与例外处理上。
未来的软件团队,竞争的不只是模型能力而是谁先建立起一套让智能体对结果负责的工程制度
资料来源
1. Cloudflare:The Agent Development Lifecycle has arrived on Cloudflarehttps://blog.cloudflare.com/agent-development-lifecycle/2. Cloudflare:Run CI/CD for millions of reposhttps://blog.cloudflare.com/ci-workflows/3. Cloudflare:Your agent can now debug Workers with local tracinghttps://blog.cloudflare.com/local-tracing/4. Cloudflare:Introducing Cloudflare Agentshttps://blog.cloudflare.com/agents-on-cloudflare/5. Cloudflare:How we built a software factory to drive Astro’s GitHub issue count to zerohttps://blog.cloudflare.com/astro-issue-triage/