ARTICLE · 1113153
别再让 AI 靠猜:知识图谱、本体与语义层,才是让 AI 真正“知道”的关键
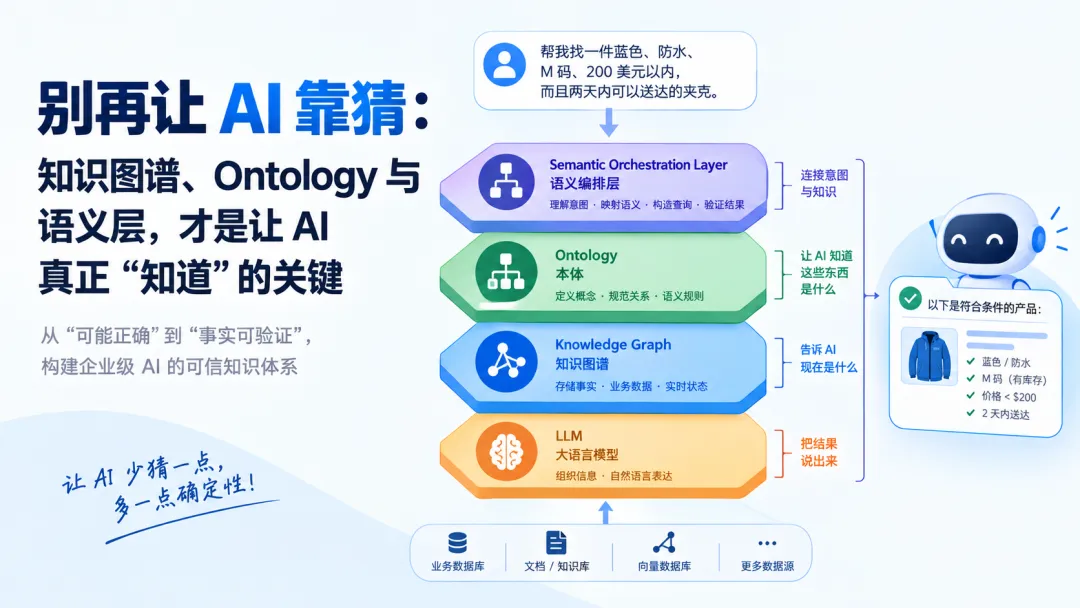
为什么接入了 RAG,AI 还是会一本正经地答错?
这是很多企业在做 AI 应用时都会遇到的问题。
我们给大模型接上知识库,接上向量数据库,再加上 GraphRAG,理论上已经把“事实”提供给 AI 了。
但实际使用时,你仍然可能看到这样的场景:
“这个产品目前有库存吗?”
AI 能回答。
“它支持哪些规格?”
AI 也能回答。
但当问题稍微复杂一点:
“帮我找一款蓝色、防水、M 码、200 美元以内,而且两天内可以送达的夹克。”
AI 就可能开始“猜”。
它可能把“防水”理解成商品描述里的营销词,把“2 天送达”理解成普通文本,把“M 码”当成商品属性,而不是库存中的具体 SKU。
最终生成了一段看起来非常合理,但实际上并没有经过真正验证的答案。
这恰恰暴露了当前很多 AI 系统的一个根本问题:
AI 拥有大量信息,但不一定真正理解这些信息之间的关系。
如果我们希望 AI 在企业知识、医疗、金融、法律、电商等高准确性场景中可靠工作,仅仅依赖一个更大的模型,或者再加一层 RAG,并不够。
真正需要解决的是:
如何让 AI 在生成答案之前,先理解“这些数据究竟意味着什么”。
这也是 Ontology(本体)、Knowledge Graph(知识图谱)和 Semantic Orchestration Layer(语义编排层)存在的意义。
1
一、先问一个问题:为什么“直接用大模型”不够?
现在很多 AI 应用的架构非常简单:
用户问题 → LLM → 答案
这种方式对于聊天、写作、总结等任务非常有效。
但如果问题涉及大量结构化约束,就会出现问题。
例如:
找一件蓝色、防水、200 美元以内、M 码有货、两天内送达的夹克。
人类看到这句话,会很自然地把它拆成几个条件:
颜色 = 蓝色 产品类型 = 夹克 防水 = 是 价格 < 200 美元 尺码 = M M 码必须有库存 配送时间 ≤ 2 天
但对于一个没有结构化约束的 LLM 来说,这些信息只是自然语言。
模型并不知道:
“防水”究竟是商品属性、营销描述,还是某种分类标签?
它也不知道:
“两天送达”究竟是物流约束,还是商品描述的一部分?
更重要的是,模型本身并没有实时的库存、价格和物流数据。
因此,它可能根据训练数据和上下文生成一个“听起来正确”的答案。
问题就在这里:
语言模型擅长生成“合理的话”,但企业系统需要的是“经过验证的事实”。
2
二、GraphRAG 已经解决了问题吗?
于是我们引入 RAG。
RAG 的基本思路非常简单:
先检索,再生成。
用户提出问题后,系统从知识库、向量数据库或者知识图谱中找到相关信息,然后把这些内容交给 LLM,让模型根据检索结果回答。
这显然比单纯依赖模型记忆可靠得多。
进一步,我们还可以使用 GraphRAG:
用户问题 → 检索知识图谱 → 获取相关节点和关系 → LLM → 答案
这确实能够降低很多幻觉。
但问题依然存在。
因为 GraphRAG 主要解决的是:
“给模型更多相关事实。”
而它没有彻底解决:
“模型应该如何理解这些事实?”
例如,知识图谱中存在:
1ProductA2 └── hasFeature → "waterproof"3模型拿到了这个信息。
但它仍然需要自己判断:
waterproof是不是合法的产品属性?什么类型的产品可以拥有这个属性? 它到底代表“防水”,还是某种营销标签? 这个属性和用户提出的“防水夹克”是不是同一个概念? 它能不能和价格、尺码、库存、物流条件一起进行约束?
如果这些规则没有被系统明确表达出来,最后还是需要模型自己“理解”。
于是就出现了一个很有意思的现象:
GraphRAG 让 AI 猜得更有依据了,但它仍然可能是在猜。
3
三、真正缺失的第一层:Ontology
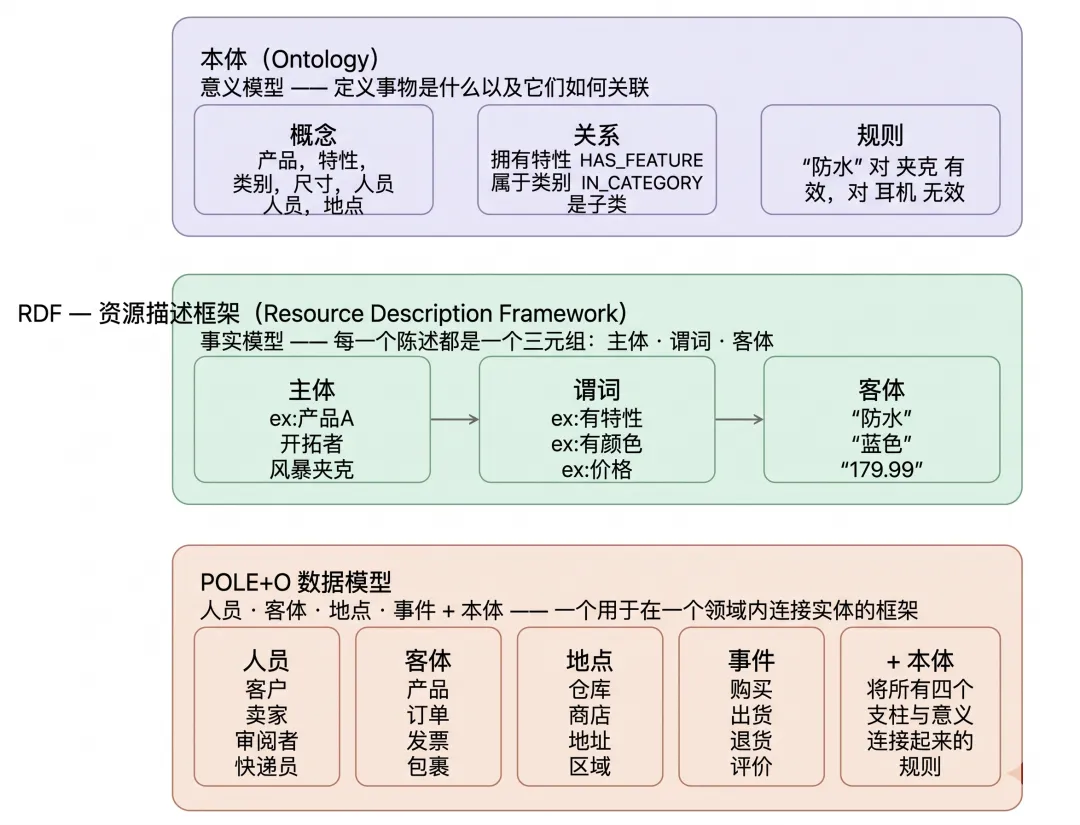
这里就轮到 Ontology,也就是我们通常说的本体。
很多人第一次接触 Ontology,会把它理解成数据库 Schema。
但两者其实并不一样。
3.1
Schema 解决的是:
数据库里有哪些字段?
而 Ontology 解决的是:
这些东西究竟是什么?它们之间允许存在什么关系?什么组合是合法的?
举个简单的例子。
在一个电商领域里,我们可以定义:
3.2
概念
1Product2Feature3Category4ShippingOption5Variant6Inventory73.3
关系
1HAS_FEATURE2IN_CATEGORY3AVAILABLE_IN_SIZE4HAS_VARIANT5HAS_SHIPPING_OPTION6同时还可以定义各种语义规则。
例如:
1Jacket2 └── 可以拥有 → Waterproof3但是:
1Headphone2 └── 不应该拥有 → Waterproof3这样一来,系统就不仅仅知道:
ProductA → hasFeature → waterproof
还知道:
ProductA 是一个 Jacket,而 Jacket 允许拥有 Waterproof 这个 Feature。
这就是 Ontology 的价值。
4
四、Ontology 到底解决了什么?
回到刚才那个问题:
找蓝色、防水、200 美元以内、M 码、两天送达的夹克。
Ontology 可以帮助系统把自然语言拆成明确的语义。
例如:
这一步非常重要。
因为:
自然语言是模糊的,Ontology 是明确的。
用户说的是:
“两天送达。”
系统最终需要理解成:
1shippingTime <= 2 days2用户说:
“200 美元以内。”
系统需要理解成:
1price < 2002用户说:
“M 码。”
系统需要理解成:
1size = M2AND3inventory(M) > 04这时候,AI 才真正从“理解一句话”,进入到“理解一个结构化问题”。
5
五、第二层:知识图谱,负责告诉 AI“事实是什么”
Ontology 解决了“意义”。
那么,谁负责提供事实?
答案就是:
Knowledge Graph,知识图谱。
知识图谱存储的不是模型认为“可能正确”的知识,而是业务系统当前确认过的事实。
例如:
1ProductA.color = Blue23ProductA.feature = Waterproof45ProductA.price = 179.9967ProductA.stock = 1289ProductA.shippingTime = 2 days10这几个信息组合起来,才真正构成了一个可以被查询和验证的业务事实。
注意这里有一个非常重要的区别。
LLM 里的知识更接近:
“根据训练数据,我认为这个产品可能是这样的。”
知识图谱里的信息则应该是:
“根据当前业务数据,这个产品现在就是这样的。”
因此可以把两者简单理解为:
Ontology = 规定“它意味着什么”
Knowledge Graph = 保存“现在到底是什么”
二者缺一不可。
6
六、但还有一个问题:谁来把用户语言转换成这些结构?
这就引出了第三层:
/Semantic Orchestration Layer/
可以把它理解为:
语义编排层。
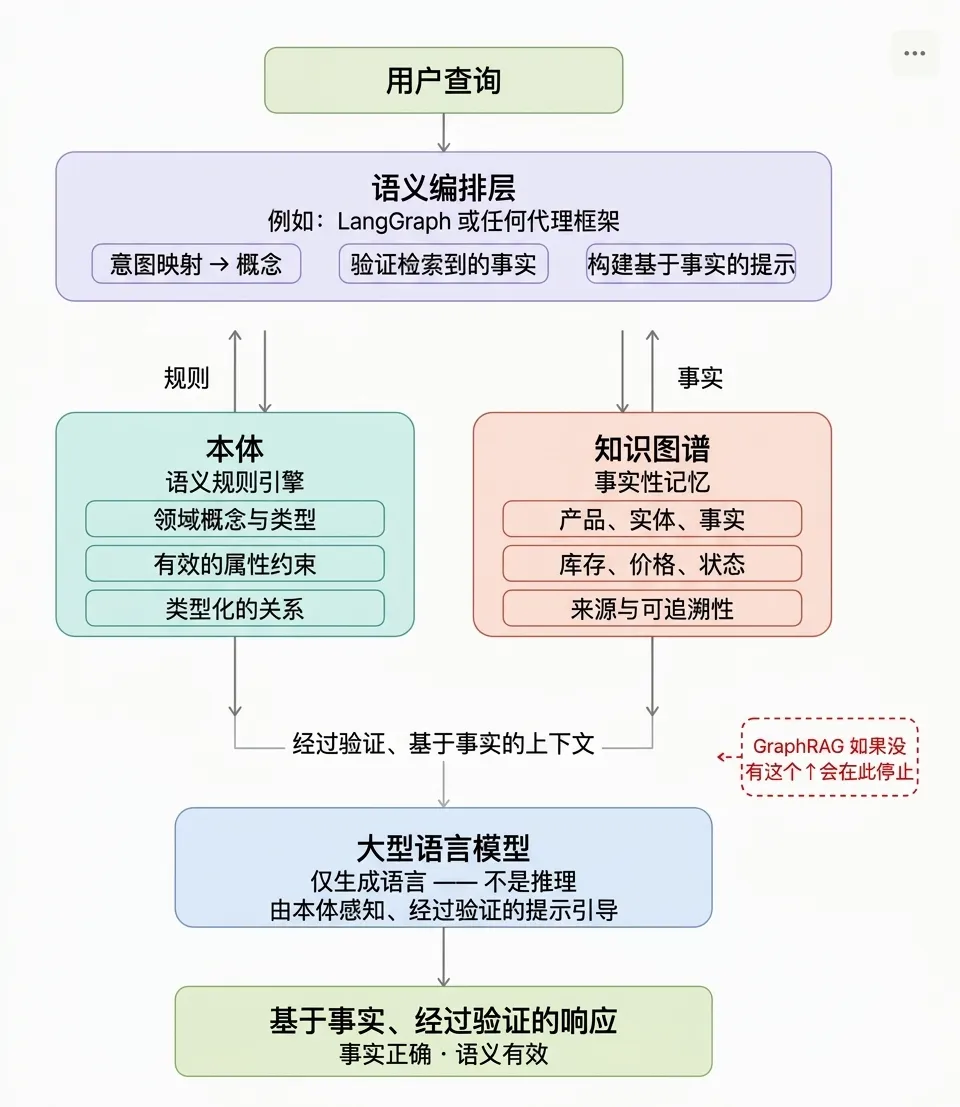
它位于用户、结构化知识和 LLM 之间。
它真正做的事情,不是简单地“调用一个知识库”。
而是负责把:
人类的自然语言
转换成:
系统可以理解、验证和执行的结构化语义。
它通常需要完成几个步骤:
6.1
1. 识别用户意图
例如:
“找一件蓝色防水夹克。”
识别出:
1Product Search26.2
2. 将用户语言映射到 Ontology
例如:
1蓝色 → Product.color23防水 → Product.feature45夹克 → Product.category66.3
3. 决定应该查询哪些实体和关系
系统知道:
这不是简单搜索“夹克”三个字。
而是需要查询:
1Product2Color3Feature4Category5Variant6Inventory7Shipping8Price96.4
4. 构造结构化查询
最终可能转换成:
1feature.waterproof = true2price < 2003size = M4shippingTime <= 2 days5stock > 066.5
5. 验证检索结果
如果知识图谱返回的数据违反 Ontology 规则,就应该在进入 LLM 之前被拦截。
6.6
6. 最后才交给 LLM
LLM 此时不再负责“猜事实”。
它负责的是:
把已经验证过的事实组织成自然语言。
/七、为什么说“GraphRAG + Ontology”比单纯 GraphRAG 更完整?/
可以把两种架构放在一起看。
6.7
GraphRAG
1用户问题2 ↓3知识图谱检索4 ↓5相关节点 / 关系6 ↓7LLM8 ↓9答案10这里的问题是:
LLM 仍然需要自己解释这些信息。
6.8
Ontology + Knowledge Graph + Semantic Orchestration
1用户问题2 ↓3语义理解4 ↓5Ontology6 ↓7结构化查询8 ↓9Knowledge Graph10 ↓11事实验证12 ↓13LLM14 ↓15自然语言答案16这两种方式最大的区别并不是:
“谁检索得更多。”
而是:
谁负责解释和约束这些事实。
在第一种架构中,很多语义判断最终仍然落到了 LLM 身上。
在第二种架构中,语义规则提前被定义,并由系统进行约束。
这意味着:
模型的自由度降低了,但系统的可控性提高了。
而在企业 AI 场景中,这往往恰恰是我们真正需要的。
/八、用一个完整案例看看它到底是怎么工作的/
还是刚才的问题:
“帮我找蓝色、防水、200 美元以内、M 码有货,而且两天内可以送达的夹克。”
如果只使用 GraphRAG:
系统可能找到一堆与夹克相关的节点:
1Jacket A2Jacket B3Jacket C4Waterproof5Blue6Size M72-day shipping8然后把这些内容全部交给 LLM。
接下来模型需要自己判断:
哪些条件属于商品属性?
哪些属于 SKU?
哪些属于物流?
哪些条件必须同时满足?
这时候就存在误判的可能。
而在 Ontology + Knowledge Graph + Semantic Orchestration 架构下,系统会先进行语义解析。
6.9
第一步:Ontology 解析
1blue2→ Product.color34waterproof5→ Product.feature67size M8→ Variant.size9102-day shipping11→ ShippingOption1213under $20014→ Product.price156.10
第二步:知识图谱提供事实
例如查询结果:
1Product A2Color: Blue3Feature: Waterproof4Price: $179.995Size M: In Stock6Shipping: 2 days76.11
第三步:系统执行约束
1feature.waterproof = true2AND price < 2003AND size = M4AND stock > 05AND shippingTime <= 2 days6只有满足全部条件的产品才会进入下一步。
6.12
第四步:LLM 负责表达
最终模型拿到的已经不是一堆未经整理的图谱节点,而是:
已经完成语义解析、事实匹配和规则验证的数据。
于是模型只需要把这些事实组织成自然语言。
例如:
“符合条件的产品共有 3 款。其中 Trailblazer Storm Jacket 售价 179.99 美元,蓝色、防水,M 码有库存,并支持 2 天内配送。”
这里有一个关键变化:
LLM 不再负责决定“这个事实是不是成立”。
它只负责:
把已经成立的事实说清楚。
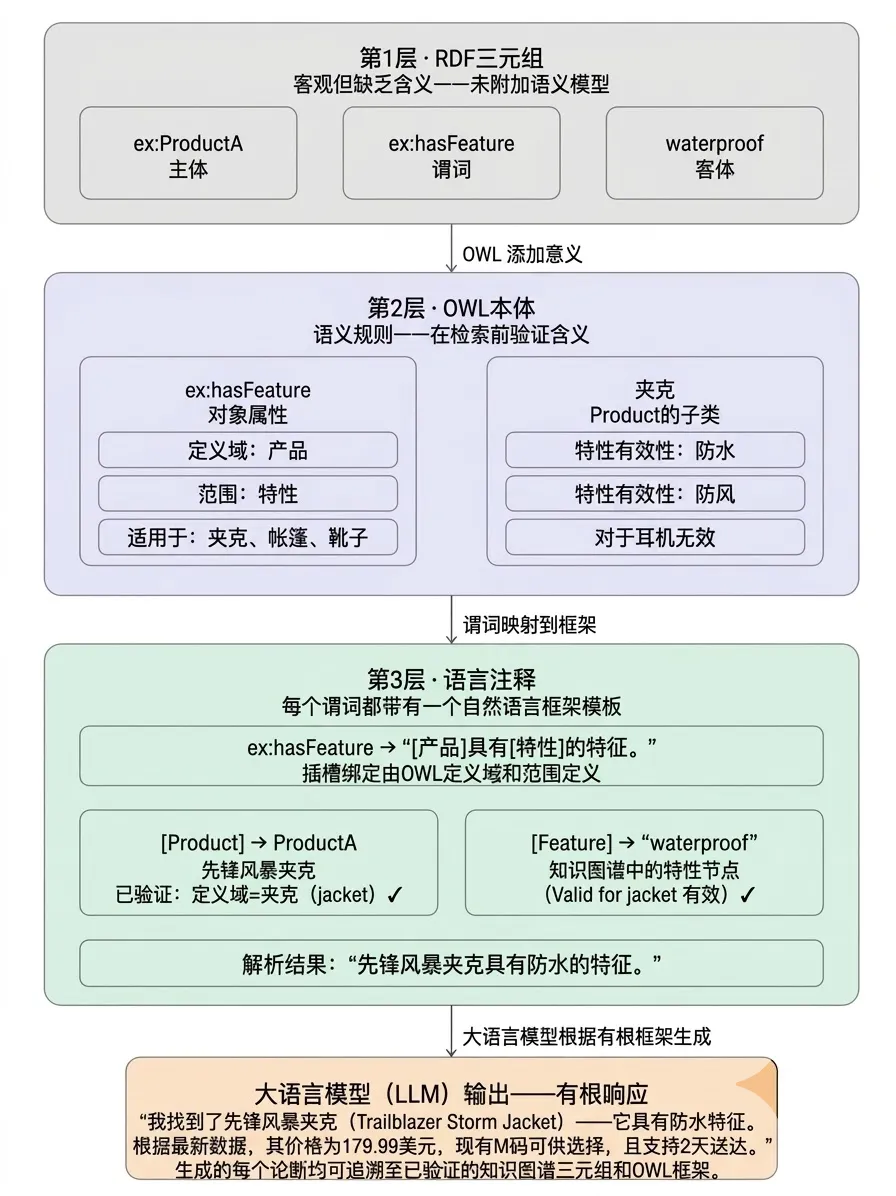
/九、RDF、Ontology、语言层,三层到底是什么关系?/
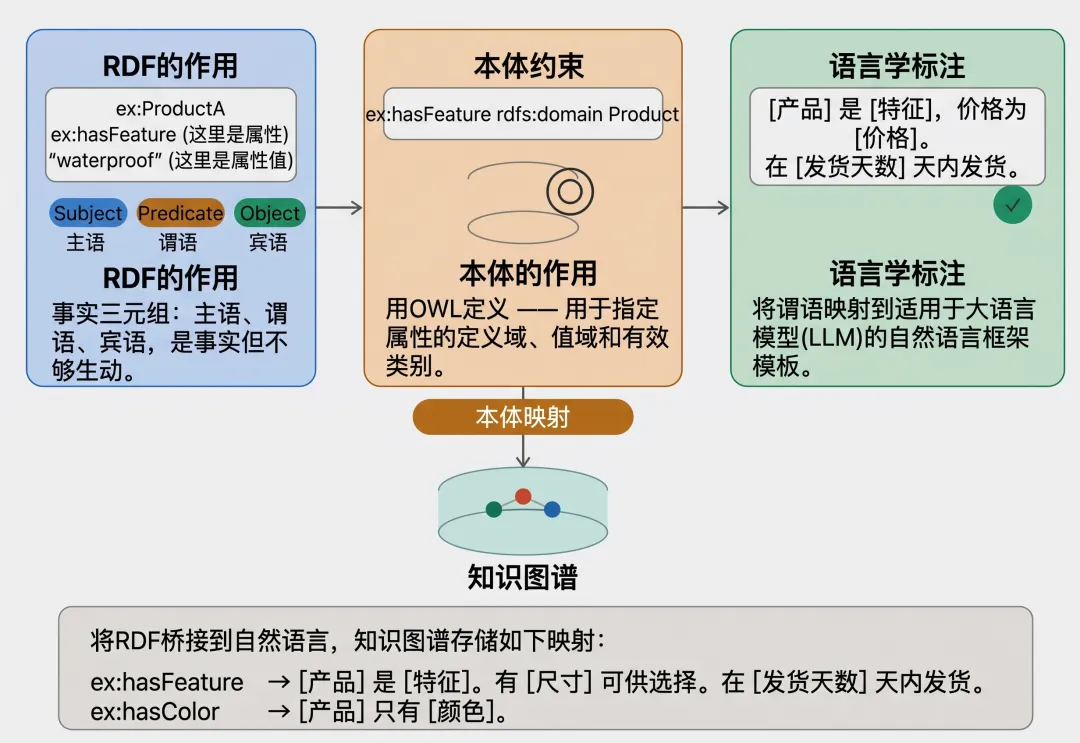
原文还进一步把这个过程拆成了三个层次。
可以简单理解为:
1第一层:事实2第二层:规则3第三层:表达46.13
第一层:RDF Triple
例如:
1ProductA2 → hasFeature3 → waterproof4它只表达一个事实:
ProductA 具有 waterproof 这个属性。
但它并没有告诉系统:
ProductA 是什么类型? waterproof 是否适用于它? 这个关系是否合法? 最终应该如何表达?
6.14
第二层:Ontology
Ontology 会进一步规定:
1hasFeature2domain → Product3range → Feature4同时:
1Jacket2 → subclass of Product3并定义:
1Jacket2 → 允许 Waterproof3如果系统发现:
1Headphone2 → hasFeature3 → Waterproof4而当前领域规则规定这种关系不合法,那么系统就可以在数据进入 LLM 之前发现问题。
这就是所谓的:
Semantic Guard——语义护栏。
6.15
第三层:Linguistic Frame
最后,还需要把结构化事实转换成人类可以理解的语言。
例如:
1hasFeature2→ “The [Product] is [Feature].”3最终得到:
“The Trailblazer Storm Jacket is waterproof.”
这时候,这句话本质上已经不是 LLM“编出来”的。
它是由:
事实 + 语义规则 + 确定性的语言模板
共同产生的。
LLM 只需要把这些已经确认的信息自然地组织起来。
/十、这个架构并不只适用于电商/
电商只是一个容易理解的例子。
实际上,只要一个 AI 系统面对的是:
高价值、强约束、需要准确事实的领域,
这种架构都有价值。
例如:
6.16
医疗
1症状2↓3疾病4↓5诊疗方案6↓7禁忌症8↓9药物10这里不能仅仅依靠模型“根据经验生成”。
6.17
金融
1账户2↓3交易4↓5规则6↓7监管要求8↓9权限10每一个条件都可能直接影响结果。
6.18
企业知识库
1员工2↓3组织4↓5岗位6↓7权限8↓9审批流程10↓11制度12这类问题也不是简单的关键词搜索能够解决的。
6.19
石油、制造、能源等工业领域
同样如此。
例如一个油田智能决策系统可能涉及:
1油田2↓3区块4↓5井6↓7地层8↓9工程参数10↓11设备12↓13施工方案14↓15风险16这些实体之间存在大量明确的业务关系。
如果只是把文档切成 Chunk,然后交给 LLM 做 RAG,模型可能“看到了信息”,但并不意味着它真正理解了这些信息之间的业务约束。
而 Ontology + Knowledge Graph 可以把这些关系显式表达出来。
/十一、所以,真正值得思考的不是“要不要 GraphRAG”/
很多 AI 项目现在会陷入一个误区:
“我们用了 GraphRAG,所以 AI 就不会产生幻觉了。”
其实并不是。
GraphRAG 是一种检索技术。
它解决的是:
如何找到更加相关的知识。
但它并不是完整的 AI 可信架构。
真正完整的系统需要考虑:
1用户意图2 ↓3语义理解4 ↓5Ontology6 ↓7结构化查询8 ↓9Knowledge Graph10 ↓11事实验证12 ↓13Semantic Orchestration14 ↓15LLM16 ↓17自然语言输出18换句话说:
GraphRAG 负责“找东西”,Ontology 负责“理解东西”,Knowledge Graph 负责“确认事实”,Semantic Layer 负责“把这些东西组织起来”,LLM 最后负责“把结果说出来”。
这才是一套完整的分工。
/十二、最重要的变化:让 LLM 从“推理者”变成“表达者”/
这可能是整套架构最值得关注的地方。
传统 AI 应用喜欢把所有事情都交给大模型:
1理解问题2↓3查知识4↓5判断事实6↓7推理8↓9遵守规则10↓11生成答案12这意味着:
模型承担了太多本应该由系统承担的责任。
而新的架构更像这样:
1Ontology2负责定义语义34Knowledge Graph5负责保存事实67Semantic Layer8负责理解意图、查询和验证910LLM11负责自然语言表达12于是,大模型不再需要:
“猜这个事实到底是不是这样。”
而只需要:
“把已经验证过的事实告诉用户。”
这就是为什么这种架构能够显著降低“看起来很合理、实际上并不正确”的回答。
/十三、最终的架构,可以浓缩成四句话/
如果把整篇文章压缩成最核心的四个组件:
6.20
① Knowledge Graph:存事实
What is true?
系统当前真实存在什么?
6.21
② Ontology:定义意义
What does it mean?
这些实体、属性和关系分别意味着什么?
6.22
③ Semantic Orchestration:连接意图与知识
How should we interpret the request?
用户说的话,应该如何映射到结构化知识?
6.23
④ LLM:负责表达
How should we say it?
如何把已经验证的事实,用自然语言告诉用户?
【插图 5:原文最终架构 / Takeaway 图】
/写在最后/
今天我们谈 RAG、GraphRAG、Agent、知识库时,很容易把注意力集中在:
“哪个模型更强?”
“哪个向量数据库更快?”
“哪个 Agent Framework 更好?”
这些当然重要。
但如果 AI 最终需要处理的是一个复杂、专业、有明确业务规则的领域,那么真正决定系统可靠性的,往往不是模型本身,而是:
模型之外的那套结构化知识与语义约束体系。
Ontology 让系统知道:
这些东西分别是什么。
Knowledge Graph 让系统知道:
当前真实发生了什么。
Semantic Orchestration 让系统知道:
用户真正想查询什么,以及应该如何查询。
而 LLM 最后负责:
把这些经过验证的信息,用人类听得懂的方式表达出来。
所以,与其不断要求 AI:
“不要再胡说了。”
不如从架构上减少它需要“猜”的地方。
真正可靠的 AI,并不是一个什么都知道的模型。
而是一套能够让模型:
少猜、可查、可验证、可约束,最后再生成答案的系统。
这或许才是企业级 AI 从“能用”走向“可信”的关键一步。
模型应该是最后一环,而不是整个系统的全部。