ARTICLE · 1113591
AI知识普及 - Harness如何了?
最近一年,你身边可能出现了两种截然相反的声音。一边,很多程序员用 AI 结对写代码,个人效率肉眼可见地提升;另一边,公司层面的软件交付指标却没有明显变化,甚至有的项目因为 AI 生成的代码变慢了。个人快、企业慢——这种分裂,正在成为 2026 年技术圈最普遍的困惑。
如果只把这理解成“个体差异”,就会错过 2026 年 AI 圈最值得关注的一个概念:Harness,模型之外的那套“驾驭系统”。过去大半年,这个词从技术圈的小众讨论,迅速成为 OpenAI、Anthropic、DeepSeek 竞相布局的方向——它就像十九世纪马具匠人为骏马定制的缰绳与鞍具:模型越强,越需要被好好驾驭。
这篇文章我们来一起看看:Harness 是什么、为什么在 2026 年突然爆火、它对 AI coding 和企业落地意味着什么,以及过去半年复盘之后,它会把 AI 带到哪里去。
01 一个正在发生的分裂:个人快,企业慢
先看三组数据。
据 DX 2026 年覆盖约 12.1 万名开发者的研究,93% 的开发者已经在工作中使用 AI,但代码合并吞吐量(PR throughput)只提升了约 9.97%,而 AI 使用量上升了约 65%。用得越来越多,产出却没有同比变多。
据 METR 2025 年 7 月发表的随机对照实验,有经验的开源开发者在自己熟悉的代码仓库里使用 AI 辅助,完成任务反而平均慢了约 19%——而且他们普遍自认为更快,自评与实测完全相反。
据 Stack Overflow 2026 年开发者调查(约 4.9 万份响应),84% 的开发者使用 AI 编码工具,但只有 3% 高度信任 AI 输出,46% 明确不信任。
这三组数据指向同一个矛盾:个人体验上的"快",并没有在组织层面变成"快"。这个矛盾,正是理解 Harness 的入口。
02 Harness 是什么:模型负责思考,它负责干活
Harness 的本义,是“驾驭马匹的挽具”。十九世纪的巴黎,最讲究的马具匠人会为贵族定制缰绳、辔头和鞍具——爱马仕(Hermès)正是 1837 年从一间马具工坊起家的。一件好的挽具,不是把马捆住,而是让马的力量顺着缰绳,精确地传到该去的地方。
今天 AI 圈说的 Harness,正是同一件事:模型像一匹强劲的马,Harness 是那套缰绳与鞍具。行业里流传最广的公式是:Agent = Model + Harness。模型提供智力,Harness 决定它如何调用工具、管理上下文、读写文件、拆分任务、调用子智能体、验证结果、从失败中复盘。中文社区因此也把它译作“驾驭”——harness engineering,就是“驾驭工程”。
前 OpenAI 安全副总裁、Thinking Machines Lab 联创翁荔在 2026 年 7 月的博客里给过一个更激进的判断:AI 自我改进(RSI)的现实路径,大概率先发生在 Harness 层,而不是模型直接改写自己的权重。
拆开来看,Harness 大致由三部分组成:
·执行层:工具调用、沙箱、文件与终端操作——模型怎么"动手"。
·记忆与上下文层:长期记忆、上下文管理——模型"记得"什么。
·治理与评估层:评测、护栏、审计、人机交接——怎么保证它干得对。
这也是为什么同一套模型,换个 Harness,表现可以天差地别。AI Spectrum 的行业统计认为,一个智能体系统中约 98.4% 是基础设施,模型本身只占很小一部分。
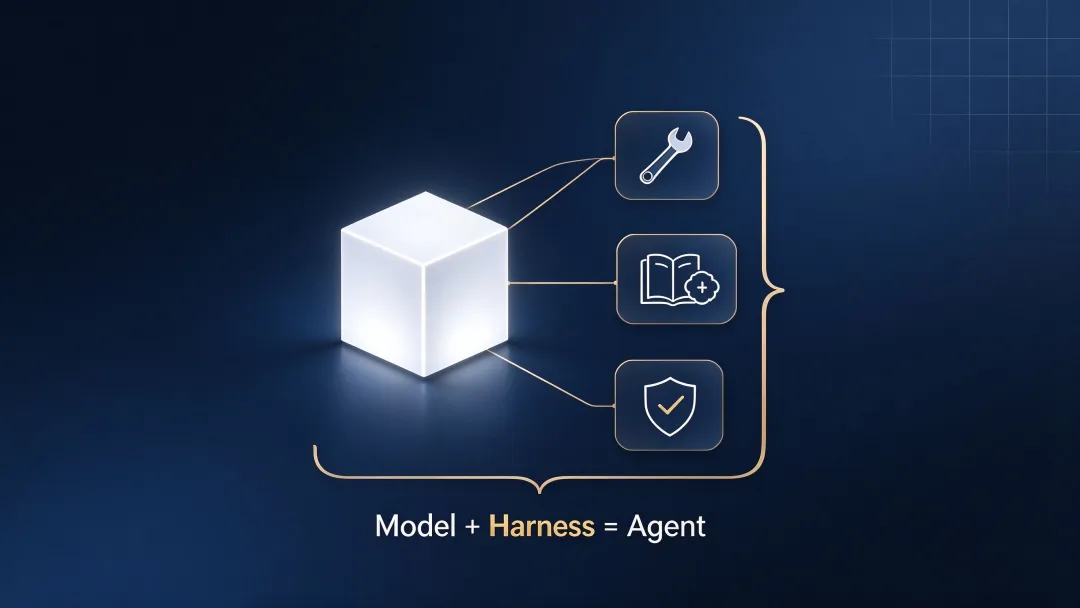
图1:Agent = Model + Harness 的结构示意(示意图)
03 Harness 为什么在 2026 年突然爆火
"系统不只在模型权重里"并不是新认知,AI 领域早就知道:一个系统的成败,很大程度取决于模型之外的工程。那为什么到 2026 年才定名、才爆火?
先看时间线。中文社区把 AI 工程范式概括为三代演进:第一代 prompt engineering(设计提示词)→ 第二代 context engineering(设计上下文)→ 第三代 harness engineering(设计环境,释放模型)。
·2025 年 11 月,Anthropic 发布《Effective harnesses for long-running agents》,系统讨论长时运行智能体的 harness 设计,是最早的完整版本之一。
·2026 年 2 月,OpenAI 发布 harness engineering 指南,披露 Codex 团队用编码智能体写了约 100 万行生产代码、人类零行书写;Mitchell Hashimoto 也公开推广"engineering the harness"的工程实践。
·2026 年 4 月,Thoughtworks 杰出工程师 Birgitta Böckeler 在 Martin Fowler 网站发表奠基文章《Harness engineering for coding agent users》,把此前分散在各家产品里的工程实践,第一次系统化命名为 harness engineering,成为行业公认的框架性文本。
·2026 年 6 月,Claude Code 在开发者社区爆火,把 harness 概念推向大众。
·2026 年 7 月,翁荔发表万字长文《Harness Engineering for Self-Improvement》,中文科技媒体大量解读,引爆中文技术圈。
·2026 年 8 月,DeepSeek 开源 Harness,打出"Model + Harness = Agent""一切皆插件"的旗号,两天内 GitHub Star 接近 10 万,成为该领域增长最快的开源项目之一;2026 年 9 月,OpenAI 也开源了 Codex Harness。
为什么是现在?因为模型能力刚好越过了门槛:代码生成质量已经够好,瓶颈从"模型会不会写",转移到了"模型能不能靠谱地把活干完"。而 Harness 正是决定"能不能干完"的那一层。
04 Harness 对 AI coding 意味着什么
它对 AI coding 的意义可以压缩成一句话:把"能写代码"变成"能完成软件工程任务"。
过去几年,AI 编码的形态走过了"补全 → 对话 → 自主执行"三个阶段。补全和对话阶段,模型只是更聪明的输入法;到了自主执行阶段,模型要自己读仓库、跑测试、改 bug、提交代码,这时候决定成败的就不再是单次生成质量,而是整套 harness——谁给模型规划任务、谁管理它的长期记忆、谁在它出错时把它拉回来。
由此带来一个重要的价值转移:竞争焦点从模型转移到 Harness。Claude Code、Codex、DeepSeek Harness、Cursor 这些产品表面上都在卖"AI 编码能力",实际上比拼的是 harness 设计:上下文怎么管理、工具怎么编排、权限怎么控制、结果怎么验证。
Anthropic 在 2026 年 3 月公开的"三智能体 harness"是很好的例子:一个 planner 负责规划,一个 generator 负责写码,一个 evaluator 负责验收,三者协作可以在数小时内自主完成跨多会话的全栈应用开发。这不是模型变强了,而是 harness 变强了。
05 企业落地为什么这么难:四个障碍
既然 Harness 这么好,为什么企业落地普遍不顺?障碍主要有四个。
第一,验证瓶颈。 AI 生成的代码越来越多,但验证跟不上。Sonar 2026 年的调查(1100 多名开发者)显示,AI 已经占提交代码的约 42%,但 96% 的开发者不完全信任 AI 输出,只有 48% 的人总是验证——代码量上去了,质量闸门却还是人肉模式。
第二,审查流程没有变。 LinearB《2026 软件工程基准报告》发现:AI 提交的 PR 被接手的时间比人工 PR 长 5.3 倍,合并率不到人工 PR 的一半。更重的 agentic AI 采用,并没有转化为更高的价值交付。
第三,组织上下文断裂。 个人 prompt 里的上下文不等于团队知识。遗留系统、跨仓库依赖、历史决策,模型统统看不到。企业要先把"组织记忆"喂给 harness——知识库、架构文档、代码图谱——否则 agent 只会在一堆碎片上下文里瞎猜。
第四,评估器缺失与治理空白。 翁荔在博客里列出了六类隐患:评估器太弱太模糊、上下文与记忆的生命周期、负面结果被忽视、多样性坍缩、reward hacking、短期成功与长期健康的矛盾。企业没有自己的评测与护栏体系,就不敢放开 agent 权限;不放权限,agent 就只能在低风险场景打转。
对应的应对思路是一致的:把 Harness 从"个人脚手架"升级为组织控制平面——先补验证基础设施(测试、CI、评审流程),再建组织上下文(知识库、代码图谱、规范),然后分层放开权限(读 → 改 → 合并),最后建立可观测与回滚机制。
06 大半年过去,Harness 的新叙事
从 2026 年初到现在,Harness 的实践已经长出了三条新叙事。
第一条:开源化成为新竞争维度。 DeepSeek Harness 基于 Cordis 元框架构建微内核架构,"一切皆插件",采用 MIT 协议开放;两天内 GitHub Star 接近 10 万。对比之下,Codex CLI 用了 16 个月才达到约 10.6 万 Star。开放性正在取代单纯的能力比拼,成为新的竞争焦点。
第二条:Harness 开始自我进化。 翁荔博客里介绍的 Self-Harness 循环(发现弱点 → 提出改进 → 验证改进)已经在 MiniMax M2.5、Qwen3.5、GLM-5 上跑出各自不同的 harness 配置;进化搜索 DGM 用 Claude 3.5 Sonnet 从简单配置出发自动进化,SWE-bench Verified 从 20% 提升到 50%,达到甚至超过了人工设计的智能体。Harness 自进化被视为通往自我改进(RSI)最现实的路径。
第三条:从个人工具走向组织级 Harness。 Claude Tag 被不少观察者解读为"组织级 harness";Harness 公司发布了基于知识图谱和 MCP 的 Autonomous Worker Agents;内部开发者门户(IDP)正在成为 agent 治理的控制面。行业里的常见路径是:企业从几百个席位的 pilot 扩到数万个席位,多数选择购买大型厂商的 harness 而非自建——治理与成本,成为这轮叙事的主线。
07 做得好的企业,Harness 长什么样
标杆案例有一个共同模式:AI 干活,人做评审与验收,组织上下文兜底。
Google 是最常被引用的例子。据 Google Cloud Next 2026 年 4 月公布的数据,Google 约 75% 的新代码由 AI 生成并经人工评审,而 2024 年 10 月这个数字还是 25%,一年半增长两倍;复杂代码迁移用 agent 大约快 6 倍。New Relic《State of AI Coding 2026》也印证:67% 的技术领导报告 AI 生成或大幅重构了他们每周 51%–75% 的代码产出。
OpenAI 的 Codex 团队披露过约 100 万行生产代码、人类零行书写——但前提是自建 harness 里有一整套强评测闭环。Anthropic 则把 Claude Agent SDK 明确定义为"驱动 Claude Code 的 agent harness",三智能体协作是其长任务范式的核心。
传统制造与大型企业的例子同样值得看。Siemens 与 Google Cloud 合作,用"知识图谱 + agentic 工作流"的 Knowledge Fabric 自动迁移遗留代码,大幅压缩了人工工作量;汽车零部件企业 Valeo 有 35% 以上的代码由 AI 生成。
这些标杆的共性可以归纳为四件事:强验证闭环、组织上下文(知识图谱与文档)、护栏与审计(权限、沙箱、可回滚)、人机分工。
但需要说明边界:这些是头部企业与领先团队的案例,不代表行业普遍水平。Black Duck 的调查显示,92% 的团队声称 AI 助手改善了生产力(其中 58% 认为是重大改善,平均每周节省约 8 小时),但 90% 的团队遇到过 AI 生成代码相关的流程问题,最大瓶颈正是人工审查。
08 为什么个人快、企业慢:问题不在模型,在 Harness
回到开头的矛盾。个人提效明显、组织提效迟缓,原因不在模型,而在任务结构和 harness 成熟度的双重差异。
个人用 AI 处理的是短任务:一个函数、一段脚本、一次调试。反馈快、上下文自足、出错成本低,模型能力直接兑现为个人速度。所以个人提效本质上是"模型红利"。
企业要面对的是长程任务:跨仓库改动、遗留系统、多团队协作。反馈慢、上下文分散、出错成本高。要让 AI 在这种环境里可靠干活,需要验证、上下文、流程、治理全部跟上——这是"harness 红利",需要组织系统地建设。
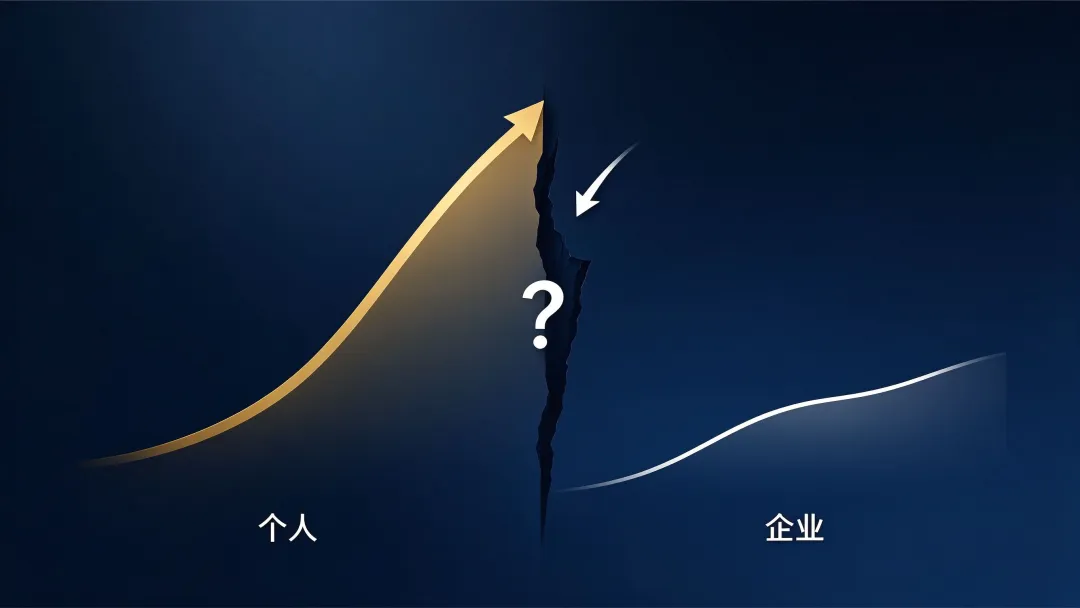
图2:个人提效与企业提效之间的落差示意(示意图)
数据也在佐证这个解释:METR 实验里开发者反而慢 19%,说明验证、上下文、调试的隐藏成本真实存在;LinearB 显示 AI PR 合并率减半,说明流程没跟着改;DX 显示吞吐量只涨 9.97%,说明用量与产出之间隔着度量与组织的转换损耗。Aspire Systems 的白皮书《The AI Acceleration Gap》给出更直白的结论:AI 放大的是组织现有的成熟度,基础没有就位就追求完全自主,是 AI 采纳失败最常见的原因。
一句话总结:个人与企业的差距,不是模型差距,而是 harness 成熟度差距。
09 半年复盘之后,Harness 会走向何方
回到开头的矛盾。过去大半年,Harness 从一个少数人讨论的术语,走进 OpenAI、Anthropic、DeepSeek 的公开战略,这条路本身就很能说明问题。把这半年放在一起看,脉络是清晰的:
·从命名到爆火:2026 年初定名,4 月诞生奠基文章,7 月中文圈引爆,8 到 9 月两家头部厂商先后开源——半年走完了别的概念几年才走完的路。
·从概念到产品:Claude Code、Codex、DeepSeek Harness 短兵相接,竞争焦点从模型能力转向 harness 设计。
·从个人到组织:叙事重心从“个人脚手架”移向“组织控制平面”,治理与成本进入主舞台。
·从人工设计到自进化:Self-Harness、DGM 已经在实验里跑出接近甚至超过人工设计的 harness。
复盘之后,下一步值得盯四个方向。
·开源生态化:DeepSeek Harness 的“一切皆插件”如果跑通,插件市场与事实标准之争会成为新战场,甚至可能出现 harness 生态的“应用商店”。
·自进化能否跨过评估器瓶颈:翁荔列出的六类隐患里,最关键的变量是评估器——评估器足够强,harness 才能可靠地自我改进。未来几个季度,评测基准与验证体系能否成熟,决定自进化是停留在论文里,还是进入产品。
·组织级 harness 收敛为产品:企业从几百个席位的 pilot 扩到数万个席位,买现成的还是自建,会推动组织级 harness 的产品形态快速收敛。
·模型与 harness 的边界重构:模型会不会把 harness 的能力内化?harness 会不会反过来定义模型的训练目标?如果自我改进真的先在 harness 层实现,这两者的边界会持续移动。
判断信号上,接下来几个季度值得跟踪三件事:开源 harness 生态的活跃度(插件数量与采用率)、自进化在公开基准上是否出现可复现的跃升、头部企业是否公布可验证的组织级提效数据——而不是使用量数据。
AI 提效的分水岭不在模型参数,而在 harness 成熟度。过去半年,这个判断从少数人的直觉变成了行业共识;下一步真正值得看的,不是模型又强了多少,而是 Harness 这层“驾驭系统”进化得有多快。