ARTICLE · 1113598
让你的「AI 团队」读懂公司内部文档: 给多智能体接上本地知识库, 数据一个字节不出门
开源大模型 · 实战进阶
上一篇搭的 AI 团队,有个「短板」
上一篇咱们用 CrewAI + Ollama,在一台电脑上搭了个能协作的『AI 团队』——研究员、写手分工干活。很多人跟着搭起来了,但用着用着发现一个短板:这个团队,只会用模型脑子里的『通用知识』,读不了我公司自己的资料。
你让它『帮我基于公司的产品手册,写一份客户答疑』——它不会,因为它没见过你的产品手册;你让它『分析一下我们内部这份市场报告』——它两眼一黑,那报告在你硬盘里,它够不着。一个只懂通用知识、却读不了你私有资料的 AI 团队,能干的活儿,是很有限的。
今天这篇,就来补上这个短板——给你的 AI 团队,接上一个本地知识库。 让团队里的 Agent,能去检索、读取你自己的内部文档(产品手册、市场报告、规章制度、历史资料……),再基于这些私有资料去分析、去创作。
这一篇,其实是把咱们之前写透的两块,拼到一起:多智能体(CrewAI 的 AI 团队)+ 本地知识库(RAG)。——让 AI 团队既能『协作』,又能『读懂你的私有资料』,而且,资料全程在本地检索,一个字节不出门。
全程带真实可跑的代码,还会讲一个大多数人不知道、但特别重要的『两种接法』的门道。做企业内部 AI、想让 Agent 用上私有资料的朋友,建议收藏。
一、核心思路:知识库,是给 Agent 的一个「工具」
先讲清楚『多智能体怎么接知识库』这件事的核心思路。它比你想象的简单——知识库,对 Agent 来说,就是一个『工具』。
还记得咱们讲 Agent 机制、讲 MCP 时说的吗?Agent 的一大本事,是『调用工具』。查天气是个工具、发邮件是个工具……而『去知识库里检索资料』,也可以封装成一个工具。你把这个『知识库检索工具』,配给团队里需要它的那个 Agent,它就获得了『查阅私有资料』的能力。
打个比方:你的 AI 团队,原本是几个『闭卷考试』的学生——只能靠脑子里记的答题。接上知识库这个工具,相当于给他们发了本『允许翻阅的参考资料』——遇到不懂的,可以去翻你的内部文档,再回答。
好消息是:CrewAI 已经把这些『知识库检索工具』做成现成的了,你不用自己从零写。 它内置了一堆专门的 RAG 检索工具(RAG 就是『检索增强生成』,咱们之前专门讲过),覆盖各种文档格式。你直接拿来用,给 Agent 一配就行。下面看有哪些。
二、CrewAI 现成的知识库工具,一抓一大把
CrewAI 的工具箱里,针对『检索不同类型的资料』,准备了一堆开箱即用的 RAG 工具。挑几个最常用的给你:
| PDFSearchTool | ||
| DOCXSearchTool | ||
| TXTSearchTool | ||
| DirectorySearchTool | ||
| PGSearchTool | ||
| RagTool |
看这张表,你想检索什么格式的资料,基本都有对应的现成工具。 想让 Agent 读你的产品手册(PDF)?用 PDFSearchTool;想让它读整个『公司资料』文件夹?用 DirectorySearchTool;想让它查数据库?用 PGSearchTool。这些工具,本质上都是帮你把『文档→切分→向量化→检索』这套 RAG 流程封装好了,你只管把文档路径给它,它就能语义搜索。 一行 pip 就能装上:
# 安装带工具的 CrewAIpip install 'crewai[tools]'三、上手:给 AI 团队接一个 PDF 知识库
直接上代码,给上一篇那个『研究员 + 写手』团队,接上一个知识库——让研究员能去查你的内部 PDF 资料。
第一步:把知识库工具准备好
用 PDFSearchTool,指向你的内部文档。关键是——让这个工具的检索,也用本地模型(Ollama),这样连『把文档向量化』这步,数据都不出门:
from crewai_tools import PDFSearchTool# 创建一个知识库检索工具,指向你的内部PDF# 并配置它用本地 Ollama 做嵌入和检索(数据不出门!)rag_tool = PDFSearchTool( pdf='./公司资料/产品手册.pdf', config=dict( llm=dict(provider="ollama", config=dict(model="qwen2.5:7b")), embedder=dict(provider="ollama", config=dict(model="nomic-embed-text")), ))# ★注意:llm 和 embedder 都指向本地 Ollama# 检索、向量化全在本地,私有文档一个字节不外传盯住那个 config——它把工具的『大模型』和『嵌入模型』都指向了本地 Ollama。 这一步是数据安全的关键:知识库检索,底层要把你的文档切分、向量化(嵌入),再语义搜索。如果用云端的嵌入服务,你的私有文档就发出去了。全用本地 Ollama,整个检索过程就锁在你机器里,私有资料一个字节不出门。 这正是咱们最看重的。
第二步:把工具配给需要它的 Agent
然后,把这个知识库工具,配给『研究员』Agent(它负责查资料,最需要这个能力):
from crewai import Agent, Task, Crew, Processfrom langchain_community.llms import Ollamalocal_llm = Ollama(model="qwen2.5:7b")# 研究员 Agent —— 给它配上知识库工具researcher = Agent( role='资料研究员', goal='基于公司内部资料,准确回答问题', backstory='你擅长从公司文档里精准找到需要的信息', tools=[rag_tool], # ★把知识库工具配给它! llm=local_llm, verbose=True,)# 写手 Agent —— 不需要查资料,不配工具writer = Agent( role='答疑撰写', goal='把研究员找到的信息,写成通俗的客户答疑', backstory='你擅长把专业内容,讲成客户能听懂的话', llm=local_llm, verbose=True,)关键就那一行 `tools=[rag_tool]`——把知识库工具挂到研究员身上。 这样,研究员 Agent 在干活时,就能自己去调用这个工具、检索你的产品手册了。而写手不需要查资料,就不配工具。你看,工具是『按需分配』的:谁需要什么能力,就给谁配什么工具。 这也是多智能体的灵活之处——每个 Agent 可以有自己独特的一套装备。
第三步:派活儿、开跑
剩下的就跟上一篇一样了——派任务、组团队、开跑:
# 派任务:让团队基于产品手册,写一份答疑research_task = Task( description='从产品手册里,找出关于"退换货政策"的规定', expected_output='退换货政策的关键条款', agent=researcher,)write_task = Task( description='把退换货政策,写成一段通俗的客户答疑', expected_output='一段客户能看懂的答疑文字', agent=writer,)crew = Crew( agents=[researcher, writer], tasks=[research_task, write_task], process=Process.sequential,)result = crew.kickoff()# 研究员去手册里查退换货政策 → 写手写成通俗答疑# 全程基于你的私有文档,数据不出门跑起来后,神奇的事情发生了: 研究员 Agent 接到任务,自己判断『这个我得去查手册』,于是调用知识库工具,在你的产品手册里语义搜索『退换货政策』,把找到的条款整理出来;然后交给写手,写成通俗答疑。整个过程,团队用的是你的私有资料,而不是模型瞎编——这就解决了『AI 一本正经胡说八道』的问题,答案有你的文档兜底。 而且,资料检索全在本地,安全。
四、进阶门道:接知识库,其实有「两种接法」
上面那种接法能用了,但这里有个大多数教程不会告诉你的深层门道——给 Agent 接知识库,其实有两种不同的『范式』,各有优劣。 搞懂它,你才能根据场景选对接法。
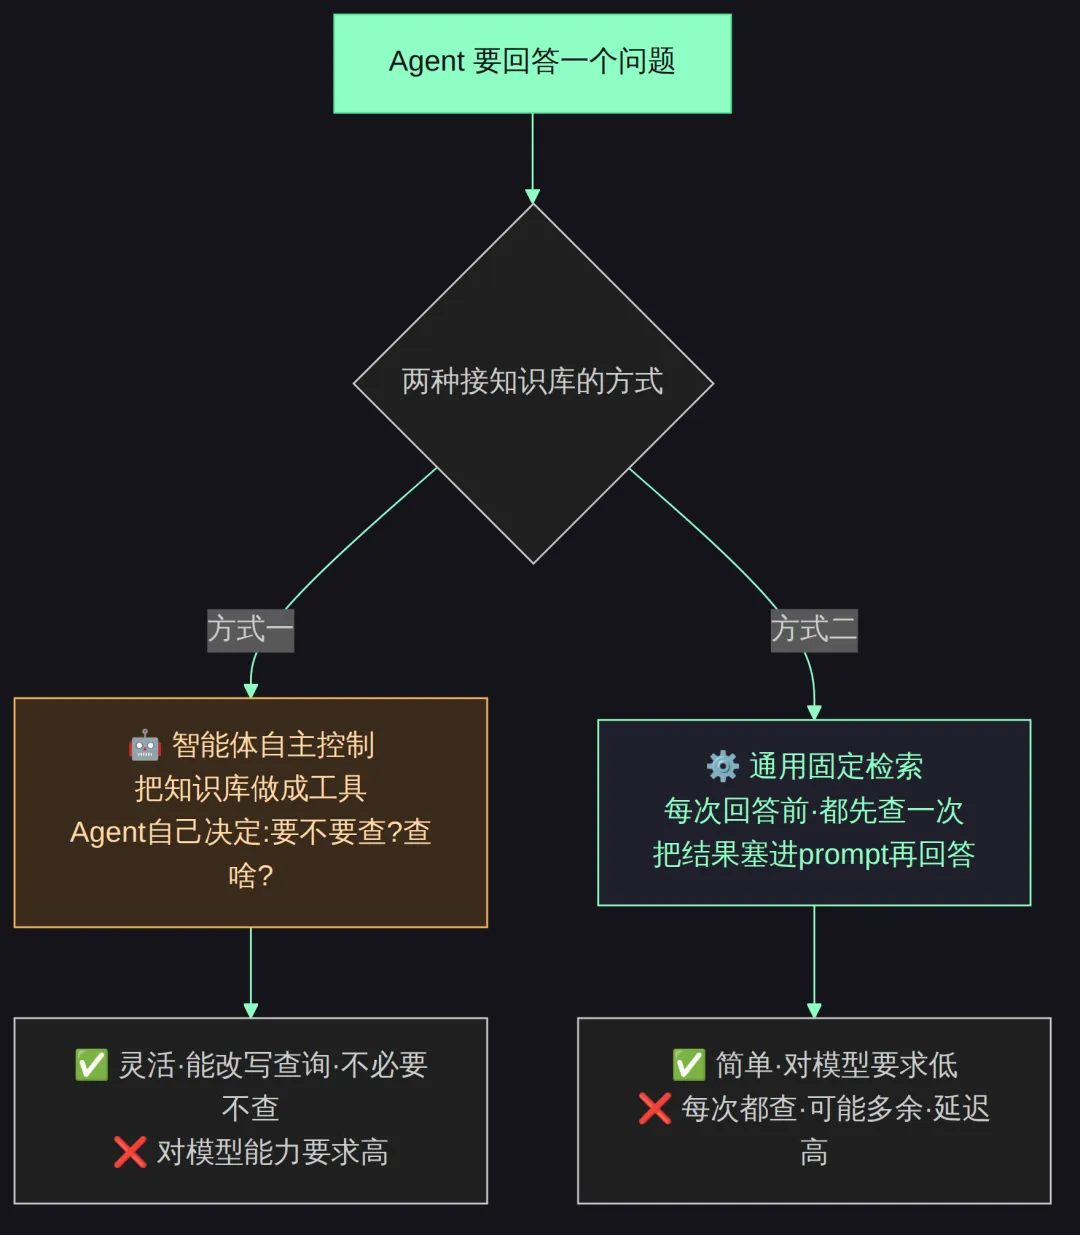
这两种范式,是接知识库的核心分野,给你掰扯清楚:
- 方式一·智能体自主控制
:就是前面代码那种——把知识库做成一个『工具』,配给 Agent,让 Agent 自己判断『这个问题要不要查知识库、该查什么关键词』。好处是灵活(它能根据上下文改写查询、简单问题不查省时间),坏处是——它需要模型『够聪明』,能做出正确的判断。这跟咱们讲 Agentic RAG 时那个『会思考的 RAG』一脉相承 - 方式二·通用固定检索
:更简单粗暴——每次 Agent 回答前,都固定先去知识库查一遍,把检索到的资料,直接塞进给模型的提示词里。好处是实现简单、对模型要求低(不用它自己判断);坏处是每次都查(哪怕这个问题根本不需要查),会有多余的检索、拖慢速度
一句话教你怎么选:模型能力强(用的模型够聪明)、追求灵活 → 用『自主控制』(配工具);模型能力一般、图简单稳定 → 用『固定检索』(每次都查)。——本地小模型,有时候『固定检索』反而更稳,别硬让它自己判断。
这个门道很实用: 你用本地 7B 小模型搭 AI 团队时,它的『判断力』不一定够强。这时候,与其让它自己纠结『要不要查知识库』(方式一,可能判断失误),不如干脆每次都查一遍(方式二,虽然笨但稳)。选哪种,取决于你的模型有多强、你的场景要多灵活——没有绝对的好坏,只有合不合适。
五、几个实用提醒
① 嵌入模型也要用本地的
接知识库,数据安全的关键在『嵌入』这步(把文档转成向量)。一定要用本地嵌入模型(如 Ollama 的 nomic-embed-text),别用云端嵌入服务,否则你的私有文档在向量化时就发出去了。这是数据不出门的命门。
② 只给需要的 Agent 配知识库工具
别给团队里每个 Agent 都配知识库工具。谁的职责需要查资料(比如研究员、分析师),就给谁配;负责写作、汇总的 Agent 不用配。按职责分配工具,清晰又高效。
③ 文档要先『治理』好
知识库效果好不好,七分靠文档质量。喂进去的文档要干净、结构清晰。乱七八糟、格式混乱的文档,检索效果会很差。别指望 RAG 能救回一堆垃圾资料——垃圾进,垃圾出。
④ 本地小模型,优先考虑『固定检索』
前面说了,本地小模型判断力有限。如果你发现 Agent 老是『该查的时候不查、不该查的时候乱查』,别硬用自主控制,换成每次固定检索,稳定性会好很多。
⑤ 大知识库,注意检索延迟
知识库特别大时,每次检索都要时间。如果用『固定检索』(每次都查),延迟会累积。这时候要么优化向量库、要么改用『自主控制』(该查才查),平衡好速度和效果。
从上一篇『会协作的 AI 团队』,到这一篇『能读懂你私有资料的 AI 团队』——就差了一个『知识库工具』。你只需要用 CrewAI 现成的 RAG 工具,配给团队里需要查资料的 Agent,你的 AI 团队,就从『只懂通用知识』,升级成了『能基于你的内部文档干活』。 产品手册、市场报告、规章制度……这些你最宝贵的私有资料,终于能被你的 AI 团队用起来了。
而这次升级,依然守住了那条最重要的底线——数据一个字节不出门。 只要模型和嵌入都用本地 Ollama,你的私有文档,从切分、向量化、到检索,全程锁在你自己的机器里。你的 AI 团队,既有了『读懂私有资料』的能力,又没有把这些敏感资料,交给任何第三方。这对企业内部场景,是决定性的——很多公司不敢用云端 AI,怕的就是资料外泄;而本地知识库 + 本地多智能体,恰好给了它们一个『既智能、又绝对安全』的选择。
到这儿,咱们这条『本地 Agent』的线,已经拼出了一幅相当完整的图景:Ollama 跑本地模型(底座)、CrewAI 编排多智能体(协作)、RAG 接本地知识库(读私有资料)、Agent-Reach 读全网(获取外部信息)、MCP 接更多工具(能力扩展)…… 一块块开源积木,拼出了一个既能协作、又懂你私有资料、还能上网、完全数据可控的『私人 AI 团队』。这支团队,只服务于你,只听你指挥,只用你的资料,数据只留在你手里——它不属于任何巨头,它只属于你。 这,就是开源和本地部署,给这个时代每一个普通人和每一家普通公司,最珍贵的礼物:真正属于自己的 AI 能力。
你会给你的 AI 团队,接上什么样的知识库?公司手册、行业资料,还是你自己的知识积累?评论区聊聊你的用法。想看『本地 AI 团队 + 知识库,搭一个企业内部智能问答系统』的完整落地实操,留言告诉我,下一篇安排。
开源大模型持续追踪开源 AI 前沿动态与行业落地做企业内部 AI 的朋友,转发给同事,搭一个懂你私有资料、又绝对安全的 AI 团队 ~