ARTICLE · 1113684
给AI装"记忆银行"?这个框架让视觉模型在雾雨雪夜不同环境里越用越聪明!
论文:Pseudo-label Refinement and Model-State Recovery for Continual Test-Time Adaptation on Semantic Segmentation 期刊:International Journal of Computer Vision
一快速了解
如果AI自动驾驶只在晴天的情况下学过开车,那么到了大雾天就会看不清路,到了夜里就会认错东西。
怎么解决呢?让它"边开边学"?结果它自己写的教材错字连篇,而且学了这个忘了那个,像是学会雪天驾驶就把雨天本领忘光。
而这篇论文主要解决的就是这两个情况。首先是教材问题,它让AI把自己写的教材送进一个修图式的去噪流水线,把错字修掉再学。其次论文给AI建了一个游戏存档机,雨天就调用雨天的存档,黑夜就调出黑夜的存档,互不干扰。
结果就是这个AI在反复变幻的恶劣天气里越开越稳,而不是像原来一样越学越废。不过目前这套方案里面的修教材有点太耗时间了,下一步研究就是怎么加快这个步骤。
二论文三问
**What:**论文提出了PRMR框架,它可以让在晴天街道数据上训练的语义分割模型在雾,夜,雨,雪等不断切换的恶劣真实环境中持续自我适应,并且还能"记住"每个环境该怎么去应对。
Why:如果让模型使用现实世界的不恒定测试集去自我学习,由于天气,光照和设备一直在变,就会导致模型边用边退化。这是模型用自己生成的不可靠标签学习导致的错误滚雪球。另一方面,不断适应新环境又会冲掉旧本事(灾难性遗忘)。这两个问题一直是持续测试时适应(CTTA)的死结。
**How:**论文采用双管齐下的方式解决了这两个问题,首先是用扩散模型对不可靠的伪标签"迭代去噪"(DPR)。其次就是用一个记忆银行存下每个域对应的模型状态,这样一来,每一张图就可以先检索出最匹配的历史状态,再继续去适应(DMR)。
三核心创新
论文是**首个把扩散模型用于CTTA分割的伪标签纠错机制(DPR)**的。这不是简单的过滤噪声标签,而是借用扩散模型"先加噪再去噪"的迭代修复能力,来把不确定区域的错标一点点的"修"好。
其次,论文还创新的使用 **域感知的模型状态恢复算法(DMR)**成功把"持续适应"这个大难题拆解成了一串独立的小"单域适应"任务。每来一张图,就先判断它像哪个老环境,然后再把模型调回那个环境的状态去学,这样就能避免新旧知识互相打架。
论文在细节方面也下足了功夫。像是利用小目标保护策略来防止扩散模型把像素占比极小的小物体(行人、交通标志)当成噪声"擦掉"。
最后,论文对自己提出的方案进行了长程适应稳定性实证。结果显示这套方案在两个基准上的三轮重复适应都不掉点,ACDC自然场景的mIoU能达到 62.7%(+6.0%),眼底图像Dice也有 73.05%(+7.19%),超越了当前最优的CTTA方法。
四实验流程拆解
1、问题诊断:模型在"变脸"世界里会越学越错
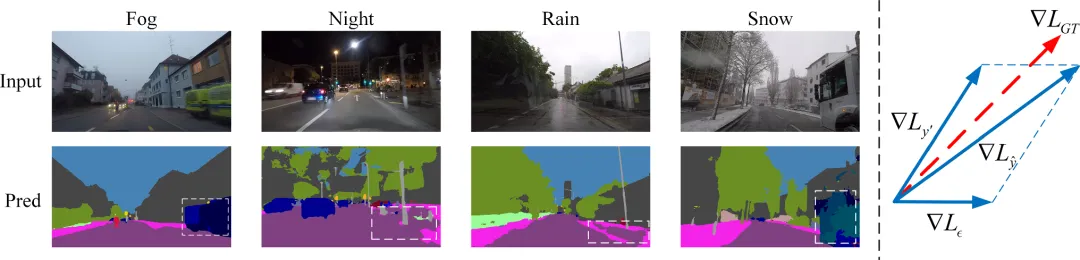
图1:域偏移下,教师模型生成的伪标签在不确定区域充满错标,直接拿来学习会让误差越滚越大。
语义分割要求模型给图像的每个像素分类,这也是自动驾驶和医学影像的底层能力。但在这个技术下,如果将一个在晴天城市街道(Cityscapes)上训练的模型给直接扔进雾天,黑夜,暴雨或大雪这种极端环境下,那么模型的性能会出现明显的崩塌,而这就是所谓的域偏移。
为了解决域偏移,传统域适应方法就需要源数据和目标域一起进行重训。可隐私限制往往会让源数据根本拿不到。于是持续测试时适应(CTTA)便应运而生。这个方法可以让模型在推理时用自己生成的伪标签当教材边用边学。
而问题也在这时出现了,因为教师模型在陌生域里的预测本来就不可靠,所以不确定区域的错误标签会持续的污染训练,最终导致误差累积和灾难性遗忘。到此,模型就会越用越废。而这篇论文的工作正是对两个病灶同时下刀。
2、DPR:用扩散模型给伪标签"去噪修复"
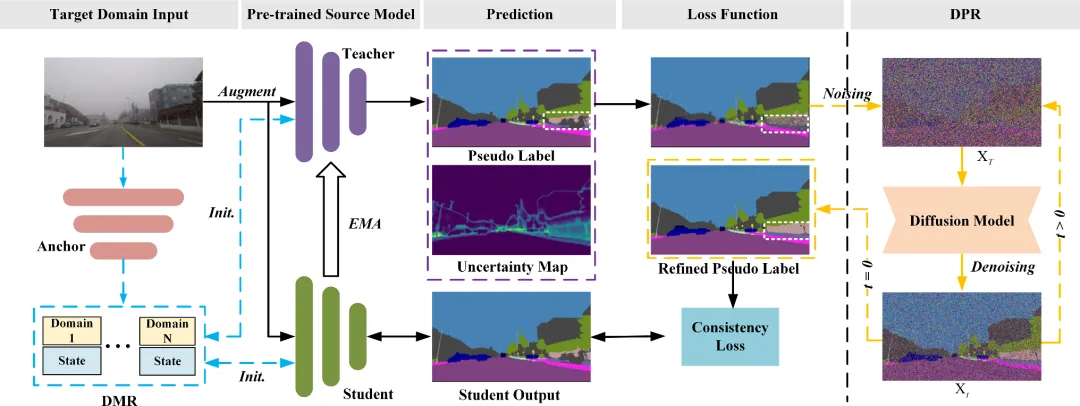
图2:PRMR整体框架。记忆银行检索历史状态初始化模型,教师出伪标签,扩散模型精修后监督学生。
论文首先是观察到了标签是跨域不变的的这个现象。比如说不管是大雾还是黑夜,车都该被标成车。再加上既然图像要适应域,那么标签只需要"变好"就行。
依此,论文先用熵图找出了模型拿不准的那些像素,并且只保留这些像素的概率最高的两个候选类别。然后,再把这份"七分对三分错"的伪标签送入到扩散模型的加噪链里,这可以让错误信息在正向过程中被衰减稀释,同时,在反向过程中,模型可以凭借从源域标签学到的分布知识把标签一步步的重建回来。
这样一套下来,错的地方就可能被"修"对。外加小目标保护,即像素占比低于3%的类别原样保留,来防止其被当成噪声抹掉。最后的消融结果显示,光DPR就能单独带来+4.6%的 mIoU。
3、DMR:记忆银行让模型"到什么山唱什么歌"
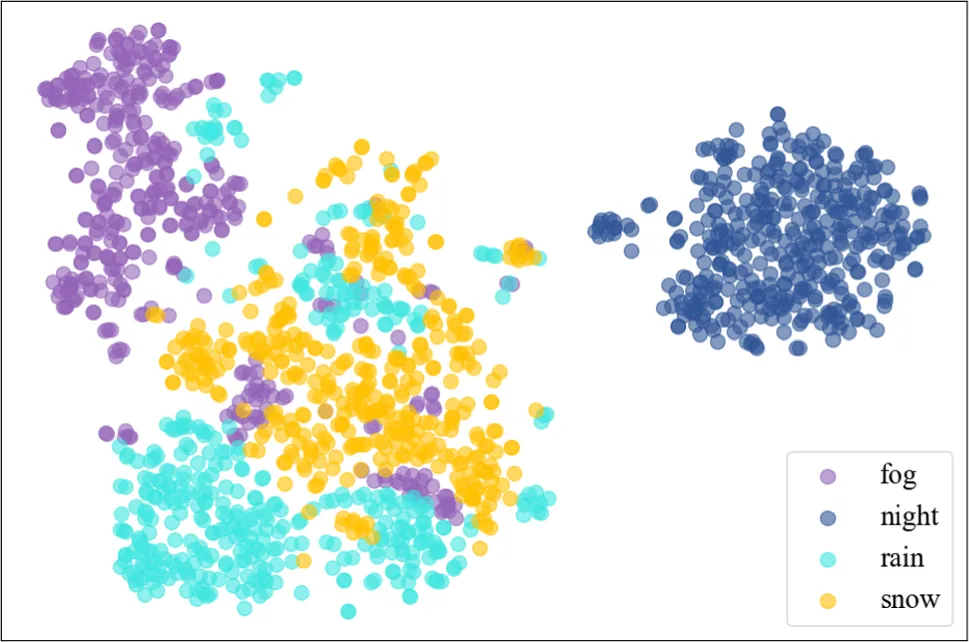
图3:t-SNE可视化显示不同天气域的特征在空间中明显分簇,这正是单模型连续适应会"精神分裂"的原因。
为什么需要记忆银行?t-SNE可视化给出了直观的答案。雾,夜,雨和雪的样本在特征空间里会各自抱团,导致域间的差异巨大。如果像原来那样,让一个模型在四个簇之间进行连续横跳,那么参数就会反复的"东倒西歪",导致学新忘旧。
而DMR的解法是给每个域单独建一个"存档点"。当一个新域到来时,先用前30张图的特征均值建立该域的"钥匙",并存入对应的教师,学生与优化器的完整状态。那么之后每来一张图,就先让其与记忆银行里所有钥匙计算余弦相似度。如果匹配上了,就调出那个域的存档来继续适应。如果连续三次都匹配不上,就将其判定为全新的域并存新档。将整个序列重复三轮,发现模型能随时"读档",这样旧知识就不会再被冲掉。到此,这一项单独贡献了+5.0% 的mIoU。
4、实验结果:两个基准全面领先且三轮不衰
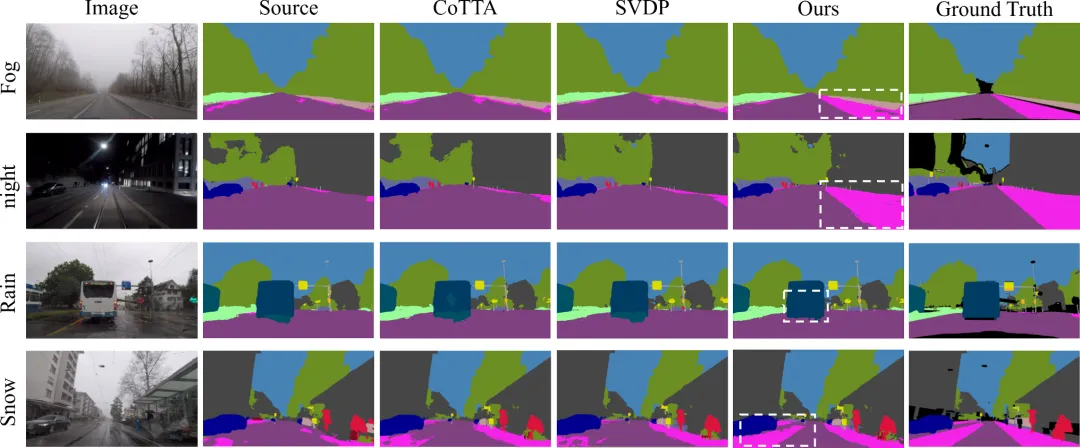
图4:定性对比。在ACDC各域上,PRMR(最右列)在人行道、公交车等类别上明显优于源模型与CoTTA、SVDP。
论文把主实验设置的相当严苛。它让图像流式输入,且每张只用一次。四个天气域按固定顺序进行连续切换,参数跨域也不重置,将整个序列再重复三轮后去检验遗忘。
最终结果显示,在Cityscapes→ACDC上,PRMR达到了62.7%的 mIoU,这比仅用源模型高出了6.0%,超过了此前的最优方法。
而在五个医疗机构的眼底OD/OC数据集上,它也达到了73.05% 的Dice(+7.19%),而且三轮适应性能都稳定在了72.85%→73.12%→73.17%,可以说几乎零衰减。而对照方法普遍因误差累积而越跑越差。
消融则证实了DPR与DMR会相互增益,合计比常规师生框架高出了3.1%。而且论文还发现算法会自动的把雨和雪识别为同一个"域模式"(这是由于特征空间过于相似),因此仅用三个存档点就行了,这充分展示了按数据驱动的域划分能力。
5、伪标签到底被修好了吗:眼见为实
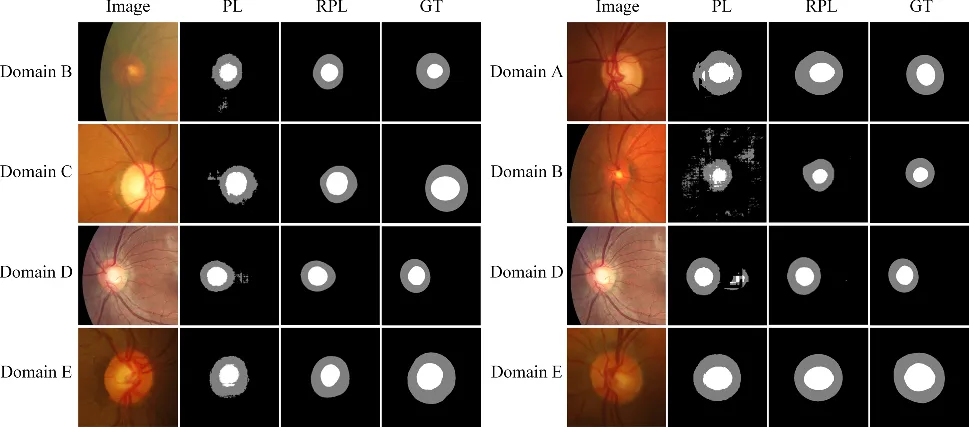
图5:精炼前后的伪标签对比。扩散模型让物体边界更锐利、轮廓更连贯,模糊区域的虚假预测被有效抑制。
定性验证则给出了最直观的证据。在眼底图像上,DPR精炼后的伪标签往往边界更锐且轮廓更平滑连贯,模糊地带的细碎噪声和虚假预测被明显的压制了。
这其实是恰好利用了扩散模型所擅长的建模结构先验的特点。因为眼底的目标区域本就是光滑的椭圆结构,所以扩散模型能把预测"拉"向更符合真实分布的形状。在自然场景中同样如此,人行道或公交车等此前被错标的类别得到了显著改善。
但这个改善的代价是算力。完整的流程速度是12.98秒/张,这比基线的4.53秒/张慢了近三倍。其中扩散去噪占了大头,但换来的IoU比最新竞品都高出了0.5,属于是"用时间换质量"的明确交易。
五核心结论
论文首先是证明了伪标签质量是CTTA的第一瓶颈,并成功使用扩散模型迭代精修不确定区域的方法,做到了DPR单项+4.6% mIoU的成绩。
第二个结论是 "拆解+存档"的方法可以治遗忘。而且可以达到DMR单项+5.0% mIoU,且三轮适应几乎零遗忘的效果。
最后,论文还确定了域的划分是可以交给数据的。以及上面两个方法是会相互增益的。
六局限与未来
论文所提的方法,其最大的局限就在于计算的开销大。像180步去噪会让推理时间达12.98秒/张,这是基线的近三倍,在实时场景(如车载)目前真的用不起。
其次就是随域增长而上升的存储成本问题,每个新域需要约1.26GB的磁盘存档,超出后只能映射到最相似的旧域,这可能会损失精度。
最后,依赖教师-学生范式的问题依然存在。这使得伪标签路线的天花板仍在,且相似度阈值ρ,去噪步数t等超参数还需按场景去调。
下一步,进行轻量化扩散,来减少采样步数。或用轻量架构把去噪开销打下来是一个方向。而针对存储成本问题,则可以进行参数化存档,用LoRA或提示向量代替完整模型状态来把1.26GB/域压到MB级。