ARTICLE · 1115986
8G显存+16G内存电脑本地部署LLM推荐
国庆也是终于有空了,来做一期消费级电脑的本地AI部署推荐。
由于网上测评结果基本都是基于无量化版进行,对真正想要本地部署AI的人参考意义不大,因此我挑选了几款口碑不错的模型的量化版本进行测试。
模型测试全都使用我本地电脑进行,使用三套学术界通用的公开基准:OpenAI 的 HumanEval(考代码)、GSM8K(考小学数学推理)和 Berkeley 等高校的 MMLU(考知识广度)。
参赛选手有 gemma-4-26B-A4B-it-UD-IQ3_S(11.3GB)、Ornith-1.5-9B-Q4_K_M(5.8GB)、Qwen3.5-9B-UD-Q4_K_XL(6.1GB)、Qwen3.5-4B-UD-Q5_K_XL(3.3GB),外加 DeepSeek V4.1 Flash 网页版作为参照。
下面是测试结果:
一、无思考
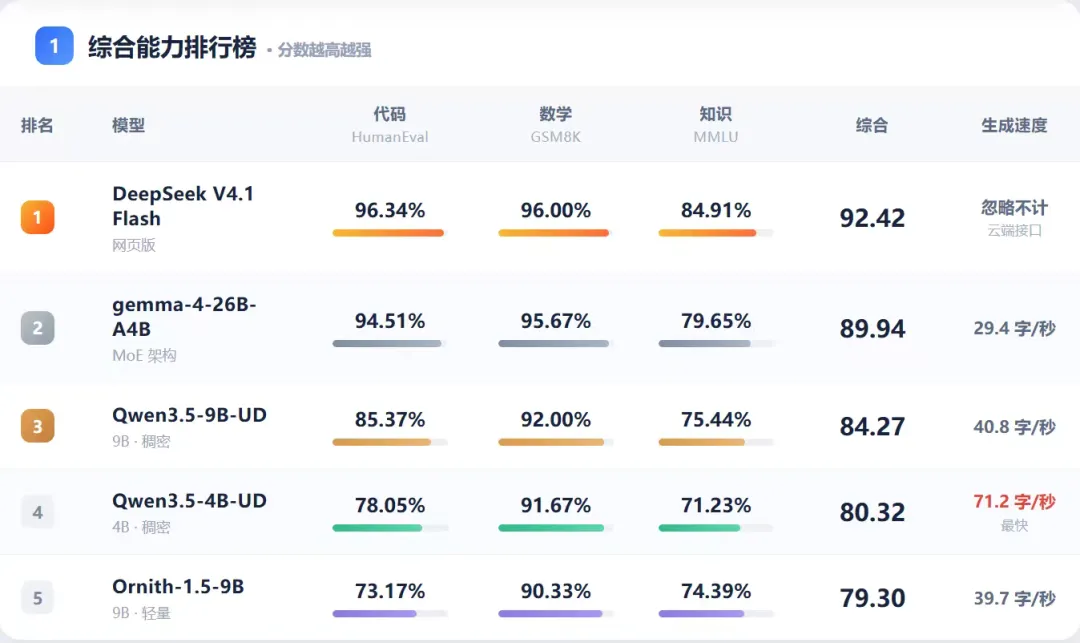
二、有思考
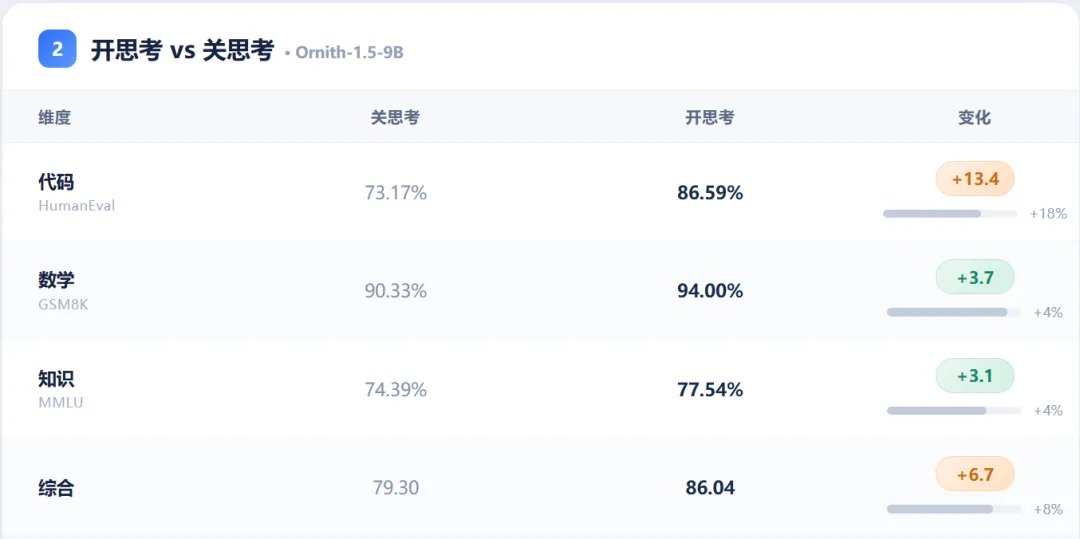
Gemma-4-26B-A4B开思考后输出太长会超过输出上限并挤爆内存(可能是因为输出的零时工作区过大,盘问workbuddy近20分钟,它也说不清是为什么);Qwen3.5的那两个会思考过长超过输出上限(简称雷霆大思考)。DeepSeek则只在复杂推理上有显著提升。
三、鹈鹕骑自行车测试
不能只看考试数据,因为题库是开源的,模型可能在训练阶段就有接触,所以结果不一定准确。于是我外加了一个鹈鹕骑自行车测试:每个选手有几次机会,我会挑出最好的成品展示。结果真是一言难尽......
DeepSeek V4.1 Flash 网页版 299t/s 第一次
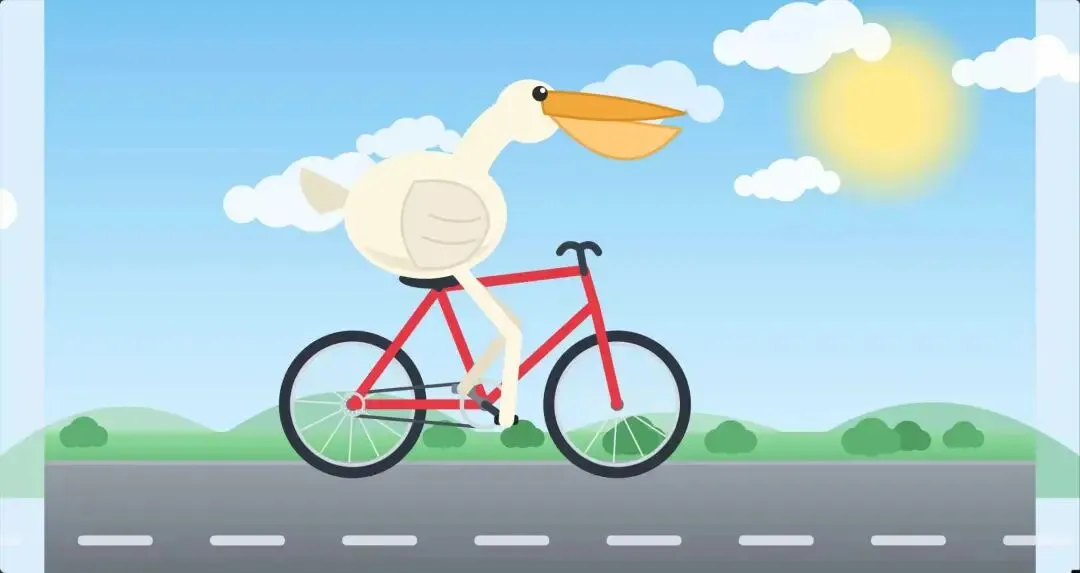
gemma-4-26B-A4B 27t/s 第二次
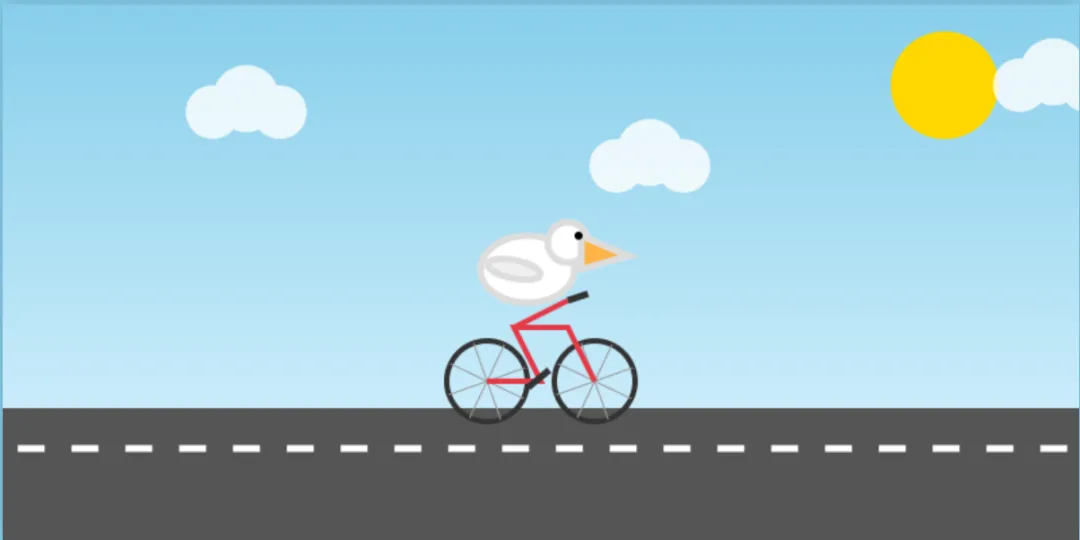
Ornith-1.5-9B 40t/s 第三次
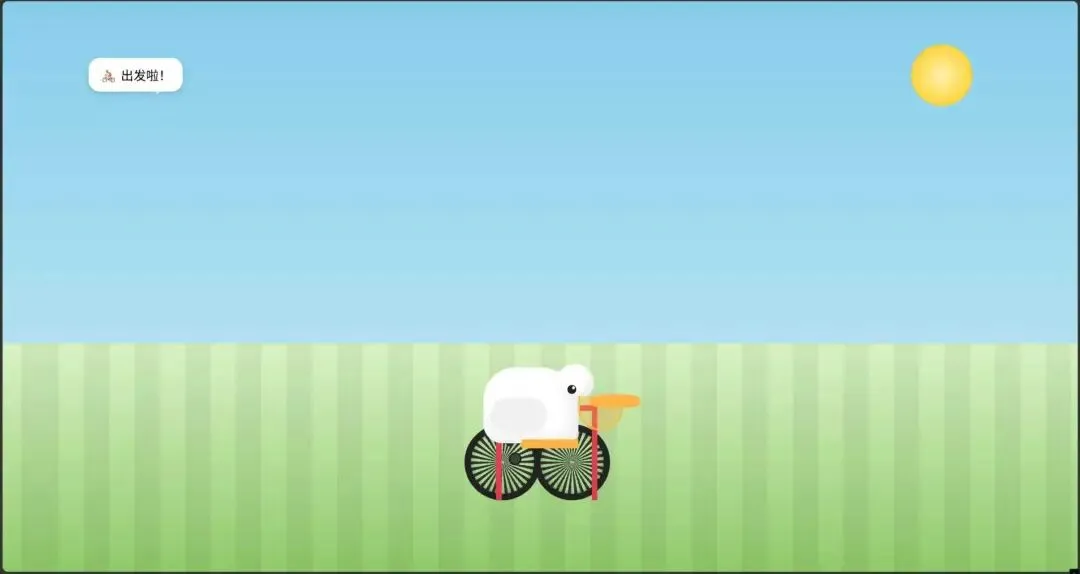
Qwen3.5-9B-UD 39t/s 第四次
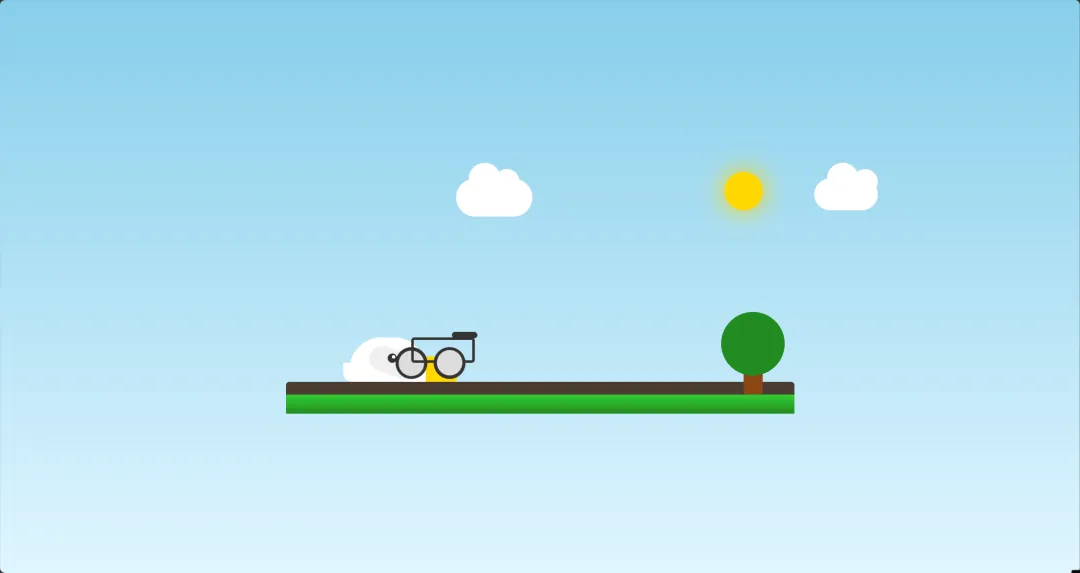
Qwen3.5-4B-UD 62t/s 第四次
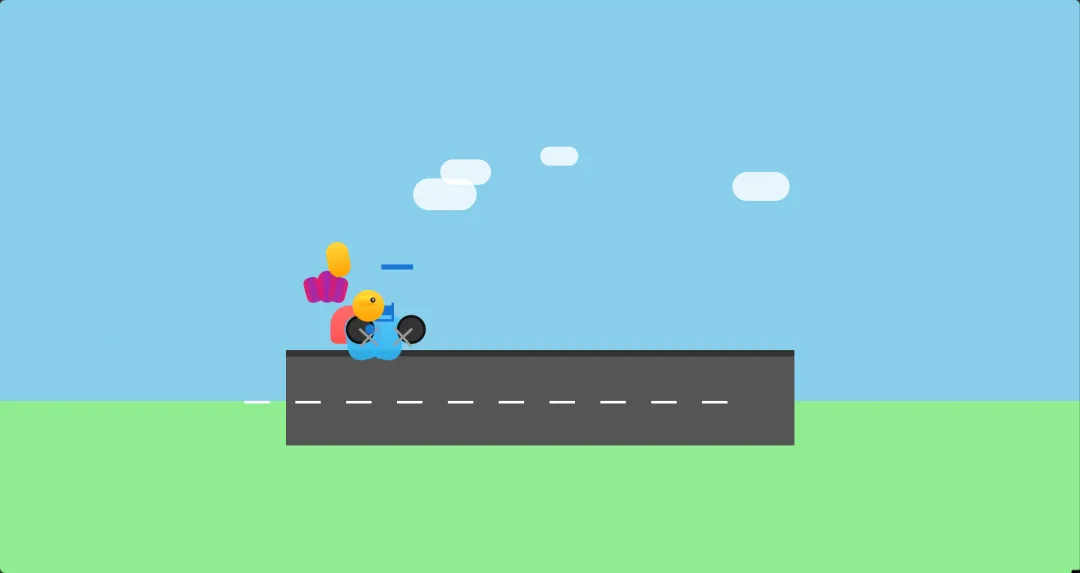
最后也是稍微测试了一下在 DeepSeek harness 上的 Agent 能力,这些本地模型的表现不太行(可能是工具调用格式不对,等我继续研究),暂时还是只能停留于对话功能。
综上,如果追求最佳效果我最推荐gemma-4-26B-A4B-it-UD-IQ3_S,它作为MoE专家模型显存占用大约6G,内存占用大约8G,对8+16G电脑来说刚刚好。如果追求性能和上下文的平衡选择Ornith-1.5-9B-Q4_K_M(必开思考)。如果追求极致速度那就选Qwen3.5-4B-UD-Q5_K_XL。
所有模型都可以去魔搭网站https://modelscope.cn/home下载。我的运行框架是kaiwu(可以适配MoE模型,自己通过AI Agent稍微开发了一个网页版,更适合新手操作,之后会开源到GitHub和gitee上,欢迎使用)
最后是求赞环节,看着文章这么简短,其实我是花了两天进行测试得到的,电脑也狂跑了十几个小时。看在我和电脑都这么努力的份上要个点赞不过分吧。谢谢各位了