ARTICLE · 1116553
停更5个月真相曝光!马斯克AI百科突然复活,20万张GPU背后的残酷算力战
— 作者 —何晴
— 编辑 —周可
2026年10月1日清晨,马斯克在社交平台转发了一条简短的推文。
文案只有两句话:“想参与打造《银河百科全书》(Encyclopedia Galactica),就加入 SpaceXAI。”
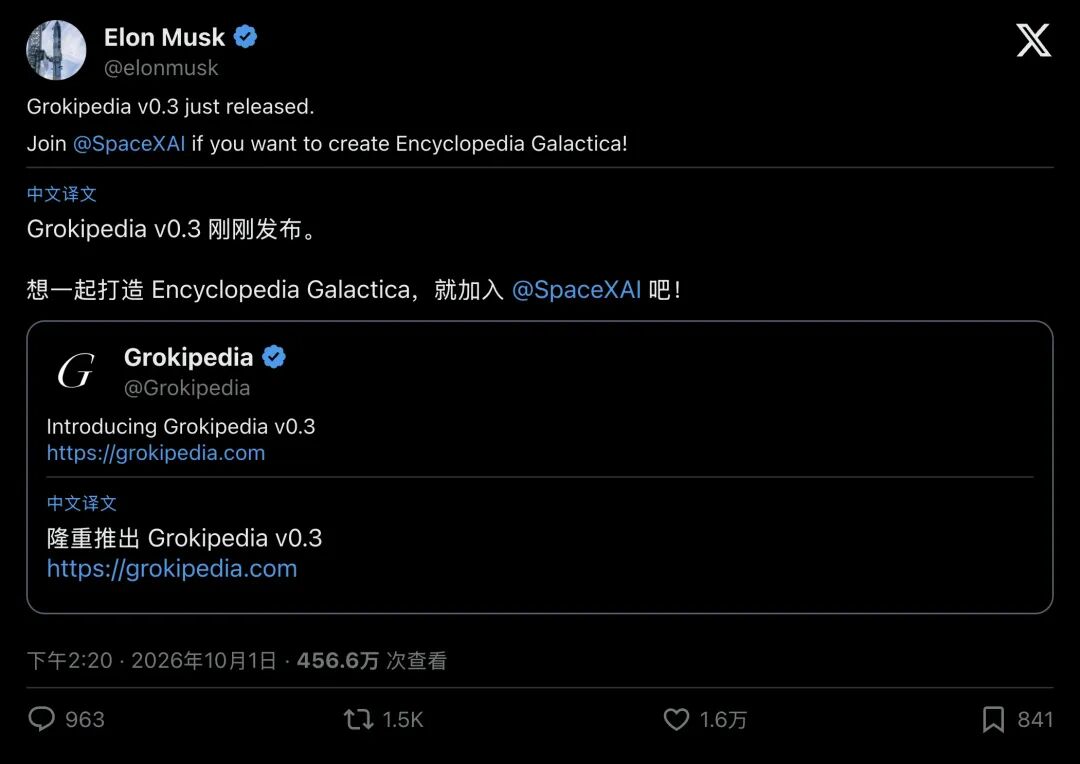
▲ 马斯克转发官方推文,高调宣示打造“银河百科全书”的野心
几乎在同一时间,各大科技社群迅速引发热议。AI 百科 Grokipedia v0.3 毫无预警地完成了一次视觉与交互改版。
屏幕那头,深色背景的页面上,立体书本正缓缓旋转,右下角不断弹跳着令人瞩目的数据:6,092,140 篇文章、1,175,771 次获批编辑。不少人在网页前感叹:你甚至能一边读着文章,一边看着文字在眼前被模型实时重写!
然而,少有普通读者知晓,在这场炫目的“实时知识呈现”背后,藏着一段长达 150 天的寂静期,以及一场高密度的算力资源调度。
01屏幕上的华丽流光:当知识变成“实时流水线”
打开改版后的 Grokipedia v0.3,任何一个习惯了传统维基百科的人,都会产生一种强烈的“时空错乱感”。
这里不再只是传统百科单调的纯文字排版,取而代之的是立体书架展示、横向排列的精选书脊,以及一个名为 “Live Edits”(实时编辑流) 的展示入口。
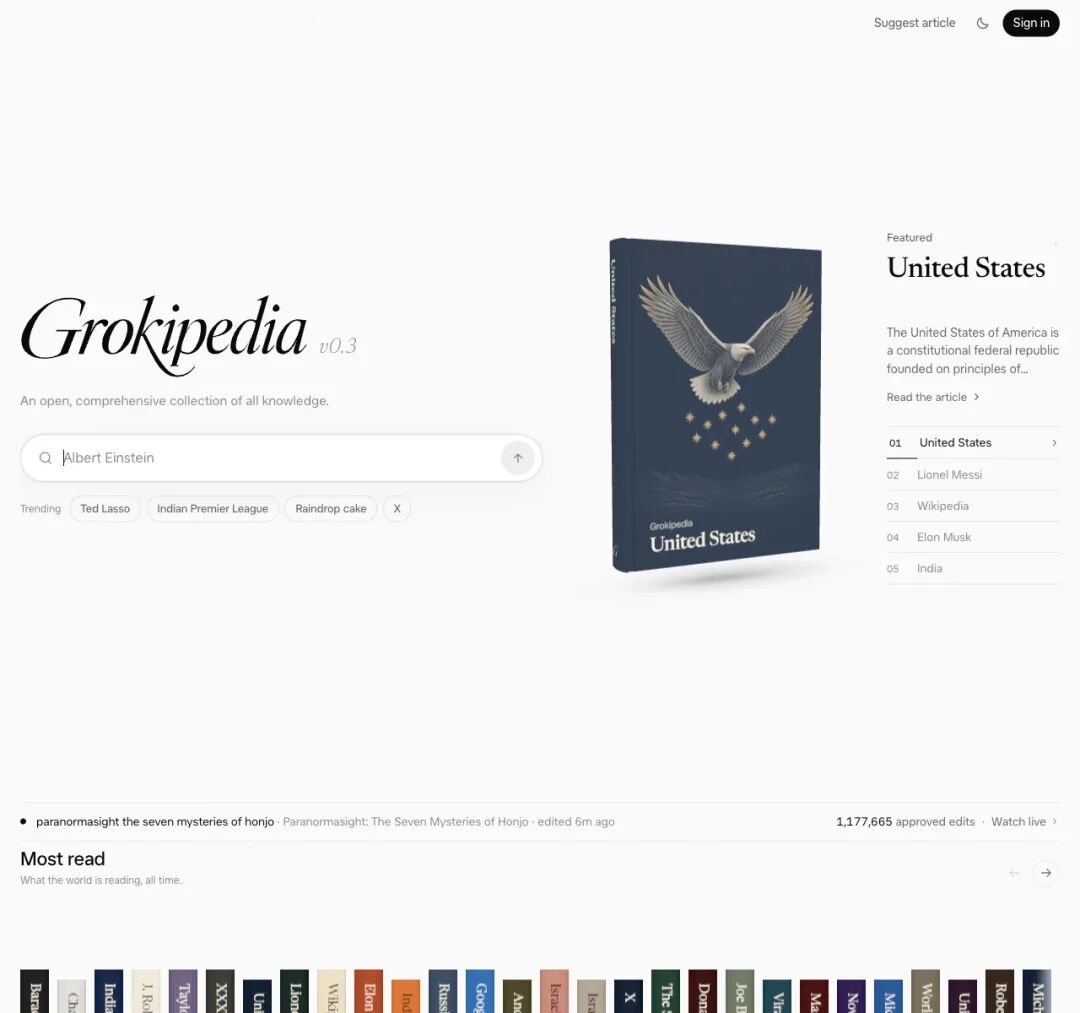
▲ Grokipedia v0.3 全新主页:精选条目以立体书卷呈现,底部包含横向阅读书脊
它把全网知识做成了一面实时跳动的编辑流。
条目更新在列表中连续刷新,记录下刚刚被 Grok 审核、修改并写回百科正文的事实变动。
有网友在社交平台上发帖:“读到一半,眼前的句子就在往前滚动重构,这感觉就像拿到了最前沿的知识收据!”
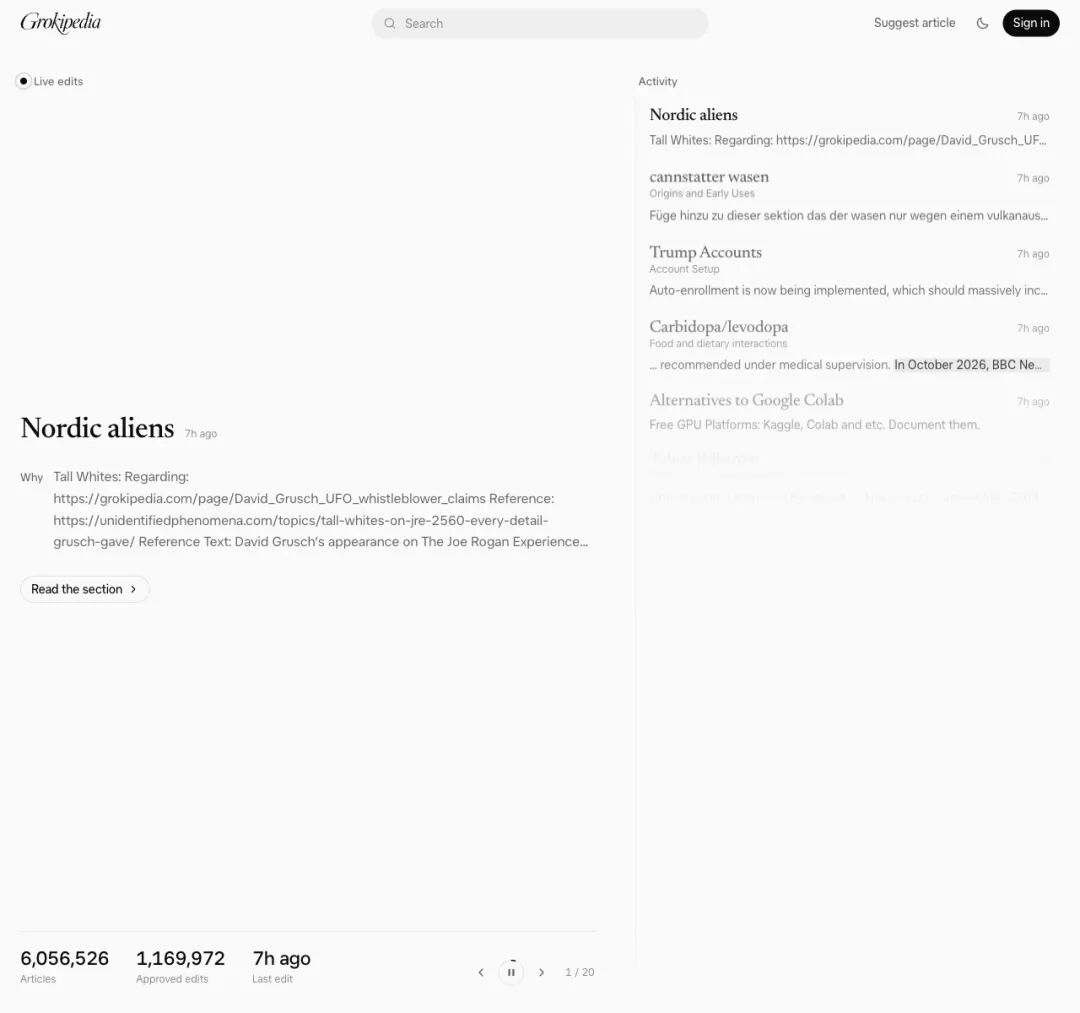
▲ Grokipedia Live 页面展示正在发生的实时编辑流与条目核查列表
但这是否足以代表透明与可信?
如果试图顺着这个“实时流”点进去,想要像维基百科那样查看“昨天下午到底改了哪几个字”,读者依然会遇到重重限制:
- 缺少字符级修改明细(Diff)
:页面主要显示“由 Grok 事实核查”的标签,尚未提供详尽的字符级红绿对比轨迹。 - 人类没有直接修改权
:在传统维基百科,志愿者可以直接改写词条;而在 Grokipedia,人类只能提交“纠错建议”,由大模型最终裁定通过、拒绝,或是留待审阅。 - 已采纳内容仍可能出现状态变动
:官方文档提及,部分曾被批准的修改在模型后续刷新或重构流程中,可能出现回退或重新判定的情况。
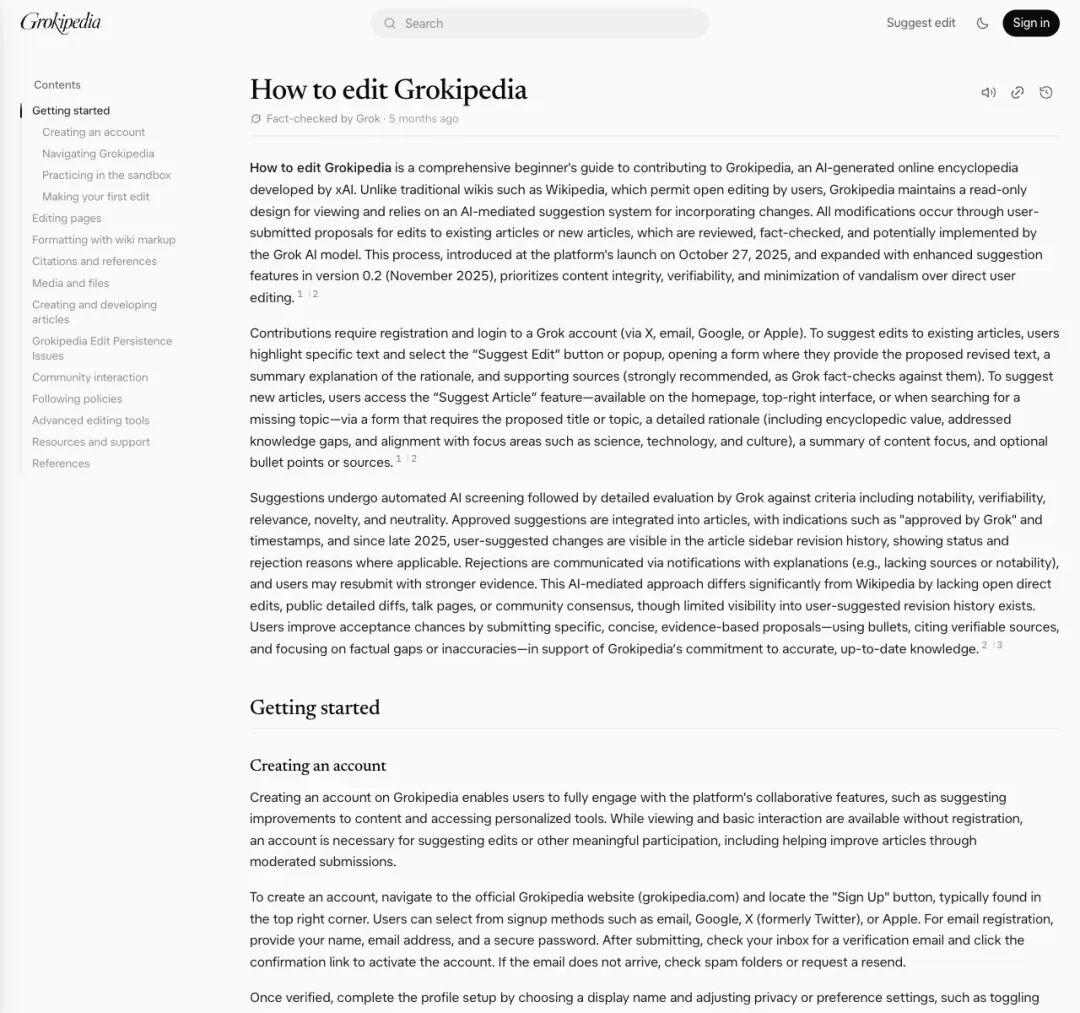
▲ 官方编辑文档明确指出:平台缺少公开的详细版本对照(Diff),仅由 AI 对人类建议进行审核
这套机制呈现出类似封闭编辑部的形态:大模型担任主审,外部读者仅能提交建议。
与此同时,这套看似昼夜运转的系统,在过去的数月里,曾经历过长达数月的停更期。
02绝密停更150天:孟菲斯巨兽的算力大挤占
时间倒回到 2026 年 8 月美国知名智库机构 Lawfare 发布了一篇令科技界哗然的深度调查报告。
研究人员通过海量数据抽样和历史网页比对,发现了一个惊人事实:从 2026 年 4 月 24 日开始,整个 Grokipedia 实际上已经彻底停摆。
模型停止了所有词条的正文自发更新; 全球成千上万读者提交的修改建议,全部卡死在“审核中(In review)”; 曾经车水马龙的实时状态页,悄悄挂上了“当前没有实时编辑”。
整整五个月,对外展示的 609 万篇庞大体量纹丝不动,整个站点如同一座华丽的数字冰雕。
官方没有发布任何长篇说明那么为何会出现长时间停滞,又在 9 月末突然重启?
停更的线索指向了田纳西州孟菲斯的超级计算中心。
根据 xAI 官方披露的超级计算集群部署资料,孟菲斯数据中心坐落着代号为 Colossus(巨像) 的超级集群。这里部署了整整 200,000 张顶级 GPU,是整个人类科技史上最恐怖的算力怪兽之一。
而在 2026 年春夏之交,Colossus 接到了最高优先级的战略死命令:全力冲刺预训练旗舰大模型,Grok 3。
行业测算显示,Grok 3 的预训练涉及超过 2 亿个 GPU 小时(GPU-hours) 的极高密度计算,算力消耗是前代模型的 10 倍以上!
在那种分秒必争的决战时刻,整座超算中心的电力负荷、液冷管道和高速网络带宽(Spectrum-X)都被拉到了 99% 的物理极限。任何非核心任务,都必须为前沿大模型的训练让路。
而作为一项免费开放、还在实验期的知识产品,Grokipedia 每天消耗的长文本推理算力,瞬间被调度器降至最低优先级,全线挂起。
直到 2026 年 9 月下旬,随着 Grok 3 训练阶段性收官、算力阀门重新松绑,庞大的算力配额才重新流回百科流水线。高关注度词条上的核查时间戳瞬间刷新,v0.3 的华丽门面应运而生。
所谓的“AI 停更”,本质上源于超算集群内部激烈的算力争夺。
03两种文明的账本:维基的低成本协同 vs 超算的密集消耗
将维基百科与 Grokipedia 放在一起审视,便能看清两种知识生产机制在经济学底层上的巨大分野。
很多人以为,生成 609 万篇文章不过是敲几次回车的事情。但把这笔账放到数据中心里算一算,数字触目惊心:
1. 百亿 Token 的冷启动洪流
Grokipedia 单篇条目的平均有效长度在 2,500 个 Token 左右。光是把这 609 万篇文章在磁盘里完整写出一遍,就直接输出了 152 亿个 Token。再加上生成时必须喂给模型的系统提示词、检索抓取的数十个网页上下文,后台推理流水线在冷启动阶段,吞吐了超过 1,000 亿个 Token 的计算量!
2. 事实核查的推理消耗
“Fact-checked by Grok”背后的核查流程极其厚重。面对全球用户提交的 117 万次建议,模型每次都要把原词条、修改意见与外部检索长文本送入注意力机制深度推理。这种持续判别的算力消耗,对计算资源提出了极高要求。
| 基础设施核心 | ||
| 知识更新边际成本 | 趋近于零 | 极度高昂 |
| 审计与追溯路径 | 字符级完整对照(Diff) | |
| 抗断电与抗波动性 | 极强 | 极脆弱 |
维基百科之所以能跨越 20 多年的互联网泡沫屹立不倒,靠的是一种极度极简的生存哲学:极低的硬件成本,绑定全球人类志愿者的分布式智慧。 每一个字符的涂改,就像在公共黑板上写粉笔字,服务器只需记录下这行纯文本,边际成本趋近于零。
而 Grokipedia,本质上是把整座人类知识大厦,建立在极其昂贵、极其耗电的超算沙丘之上。
一旦风向转变、电费吃紧、或者母公司要训练下一个万亿参数的巨无霸,这座宏伟的知识大厦随时可能被瞬间断电,重归冰封。
04“看见在动”,并不等于“掌握变更”
随着新版界面的热度平稳,越来越多关注产品细节的专业人士开始审视其深层机制。
技术观察者 @Vladic_ETH 在公开长评中直截了当地指出:在缺乏句子级版本对比的情况下,“Approved by Grok”仅能起到展示徽章的作用,难以提供严谨可靠的知识审计记录。
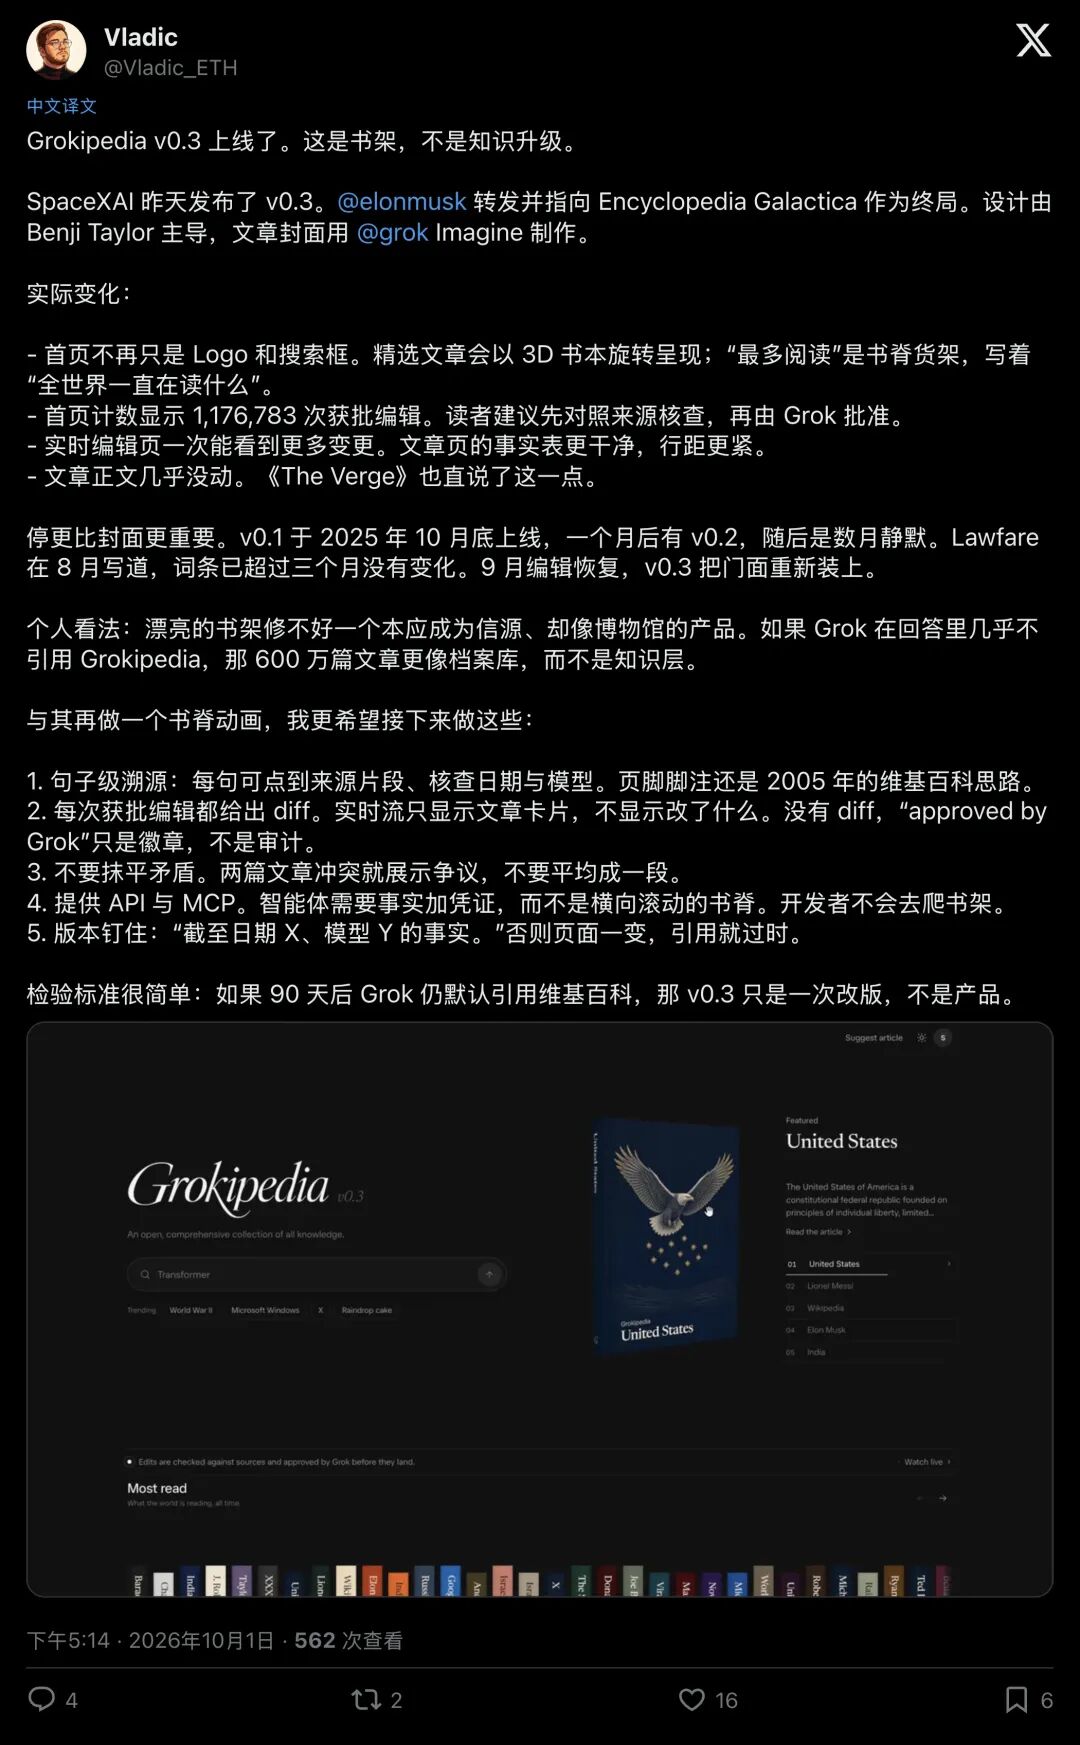
▲ 业界针对 v0.3 提出深层批评:漂亮的书架不能代替版本对照(Diff)与可溯源性
也有不少读者在讨论区留言,表达了相似的感受:即便能看到卡片跳动,依然难以直观对比当前版本与上一版本之间的具体文字变动。
这展现了 Grokipedia v0.3 所带来的双重思考:
在“产品层面的可见性”上,它通过滚动的卡片、精美的书卷和动态计数器,向外界清晰呈现出系统的运转状态;
但在“知识层面的透明度”上,平台依然留有空白:读者难以审计模型固有的偏见,难以追溯词条被修改的具体起因,也无法确定今天所见的内容是否会在后续权重调整中悄然改变。
从早期版本的数十万篇机器生成,到 v0.3 阶段的六百万篇数字库;从数月静默,到超算算力重新分配后的恢复更新。
马斯克构想的《银河百科全书》展示了生成式 AI 吞吐与整理知识的全新可能,也清晰揭示了“算力驱动知识生产”所伴随的现实约束。
当我们观察那些自动生成的文本时,或许应当记住:
看得到流水线的飞速运转,并不等同于掌握了可信的知识脉络。在这场高昂的生成实验里,决定一条内容去留的关键,往往取决于云端算力阀门的开合节律。