ARTICLE · 1116562
不吃人类一口数据!斯坦福两台AI“左右互搏”,竟凭空参透语言、图像与DNA
如果把两台刚“出生”的大模型关进小黑屋,不给它们看一页维基百科,不给它们看一张照片,也不喂哪怕一秒人类的音频,它们能学会什么?
在过去所有 AI 科学家的认知里,答案只有一个:它们会变成纯粹的智障,只能吐出一堆毫无意义的乱码。
然而,一项刚刚席卷 AI 圈的重磅研究,彻底把这个常识踩得粉碎。
来自斯坦福大学、特拉维夫大学等机构的联合团队,在一篇题为《Self-Play Pretraining with Zero Data》(零数据自对弈预训练)的论文中,做了一场近乎疯狂的实验:
他们让两个大脑一片空白的 AI 在虚拟环境里“左右互搏”,一个疯狂写小程序吐出字节,另一个拼命猜下一个字节是什么。在整个训练过程中,自然界的真实数据为零。
但当这场纯粹的算力游戏结束后,科学家们把这个从未见过现实世界的 AI 拖出来,扔到人类的真实世界面前:
它不仅瞬间看懂了人类文本、C 语言和 Python 代码,还能预测CIFAR-10 图像像素、LibriSpeech 语音声波、古典音乐旋律,甚至看懂了人类基因组的 DNA 编码序列!
在这些从未见过的现实数据上,它的零样本预测损失甚至呈现出极其严格、平滑的幂律下降(Scaling Law),并当场展现出了做加法运算、反转字符串的上下文推理能力(In-Context Learning)。
整个 AI 社区被彻底震动人类一直以为是自己浩瀚的数据文明哺育了大模型的智慧,但这项实验却冷酷地揭示出另一个真相:
智能的底层密码,也许根本不需要人类教。只要算力足够,AI 自己在虚无中“左右互搏”,就能把宇宙的逻辑规律凭空炼出来!
01逼近绝境的大模型,与萨顿的“苦涩教训”
要理解这项研究有多颠覆,得先看一眼当前大模型遭遇的“死局”。
现在的预训练大模型,本质上都是“吞噬人类文明数据的巨兽”。GPT-4、Claude 3 为什么聪明?因为它们吃光了互联网上几万亿 token 的人类书籍、网页、代码和论文。
但坏消息已经人尽皆知:人类高质量的自然数据,快被大模型吃光了。
为了继续 Scaling(扩大规模),行业开始尝试用 AI 生成的合成数据喂给 AI。但很快大家就发现:模型越吃合成数据,越容易退化成痴呆(Model Collapse)。人类不得不耗费海量人力去清洗、标注、精心设计混合配比。
数据,成了卡在通用人工智能(AGI)咽喉上最大的一根刺。
早在多年前,强化学习之父理查德·萨顿(Richard Sutton)就写下过那篇著名的《苦涩教训》(The Bitter Lesson):七十年的 AI 历史告诉我们,任何试图把人类手工设计的知识和规则塞进 AI 的做法,最终都会被“通用算法 + 纯算力”彻底碾压。
AlphaGo 依靠人类棋谱,水平终究有限;而彻底抛弃人类棋谱、全靠左右互搏的 AlphaGo Zero,只用了几天就打通了围棋的上帝视角。
那么,语言和多模态预训练,能不能也来一次“AlphaGo Zero 级别的彻底革命”?
斯坦福团队顺着这个狂想,回溯到了理论计算机科学的一个神级概念,所罗门诺夫归纳(Solomonoff Induction)。
这个理论告诉我们:宇宙中一切可被预测的现象(无论是语言、音乐、图像还是物理定律),其底层本质上都可以被视为某个计算程序的输出。只要一个系统能穷举并搜索出所有最优雅的短程序,它理论上就能预测世间万物。
可问题是:这个程序空间浩瀚无边,纯靠瞎猜等于大海捞针。怎么办?
答案是:让 AI 自己来一场自适应的“自对弈教学”。
02极简世界的死斗:出题人、答题人与“梯度对齐”
团队搭建的这套“无中生有”系统,精巧得令人拍案叫绝。
他们只用了三个核心组件:
- 生成器(出题人)
:一个随机初始化的 Transformer。它不负责编写人类自然语言,专门用一种只有 19 个基本符号、类似 Brainfuck 的极简图灵完备语言生成小程序。 - 通用解释器(裁判)
:一个最小图灵机,负责运行生成器写出来的代码,并把运行结果吐成一串原始的字节序列(Byte Stream)。 - 学习器(答题人)
:另一个同样架构的 Transformer。它的词表只有 256 个字节值(0-255),任务极其纯粹,做标准无差别的下一字节预测(Next-Byte Prediction)。
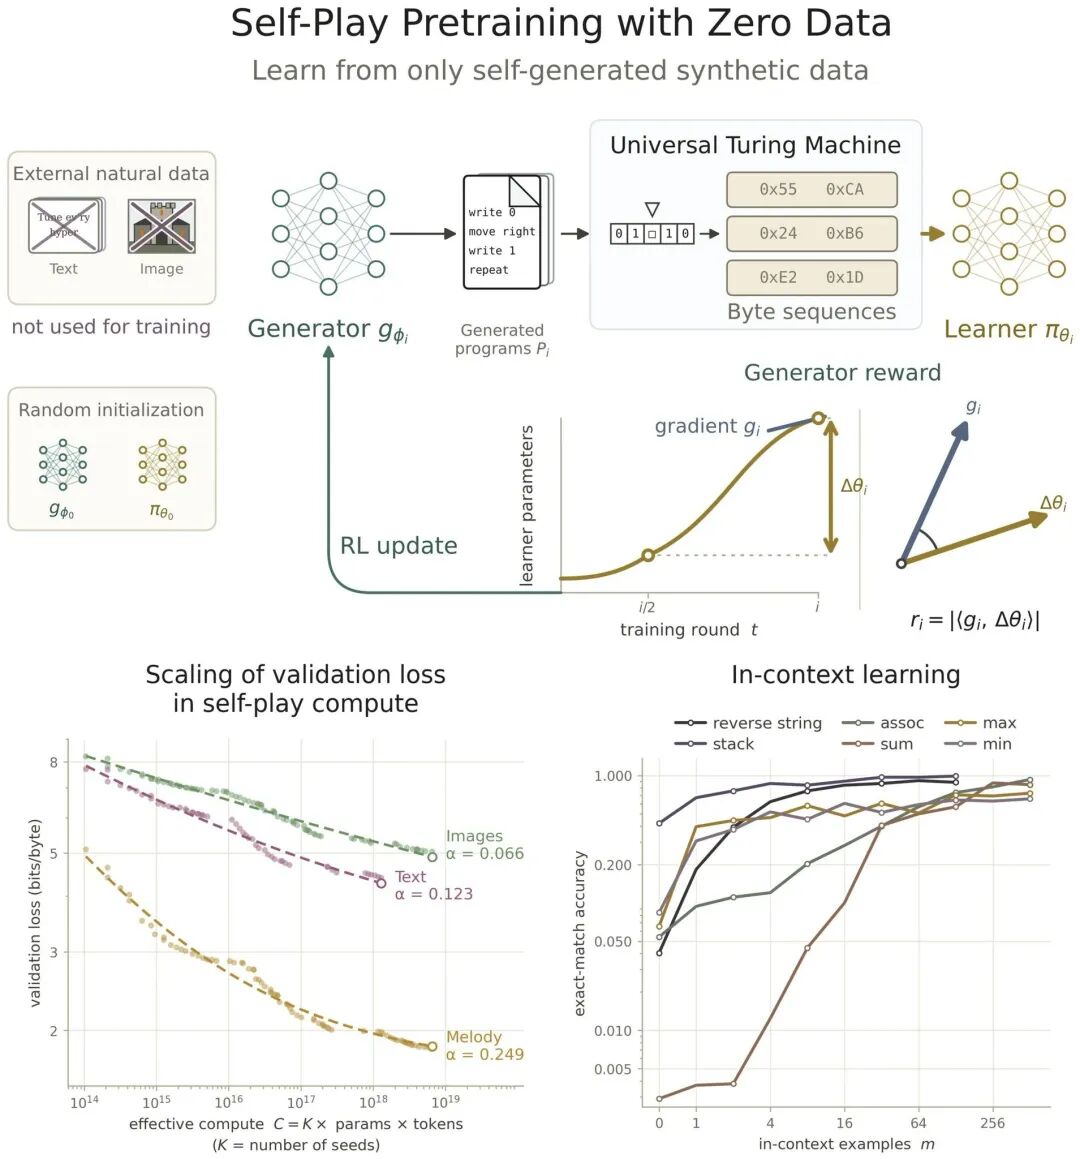
▲ 斯坦福研究团队发布的方法总览与梯度对齐反馈机制
这个极简世界运行的第一天,出题人写的程序全都是垃圾,吐出来的字节也是乱码,答题人猜得一头雾水。
但研究团队引入了致命的一招:如何给“出题人”发奖励?
如果你让出题人去追求“把答题人难倒”,系统立刻就会崩溃,出题人会直接写一个死循环生成纯随机白噪音,答题人瞬间原地躺平。
团队设计了一种极具智慧的学习进度 / 梯度对齐奖励(Gradient Alignment Reward):出题人拿到高分并不取决于题目难度,唯一标准在于:这道题吐出来的字节,必须刚好踩在答题人“当前的认知能力边界”上!
答题人已经完全掌握的规律(比如简单的重复字节),梯度为零,出题人不得分; 纯随机、毫无逻辑的乱码,答题人学不会,梯度不对齐,出题人也不得分; 唯有那些既包含潜在计算结构,又刚好能让答题人“踮起脚尖学到新东西”的程序,出题人才能拿到暴利奖励!
这一机制,就像一个顶级名师在因材施教。出题人被强化学习逼着在无限的代码空间里,源源不断地挖掘出越来越精妙、越来越深邃的数学与逻辑结构,逼着答题人疯狂进化。
03奇迹诞生:斐波那契数列与加法智能的凭空涌现
当这套自对弈飞轮转起来后,不可思议的现象接连爆发。
在没有任何人类提示的情况下,生成器在自对弈的第 512 轮,竟然自主“发明”了斐波那契数列程序的生成逻辑! 紧接着,等差数列、几何数列、二次方与三次方规律接二连三地从虚拟空间里被搜索了出来。
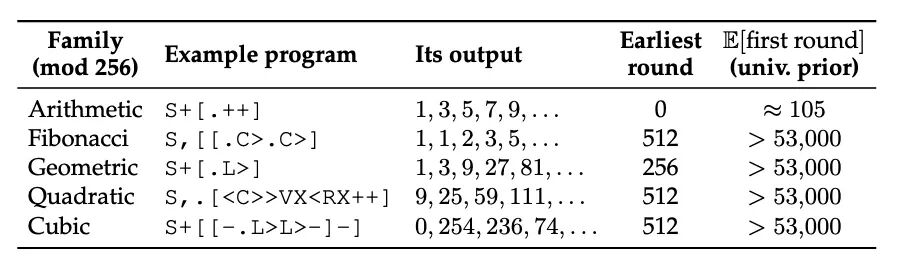
▲ 自对弈过程中,各类复杂数学规律被自主发现的轮次与期望轮次对比
对比实验显示:如果用无偏的随机采样去碰运气,要想随机碰到斐波那契这类程序,需要几万轮以上。自对弈的互相激发,让数学规律的发现速度提升了上百倍!
更震撼的还在后面:答题人自发学会了“在脑中推演规则”的上下文学习(ICL)。
当研究人员用“加法任务(SUM)”去测试这个从没学过算术的答题人时,记录下了它令人惊叹的认知跃迁:
刚开始,它只能盲猜一些常见的固定字节; 接着,它开始尝试在上下文中寻找输入与输出的复制关系,并经历短暂的信心崩溃; 紧接着,它突然顿悟,先后掌握了低位求和与高位进位的逻辑链条!
它没有更新任何模型权重,仅仅凭借上下文里给出的几个例子,就当场推导出了加法规则。
04跨模态大地震:零样本击穿 6 大自然领域
在验证模型泛化能力时,研究团队把这套在纯虚拟世界练出来的模型,扔进了 6 大截然不同的人类真实留出数据集:
- 自然语言
(DCLM 高质量网页清洗语料) - 程序代码
(AITDCC C语言源码、GitHub Python 源码) - 视觉图像
(CIFAR-10 纯像素字节流) - 声学音频
(LibriSpeech 原始 PCM 波形) - 古典旋律
(Mutopia MIDI 音乐事件流) - 生物基因
(人类基因组 DNA 序列)
结果震碎了所有人的三观:
完全没有吃过哪怕一个英文字母、一张图片、一段音频的学习器,在所有真实模态上的验证损失,全部呈现出极为平滑的幂律下降!
论文给出的拟合缩放指数 $b$(数值越大代表算力转化效率越高)显示:
在 DNA 基因序列上,自对弈零样本缩放指数高达 0.435(文献真实预训练通常仅在 0.01~0.06); 在 音频波形上,指数高达 0.260(远超真实数据预训练的 0.12~0.14); 在 图像像素与 自然文本上,自对弈的缩放斜率也全面持平甚至超越了直接在自然数据上预训练的基准!
为排除偶然因素,团队设置了严苛的对照组:
如果用固定的图灵机随机采样喂给模型,缩放曲线几乎是一条平缓的死线,证明没有“自适应课程”,死算力毫无意义; 如果用人类精心设计的递归文法(PCFG)喂给模型,模型在代码和文本上表现尚可,但在图像、音频和 DNA 连续信号上全面溃败; - 唯有这套自对弈系统,在所有模态中通杀,展现出了坚不可摧的普适性!
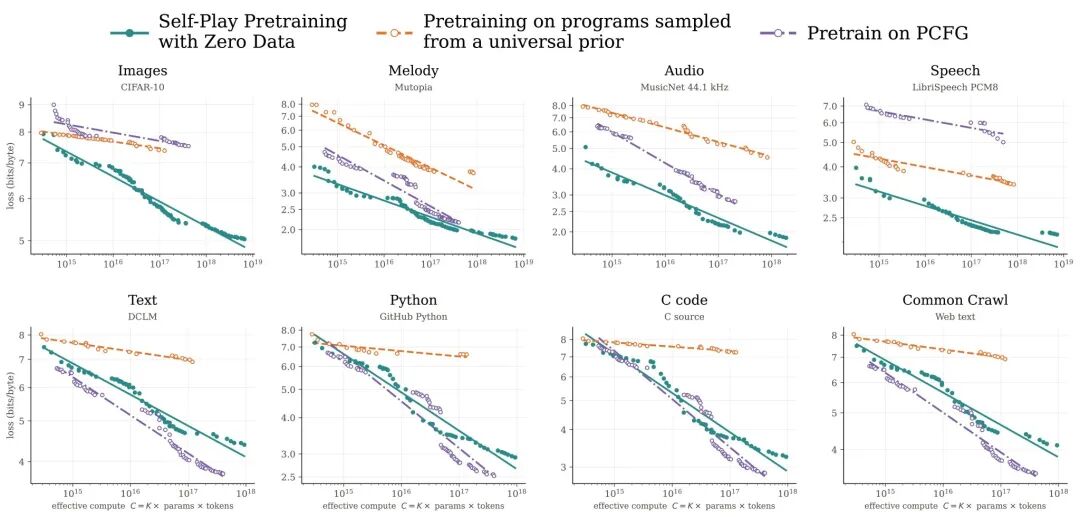
▲ 自对弈预训练在文本、代码、图像、音频等多模态上的缩放表现,显著优于通用先验与 PCFG 对照组
05终极洞察:普遍结构 vs 偶然信息
为什么一个只跟代码玩互搏的 AI,能看懂大自然与人类文明?
论文作者在讨论中给出了一个极具穿透力的哲学解释:世界上的一切数据,都可以拆解为两部分,普遍预测结构(Universal Structure)与偶然信息(Contingent Information)。
- 偶然信息
是具体的、碎片化的事实:比如“法国的首都是巴黎”、“秦始皇统一了六国”、“某种特定花朵叫玫瑰”。这些事实如果不与真实物理世界互动,谁也无法凭空猜出。 - 普遍预测结构
则是跨越一切模态的底层抽象:对称、递归、周期、层次、因果、局部相关性与长程依赖。无论是莎士比亚的十四行诗、贝多芬的交响乐,还是人类 DNA 的双螺旋、计算机的操作系统,其骨架全都是由这些普遍结构编织而成的。
以往的人类大模型预训练,把这两者混为一谈。我们浪费了数以万卡计的顶级算力,让模型在一边学习“逻辑骨架”的同时,一边痛苦地死记硬背互联网上的海量事实。
而这项研究向全世界证明了:智能的“逻辑骨架”,完全可以脱离人类数据,用纯算力在极简的自对弈中直接淬炼出来!
在附录的迁移实验中,团队发现:用这种自对弈训练好的权重作为底座(“预预训练”),再去吃少量的自然真实数据,其收敛速度和效果远远把随机初始化的模型甩在身后!
06后数据时代的诺亚方舟
从 2017 年 AlphaGo Zero 宣告棋类人类经验的终结,到 2026 年这项研究叩响“零数据预训练”的大门,历史完成了一次惊人的闭环。
它给整个 AI 行业带来了一剂强心针,更指明了一条完全不同的技术路线:
当人类文明的网页数据被吃干榨净,当数据墙的阴霾笼罩在每一家科技巨头的头顶,我们或许根本不需要感到绝望。
因为在数据枯竭的尽头,等待人类的是纯粹的算力。
只要给 AI 搭建一个最纯粹的图灵竞技场,让它在无尽的计算虚空中左右互搏,宇宙底层深邃的逻辑与智慧,终将在那冰冷的字节流中,一次又一次地轰然涌现。