ARTICLE · 1116564
不吃人类一句话、一张图!两台空壳AI黑盒互搏,竟自发参透现实世界规律
你敢想象这样一个极端的科学实验吗?
把两台完全随机初始化、大脑一片空白的神经网络,关进一间密不透风的“算力小黑屋”。
不给喂维基百科,不给看互联网抓取的网页,不给看任何人类拍摄的照片或音频,甚至连人类写过的一行代码都不给。物理意义上的“零数据喂养”,彻底从零开始(Tabula Rasa)。
两台 AI 只能在黑盒里玩一场极度抽象的游戏:一台像个疯狂的程序员,用极简的乱码指令拼凑出各种小程序;另一台则扮演做题家,拼命预测这些程序吐出的字节序列。
几天之后,研究人员把这台从未见过真实世界的 AI 抱出实验室,直接扔进真实的莎士比亚戏剧、自然风光图像、人类语音甚至生物 DNA 序列里进行测试。
离奇的异常发生了
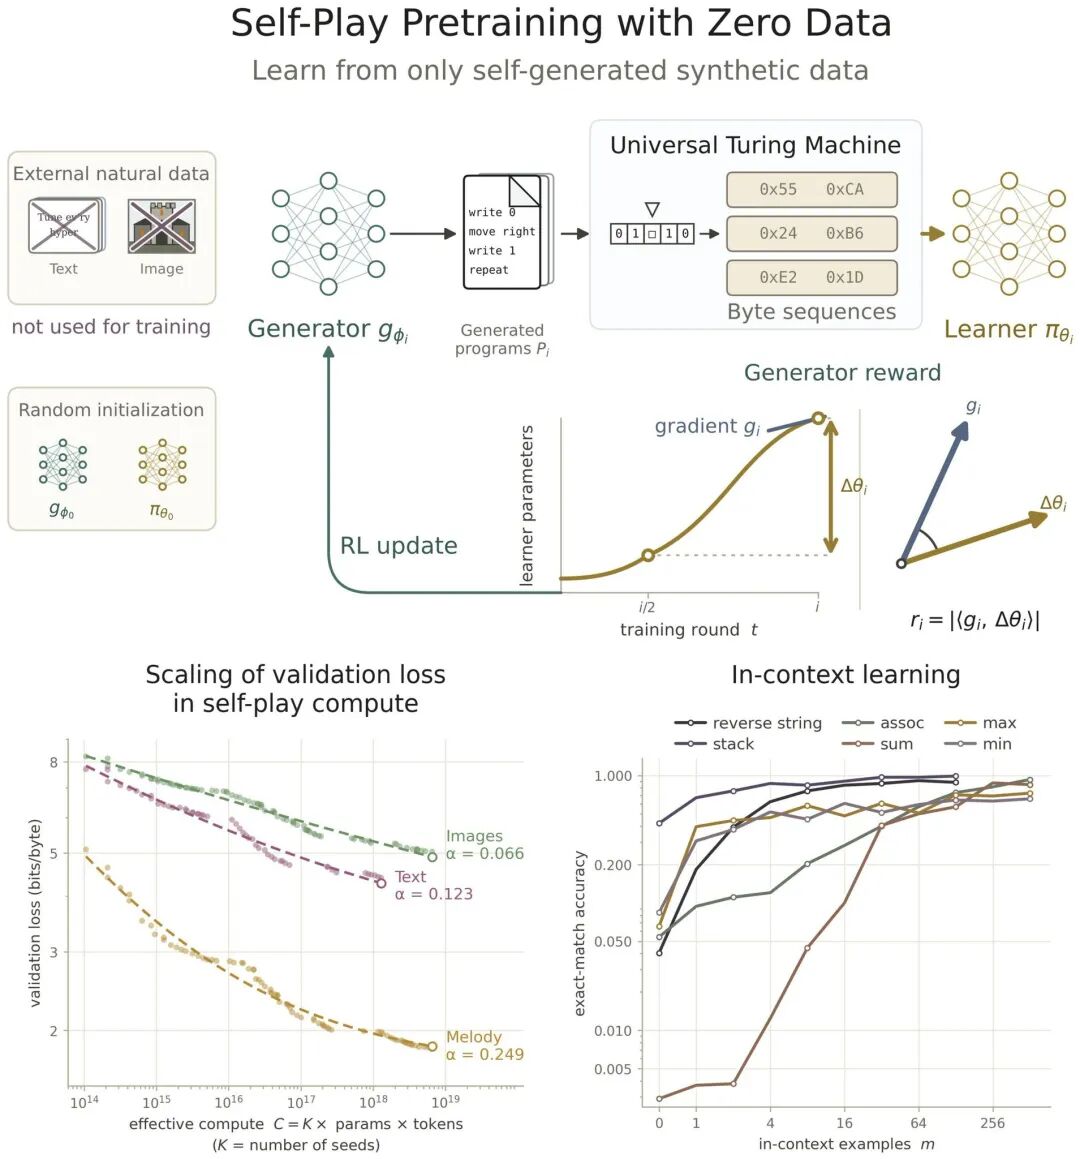
▲ 斯坦福等团队发布的架构总览与实验曲线:零真实数据下,模型在跨模态自然数据上呈现出规整的幂律缩放
这台在虚无中长大的 AI,在面对从未接触过的人类文本、图像和代码时,其预测损失竟然呈现出极其规整、符合教科书级别的幂律下降(Scaling Laws)!不仅如此,给它几个示例,它竟然能够无师自通地展现出上下文学习(In-Context Learning)能力,甚至自己学会了算术加法与数列推断。
全球 AI 社区为之震动这篇由斯坦福大学、特拉维夫大学等机构联合发表在 arXiv 上的重磅论文(编号:2609.30063),彻底撕开了一条通往通用智能的全新隧道:大模型的智慧,难道根本不需要从人类现成的数据堆里汲取?
01异常追踪:它在小黑屋里到底玩了什么?
大模型的传统演进路线,本质上是“吃人类数据的饭”。清洗万亿网页、人工标注指令、精心调配各模态配比。当业界都在为“人类数据即将被大模型吃光”而焦虑撞墙时,这项研究提出了一个反叛的假设:能不能让模型自己给自己出题,通过纯算力自生智慧?
很多人看到这里的第一反应是:这不就是生成对抗网络(GAN)或者单纯的随机合成数据吗?
就连 Meta 的知名 AI 科学家 Lucas Beyer 最初也误以为这又是一个 GAN 的变体,但随后他公开更正了自己的看法,坦言其背后的机制与传统印象完全不同。
这套系统的底层逻辑极其精妙,由三部分组成:
- 出题人(生成器)
:一个随机初始化的解码器 Transformer。它不写 Python,也不写英语,而是使用一种类似 Brainfuck 的图灵完备极简语言(仅 19 个指令符号)。无论怎么胡乱拼凑,程序被设计为绝对不报错、永远可执行,并吐出一串原始字节。 - 极简图灵机(解释器)
:负责高效执行这些小程序,把程序执行后的动态轨迹变成一串原始字节流(0~255)。 - 做题家(学习器)
:另一个同架构的 Transformer。它的任务极其单纯,做最标准的下一字节预测(Next-Byte Prediction)。
看似简单的“左手倒右手”,暗藏着一个足以让系统瞬间崩溃的致命陷阱:如果出题人为了赢,故意生成纯随机噪点怎么办?
纯随机的乱码不可预测,做题家必输无疑,整个系统就会迅速陷入垃圾数据的死循环。
研究团队给出了极其毒辣的解法,梯度对齐奖励(Gradient Alignment)。
系统专门奖励“最能引发学习器进步的题”。
算法通过前向模式自动微分,实时计算某道题在学习器上激发的梯度,与学习器最近参数移动方向的重合度。
如果这道题学习器已经烂熟于心?梯度近乎为零,出题人拿不到奖励; 如果这道题是毫无规律的纯噪声?梯度方向完全脱轨,出题人同样零分; 唯有那些“尚未掌握、但其结构恰好沿着当前认知轨迹向前延伸”的数据,出题人才能拿走超高奖励!
这正是心理学上最理想的“最近发展区”教学法:出题人被强化学习逼着,永远在做题家的能力边界边缘试探。
02惊人涌现:数学规律与推理能力从虚无中诞生
在这场没有人类干预的自对弈军备竞赛中,奇迹开始一浪接着一浪地发生。
随着训练轮次的推进,生成器为了击中学习器的能力前沿,开始自发地发明可识别的数学序列。
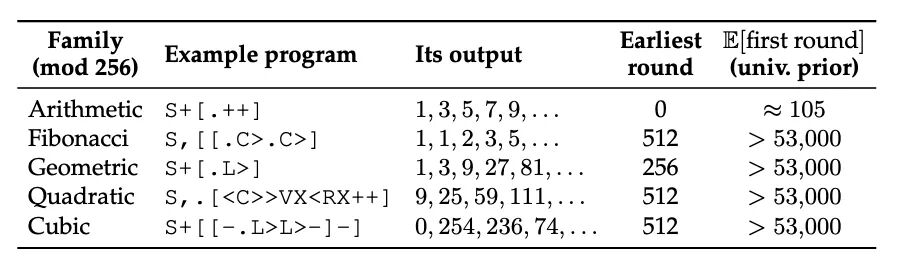
▲ 生成器在训练中自发发现的数学序列族及轮次对比
在第 512 轮自对弈时,系统自发编写出了斐波那契数列的生成程序。如果依靠传统算法在通用程序空间里盲目随机采样,想要碰出斐波那契序列,期望轮次要在数万轮以上!
不仅如此,模型还涌现出了强大的上下文学习能力(ICL)。
在对未见过的多项逻辑与算术任务测试中,随着提示词中给出示例数量的增加,完全由自对弈训练出来的模型,其贪心解码正确率呈现出昂扬的上升曲线!
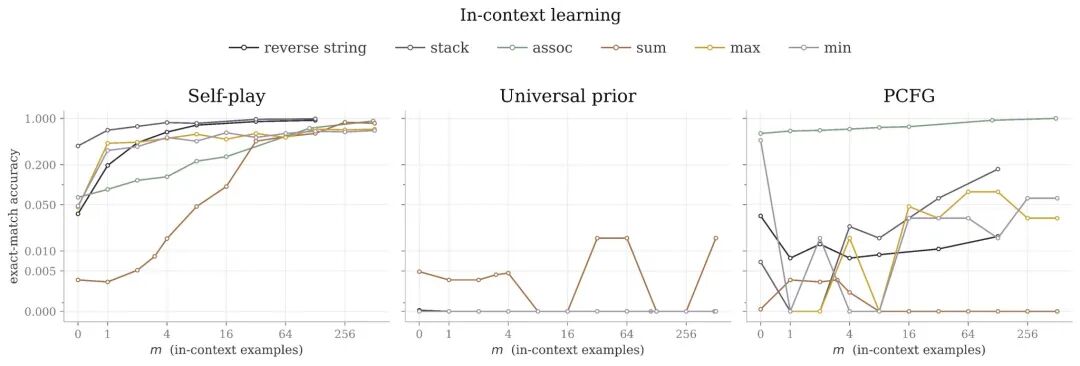
▲ 在六项基准任务中,自对弈模型随 ICL 示例数增加而全面提升,远超固定先验基线
在定性分析加法求和(SUM)任务时,研究人员观察到了惊人的一幕:面对一串全新的加法算式,模型先是利用记忆中的先验字节试探,经历短暂的信心崩溃后,在没有任何额外梯度更新的情况下,仅靠上下文注意力,逐步推导出了低位求和与高位进位的潜在规则!
在自己的算法宇宙中,它将逻辑演绎的通用机制内化成了神经网络的本能。
03认知重构:为什么不吃人类数据,反而能懂人类世界?
这构成了整篇研究最颠覆常识的哲学内核:为什么一个只在抽象图灵机里打滚的模型,能对真实人类世界产生如此强大的零样本泛化?
答案藏在 60 年前计算机先驱雷·索洛莫诺夫(Ray Solomonoff)提出的索洛莫诺夫归纳(Solomonoff Induction)理论中。
索洛莫诺夫认为:世间一切可观测的规律,本质上都是某台图灵机上的计算程序;而宇宙天然偏爱更简短的程序(奥卡姆剃刀)。这种简单性偏置,造就了跨越所有模态的底层公理,重复、对称、状态递归、模块复用。
论文作者团队提出了一个极其深刻的理论拓展:通用数据拟设(Universal Data Ansatz)。
他们指出,人类的自然界数据,本质上由两部分纠缠而成:
- 偶然信息(Contingent Information)
:特定世界的具体事实与符号约定。比如“拿破仑滑铁卢战败”、“apple 在英语中代表苹果”。 - 普遍预测结构(Universal Predictive Structure)
:跨越一切系统底层共享的抽象可计算逻辑。比如因果递进、层级嵌套、信息压缩与递归转移。
以往我们总以为大模型预训练是在同时吞下这两者。而这项实验将它们彻底解耦:
自对弈系统没有学到哪怕一条现实世界的“偶然事实”,但它把宇宙间所有可计算过程共享的“普遍预测结构”,通过纯粹的算力搜索,淬炼到了极致!
当这台模型转头去读莎士比亚、看自然风景、测人类心电图时,它虽然不知道这些字节在人类社会中的语义,但它的神经网络早已经掌握了这种层级结构的组织律动。
04苦涩教训的终极胜利:AI 的尽头是算力搜索
回望 AI 发展的七十年历史,强化学习之父理查德·萨顿(Richard Sutton)曾写下振聋发聩的《苦涩的教训》(The Bitter Lesson):
凡是试图靠人类专家经验、手工规则或人工设计偏置来提升 AI 的路线,短期内或许有效;但从长远来看,最终无一例外都会被依赖通用计算、通过大规模搜索与自适应学习的方法以压倒性优势彻底超越。
从深蓝击败国际象棋大师,到 AlphaGo 抛弃人类棋谱走向纯自对弈,历史一次次验证着这个规律。
如今,《Self-Play Pretraining with Zero Data》将这一理念推进到了大模型最底层的无监督预训练领域。
这项研究向我们表明:人类精心标注、细致清洗的互联网语料库,未见得是通用人工智能的唯一温床。在图灵机完备的极简规则之上,只要给足算力,让算法与算法在黑暗中自对弈,智慧的火花就能从虚无中自行碰撞出来。
当真实世界的数据墙逼近、人类文本即将被榨干的时刻,这条通向“纯算力自生智能”的未知之路,或许正是开启下一个技术时代的全新起点。