ARTICLE · 1116672
AI 出图没有故事感?问题出在提示词里没有“导演”
AI 出图没有故事感?问题出在提示词里没有“导演”用即梦、可灵、Midjourney 出图的人,大概都经历过同一个阶段:提示词越写越长,画面却越来越像壁纸。“绝美”“梦幻”“史诗感”堆了一堆,图确实好看,但好看得没话说。 把一批图摆在一起,你会发现构图、情绪、人物状态都差不多,只是换了背景和颜色。问题不在模型,在你写提示词的方式。你一直在描述画面,没有在设计一个瞬间。 为什么堆词没用?因为模型是在猜最可能的答案。“绝美”“梦幻”这类词太安全了,它只能给出一张哪儿都对、哪儿都不记得的图。真正的信息量来自具体的决定:谁,在哪,在干什么,和什么有关系。 这篇文章要讲的这套 Skill,叫“超现实电影底图提示词导演”。它不提供词库,提供一套导演工作流:把主题、情绪、故事,变成有明确人物关系、视觉隐喻和电影感的画面提示词;图生成之后,还能继续产出约 5 秒单镜头的图生视频提示词。下面拆开讲它到底怎么工作。 01 先回答六个问题,再动笔 这套流程的第一条规则:每幅画面必须明确写出六样东西:人物、道具或生物、动作、场景、环境、情绪关系,缺一个都不算完成。同时禁止一堆模糊表达,“某个”“一种”“或者”“类似”“可以根据需要选择”。这些词一出现,等于把决定权扔回模型,模型就会挑一个最平均、最安全的答案。 错误示例是“一个女孩站在某个荒野里,身旁有一种巨大动物”。正确示例是“年轻中国古风女子坐在浅水中央,穿素白色汉服,宽袖垂落水面,一条巨大白蛇从她身后抬起头部,远处是雾气笼罩的青灰色山影”。差别一眼就能看出来:前者是形容词的堆叠,后者是分镜。 缺一个要素,画面就塌一块。人物没有动作,就是摆拍;道具和人物没有关系,就是装饰;场景不具体,情绪就无处安放。六要素不是凑数的清单,是给模型的边界,也是给自己想清楚的分镜。 02 画面必须有人物与世界的关系 只罗列漂亮元素,图还是空的。这套 Skill 要求每张图先建立一段关系:人物依靠巨大生物、人物忽略巨大生物、生物保护人物、人与生物互相凝视、人物害怕但没有逃跑。关系定了,情绪就从画面里长出来,不用写“悲伤”“孤独”这种情绪词。 拿白蛇那张举例(见下文图1)。女子坐在浅水里,没有回头,白蛇从她身后抬起头部,体积是她的好几倍。设定里没写“恐惧”,但压迫感已经在了。这就是把情绪翻译成视觉关系:生物替人物说出说不出口的东西。 03 一次出 6 张,就要按 6 张来设计 单张图好看不难,一批图都好看才难。这套 Skill 有专门的去重规则:同一批画面不能只换动物、服装或背景;不能所有人都站着看镜头;不能全是白裙、黑西装、海边、花田;不能连续用同一种构图和族裔。 可用的差异包括:站立、坐下、躺卧、依靠、触碰、对视、背对、被环绕、共同看向远方、躲在巨大生物投下的阴影里。每张图只保留一个主要动作。下面这 6 张,是我按这套规则出的演示图,六个主题、人物族裔、动作、场景、构图全部错开。 如果暂时没有方向,这套 Skill 还内置了主题库:梦与错误记忆、城市孤独、身体与植物、欲望后的空洞、时间停止、童年遗物、海洋进入现实、爱情残留、末日后的平静。选一个主题,再往里面填六要素,比从零开始想容易得多。 图1,人与巨大生物:古风女子坐在浅水中,白蛇从她身后抬头,女子没有回头。运动线索是水面波纹和蛇的呼吸。 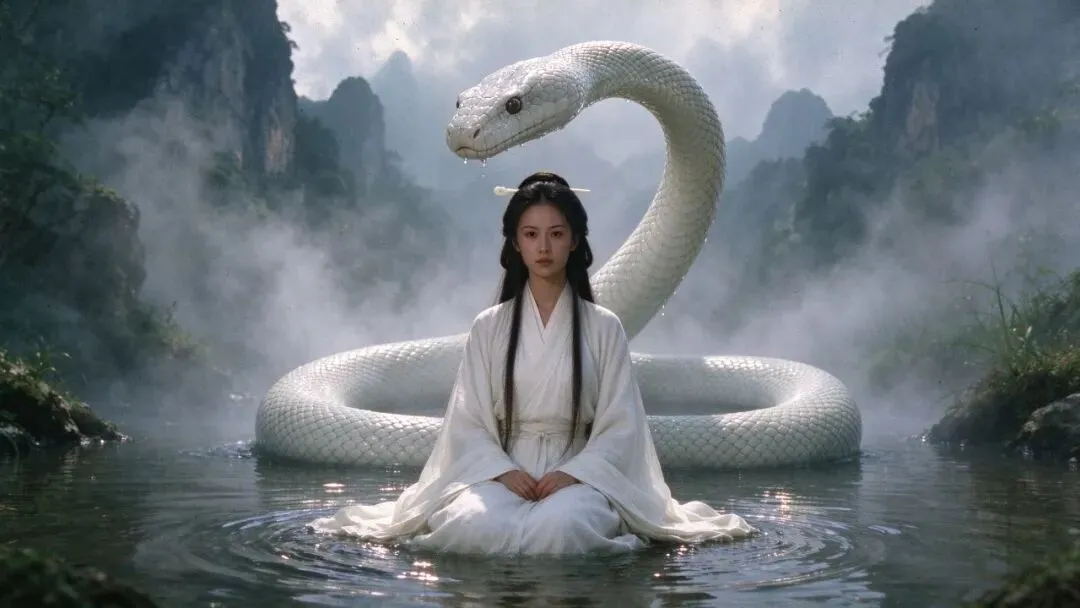
图1:白蛇与素衣女子,主题“人与巨大生物”(AI 生成示意图) 图2,身体与植物:红发女人站在废弃温室里,藤蔓和白色花朵从她手臂和裙摆边缘生长出来,她低头看着自己的手腕。运动线索是花瓣半开和光斑浮动。 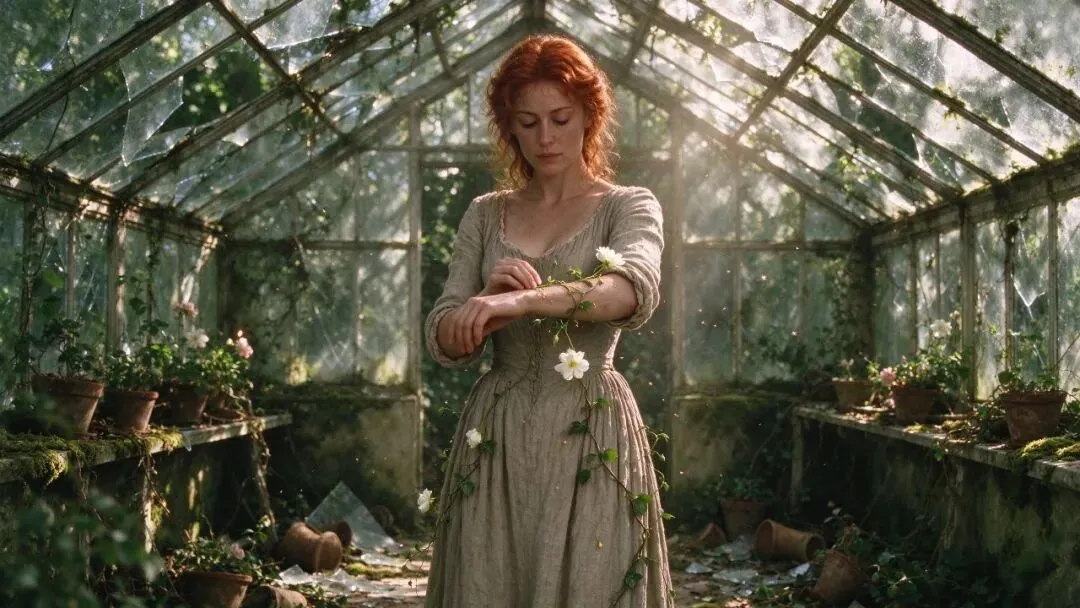
图2:温室与藤蔓,主题“身体与植物”(AI 生成示意图) 图3,爱情残留:深夜咖啡馆,女人伸手悬在桌面,没有碰对面空椅上那件叠好的外套,咖啡已经冷掉。运动线索是窗外雨水和霓虹晕开。 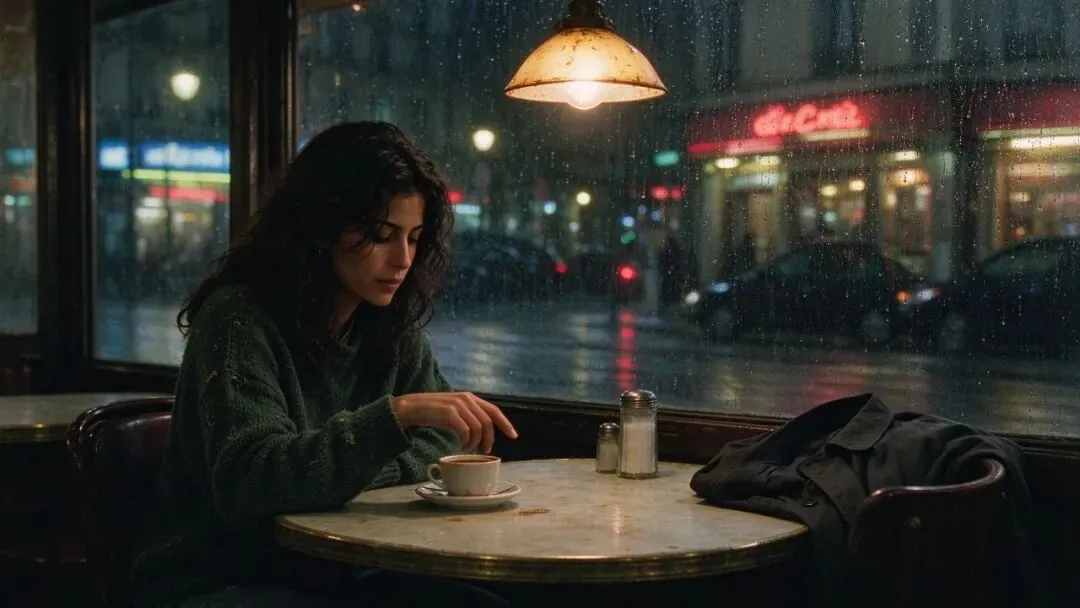
图3:咖啡馆的空椅子,主题“爱情残留”(AI 生成示意图) 图4,末日后的平静:黑人青年站在半塌的图书馆里,用手帕仔细擦拭一本旧书,阳光从屋顶裂缝落下。运动线索是灰尘在光柱里浮动。 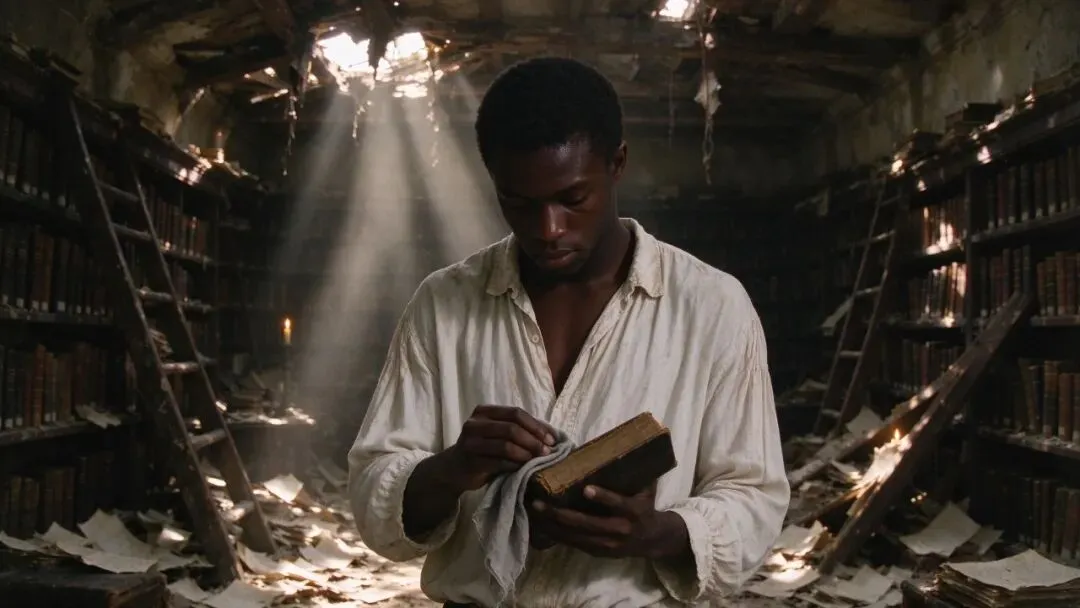
图4:废墟图书馆,主题“末日后的平静”(AI 生成示意图) 图5,海洋进入现实:女人仰面躺在床上,潮水漫过地板,小鱼和珊瑚在床周围游动,她看着天花板。运动线索是鱼群游动和水面微光。 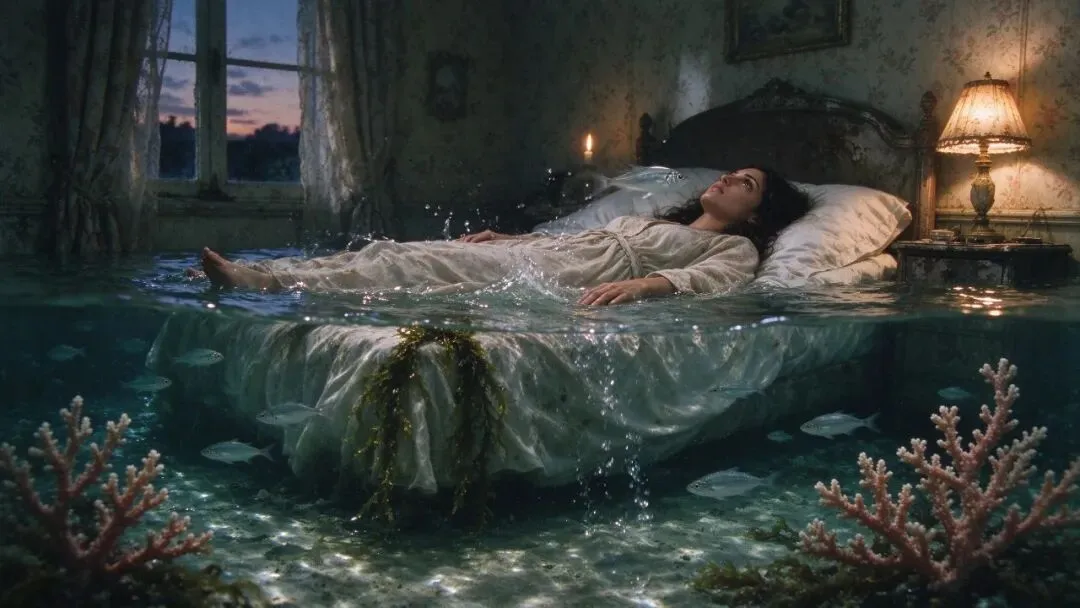
图5:卧室里的潮水,主题“海洋进入现实”(AI 生成示意图) 图6,时间停止:男人站在暴雨中的十字路口伸手去接,所有雨滴悬停在半空,水花凝固成弧线。运动线索是第一滴雨即将落下。 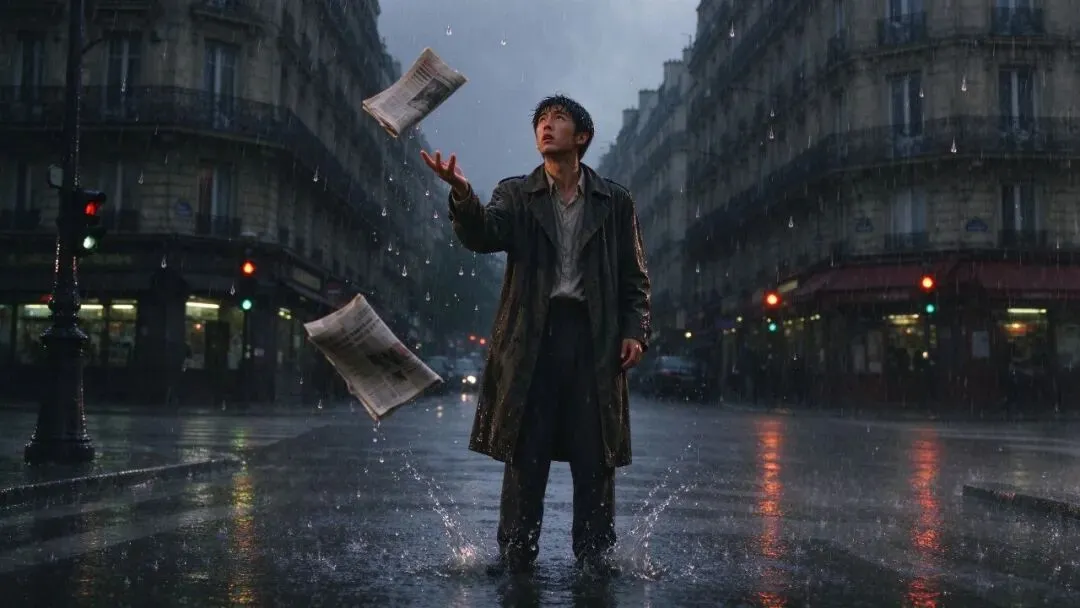
图6:冻结的雨,主题“时间停止”(AI 生成示意图) 04 把画面停在“下一秒”之前 这套规则里最值钱的一条:画面要停在下一秒即将发生变化的瞬间,而不是已经完成全部剧情的瞬间。原因很实际,这套图要当图生视频的底图用,画面里得留出可动的空间。 具体做法是内置一到两个自然运动元素:风吹头发、衣摆轻动、花草摇晃、烟雾飘散、水面波纹、光斑变化、动物呼吸。但动作必须克制,不要让人物在一张底图里同时奔跑、转身、哭泣、挥手。看“冻结的雨”,雨滴悬在半空,男人伸手想接,画面就停在第一滴雨即将落下的那一刻。这一口气,就是视频的入口。 这条规则同时保护了画面本身:动作越少,模型越不容易画崩。一个克制的瞬间,比十个激烈动作更稳,也更有镜头感。 05 一套设定,两套提示词 每张图会同时输出两套提示词。中文通用版给即梦、可灵、Seedream 这类支持中文输入的模型用,16:9 横版,配固定的中文风格描述:20 世纪 90 年代法国电影美学、复古胶片颗粒、低饱和色彩、16 毫米胶片质感、斑驳阳光、油画般的明暗对比、电影级景深。 Midjourney 版把同样的人物、动作、道具、场景转成精炼英文,结尾锁死一段固定尾缀,不删词、不调序、不加参数。两套提示词的人物、服装、动作、场景必须一一对应,中文写白蛇,英文就不能变成白龙。 锁尾缀这件事反直觉,但有用。风格稳定靠的不是每张图重新描述一遍“电影感”,而是让一段固定风格反复出现。模型会把它当基线,每张图只需要改主体内容,风格自然连贯。 拿“冻结的雨”举例,中文通用提示词大概是这样的:16:9 横版画面,90 年代法国电影美学,复古胶片颗粒,低饱和色彩,16 毫米胶片质感,斑驳阳光,油画般的明暗对比,电影级景深;年轻日本男人站在暴雨中的十字路口,穿深色旧风衣,微微抬起右手想接住什么,所有雨滴悬停在半空,水花凝固成弧线,一张报纸停在半空,画面停在第一滴雨即将落下的瞬间。 06 图生视频:5 秒,一个镜头 图生成后,把图喂给视频模型。第二阶段的标准是:约 5 秒、整段一个连续镜头、不切镜、不转场。运镜只选一个:人物近景就轻微推进,人物和巨物同框就轻微后拉展示比例,前景有遮挡就从前景后方横移。 动态分三层优先级。环境动态(风、水、雾、光斑)优先,其次人物微动作(缓慢眨眼、呼吸带动肩膀、指尖收紧),最后才是生物行为(蛇缓慢抬头、鹿耳朵转动)。动作必须符合真实运动逻辑,不能让巨兽瞬移。 给“冻结的雨”配的视频提示词大概是:极缓慢向前推进,男子抬起的手掌微微张开,悬停的雨滴开始缓慢下落,第一滴水落进他掌心,被风卷起的报纸轻轻晃动,街灯光晕在水汽里散开。(视频仅有音效内容,无音乐) 声音环境也要写进提示词:风声、水流声、雨声、布料摩擦声。视频模型会根据描述配环境音,结尾统一标注“视频仅有音效内容,无音乐”,避免它自作主张加一段配乐。 07 你真正该抄的不是提示词 这套流程走完你会发现,提示词本身反而不是重点。重点是动手之前,你先替画面做了几个决定:谁和谁是什么关系,停在哪个瞬间,留什么给动起来。模型只是执行你的分镜。 下次拿到一个主题,先别急着堆形容词。先写一句关系句,比如“女子把额头贴在巨大白鹿的前腿上,白鹿低头注视她”,再补环境,最后才是风格词。导演想清楚了,演员才知道往哪站。 出图前可以拿四句话自查:人物是谁,和世界是什么关系,动作只有一个吗,画面停在哪个瞬间。四句都答得上来,提示词基本不会跑偏。 08 领取完整 Skill 这套「超现实电影底图提示词导演」Skill 已经打包好放在云盘里,点下面的链接就能直接下载: 点击领取:surreal-cinematic-keyframe-director.zip 下载后把压缩包里的 SKILL.md 放进支持 Skill 的工具(如豆包)的 skills 目录,重启后直接对它说一个主题,就能开始当导演。