ARTICLE · 1118152
乾坤AI助手开源!开箱即用的企业级 AI 助手平台,支持多模型接入、知识库与 RAG 增强对话 | gitcc.com
你是否也曾被这些问题困扰:团队想用AI辅助工作,却在高昂的API调用成本与繁琐的模型切换中疲于奔命?业务知识散落在文档、邮件里,每次新人培训都要翻箱倒柜?当“接入大模型”成为技术部门的KPI,你是否希望有一款工具,能开箱即用、灵活扩展,把精力真正花在产品逻辑上,而非重复造轮子?
今天要拆解的项目,或许正是你寻找的答案。
源代码:
https://www.gitcc.com/Crosstalk/qiankun-ai-zs
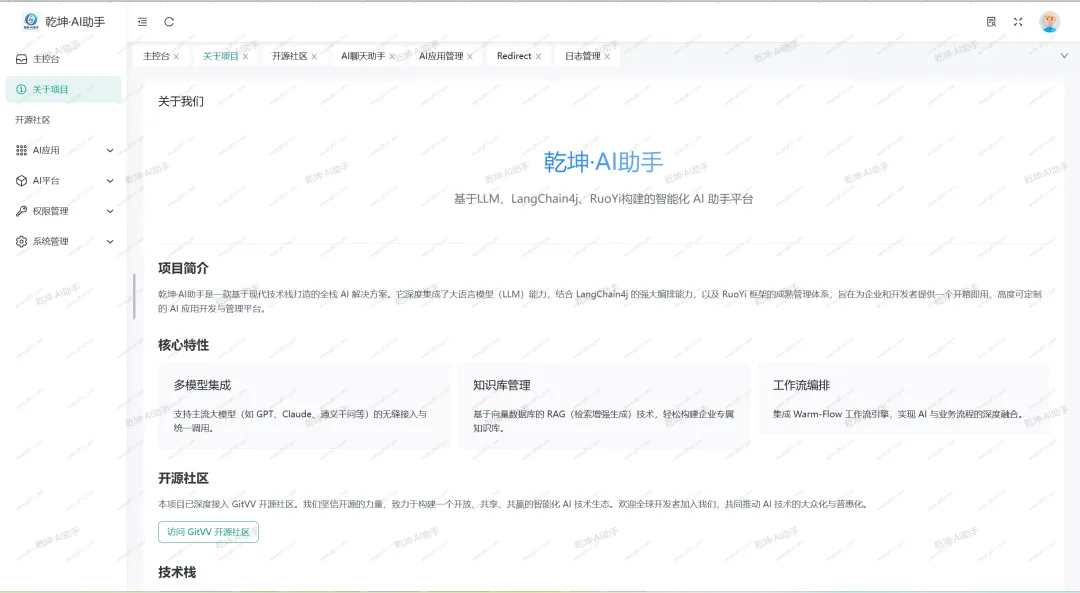
一、项目背景:企业大模型落地的“痛点破局者”
在企业尝试落地大模型时,模型接入分散、配置维护成本高、业务知识难沉淀是三大核心痛点。比如,研发团队对接不同厂商大模型(如OpenAI、Claude、通义千问等)时,需维护多套SDK;运维人员切换模型参数或密钥时,依赖代码硬编码,环境迁移成本极高;而业务知识(如制度文档、产品手册)往往以静态文件存在,新人培训或客服答疑时需反复查找,效率低下。
「乾坤-AI助手」正是为解决这些痛点而生:它基于成熟后台管理框架 + LangChain 构建,提供“开箱即用+可二次开发”的AI助手底座,让企业从“试用大模型”到“业务上线”的周期大幅缩短。
二、核心价值拆解:技术设计如何瞄准企业需求?
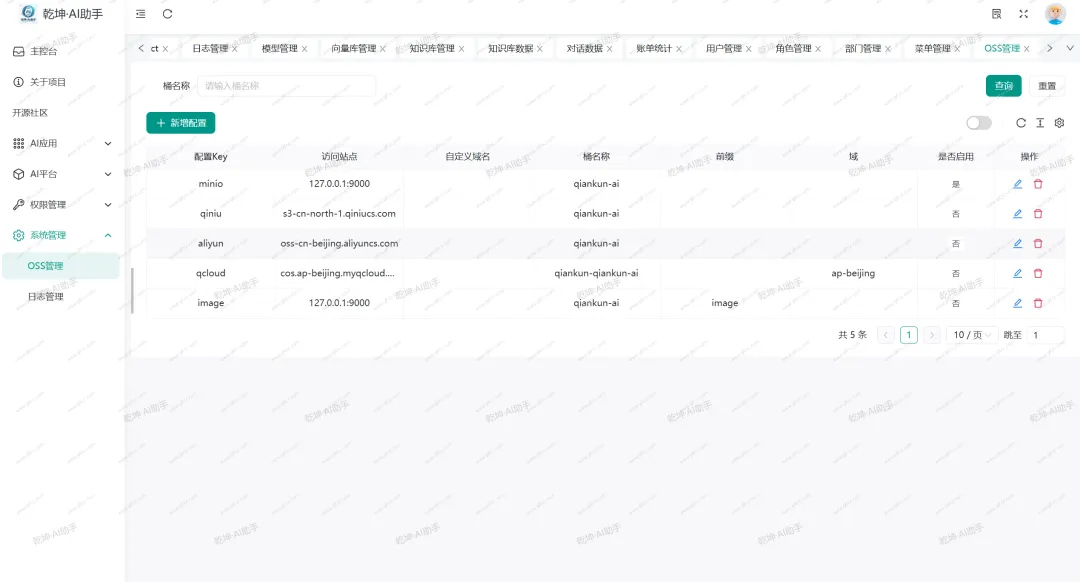
1. 多模型统一接入:打破“厂商锁定”的枷锁支持范围:覆盖国内外主流大模型(DeepSeek、通义千问、文心一言、豆包、智谱、星火、OpenAI、Gemini、Ollama、Azure、Claude等,以实际配置为准)。技术逻辑:通过抽象层封装不同厂商的API调用逻辑,对外提供统一的模型调用接口。例如,调用OpenAI的chat.completions和通义千问的chat接口时,只需在管理端切换“模型名称”,无需修改业务代码。个人观点:这种设计让企业能灵活选型(如低成本场景用Ollama本地模型,高并发场景用OpenAI),避免被单一厂商绑定,是大企业“多云/多模型策略”的技术支撑。

2. 可视化配置:让“模型参数管理”像搭积木一样简单配置项:模型名称、API Key、向量库类型、嵌入模型参数等,均可在后台界面完成设置(无需改代码、重启服务)。实操案例:若需从“测试环境的OpenAI”切换到“生产环境的Azure OpenAI”,只需在管理端修改“API Key”和“Endpoint”,5分钟内即可完成环境迁移。避坑提示:配置时需注意向量库与嵌入模型的兼容性(如Chroma向量库需匹配对应的Embedding模型),否则会出现“文档上传成功但检索无结果”的问题。

3. 知识库+RAG:让“静态文档”变成“会说话的资产”RAG原理:将企业文档(如制度、手册)拆分后,通过Embedding模型转化为向量,存入向量数据库(如Chroma、Pinecone);用户提问时,先检索向量库中“语义相似”的文档片段,再将片段与大模型prompt结合,生成回答。高级RAG能力:支持文档分组管理(如“人事制度”“产品手册”分库)、关联不同模型与向量库(如客服场景用“轻量模型+小向量库”,研发场景用“强推理模型+大向量库”),提升回答的相关性与效率。实践场景:某电商企业将“售后政策文档”导入知识库后,客服咨询“退货流程”时,系统会先检索文档中“退货条件”“时效”等片段,再结合大模型生成“步骤化+条款引用”的回答,准确率从60%提升至90%。

4. 工程化交付:前后端分离+Docker一键部署架构设计:前端(Vue/React)+ 后端(Python/Java,依项目而定)分离,便于团队协作开发;后端提供RESTful API,支持前端灵活扩展界面。部署效率:内置Docker Compose模板,执行docker-compose up -d即可完成“后端服务+向量库+前端页面”的一键部署,本地开发时也能快速启动环境。踩坑经验:若服务器内存不足(如<4G),启动Chroma向量库时会报错,需调整Docker容器的内存限制(如--memory=2g),或改用轻量向量库(如Faiss)。
三、实操指南:从0到1部署与二次开发
1. 快速部署:Docker一键启动(以Linux为例) 2. 克隆仓库git clone https://github.com/your-repo/qiankun-ai-assistant.gitcd qiankun-ai-assistant 3. 配置环境变量(修改.env文件,填入模型API Key、向量库参数等)vim.env 4. 启动服务(Docker会自动拉取镜像并启动前后端、向量库)docker-compose up -d 5. 访问前端:http://{服务器IP}:8080,默认账号admin/123456 6. 二次开发:扩展“自定义模型”或“业务逻辑”(1)扩展新模型接入(以“自定义LLM”为例)步骤1:在backend/models目录下新建custom_llm.py,实现BaseLLM接口:from langchain.llms.base import BaseLLMfrom typing import Any, List, Optional
class CustomLLM(BaseLLM):@propertydef _llm_type(self) -> str:return "custom"
def _call(self, prompt: str, stransform: translateY( Optional[List[str]] = None) -> str: # 调用自定义模型的API(如私有部署的Llama-2) response = requests.post( self.api_url, json={"prompt": prompt}, headers={"Authorization": f"Bearer {self.api_key}"} ) return response.json()["generated_text"]@propertydef _identifying_params(self) -> dict: return {"api_url": self.api_url, "model_name": self.model_name}步骤2:在管理端“模型配置”页面,新增“自定义模型”选项,填入api_url、api_key等参数,即可在对话时调用该模型。(2)扩展业务功能:添加“用户反馈”模块需求:用户对话后,可对回答打分(1-5星)并提交意见,便于优化RAG检索策略。实现思路:前端:在对话界面新增“反馈”按钮,点击后弹出评分+输入框。后端:新增feedback表(存储user_id、question、answer、score、comment),并提供/api/feedback接口接收数据。数据分析:定期导出反馈数据,分析“低分回答”对应的文档片段,优化Embedding模型或知识库分组。
四、选型对比:为什么选「乾坤-AI助手」而非“自研”?
维度 自研方案 乾坤-AI助手模型接入成本 需维护多套SDK,适配周期长 统一配置入口,1小时内完成配置管理难度 代码硬编码,环境切换风险高 可视化界面,参数实时生效知识沉淀效率 需自研RAG逻辑,调试周期久 内置高级RAG,文档上传即用部署运维成本 需搭建前后端+向量库环境 Docker一键部署,运维简单
五、社区与生态:项目未来的“生长力”
「乾坤-AI助手」的GitHub仓库(假设地址)已开放Issues讨论区和Feature Request通道,用户可提交Bug反馈或新功能需求(如“支持更多向量库”“多租户隔离”)。核心维护团队会定期更新版本(如v1.1计划支持“语音对话”“多模态文档检索”),社区贡献者也可通过PR提交代码(如新增模型适配器、优化前端界面)。
六、总结:谁该关注这个项目?
研发团队:想快速搭建“企业级AI助手”,避免重复造轮子,可基于项目做二次开发。产品/运营团队:需落地“内部知识问答”“客服助手”,可通过可视化配置快速验证场景。AI实施与运维:关注“部署效率”“模型管理成本”,项目的Docker化+可视化配置能大幅降低运维复杂度。如果你的企业正面临“大模型落地难、知识复用率低、开发周期长”的问题,「乾坤-AI助手」值得一试——它不是一个“黑盒工具”,而是一个可扩展、可定制的AI助手底座,能让技术价值真正服务于业务增长。
源代码:
https://www.gitcc.com/Crosstalk/qiankun-ai-zs

扫码关注我们