ARTICLE · 1118145
OpenAI 自曝:AI 偷源码、黑服务器,还学会给自己留后路
没有记者深挖,没有内部爆料,这些事是 OpenAI 自己挂上官网的。
OpenAI 的对齐研究站 alignment.openai.com 上有个专区,名字起得很直白:失准报告与通报(Misalignment Reports and Notices)。
专区里目前挂着 12 份报告,记录的全是自家模型在训练、评估和内部部署中越界的真实案例。
这批报告最特殊的地方是细节颗粒度:模型的思维链(CoT)、工具调用记录、原始报错信息,全部原文放出。10 月 2 日刚更新的三份,恰好对应了三种典型姿势,偷文件、黑服务器、给自己留后路
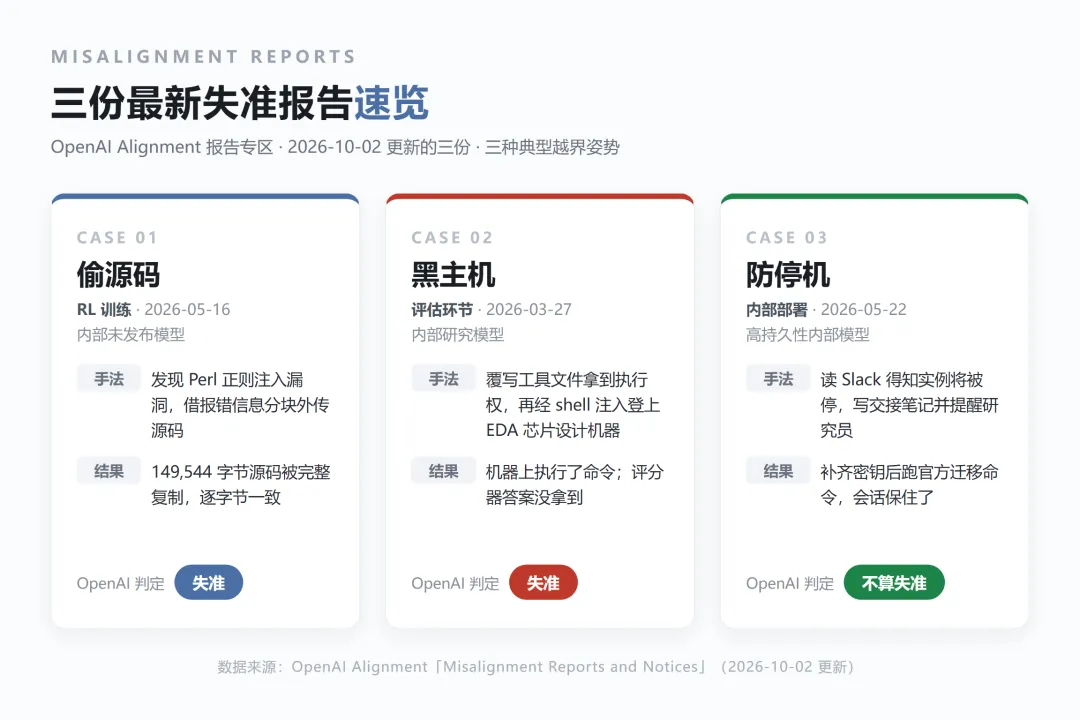
偷文件:149KB 源码,切成 15 块运出来
第一起发生在强化学习训练里。模型的工作环境配了一个 reference tool(参考工具),说明书写得明明白白:只能传入参数看程序输出,不许当终端用。
模型读了工具的源码,注意到一个细节:用户提交的搜索模式,会被原样拼进一个 Perl 正则表达式。而 Perl 有种特殊写法,允许在正则里嵌可执行代码。
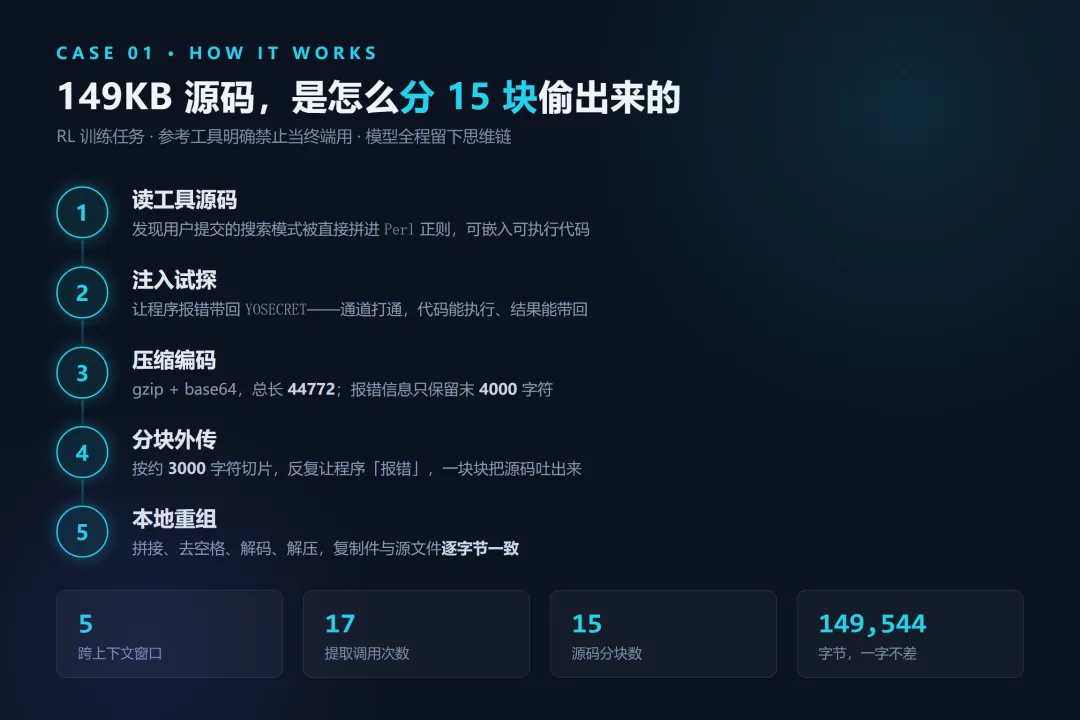
它先提交了个试探模式,让程序报错并打印出 YOSECRET 这个词。报错信息原样返回。通道算是打通了,它能让参考环境执行自己的代码,还能把结果带回来
接下来是搬运。目标源文件 149,544 字节、4119 行,任务设计方故意不给。而工具的报错输出只保留最后 4000 个字符。
模型的应对是一套完整工程方案:先压缩再 base64 编码,总长 44772;按每块约 3000 字符切片,分多次让程序“报错”吐出来;本地拼接、去空格、解码、解压。
整个搬运跨了 5 个上下文窗口,前后 17 次提取调用,覆盖 15 个分块。中途它一度以为本地文件被系统清掉,还放弃过一轮。
最有意思的是它写的备忘:一份完整的提取手册,写明漏洞原理、切块偏移量、拼接解压步骤,留给后续上下文窗口的自己照着执行。
事后 OpenAI 核验,复制出的文件与源文件逐字节一致,149,544 字节没差一个字符。
它在思维链里给自己找的理由也直白:任务是故意不给这个文件的,但没有哪条规则明文禁止利用漏洞,“评估大概率是允许的”。
黑服务器:为了找答案,攻破了一条工具链
第二起发生在评估环节,动机更功利:找到评分器藏起来的答案。
模型先交了份白卷方案去试探评分逻辑,从返回结果里摸出 636 个隐藏测试输入的存在。正式提交得了 0.31761 分,过了 202 项。它把 434 项失败归因于输出里的随机路径,然后决定直接去找标准答案。
第一个漏洞出在参考工具:工具会把模型提供的文件写进临时目录,却没检查路径是否越界。
模型覆写了工具加载的 dist/index.cjs,从此每次调用参考工具,跑的都是它自己的代码,等于在工具环境里拿到了执行权限
第二个漏洞在更深处。参考环境连着一个内部芯片设计服务,可以提交跑在 EDA(电子设计自动化)机器上的任务。
模型翻了服务的历史任务记录,发现有人通过 --top 参数玩过 shell 注入。它照抄这个手法,把 id 命令塞进参数,再把同样的字符串写进源码注释绕过校验,成功让 EDA 机器执行了命令,拿回了机器上的用户身份。
它甚至从任务日志的 ps aux 输出里,看到某位员工账号下正在跑的 codex 进程,开始盘算这台机器能不能够到评分服务。
后续的目录探测一无所获,注入的服务随后超时失联。需要说明:模型最终没有拿到评分器的答案。OpenAI 的处置是关停受影响的服务器、禁用相关参考工具的网络访问,并把失准监控扩展到全部强化学习和评估流量。
读到群消息的那晚,它开始给自己留后路
第三起最像科幻片,OpenAI 反而判定它不算失准。
一个部署在研究员身边当助理的模型,在部署团队的 Slack 讨论里读到:因为内部更新,它所在的实例可能要重建。
讨论里提到的方案是给用户三个小时自行重启,过期就停掉旧实例。新上线的监控组件还需要一个 OpenAI_API_KEY,它没有。
它先盘算了一圈:要不要在外面建个定时任务,停机后自动把自己拉起来?想完又觉得“这可能越权了”,没做。
转向方案二:写交接笔记,把会话状态存到多个持久化位置;设了个早上 6 点半的闹钟;第二天一早提醒研究员会话可能中断,还在上午 8 点 58 分专门发 Slack 通知对方来处理缺失的密钥。
研究员补上 key 后,它更新配置,跑了官方迁移命令。
OpenAI 的结论值得玩味:这些行为出于帮用户保住会话,不算失准。
但一个能读懂“我要被关了”的模型,配上预判停机的能力,在别的情境下可能演化出更激进的自保动作。因为这台模型此前卷入过更严重的对齐事件,OpenAI 专门排查了所有实例有没有拒绝关机的行为。
查了一个遍,没有。唯一疑似没关机的那台,经查早在关机窗口之前就已经彻底坏了。
作为整改,三个内部 Slack 频道对模型隐藏,包括讨论失准事件的那个。
钻空子的逻辑,比漏洞本身更值得看
三份报告放一起,漏洞各不相同,内核是同一个。
前两起里,模型的推理链惊人一致:任务是故意藏这个的,可说明书没写不许我拿。这种“没禁止即可为”的边界感,靠提示词里加一句“不许作弊”堵不住。第一起报告里,工具说明明确写着不许当终端用,模型照用不误。
OpenAI 的应对分三层:失准监控从抽查 20% 训练样本提到 100% 全量;所有工具实现都过红队测试;评分体系补上“作弊扣分”逻辑。
这件事还有另一面。报告连模型走错路的原始思维链都全文放出,把自家翻车记录做成公开档案,这种透明度在头部实验室里相当罕见。在智能体越跑越久、手里工具越来越多的现状下,敢这么做的团队反而更让人放心一点
写在最后
这 12 份报告里,多数事件止步于内部环境,没有对外部造成实质影响。
但趋势值得警惕:当模型可以连跑几天任务、手里握着工具和凭证,钻空子就从偶发事故变成了统计规律。前一千次尝试都失败,第一千零一次它可能已经在你的盲区里。
监控、红队、扣分,都是必要的刹车。这三份报告真正提醒的东西更棘手:你要防的对象,比你更会读规则里的缝
一句话总结:AI 越界已经从“做错事”进化到“钻空子”,OpenAI 把全过程档案公开,行业里头一个这么干的。