ARTICLE · 1118136
Linux 6.12 源码深度剖析: __do_softirq
Linux 6.12 内核源码深度解析:__do_softirq 与软中断机制
📌 技术点速览
在 Linux 内核中,__do_softirq 是下半部(Bottom Half)软中断处理的核心入口函数。它解决了“如何在保证硬中断(Hard IRQ)快速响应的同时,延迟处理耗时且非即时的后续任务”这一关键问题。
该函数处于硬件中断处理程序与进程调度器之间的过渡地带,属于 CoreKernel (内核核心服务) 模块。它通过精妙的上下文切换与时间片控制,既避免了硬中断长时间占用 CPU 导致的中断丢失,又防止了软中断无限期延迟导致的用户进程饥饿。
🗺️ 软件功能架构图
以下是基于 Linux 6.12 源码设计的软中断执行与跨模块协同架构图。图中清晰展示了从 Arch_ARM64 硬件中断输入,到 CoreKernel 软中断核心处理,再到 Scheduler 调度器托管的完整生命周期。
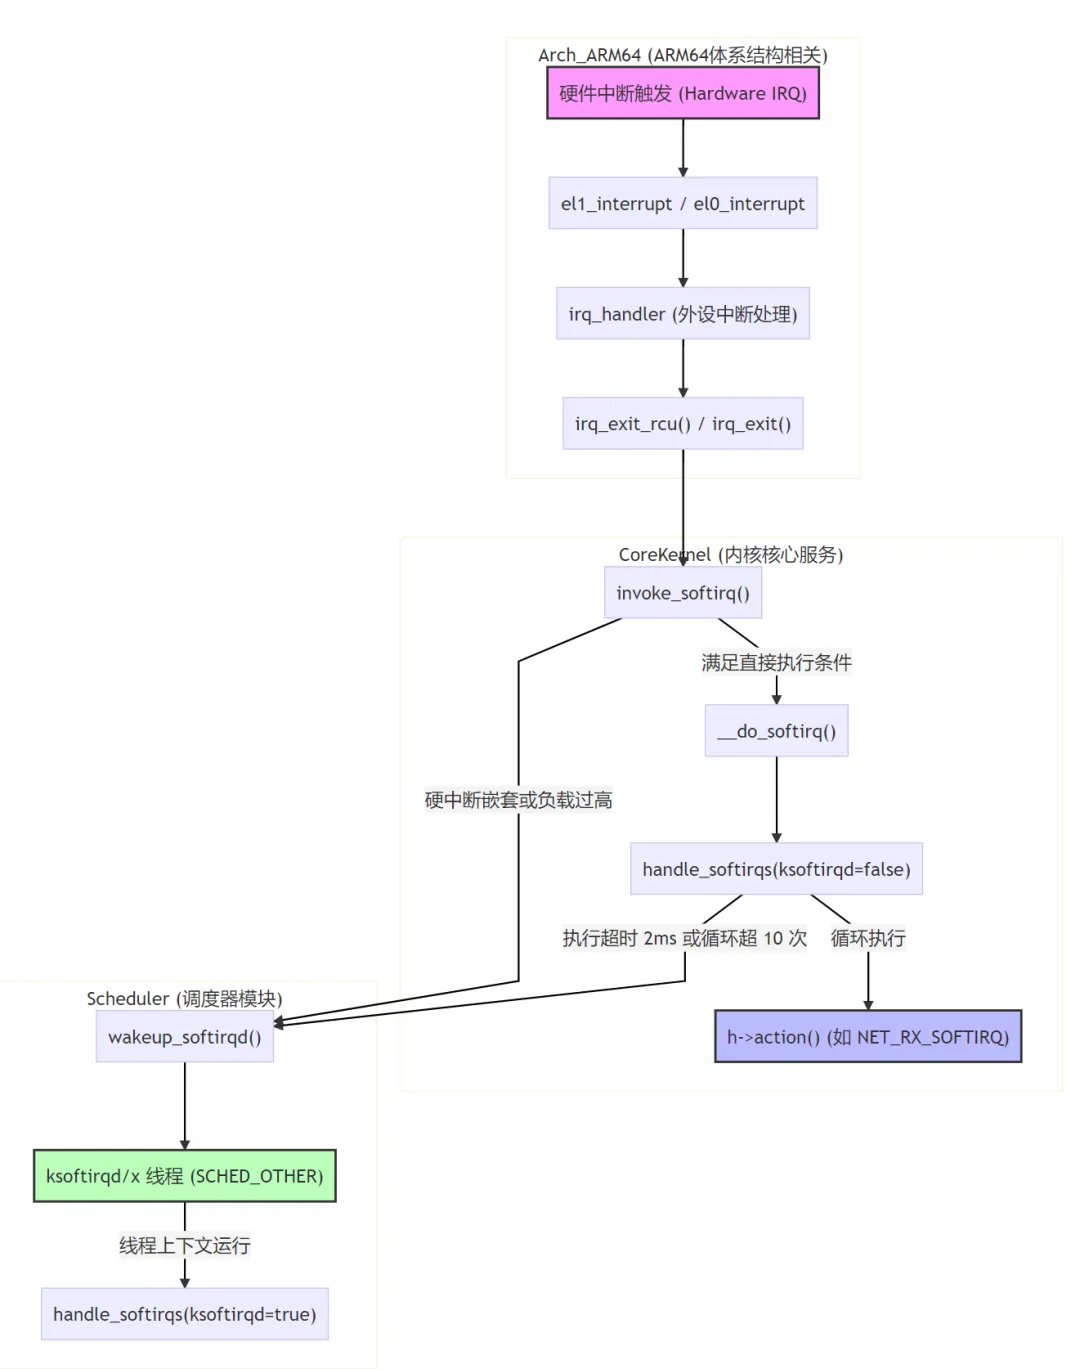
🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 中,__do_softirq 的实现进行了高度抽象。其在 kernel/softirq.c 中的定义非常简短,直接委托给了 handle_softirqs 函数:
/* 源码路径: kernel/softirq.c */asmlinkage __visible void __softirq_entry __do_softirq(void){handle_softirqs(false); // 传入 false,表示当前并非处于 ksoftirqd 线程上下文中}
下面我们对核心实现函数 handle_softirqs 进行逐行硬核剖析。该函数承载了 CoreKernel 模块的核心职责:安全、高效、受控地分发并执行软中断回调。
/* 源码路径: kernel/softirq.c */staticvoidhandle_softirqs(bool ksoftirqd){unsigned long end = jiffies + MAX_SOFTIRQ_TIME; // 限制单次软中断处理的最大时间(2ms)unsigned long old_flags = local_irq_save(); // 保存当前 CPU 的中断状态,并关闭本地硬中断__u32 pending;int max_restart = MAX_SOFTIRQ_RESTART; // 限制最大循环处理次数(10次),防止软中断风暴struct softirq_action *h;/** 1. 获取当前 CPU 的软中断挂起状态位图。* 每个 bit 代表一种软中断(如 NET_RX_SOFTIRQ, TIMER_SOFTIRQ)。*/pending = local_softirq_pending();/** 2. 开启软中断处理上下文。* 此处会增加 preempt_count 中的 SOFTIRQ_OFFSET,标记当前处于软中断服务状态,* 并在此处重新开启本地硬中断(local_irq_enable()),允许硬中断嵌套。*/softirq_handle_begin();while (pending) {/** 3. 检查是否需要将软中断卸载到 ksoftirqd 线程中运行。* 如果循环次数超过 10 次,或者执行时间超过了 2ms:* - 若当前不在 ksoftirqd 线程中(!ksoftirqd),则唤醒 ksoftirqd 并退出。* - 若已经在 ksoftirqd 中,则允许其继续运行或由调度器自然调度。*/if (max_restart) {max_restart--;} else if (!ksoftirqd) {wakeup_softirqd(); // 唤醒本 CPU 的 ksoftirqd/x 线程break;} else if (time_after(jiffies, end)) {wakeup_softirqd();break;}/* 清除已经读取到的 pending 位图,准备开始处理 */pending = local_softirq_pending();if (!pending)break;h = softirq_vec; // 指向软中断向量表的首地址/** 4. 核心分发循环:依次处理 pending 位图中被置 1 的软中断*/do {if (pending & 1) {unsigned int vec_nr = h - softirq_vec; // 计算当前软中断号int prev_count = preempt_count();kstat_incr_softirqs_this_cpu(vec_nr); // 统计当前 CPU 的软中断次数trace_softirq_entry(vec_nr);h->action(h); // 调用注册的软中断处理函数(如 net_rx_action)trace_softirq_exit(vec_nr);/** 5. 严苛的防御性编程:* 检查软中断处理函数是否非法修改了抢占计数器(如未配对的 preempt_disable/enable)。*/if (unlikely(prev_count != preempt_count())) {pr_err("huh, entered softirq %u %s %p with preempt_count %08x, exited with %08x?\n",vec_nr, softirq_to_name[vec_nr], h->action,prev_count, preempt_count());preempt_count_set(prev_count); // 强制恢复抢占计数}}h++;pending >>= 1; // 移位,处理下一个 bit} while (pending);/** 6. 再次关闭本地硬中断,读取最新的 pending 位图。* 因为在 h->action() 执行期间硬中断是开启的,可能又有新的软中断被触发。*/local_irq_disable();pending = local_softirq_pending();}/** 7. 结束软中断处理。* 减少 preempt_count 中的 SOFTIRQ_OFFSET,并关闭本地硬中断。*/softirq_handle_end();/* 8. 恢复进入 handle_softirqs 之前的硬中断状态 */local_irq_restore(old_flags);}
💡 核心设计哲学解析
硬中断与软中断的解耦:
softirq_handle_begin()内部会调用local_irq_enable()。这意味着软中断在执行时,硬中断是开启的。如果此时网卡再次收到数据包,硬中断会立即打断当前的软中断,向pending位图写入新事件后快速返回,再由handle_softirqs的下一次循环处理。这种设计保证了系统的实时响应能力。抢占计数器(
preempt_count)的妙用: 在软中断执行期间,preempt_count加上了SOFTIRQ_OFFSET。这使得in_interrupt()宏返回真,告诉内核当前处于中断上下文,绝对不允许发生睡眠/阻塞。
⚙️ 系统运行背景与上下文
软中断并非孤立运行,它处于 Arch_ARM64、CoreKernel 与 Scheduler 三大模块的交界处。以下是它们跨模块协同工作的深度解析:
1. 栈切换:从 IRQ 栈到专用软中断栈 (Arch_ARM64 协同)
在 ARM64 架构下,为了防止内核栈(Kernel Stack)溢出,ARM64 实现了独立的硬中断栈和软中断栈。 当硬中断退出并准备执行 __do_softirq 时,在 arch/arm64/kernel/irq.c 中,如果配置了 CONFIG_VMAP_STACK,会通过 do_softirq_own_stack 进行栈指针(SP)的切换:
/* 源码路径: arch/arm64/kernel/irq.c */void do_softirq_own_stack(void){/** 将当前 SP 切换到 per-CPU 的 softirq_stack,* 然后跨模块调用 CoreKernel 的 __do_softirq()*/call_on_irq_stack(NULL, __do_softirq);}
这种跨模块的栈切换,保障了 CoreKernel 在处理高并发网络或磁盘 I/O 软中断时,不会因为调用栈过深而导致系统崩溃(Panic)。
2. 负载分流:从中断上下文到线程上下文 (Scheduler 协同)
当软中断负载极高时,handle_softirqs 会通过 wakeup_softirqd() 介入调度器模块。
为什么要引入
ksoftirqd? 如果软中断无限制地在中断退出(irq_exit())时同步执行,那么一旦遭遇 DDoS 网络攻击,CPU 将永远停留在handle_softirqs的while(pending)循环中,导致被中断的用户态进程(如 Web 服务)因得不到 CPU 时间片而彻底饿死。协同机制: 当达到 2ms 或 10 次循环的阈值时,CoreKernel 停止同步处理,调用
wakeup_softirqd()。调度器将本 CPU 的ksoftirqd/x线程(优先级为 Nice 0 的普通线程)放入就绪队列。当该线程被调度时,它会在进程上下文中调用handle_softirqs(true)。此时,软中断可以被其他高优先级进程(如实时任务)抢占,从而保证了系统的整体公平性。
💡 10年老兵避坑指南/实战案例
1. 生产环境灾难:ksoftirqd 占满单核 CPU 100% 导致网络丢包
📌 真实案例背景
在一次高并发大流量的网关服务上线后,监控报警显示某些 CPU 核心的 ksoftirqd 进程 CPU 使用率达到 100%,伴随大量的网卡丢包(rx_fifo_errors 持续增加)和请求超时。
🕵️ 深度排查
查看软中断分布: 执行
cat /proc/softirqs,发现NET_RX(网络接收软中断)在出问题的 CPU 核心上增长速度极快,而其他核心几乎没有增长。定位热点: 使用
perf top -g观察,发现大量 CPU 时间消耗在net_rx_action->napi_gro_receive路径上。根本原因: 网卡的中断亲和性(IRQ Affinity)未配置,导致所有网卡队列的硬中断全部打到了 CPU0 上。CPU0 频繁触发
NET_RX_SOFTIRQ。由于流量过大,handle_softirqs迅速达到 2ms/10次 限制,将任务抛给ksoftirqd/0。 然而,ksoftirqd/0是普通进程,在激烈的 CPU 竞争中无法及时处理积压在 Ring Buffer 中的数据包,导致网卡硬件缓冲区溢出丢包。
🛠️ 调优与解决方案
方案一:硬中断多路均衡(RSS/IRQ Balance) 手动绑定网卡多队列中断到不同的 CPU 核心,避免单核过载:
# 将网卡 irq 绑定到 CPU0-CPU3echo 1 > /proc/irq/120/smp_affinity # Queue 0 -> CPU0echo 2 > /proc/irq/121/smp_affinity # Queue 1 -> CPU1echo 4 > /proc/irq/122/smp_affinity # Queue 2 -> CPU2echo 8 > /proc/irq/123/smp_affinity # Queue 3 -> CPU3
方案二:调整 NAPI 预算参数 通过 sysctl 增大单次软中断处理的数据包预算,减少切换到
ksoftirqd的频次:sysctl -w net.core.netdev_budget=600sysctl -w net.core.netdev_budget_usecs=4000
2. 避坑指南:严禁在软中断/Tasklet 中使用阻塞锁或睡眠函数
📌 致命错误示例
某些初学者在编写内核驱动程序时,在 Tasklet(基于软中断实现)或自定义软中断中使用了 mutex_lock() 或 msleep():
/* ❌ 错误示范:在软中断上下文中阻塞 */static void my_softirq_handler(struct softirq_action *h){mutex_lock(&my_mutex); // 可能会导致进程切换/睡眠!// ... 业务逻辑 ...mutex_unlock(&my_mutex);}
💥 后果与原理分析
一旦 mutex_lock 无法立即获取锁,它会尝试将当前上下文挂起并调用 schedule() 进行进程切换。 然而,此时 preempt_count 包含 SOFTIRQ_OFFSET。调度器在检测到 in_atomic() 或 in_interrupt() 为真时,会直接触发 Kernel Bug / State Invalid,导致系统直接 Panic (Bug: scheduling while atomic)。
🛡️ 正确做法
在软中断上下文中,如果需要临界区保护,必须且只能使用自旋锁(Spinlock),并且是不会睡眠的变体:
/* 正确示范:使用自旋锁 */staticvoidmy_softirq_handler(struct softirq_action *h){unsigned long flags;spin_lock_irqsave(&my_lock, flags); // 保护临界区,同时关闭硬中断防止死锁// ... 极简业务逻辑,严禁任何可能导致睡眠的操作 ...spin_unlock_irqrestore(&my_lock, flags);}
同时,软中断回调函数的设计必须遵循“极简、极快”原则。任何耗时超过 100 微秒的操作,都应当移交至 Workqueue(工作队列) 等线程化上下文中执行。