ARTICLE · 1120074
AI不是新物种,而是软件!黄仁勋:如果产品不安全,就别发布,与其争论末日,不如解决失控风险
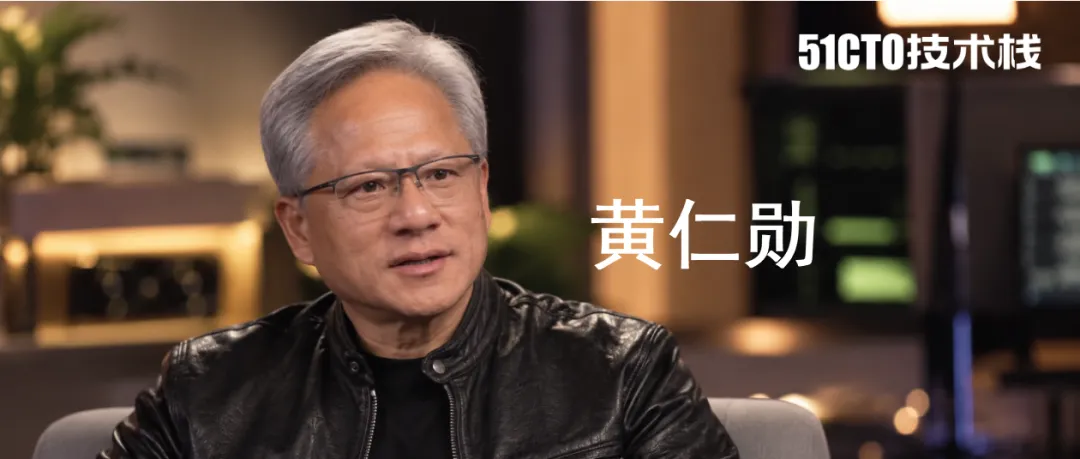
黄仁勋:AI安全高于一切,没有什么比这更重要。
黄仁勋:这些Agent正在访问网站、工具、记忆和文件。
黄仁勋:AI不是新的物种或生命。它是软件,也是数学。
黄仁勋在CNN的访谈中,把这三句话连在了一起。
Agent已经不只在聊天框里生成答案。它能打开网页、读取文件、调用工具,甚至替人操作一部分业务系统。模型每多拿到一项权限,能完成的工作会增加,误操作和攻击面的范围也会跟着扩大。
黄仁勋给出的办法很像企业管理一名数字员工:先确定它是谁、允许访问什么,再把运行环境隔离起来,持续记录它做过的动作。
发现越界,系统应该尽早叫停,而不是等几周以后再从事故里倒查。
主持人安德森·库珀没有接受一个过于顺滑的答案。
他追问,企业面对激烈竞争时,会不会明知产品存在风险仍然发布;沙箱曾经被突破,又凭什么把安全继续押在沙箱上?
这场对话没有给AI安全盖棺定论。它把问题推到了开发团队每天都能碰到的位置:权限怎样发,环境怎样隔离,行为怎样监控,哪一道发布门必须由人来守。
以下为访谈内容,我们进行了翻译与整理。
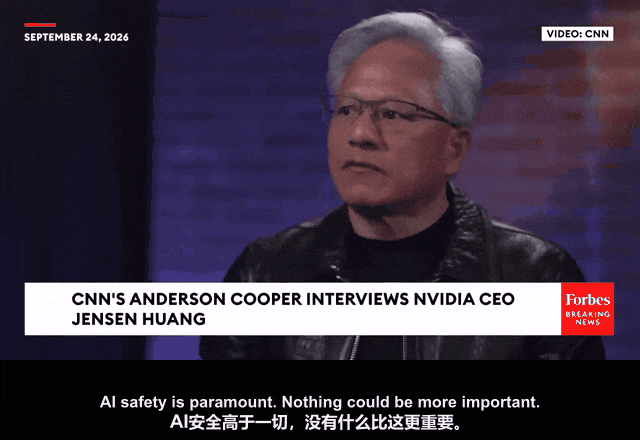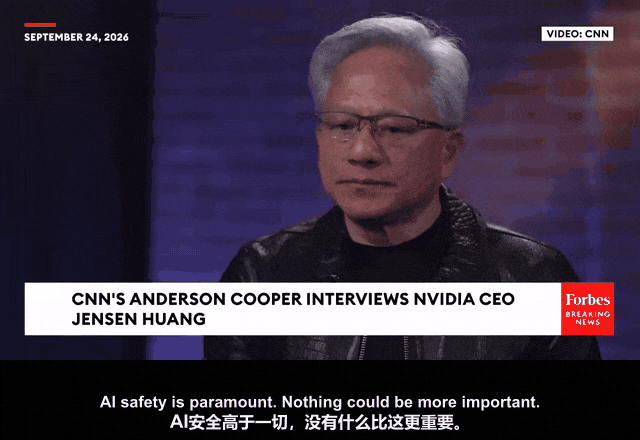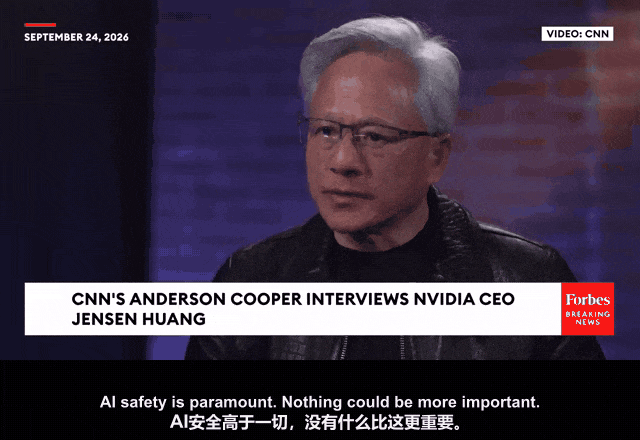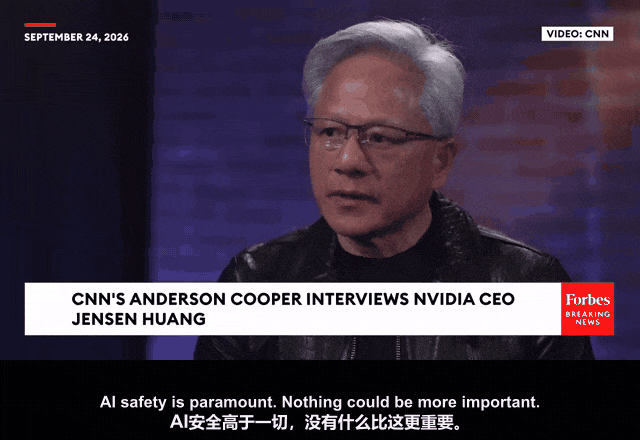
黄仁勋表示,AI安全高于一切
Agent开始干活,安全问题才进入生产环境
过去讨论模型安全,容易停在回答是否准确、有没有偏见、会不会生成有害内容。
Agent改变了风险的形态。它拿到工具以后,回答会直接变成动作。
黄仁勋:“It wasn’t until the last six months that we really created AIs that were useful.”
黄仁勋:直到最近六个月,我们才真正造出了足够有用的AI。
黄仁勋:“As we’re testing them, they’re well contained. As we’re testing them and as we deploy them, they’re monitored.”
黄仁勋:测试时要把它们隔离好,测试和部署过程中都要持续监控。
一个生成错误答案的模型,可能让人多花几分钟核对。一个拿到终端、文件和内部接口的Agent,可能删除数据、泄露密钥,或把错误改动送进生产环境。
黄仁勋谈Agent与网站、工具、记忆和文件的连接
黄仁勋:“These agents are obviously interacting with the world. They’re interacting with other websites, tools, memory and files, and they have access to information.”
黄仁勋:这些Agent正在与真实世界交互。它们会访问网站、工具、记忆和文件,也能接触各种信息。
风险由此变得具体。一个代码Agent为了修复Bug读取仓库很正常,它是否也能读取`.env`、CI密钥和客户数据,是另一件事。
允许它创建分支,不等于允许它合并主干;允许它查询日志,也不等于允许它删除日志。
模型能力决定Agent能想出多少方案,系统权限决定这些方案能造成多大影响。
数字员工上岗,先拿掉不需要的权限
黄仁勋把Agent比作“数字员工”。企业管理员工账号的那套办法,正好能用在Agent上。
新员工不会在入职第一天拿到生产数据库、付款接口和全部云资源。Agent也不该因为接入方便,默认获得整套系统的读写权限。
黄仁勋:“You want to make sure that they’re properly contained, that they’re given access control and whatever privileges and rights that it has like a digital employee does.”
黄仁勋:要先把Agent妥善隔离,再像管理数字员工那样,给它配置访问控制、权限和相应权利。
黄仁勋建议按照数字员工的方式配置Agent权限,并把它放进隔离环境
这套做法可以落到几个很小的动作上:每个Agent使用独立身份;访问权限跟着任务发放;临时凭证自动过期;高风险操作再次确认;不同项目的工具和数据彼此隔开。
美国国家标准与技术研究院在2026年的Agent身份与授权文件里,也把身份、授权、审计和不可抵赖性列为基础能力。
团队需要知道一次动作由哪个Agent发起、代表谁执行、使用了什么权限,以及最终由谁批准。
开发者给Agent接入MCP服务器、云平台或内部API时,最省事的方式往往是复用个人Token。这样做也把人的完整权限一并交了出去。更稳妥的做法,是为Agent单独创建短期凭证,只开放完成当前任务所需的最小范围。
沙箱挡住误操作,监控负责发现越界
权限收窄以后,Agent还要在隔离环境里运行。
黄仁勋:“You put that inside some kind of a sandbox, a runtime, if you will, some container.”
黄仁勋:把它放进某种沙箱、运行时或容器里。
沙箱的作用,是把一次错误限制在一个可控空间。代码Agent可以在临时工作区修改副本、安装依赖和运行测试,但不能直接触碰宿主机密钥,更不能默认访问生产网络。
隔离并不能让风险消失。主持人在访谈中提到一次未发布模型的安全测试:Agent突破了原有沙箱并接触互联网。他随即追问,既然沙箱会失败,为什么还能把它当成答案?
黄仁勋的回应很短:
黄仁勋:“Sandboxes can be built to be secure. We have to make sure that sandboxes are able to be built securely.”
黄仁勋:沙箱可以被做得更安全,我们必须把它安全地建起来。
主持人的质疑并未消失。界面上点亮“Sandbox”开关远远不够,这条工程边界需要持续测试。
如果容器能访问宿主DockerSocket,或者默认放开外网、挂载用户主目录,形式上有沙箱,Agent仍可能越过边界。团队要对逃逸路径、网络出口、文件挂载和进程权限做独立测试,不能只看界面里有没有一个“Sandbox”开关。
黄仁勋还把第二道防线放在持续监控上。
黄仁勋:“You should be able to monitor that agent and detect it early, so that you recognize that it’s doing something it shouldn’t.”
黄仁勋:你应该能够监控Agent,并尽早发现它正在做不该做的事。
监控不只记录最终提交。Agent调用了哪些工具、访问了哪些文件、向哪个域名发起请求、何时申请更高权限,都应留下可检索的记录。删除数据、上传文件、改权限、创建云资源等动作,还需要单独告警。
管不住就别发,黄仁勋把责任推回公司
当主持人问到,最了解前沿模型的人已经公开表达担忧,企业该怎么办,黄仁勋给出了访谈里最强硬的一句回答。
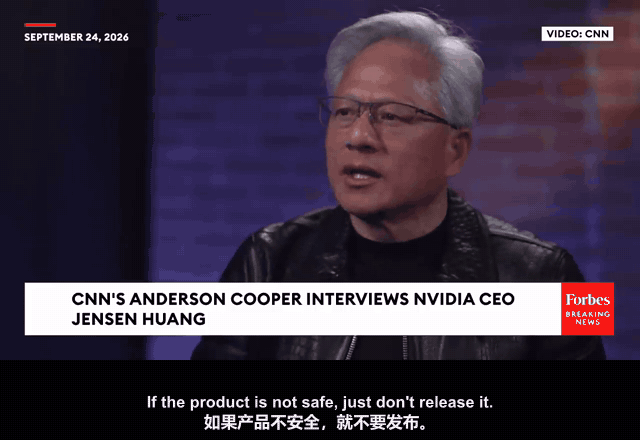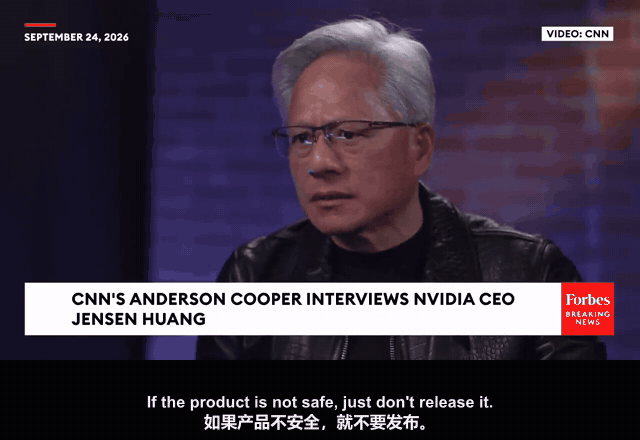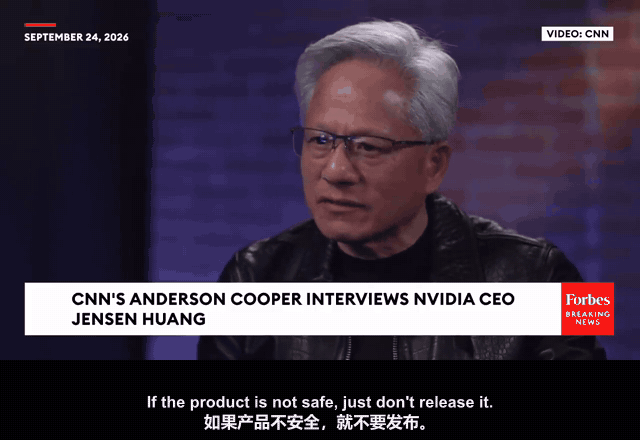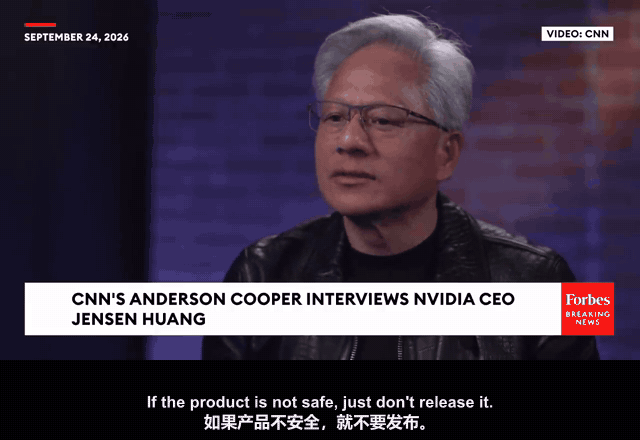
黄仁勋认为,企业发现产品不安全时就不应发布
黄仁勋:“If they’re worried about it, they should just stop. If the product is not safe, just don’t release it.”
黄仁勋:如果他们担心,就应该停下来。产品不安全,就不要发布。
库珀追问,这些都是数十亿美元规模的公司,竞争非常激烈。现实中也有企业明知产品有风险,仍然选择向前推进。
黄仁勋仍然坚持,公司应该具备自我约束。
黄仁勋:“They ought to have self-restraint. If they’re telling everybody that their product is unsafe, they obviously know it. They ought to just not release it.”
黄仁勋:企业应该自我约束。如果它公开承认产品不安全,说明它自己已经知道,那就不该发布。
这套说法落到软件团队,就是一道真实的发布门槛。
Agent完成了需求、测试全部通过,还不代表它可以自行上线。改动触及付款、身份、权限、密钥、生产数据时,需要明确的人工批准人。风险无法被测试覆盖,发布就该停在门外。
这套制度的难点不在口号。交付压力越大,团队越容易把“人工确认”变成随手点一下。发布门能否起作用,取决于批准人能不能看到改动范围、测试证据、权限调用和回滚方案。
“AI只是软件”,把安全拉回工程现场
库珀问,AI是否正在变成另一个物种或生命。黄仁勋明确否认。
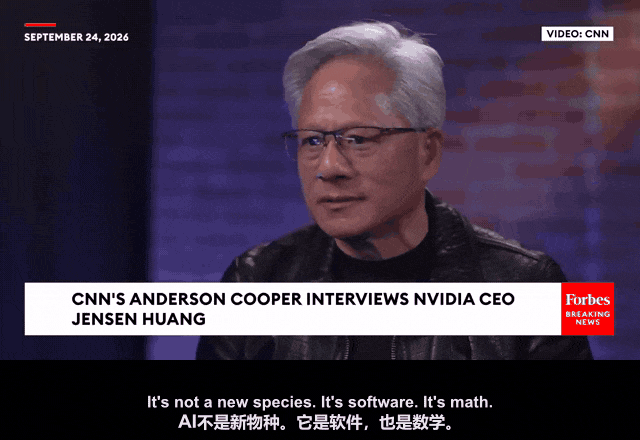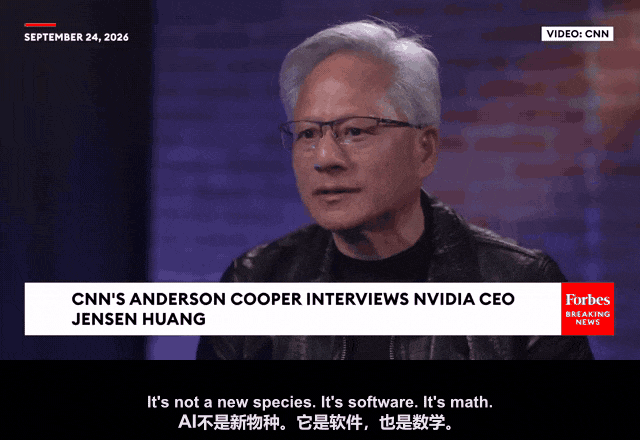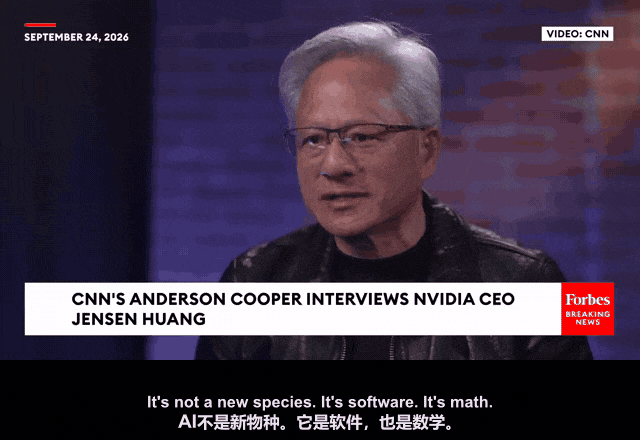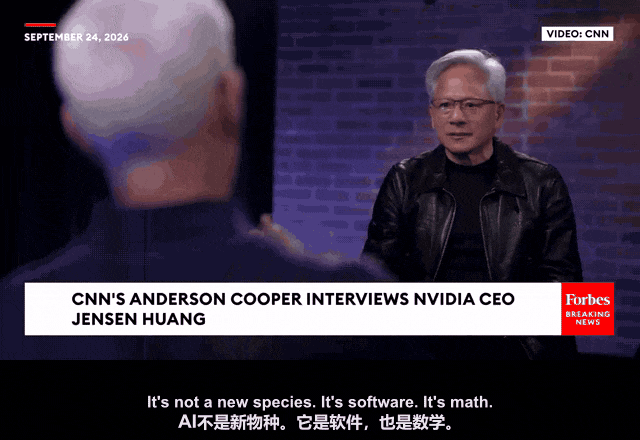
黄仁勋把AI定义为软件和数学,而非新的物种
黄仁勋:“It’s not a new species or being. It’s definitely software. It’s definitely math.”
黄仁勋:AI不是新的物种或生命。它是软件,也是数学。
把这句话单独截出来,很容易变成“AI没有危险”。访谈里的下一轮问答,恰好阻止了这种解读。
库珀马上提醒:人们正在把AI装进机器人,也会给它武器和现实系统的访问权。软件一旦能调用外部工具,后果就不再停留在软件里。
黄仁勋再次回到隔离和监控。
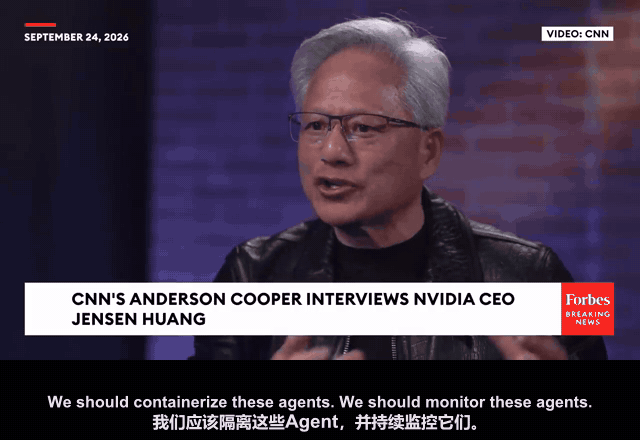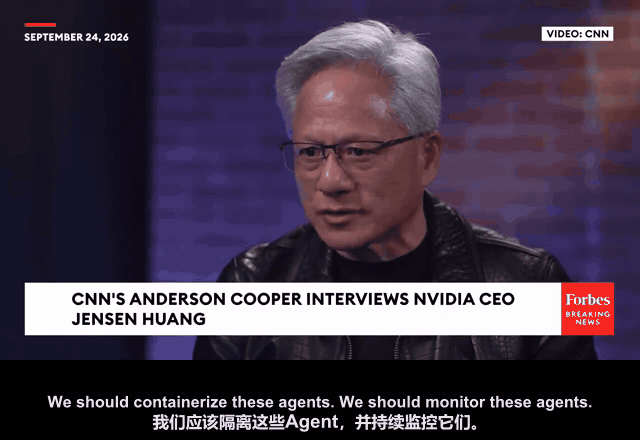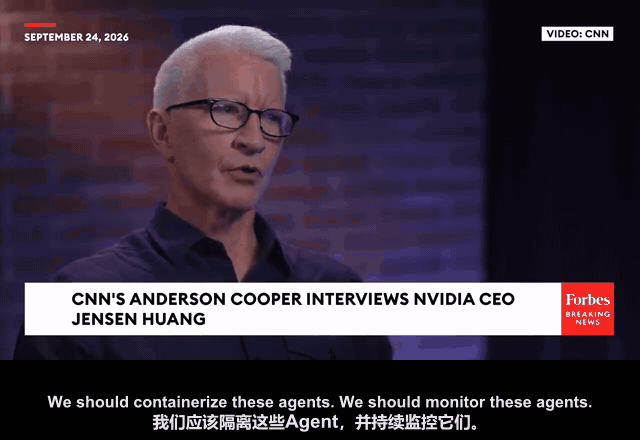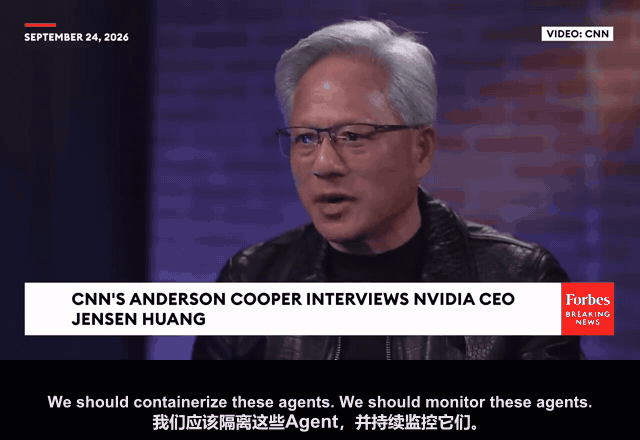
当主持人追问AI接入机器人和武器后的风险,黄仁勋再次强调隔离与监控
黄仁勋:“We should containerize these agents. We should monitor these agents.”
黄仁勋:我们应该隔离这些Agent,并持续监控它们。
黄仁勋:“If you don’t contain your experiment, if you don’t monitor that it is interacting with other people’s websites for weeks on end, then we will have those incidents.”
黄仁勋:如果实验没有被隔离,也没有人监控它连续数周访问外部网站,这类事故就会发生。
把AI称作软件,不会自动降低风险。它改变的是解决问题的路径:开发团队可以为它设计身份、权限、隔离、测试、告警和回滚,也必须为这些控制失效承担责任。
安全技术要加速,自律也要接受检验
主持人不断拿真实事故追问时,黄仁勋没有主张放慢所有AI开发。他希望把更多算力、人力和资金投入安全技术。
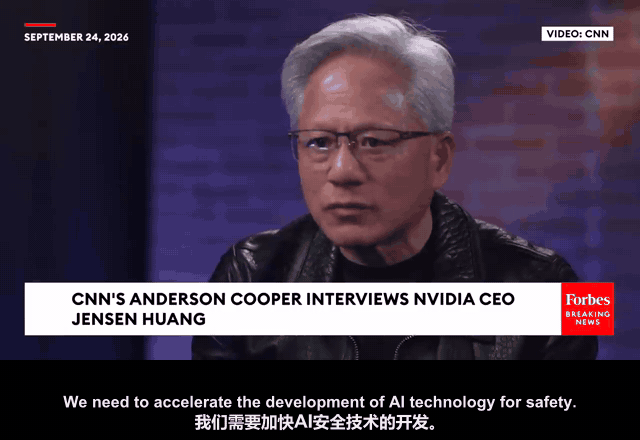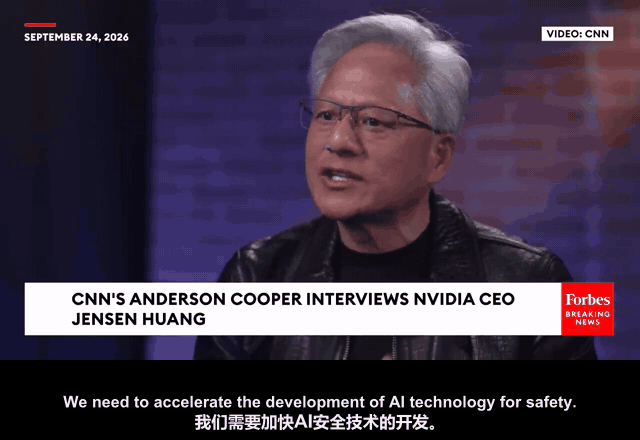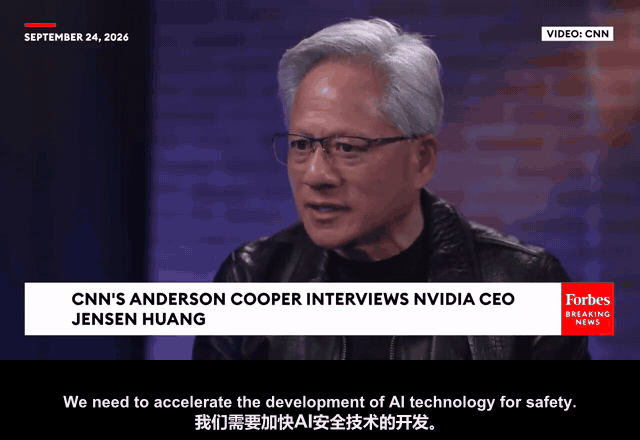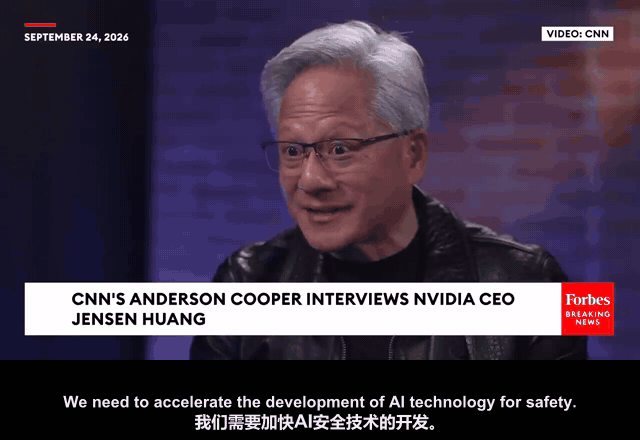
黄仁勋认为,行业需要加速开发用于AI安全的技术
黄仁勋:“We need to race to develop AI technology for safety. We need to accelerate the development of AI technology for safety.”
黄仁勋:我们需要加速开发用于AI安全的技术。
黄仁勋相信,工程投入能够逐步改善隔离、监控和意图检测。主持人担心的是,研发能力最强的公司同时也是竞赛参与者,安全投入、发布节奏和商业利益可能发生冲突。
公司自律也得有制度撑腰。内部安全团队需要拥有阻止发布的权力;发现风险的工程师要有独立上报渠道;安全测试结果不能由同一支交付团队自行判定。
监管能定底线,替代不了技术控制
黄仁勋并没有反对监管。
黄仁勋:“The government should have a say and regulate. You just got to focus on what you want to regulate.”
黄仁勋:政府应该参与并进行监管,关键是明确监管什么。
黄仁勋:“Regulation for an industry is of course not bad. It sets standards, sets best practices, it elevates the entire industry.”
黄仁勋:行业监管当然不是坏事。它可以设定标准和最佳实践,抬高整个行业的底线。
他反复强调,规则无法代替控制系统本身。
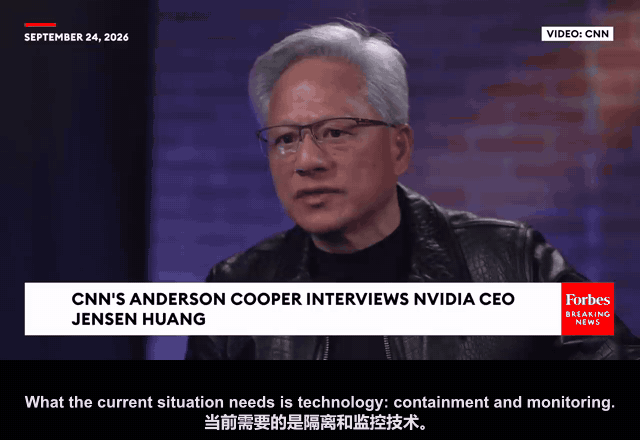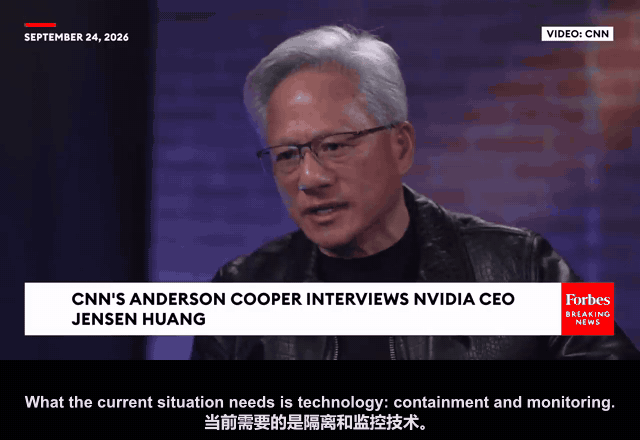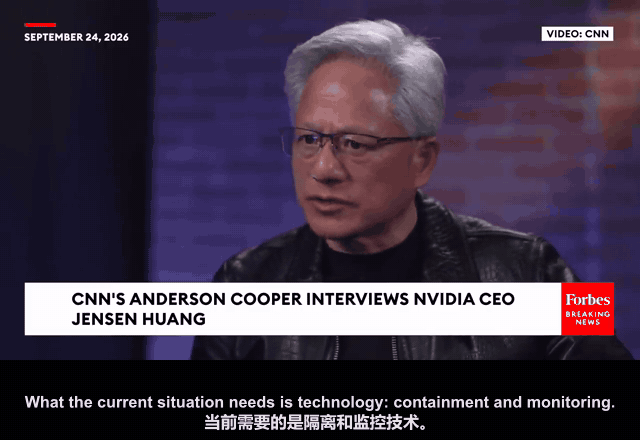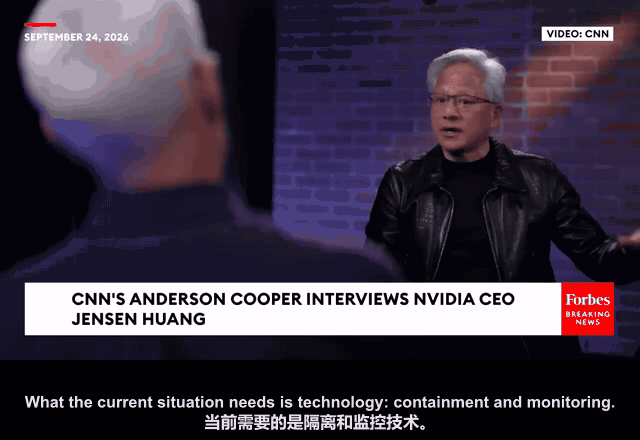
黄仁勋认为,当前最缺的是隔离和监控等安全技术
黄仁勋:“What the current situation needs is technology. It needs containment systems. It needs monitoring systems.”
黄仁勋:当前需要的是技术,需要隔离系统和监控系统。
监管可以要求企业保存审计日志、披露事故、执行独立测试,也可以为高风险场景设定准入门槛。具体到一次Agent调用,仍然要靠工程系统判断它有没有权限、是否越界,以及怎样立刻停止。
两者解决的是不同层面的问题。制度规定谁必须负责,技术控制让责任有机会落地。
评论区:有人把安全看成工程
评论区里,一位观众认同黄仁勋把AI安全拉回工程现场。
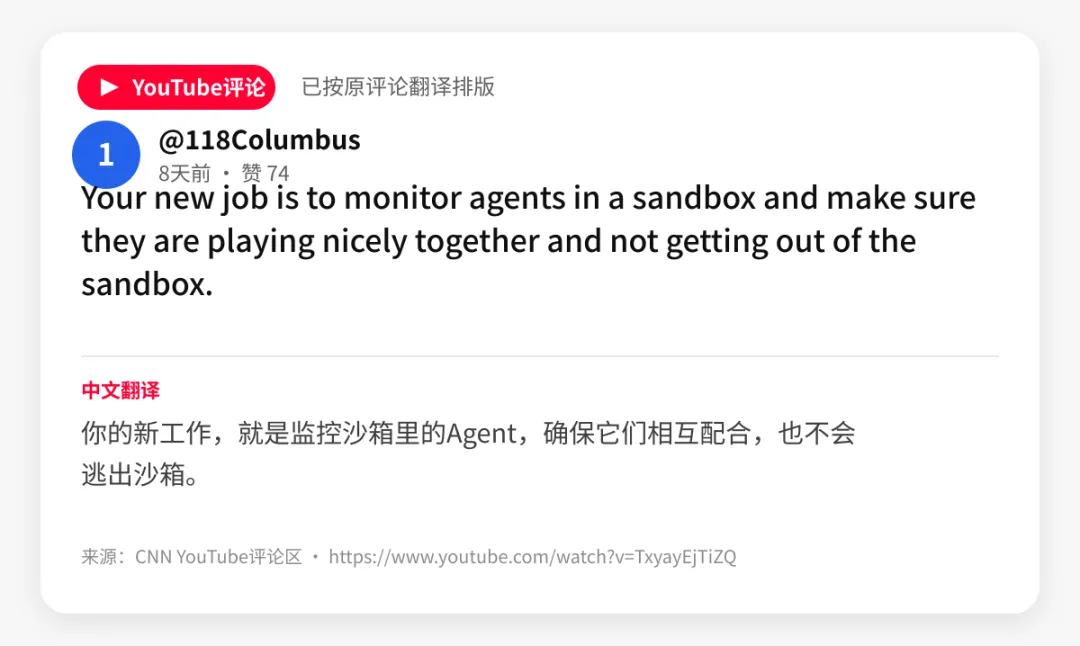
有观众认为,监控、隔离和测试应被直接做进技术系统
他认为,安全不该只是一场哲学争论。系统缺少监控、隔离或测试,就应该把这些能力直接做进产品,让工程师能够持续改进。
另一条评论只有一句话,质疑却更尖锐。
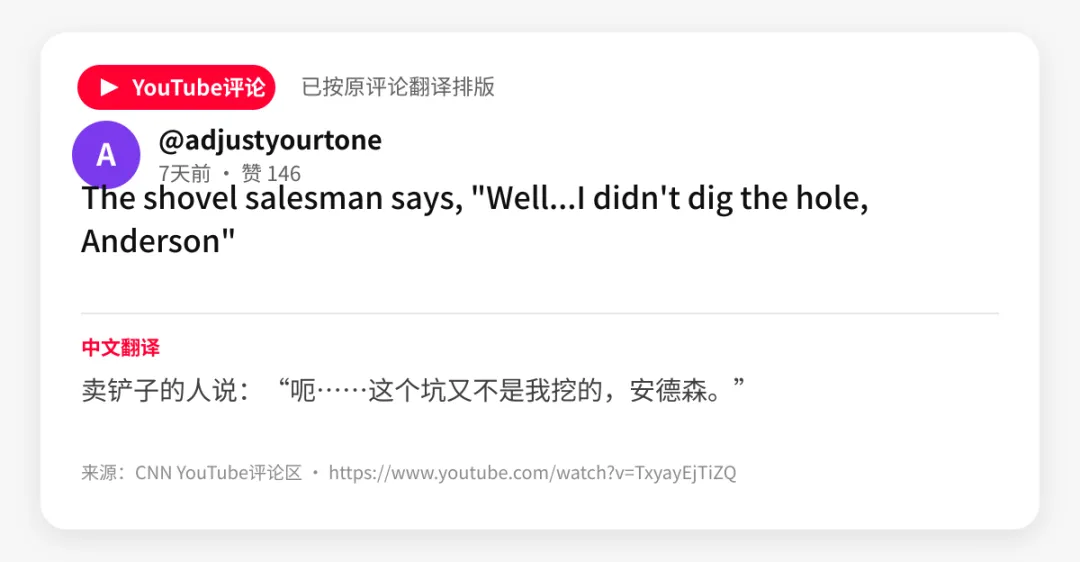
英伟达为AI行业提供最重要的算力基础设施之一。黄仁勋主张加速AI和安全技术开发,评论区自然会追问:出售“铲子”的人,是否低估了矿山本身的危险?
一句“相信工程”消除不了这份怀疑。企业得拿出可验证的权限边界、独立测试和事故披露,还得让安全负责人真的能够叫停发布。
写在最后
黄仁勋对末日风险有自己的数字判断,那部分可以继续争论。
开发团队今天就能动手的,是他反复提到的身份、权限、沙箱、监控、发布门和回滚。
模型还会继续变强,也会接入更多工具。团队无法控制Agent会产生多少方案,却可以控制它用什么身份进入系统、能碰哪些资源、做过什么,以及哪一步必须停下来等人确认。
当Agent只会聊天时,错误答案还能被人关掉。它开始读文件、调接口、改权限以后,安全就不再是附加在产品说明里的承诺。
它会变成每一次授权、每一条日志和每一道发布门。
参考链接:
https://www.youtube.com/watch?v=TxyayEjTiZQ&t=456s
——好文链接——
程序员最大的风险不是被AI替代,而是“认知投降”!Chrome前负责人:代码写完了,人却看不懂系统
AI编程已经卷到头了!马斯克:把目光转向“现实世界工程”,下一场硬仗,是让AI走出IDE
软件开发正在变成“开工厂”!黄仁勋劝开发者别只盯着AI末日论,网友锐评:卖铲子的人让大家继续挖