ARTICLE · 1122215
推荐一个开源AI项目,体制内写材料的可以重点看看
「这篇有 AI 味」
把说不清的手感,变成可测的参数
102 万字真实公文蒸馏
229 篇公文 · 7 类文体 · 2 个文体族 · 零依赖
lieflat-gongwen · 体制内写材料的可以看看
📦 6 Parts + Conclusion
👉 滑动
PART 01
它能干什么
不给你模板,给你数
PART 02
推翻套路
五个认知不成立
PART 03
中位数不是均值
好文章不整齐
PART 04
身份证参数
七个文种指纹
PART 05
它把自己的坑
写进了文档
PART 06
做不到什么
两条边界
PART ///
写在最后
先别讲道理,去数
它不给你模板,它给你数
「AI 味」不是玄学,是我们没找到测量的方式
体制内写材料的人,大概都听过一句话:这篇有 AI 味。
这句话最气人的地方在于,它不给方向。你说哪里假?对方答不上来,但他就是觉得假。而你手里那份稿子,明明每条套话都在,结构也整整齐齐。
今天推荐一个 GitHub 项目,叫 lieflat-gongwen。它把这句说不清的「AI 味」变成了可以量化的参数:作者拿 102 万字真实公文做了全量统计,229 篇正式公文加 77 篇党建千字材料,把公文写作风格「蒸馏」成一套 Agent Skill,覆盖 7 类文体、2 个文体族。
先说清楚一个限定,免得你踩坑:这个项目不是 OSI 意义上的开源,用的是 PolyForm Noncommercial 1.0.0 许可证,只允许非商业使用。个人学习、研究、教育机构、公共研究机构和政府机构都能用,但不能拿它做付费写作或咨询服务,也不能集成进商业产品,商业使用要先联系作者拿单独授权。把它放开头是因为它重要,下面讲的内容,你照着改自己的稿子没问题。
01
PART
先说它能干什么
IT GIVES YOU NUMBERS, NOT TEMPLATES
它的核心主张是一句话:
公文的「像不像」是可测量的。句长、顿号密度、层级配比、力度词配额,都有各文种的特征区间,写完可以用脚本验收。
翻译一下:它不给你模板,它给你数。
市面上的公文 AI 工具都走同一条路:给模板、给套话清单。这个项目反过来走,先去测真实公文长什么样。它的文体覆盖分两族,参数互斥,判错这一步后面全错:
| 党建族 | ||||
| 公文族 |
公文族下再分六类:调研报告、领导讲话、工作意见、经验材料、工作方案、经验总结。它明确不做通知、请示、批复、函这类法定公文,理由是这类文体正文是固定结构,不需要靠量化蒸馏来统计。
02
PART
它推翻了几个我们信了很久的套路
MYTHS THAT DON'T SURVIVE THE DATA
这一节是我最想让你看的。作者拿流行的公文写作认知,对着真实公文一项项测,结果是多数不成立:
| 75-87% 是自然收束 | |
| 60-72% 完全不用百分比 | |
「必须/应当」是稀缺资源,用多了就失效。一半到全部的真实公文,一个百分比都没有——经验总结 8 篇 100% 不用,工作方案 80%、领导讲话 75%、调研报告 51%。作者由此立了一条规矩:不掌握真实数据时不要编造,靠逻辑深度撑起文章,缺数字的地方一律用占位符 【待补:xx】。范文里那些留着的占位符不是没写完,是故意留的。
所以「公文套路」到底是怎么回事?
作者的判断很尖锐:模板化的公文套路,其实是低分公文的特征。 真正稳定的共性在语言构造层,不在套话层:平均句长 53-56 字,是自媒体的 2-3 倍;顿号密度每千字 14-31 个,是自媒体的 4-5 倍。公文靠「A、B、C、D」式的并列枚举撑长句,这才是它最强的语言指纹。
03
PART
它的方法:中位数,不是均值
MEDIAN, NOT MEAN
统计参数时作者用的是中位数加四分位,不是平均值,这个细节很专业。这批语料个体离散度极大,同一文种内部的差异往往大于文种之间。调研报告字数均值 4,406、中位 3,492,照均值写反而会被自检器判偏离 p75。作者的原话是:中位数描述的是「多数作品落在哪里」,均值描述的是一个并不存在的平均作品。
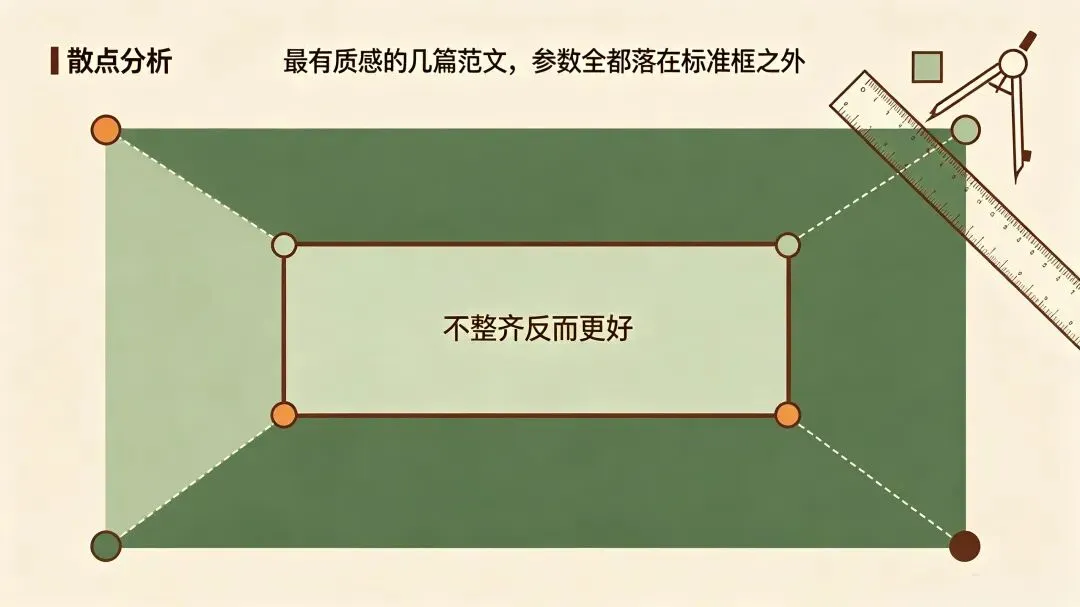
好文章不整齐,整齐的往往是平庸作品
自检器只判硬冲突,其余参数偏离仅作提示
作者拿语料里最有质感的几篇逐篇跑自检来撑这条规则:
四篇没有一篇全项落在框内,而且偏得很远。 所以它明确反对一件事:为了消掉提示,把稿子改成最匀速的样子。它甚至写了一句提醒:「迭代时若发现自己在做『补字数、拉句长、调顿号密度』这类动作,停下来。那是在把稿子往中位数上拽,代价是把场面和短句挤出去。」
04
PART
各文种的「身份证参数」
FINGERPRINTS BY GENRE
这部分最实用。同一个大类下的文种,手感差别可以用参数描述。
| 工作意见 | ||
| 工作方案 | ||
| 调研报告 | ||
| 领导讲话 | ||
| 经验材料 | ||
| 经验总结 | ||
| 党建千字材料 |
看两条对比就明白它有多细。「一是二是」这个词,工作意见用 1 次,调研报告用 9 次,差 9 倍,写调研报告用工作意见的路数,参数上就是文种错位。一级标题字数也差 4 倍:业务类(方案、意见)4-8 字,分析类(调研、讲话)17-18 字。
它的工作流是六步:判文体族和文种、读骨架公式、读 DNA 文档和范文、出骨架等确认、按参数写正文、跑自检修正。第 3 步是这个 skill 和模板类工具的分野——抽象参数说不清「并列成分怎么堆」,看一篇真的比读十条规则有效。第 4 步也值得说:它只给骨架就停下等你确认,不一口气写到底,能省掉大量返工。
05
PART
最打动我的地方:它把自己的坑留在了文档里
IT DOCUMENTED ITS OWN MISTAKES
我用过不少号称「专业」的工具文档,绝大多数只写自己多好用。这个项目的文档里有一整节,是作者承认自己做错了什么。
第一件事:第一批十篇范文,没有一篇是真正读完语料才写的。
| 短经验材料 | 0 篇 |
读法都是同一个套路:切前 700-1,200 字,再用正则抽标题。作者的原话是「这拿到的正好只有骨架」——而场面一般在中段,结尾永远在末尾,这两样一次都没进过视野。结果是六篇重写,四篇保留。
第二件事:统计踩的坑,修了但没抹掉。 用正则提取特征、匹配字面而不解析语义,是整条方法链最弱的一环。有五项统计因词表缺陷被复核推翻,比如「数字命名法」因量词污染从 84% 修正到 60%,「群众归因」从 30% 修正到 9%。由此立的规矩是:任何覆盖率超过 80% 的关键词统计,都先当作被污染,逐条检查命中项再采信。
踩过这两个坑之后,它给自己立了一条引用规矩
凡涉及政策文件名称、发文机关、印发时间,一律只采用新华社、人民日报、中国政府网层级的源;权威源之间冲突时,要占位,不要挑一个看着顺的。有份文件的印发时间,四个权威源写 8 月、地方解读页写 2024 年 8 月,他的处理是全删掉,只留文件名,时间走 【待补:印发时间】。理由说得很到位:「日期一旦写错,会被使用者当依据直接抄走。」
06
PART
它自己承认做不到什么
WHAT IT CANNOT DO
文档最后有一节叫「方法论声明」,写了两条边界,这种坦诚在工具类项目里很少见。
第一,参数解决「像不像」,不解决「对不对」。 内容是否站得住、判断是否准确、政治表述是否得体,参数管不了,涉密、重大决策、对外口径一律须经本单位核稿人终审。
第二,语料因版权已全部移除,不随包分发。 这意味着频率数值第三方无法直接复核,作者把它称为「实质缺陷」,还说移除原文后「是一次真实的能力下降」。样本量也坦白了:工作方案只有 10 篇、经验总结只有 8 篇,仅供参考。它还主动砍掉了两个文体:网评和心得体会,理由是这两类的输出物是「作者的观点」和「个人经历」,AI 都没有,参数再准也写不出来。
一个工具肯说自己做不了什么,反而更让人信它能做什么。
///
LAST
写在最后
DON'T ARGUE, COUNT
回到那句「这篇有 AI 味」。看完最大的收获是:「AI 味」不是玄学判断,它只是我们没找到测量的方式。 我们凭直觉觉得 AI 写的材料假,这个直觉是对的,只是解释错了——假不在套话不够多,而在于句长、并列密度、层级配比这些更底层的东西对不上。
另一件更值钱的事是那句好文章不整齐。这对写材料的人是种解脱:我们总想把稿子改得工整、匀速、每段一样长,但真实语料里最有质感的几篇,跑自检没有一篇全项达标。
1,253 ★ · 183 fork · 7 次提交 · 454 KB
地址:github.com/larashero3-dotcom/lieflat-gongwen。装法很简单,把整个目录放进 Agent 的 skills 目录就行,核心能力零依赖,自检脚本只用 Python 标准库。
!提醒 🕳
它已经 27 天没有更新了,首发即完整,之后没有新提交。打算重度使用的话,得接受它可能不会持续维护。
顺带说一个调研时发现的事:这个作者不只做了公文这一个。同一个账号下还有 lieflat-charts 5,897 ★、writing-dna-skill 2,256 ★、lieflat-less-ai-tone 2,254 ★,加上这个公文。看出来了:他在反复做同一件事,把「风格」变成语料统计。 说不清的东西先别急着讲道理,先去数一数。
最后一句要还给你:这个项目再好,也替不了本单位核稿人那一道关。工具解决「像不像」,材料能不能出台,还得你自己负责。
数据说明:全部参数、占比与统计结论取自仓库内 README.md、参数卡.md、SKILL.md、示例/README.md,核验时间 2026-10-03。仓库元数据(1,253 ★、183 fork、7 次提交、454 KB、PolyForm Noncommercial 1.0.0、创建与推送时间)取自 GitHub API 同日核验;作者其他项目的星数取自 GitHub API 同日核验。本项目语料原文因版权未随仓库分发,上述频率数值无法由第三方独立复核,此点已按作者原文如实写出。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING