ARTICLE · 1122647
监理如何用AI:为什么规范 PDF 丢给 AI 还是答错
监理如何用 AI · 第 12 讲
同样是规范 PDF,有的能直接提取文字,有的需要识别图片。先检查文件怎样被读出来,再判断答案为什么出错。
查《混凝土结构工程施工质量验收规范》GB 50204-2015 的表 8.3.2,你问:“独立基础的轴线位置允许偏差是多少?”
假设 AI 回答“15 mm”。打开规范原页一看,这个数值属于整体基础,独立基础对应的是 10 mm。
错误可能出在文件被读入的过程中。很多文档问答软件会先从 PDF 中提取内容,整理文字顺序和表格关系,再把结果交给 AI,这一步叫解析。如果解析时把项目和数值配错,后续问答就可能沿用错误依据。
本讲用这张真实规范表格说明怎样选解析方式、检查读取质量。下文的错误解析和错答是人为设置的教学示意,不是某款软件的实测记录。
同样是 PDF,里面保存的内容可能不同
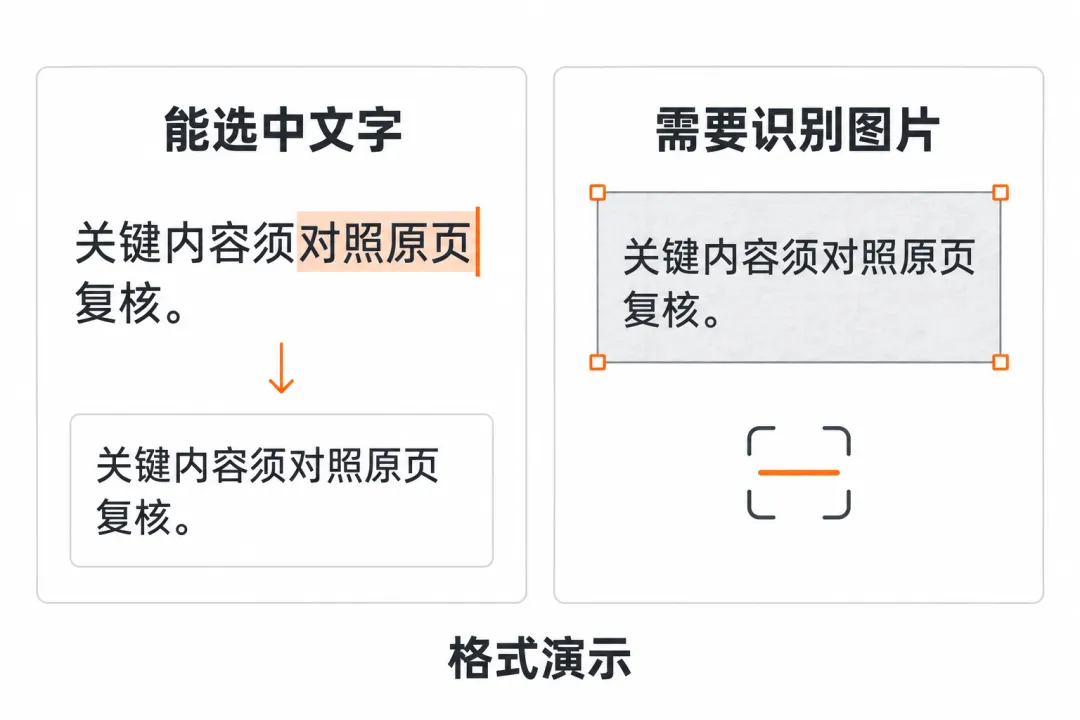
打开 PDF,用鼠标选中一句话,复制后粘贴到记事本里。如果粘贴出来的是文字,说明文件中有可以直接读取的文字内容;如果页面上明明有字,却选不中、复制不出来,可能是扫描图片,需要先识别图片中的文字。
扫描件经过 OCR 后也能复制文字,但识别出来的文字可能有错。复制和搜索只能帮助初筛,不能证明整份文件都读对了。
[PDF 类型与文字提取说明](https://pypdf.readthedocs.io/en/stable/user/extract-text.html)
[扫描件文字层说明](https://ocrmypdf.readthedocs.io/en/latest/introduction.html)
表格是否复杂,还要另看。同一张带合并单元格的表,无论保存为文字版还是扫描版,都需要检查行列关系。
|
选工具,要看它能处理哪一部分
PDF 解析工具很多,读文字、认图片和恢复表格结构,用到的能力有所不同。它们也可以组合在同一个软件里。
• 提取已有文字。pypdf 这类程序能读取 PDF 中已有的文字信息。简单文字版可以先走这条路径;纯图片页没有文字可供它直接提取。
• 识别图片上的字。Tesseract 这类 OCR 工具负责从图像中识别文字。扫描是否清晰会影响识别,处理后还要核对数字和符号。
• 恢复版面和表格关系。MinerU 这类文档解析工具可以处理扫描件和复杂版面,把内容整理成便于后续使用的文字、表格等形式。它适合拿来试处理复杂规范页面,结果仍需对照原页检查。
这些名字用来帮助理解能力差别,不要求你逐个安装。使用文档问答软件时,要看它提供的解析方式是否支持扫描件和表格,能否查看解析结果。
原生文字清楚且提取正常,就不必先转成图片再识别。只有字识别出来、表格关系却乱了,则需要检查结构解析;反复做识字处理未必能解决错配。
用规范原页,看清一处错配怎样影响回答
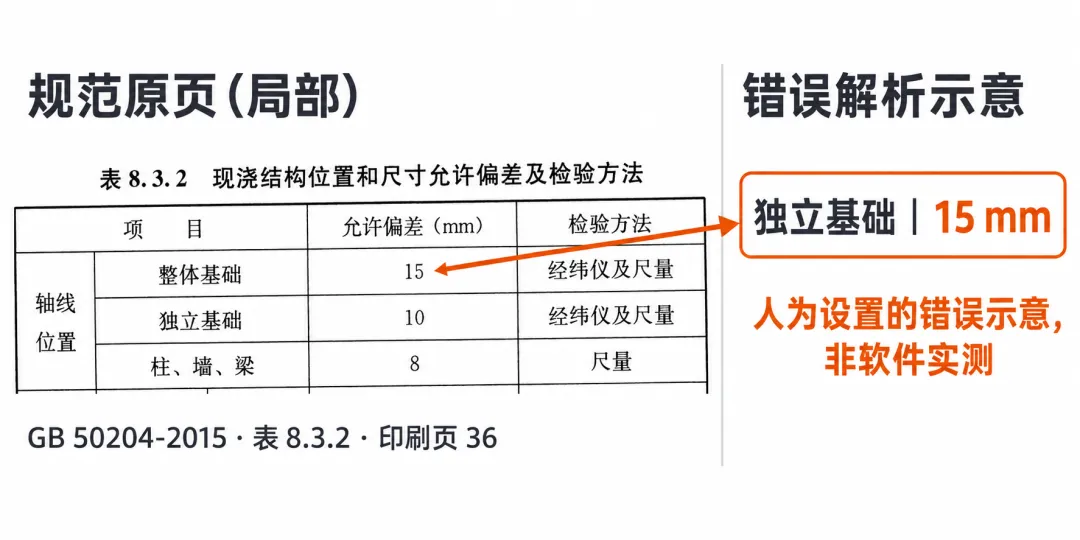
案例取自 GB 50204-2015 表 8.3.2“现浇结构位置和尺寸允许偏差及检验方法”。上海市住建委公开的原文 PDF中,这张表在印刷页码第 36 页,即该文件的第 46 页。
下面只摘出“轴线位置”这一项的三行,保留数值和检验方法:
原表的“轴线位置”是合并单元格,管着这三行。解析时,既要读出数值,也要保留它所属的检查项目和对象。
假设解析结果出现下面这一行,后续问答又沿用了它:
错误解析示意:轴线位置|独立基础|15 mm|经纬仪及尺量。 提问:根据表 8.3.2,现浇结构中独立基础的轴线位置允许偏差是多少? 错误回答示意:独立基础的轴线位置允许偏差为 15 mm。 |
“15”没有被识别成别的数字,却被配给了相邻的对象。读字正确,仍可能把表读错。仅要求 AI“回答仔细一点”,并没有修复这份错误的输入。
|
发现这种错配后,先看文件类型。文字版可换用能识别表格结构的方式;扫描版需要同时处理文字识别和表格关系。原图已经模糊或缺边的,先换清晰、完整的文件。
重新解析后,先把这三行与原页逐行核对,再用同一个问题检查回答。人工核对得到的答案应是:
按 GB 50204-2015 表 8.3.2,现浇结构中独立基础的轴线位置允许偏差为 10 mm,检验方法为经纬仪及尺量。 |
这份答案是依据原表写出的核对示例。表中的限值对应特定检查项目,不能据此直接判断某个现场构件验收合格。
公式、条件和图示也可能读错
• 公式上下标:下标混入正文,平方、立方的上标丢失,改变符号或公式的含义。
• 符号与单位:“≤”被读成“<”,小数点或正负号遗漏,mm²、mm³ 的幂次丢失。
• 跨页内容:续表缺少表头,条文后半段或公式说明没有接上。
• 限定条件:“不应”“除……外”等文字漏读,表下注与对应条目脱离。
• 图示标注:构造图中的尺寸或引线说明被漏掉,或者无法对应到具体位置。
解析后的文件不能默认无误。涉及判断或计算的关键条文、限值和公式,必须由人工对照规范原页复核;有疑问的内容,核清前不作为依据。
正式使用前,先检查两页
拿到下一份规范,先确认名称和版本,再选一页普通正文、一页复杂表格试解析。有跨页表格的,要把续页一起检查。
正文页对照条文编号和文字,尤其留意“不应”等限定词,以及小数点、正负号和大小于号。表格页逐行核对项目与数值是否对应,再看单位和适用条件有没有保留。正文引用了表下注的,还要确认注释与表格能对应起来。
发现问题后,按前面的类型和能力选择调整解析方式,重新检查同一页。抽查通过,只说明检查过的内容一致,不能推及整份文件。
如果软件没有解析预览,可以先让 AI 摘录内容,辅助检查:
请根据 GB 50204-2015 表 8.3.2,逐行摘出“轴线位置”项下各对象的允许偏差和检验方法,保留单位。先不要解释;读不到或无法确定对应关系的地方,写“无法确认”,不要补全。 |
这次摘录也经过 AI,只能用于发现可疑之处,不能单凭它判定解析环节一定正确或错误。
解析内容与原页一致后,如果答案仍有问题,再检查引用是否包含所需条文,以及回答是否改掉适用条件。
我们在《AI最后一公里:一半是知识治理,一半是认知启蒙》中,把知识治理看作 AI 落地最后一公里的一半。解析后纠正错字、恢复表格和公式关系,并保留来源与版本,就是其中基础的数据治理工作。把资料整理准确,后续检索与问答才有可靠的依据。
下一讲,我们在 AI 监理系统里用 MinerU 处理扫描版 PDF,走一遍具体操作。
有问题、有建议、想报 bug(程序缺陷)、想合作,联系我们:
微信号:kjcsjl 邮箱:54538467@qq.com
或者加入群聊,获得安装包