ARTICLE · 1122645
10 人团队 10 种 AI 代码风格,如何破解?Claude Code、Cursor、Copilot 怎么对齐?
一个 10 人的后端团队,同一个需求,每个人各自让 AI 写一版。收上来的代码大概是这样:有的接口返回裸对象,有的包了 Result<T>;有的 @Transactional 打在 controller,有的打在 service;错误码有字符串、有枚举、有直接抛 RuntimeException 带一句中文;测试有的用 AssertJ,有的用 assertEquals,有的干脆没写;Redis key 有的带业务前缀,有的就是一个裸 id。
每个人的代码单看都跑得通。问题不在写得慢,在方差大。
于是 code review 变成风格辩论会。一半时间在争"这个返回体要不要包一层",争完这次,下次换个需求继续争——因为约定从来没离开过每个人的对话框,它就没有一个所有人都指向的落点。
规则文件(CLAUDE.md / AGENTS.md / .cursor/rules / .github/copilot-instructions.md)的价值,不是"让 AI 更聪明",而是把团队约定从每个人的对话框里搬进仓库,让它像代码一样能被 review、能被 diff、能被回滚。
但这一步有个前提必须先讲清楚,否则整个规范体系会从一开始就建错地方。
先划一条硬边界:规则文件是上下文,不是配置
Anthropic 官方文档里有一句很直白的话:Claude 把 CLAUDE.md 视为上下文而不是强制配置;如果你要阻止某个动作、无论 Claude 决定什么都要阻止,请改用 PreToolUse hook。
这句话决定了团队规范的分层方式。判据只有一条:这条规则能不能被确定性执行。
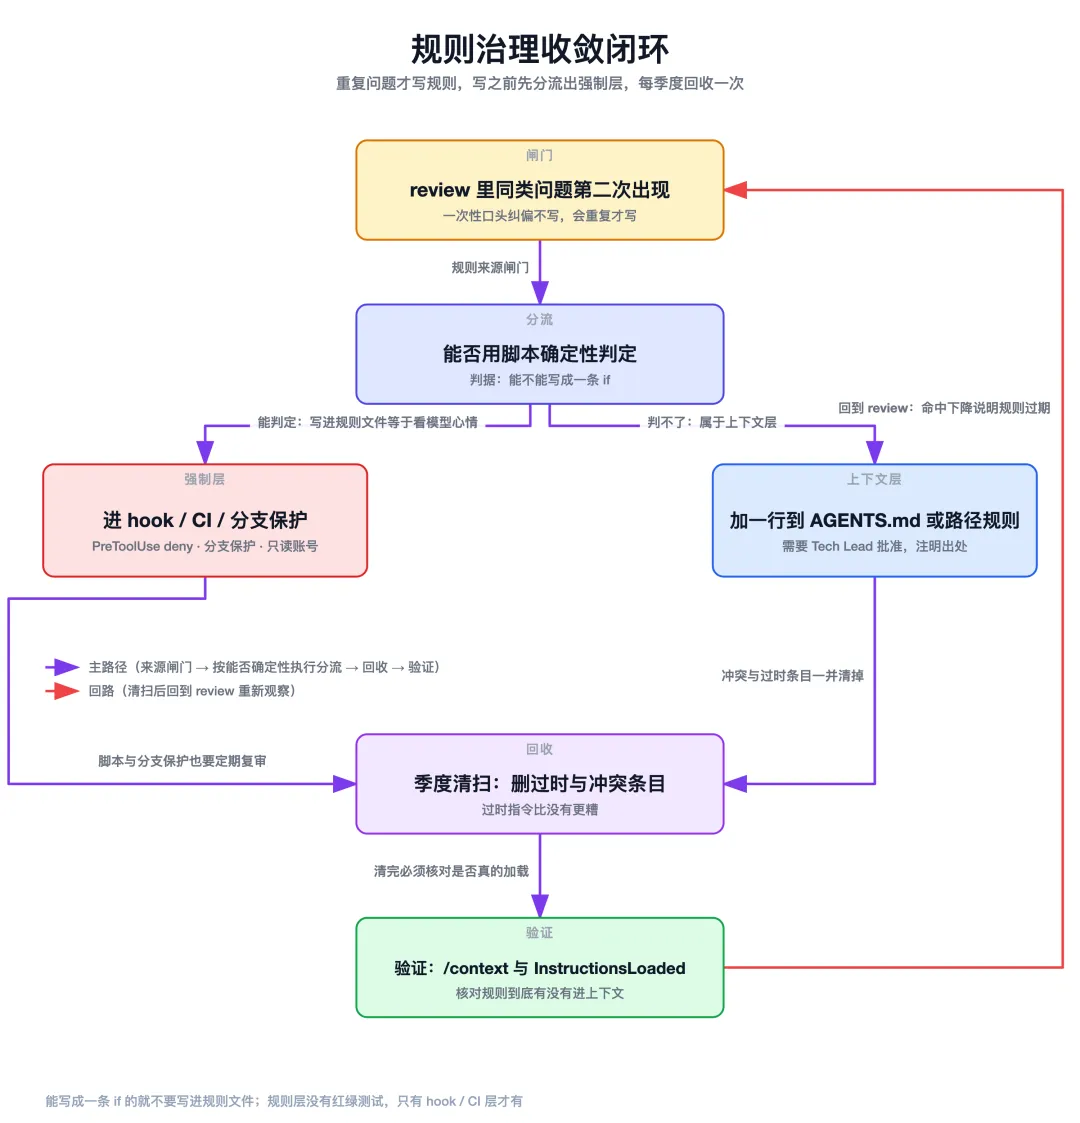
能写成一个脚本判断真假的,就不要写进规则文件——写进规则文件意味着"看模型心情"。比如"禁止 force push"、"不要改 config/ 下的文件"、"不要在循环的每一轮里查库":前两条是纯字符串/路径匹配,第三条能被 ArchUnit 或 SpotBugs 规则判定,它们都不该指望模型自觉遵守。
反过来,"新增接口要说明幂等策略"、"事务边界放在 application 层"这类没法用一条 if 判定的,才属于规则文件。
落到 Claude Code 上,强制层是 PreToolUse hook,它在工具调用发生之前执行,能真正拦住动作。这里有两个坑,踩了会让你以为 hook 生效了其实没有:
第一个坑是退出码。0 表示成功;2 是阻塞错误,stderr 会回喂给 Claude;而 1 和其他非 0 值是非阻塞的——脚本报错了,动作照常执行。想拦住一件事必须 exit 2。另外 PostToolUse 是在工具已经执行完之后才触发的,它拦不住调用本身,只能回喂一段文本,别把它当护栏用。
第二个坑是 updatedInput。 它是替换整个 input 对象,不是打补丁。你只想把 mvn test 改成 mvn -o test,就得把 description、timeout 这些没改动的字段原样回传,否则它们会直接丢掉。
一个能用的拦截脚本长这样(放在 .claude/hooks/deny-dangerous-bash.sh,入库):
#!/usr/bin/env bashset -uo pipefailinput=$(cat)cmd=$(printf'%s'"$input" | jq -r '.tool_input.command // ""')block() {echo"被团队规则拦截:$1。如需执行,请在 PR 里说明理由并由 Tech Lead 处理。" >&2exit 2}case"$cmd"in *"git push"*"--force"*|*"git push -f"*) block "禁止 force push" ;; *"flyway:migrate"*|*"liquibase:update"*) block "禁止本地直连数据库跑迁移,走 CI 流水线" ;; *"rm -rf"*"/"|*"DROP TABLE"*|*"TRUNCATE"*) block "高危删除操作" ;;esacexit 0配套的 .claude/settings.json:
{"hooks": {"PreToolUse": [ {"matcher": "Bash","hooks": [ { "type": "command", "command": "bash .claude/hooks/deny-dangerous-bash.sh", "timeout": 5 } ] } ] }}需要改写参数而不是拒绝时,返回 permissionDecision 与 updatedInput(未改动的字段必须原样带上):
{"hookSpecificOutput": {"hookEventName": "PreToolUse","permissionDecision": "allow","updatedInput": {"command": "./mvnw -q test -pl order-app -am","description": "运行变更模块的单元测试","timeout": 600000 } }}这套机制截至 2026-09 有效,但工具行为会随版本变,配置完请用 /context 确认规则确实进了上下文,并手动触发一次拦截验证退出码。
还有一个组织层面的约束要提前想明白:项目级 settings.json 虽然入库了,成员仍然可以在本地改掉它,本地 hook 也能被 git commit --no-verify 绕过。 所以"绝对不能发生"的事,最终落点必须是服务端——CI 流水线、分支保护规则、只读数据库账号、由 IT 分发的托管策略。本地 hook 的定位是"把错误挡在离开发者最近的地方",不是最后一道防线。
四层作用域:团队规范只占其中一层
Claude Code 的 CLAUDE.md 有四个作用域,从广到窄:
/Library/Application Support/ClaudeCode/CLAUDE.md/etc/claude-code/CLAUDE.md(Linux / WSL) | ||||
~/.claude/CLAUDE.md | ||||
./CLAUDE.md./.claude/CLAUDE.md | 是 | |||
./CLAUDE.local.md |
加载时从当前工作目录向上遍历目录树,逐层找到的文件全部拼接,不是互相覆盖。这条很重要:它意味着你在项目级写"缩进 2 空格"、成员在用户级写"缩进 4 空格",不会有一方赢,两条指令同时躺在上下文里——这正是"规则冲突时模型会任意选一条"的成因之一。
对应的分工:团队规范只放项目级;个人偏好不要污染团队文件。 成员自己的习惯写在 ~/.claude/my-project-instructions.md,然后在项目 CLAUDE.md 里用 @~/.claude/my-project-instructions.md 导入(首次导入会弹批准对话框,拒绝后该导入永久禁用且不再提示,新成员 onboarding 时要提醒点批准)。
跨工具文件矩阵:一份公共层 + 每个工具一个薄适配层
团队里通常三种工具同时在用。最省事也最常见的做法是维护三份内容重复的规范——三个月后它们必然漂移。
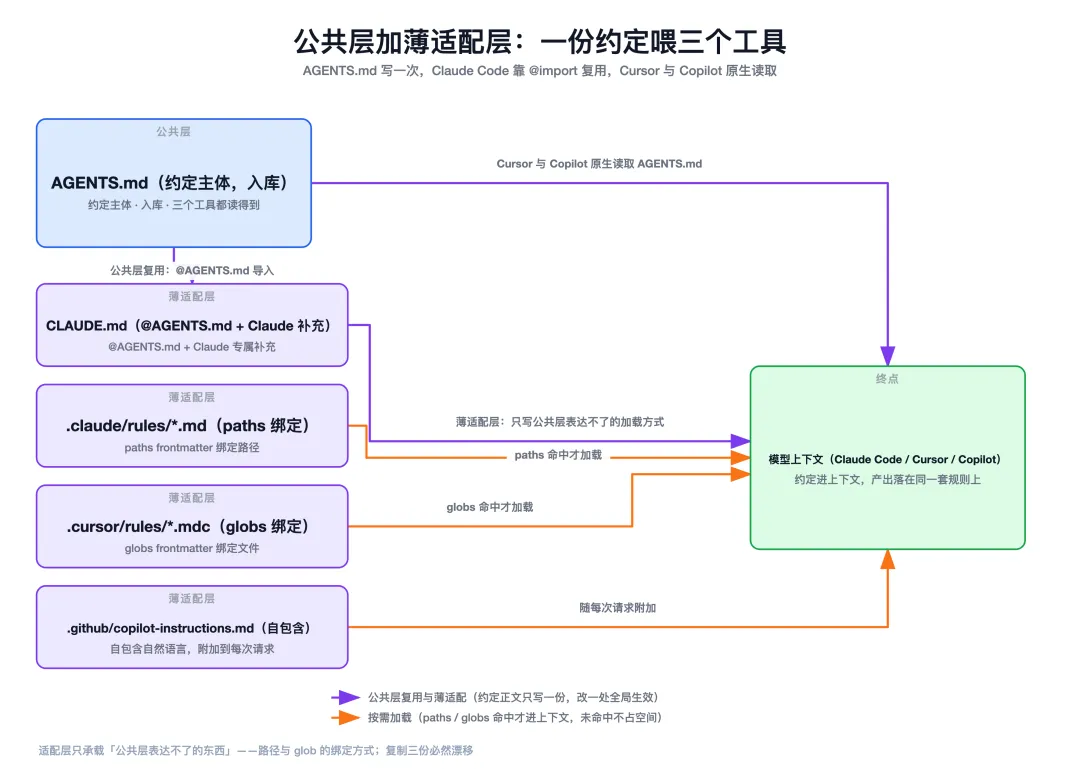
可行的结构是:一个 AGENTS.md 承载约定主体,各工具只保留自己独有的加载方式。
AGENTS.md—— 公共层,约定主体。它是给编码 agent 看的标准 Markdown,没有必填字段、没有特殊语法。2025 年 8 月发布,现由 Linux 基金会下属的 Agentic AI Foundation 托管,agents.md 官网称已被 6 万+ 开源项目采用。CLAUDE.md—— Claude Code 默认不读 AGENTS.md,官方推荐的做法就是两行:先@AGENTS.md导入,再写 Claude 专属补充。Windows 上别用软链(需要管理员权限或开发者模式),走 import。.claude/rules/*.md—— 路径范围规则,带pathsYAML frontmatter,只在 Claude 处理匹配文件时加载;不带paths的启动时加载。.cursor/rules/*.mdc—— Cursor 侧,frontmatter 三字段description/globs/alwaysApply。Cursor 官方明确:项目根目录的.cursorrules是旧版,已标注即将弃用,不要再新建。迁移步骤:命令面板 New Cursor Rule → 复制内容 → 规则类型设为"始终应用" → 删除.cursorrules。两者同时存在会被同时加载,冲突时.mdc优先(这一条来自社区观察,不是官方文档结论)。.github/copilot-instructions.md—— Copilot 侧,自然语言 Markdown,附加到所有 chat 请求。它需要自包含:GitHub 官方把"Always conform to the coding styles defined in styleguide.md in repo my-org/my-repo"明确列为反例。也就是说,把规范写在doc/里然后让 AI 去读,这条路官方已经替你否掉了。
这个结构成立的关键依据是 Cursor 官方文档的一句原话:Cursor 读取 CLAUDE.md 的方式与读取 AGENTS.md 相同;而 Copilot 的 agent 指令也支持 AGENTS.md(可用仓库根目录的单个 CLAUDE.md 或 GEMINI.md 替代)。所以真正的适配层只需要承载"公共层表达不了的东西"——路径与 glob 的绑定方式。
一份后端团队规则模板(Java 17 + Spring Boot 3,可直接抄)
以下按文件拆分,技术栈是 Java 17 + Spring Boot 3 + Maven + JUnit 5 + MySQL + Redis。每段的取舍我在段后说明。
AGENTS.md:约定主体
# order-service## 构建与验证命令(会被 agent 直接执行,写错会浪费整轮)- 编译:./mvnw -q -DskipTests compile- 单测(改完必跑):./mvnw -q test -pl order-app -am- 全量(CI 同款,耗时长,只在提 PR 前跑):./mvnw -q verify- 静态检查:./mvnw -q checkstyle:check spotbugs:check -pl order-app- 本地起依赖:docker compose up -d mysql redis<!-- 维护者:命令每季度核对一次,换 JDK 或依赖大版本时立刻核对。 -->## 架构(三句话)- 分层:controller → application → domain → infrastructure,依赖只能自上而下,反向依赖一律打回。- 耦合:跨模块只通过 application 层的 Service 接口与领域事件,不直接访问对方的 repository。- 存储:MySQL 写,Redis 只做缓存与分布式锁,任何缓存都不作为唯一数据源。## 命名与风格(按可 grep 验证的粒度写)- 类:XxxController / XxxService(接口)+ XxxServiceImpl / XxxRepository / XxxMapper。- DTO:XxxRequest / XxxResponse,只放数据传输,不写业务逻辑。- 方法:findXxx 允许返回 null,getXxx 不允许;不存在时抛业务异常或返回 Optional。- 布尔字段不用 is 前缀(Jackson 序列化会多一层坑)。- 缩进 2 空格不用 Tab,行宽 120,import 不写通配符。- 日志用占位符:log.info("order.created, orderId={}, userId={}", orderId, userId),禁止字符串拼接。## API 约定- 所有出站响应统一 Result<T>:{code, message, data, traceId},禁止返回裸对象或 Map。- 错误码格式 {业务域}{三位数字},如 ORDER404;新增错误码必须同步改 docs/error-codes.md。- 写入接口必须幂等:请求方传 Idempotency-Key,服务端存 Redis,TTL 24h。- 参数校验放在 controller 层(@Valid + @Validated);domain 层只校验业务规则,不重复校验格式。- 分页统一 PageQuery{pageNo, pageSize} / PageResult<T>,pageSize 上限 100。- 新增路由默认挂 AuthInterceptor,进白名单必须在 PR 里写明理由。## 数据层- 事务边界在 application 层,用 @Transactional;controller 与 domain 层不写事务注解。- @Transactional 一律显式 rollbackFor = Exception.class,不要依赖默认的 RuntimeException。- 禁止在循环里查库或调 RPC,先批量查一次再在内存里拼装。- 新增 SQL 必须命中索引,PR 描述里贴 EXPLAIN 结果,type 至少 range。- 慢查红线:P99 > 100ms 记为待优化,> 1s 必须当次修复。- Redis key:{业务域}:{业务对象}:{id},如 order:detail:123456,必须设置过期时间,禁止无 TTL 的 key。- 禁止把 Redis 当消息队列,异步一律走 Kafka。## 测试(JUnit 5 + Mockito + AssertJ)- 命名:被测方法_场景_预期,如 createOrder_stockInsufficient_throwsOrderException。- 粒度:domain 层纯单测不启 Spring 上下文;涉及 DB 的用 @SpringBootTest + Testcontainers,放 src/test/java/**/integration/。- 必覆盖边界:参数缺失、幂等重复提交、并发扣减、下游超时、金额精度。- 断言统一 assertThat,不用 assertEquals。- 改完代码必须自己跑 ./mvnw -q test -pl order-app -am 并在回复里贴结果。## 安全与配置- 密钥、AK/SK、数据库密码走环境变量或配置中心,禁止写进 application.yml 或任何入库文件。- config/ 目录只允许 SRE 修改,agent 不得改动(同时由 PreToolUse hook 强制)。- 外部输入(HTTP 参数、MQ 消息体、第三方回调)必须在入口校验长度、类型与枚举范围。- 日志脱敏:手机号、身份证、银行卡号、token 打码后再落日志。- SQL 一律参数绑定 #{},禁止 ${} 拼接。## Git 与 PR- 分支:main(生产)/ release/x.y / feature/JIRA-123-short-desc,feature 从 main 切。- commit message:<type>(<scope>): <subject>,type 取 feat/fix/refactor/test/docs/chore。- PR 描述四段:改了什么 / 为什么改 / 怎么验证 / 影响面(接口、SQL、配置)。- 单 PR 改动不超过 400 行,超了拆开。三处写法值得单独点出来(模板里的阈值、错误码格式、分页上限都是示例值,照抄前按你们的 SLA 和规范改):
命令必须准确。 官方文档明确要求这一点,因为 agent 会真的执行它们。./mvnw 还是 mvn、有没有 -pl、跑一次多久——写错一条,浪费的是整轮会话。写成 ./mvnw -q test -pl order-app -am(只跑变更模块及其依赖)而不是裸 mvn test,是为了让 agent 愿意多跑几次。
"可 grep 验证的粒度"。 「正确格式化代码」这种指令等于没写,「缩进 2 空格、行宽 120」才能被执行。同理,「禁止在循环里查库」能配一条 ArchUnit 规则落地,「代码要优雅」不能。
HTML 块注释。<!-- 维护者:... --> 会在注入上下文前被剥离,代码块内的注释则保留。这给了你一个"写给人看、不花 token"的位置:维护责任人、上次修订原因、为什么加了这条。注意别把团队的真实红线写进块注释——它不会进上下文,模型看不见。
.claude/rules/:路径范围规则
不带 paths 的规则在启动时加载,会一直占着上下文;带 paths 的只在 Claude 处理匹配文件时才加载。把"只跟某层有关"的规则挪到这里,是控制 AGENTS.md 长度的主要手段。
.claude/rules/api-layer.md:
---paths: - "order-app/src/main/java/**/controller/**/*.java" - "order-app/src/main/java/**/application/**/*.java"---# API 层规则(只在改动 controller / application 时加载)- 出站必须 Result<T>,入站必须有 @Valid。- 新增路由必须挂 AuthInterceptor。- controller 里不写业务逻辑,超过 3 行就下沉到 application。.claude/rules/db-migration.md:
---paths: - "order-app/src/main/resources/db/migration/**"---# 数据库迁移(Flyway 脚本)- 文件名 V{version}__{描述}.sql,version 用时间戳 yyyyMMddHHmm。- 只允许加列、加索引;删列与改类型必须分两个发布周期做。- 大表 DDL 走 gh-ost,禁止直接 ALTER。frontmatter 必须在文件最顶部。 想标注文件名就写在代码块外面,别写成 <!-- .claude/rules/api-layer.md --> 塞在 --- 前面——那样 YAML 解析不出来,paths 会失效,规则退化成"启动时全量加载",正好把你想省下的上下文又吃回去。
.cursor/rules/:Cursor 侧
.cursor/rules/api-layer.mdc:
---description: 订单服务 API 层约定(controller / application)globs: - "order-app/src/main/java/**/controller/**/*.java" - "order-app/src/main/java/**/application/**/*.java"alwaysApply: false---- 出站必须 Result<T>,入站必须有 @Valid。- 新增路由必须挂 AuthInterceptor。- controller 里不写业务逻辑,超过 3 行就下沉到 application。内容与 .claude/rules/api-layer.md 保持一致——这是"一份约定两份载体"目前绕不开的重复,我在两边都加了同一行注释提醒同步。如果团队用 Cursor 的 Team/Enterprise 方案,可以在仪表盘建团队规则(分强制与可选,支持 glob),但要注意:团队规则采用自由文本,不支持 .mdc 的目录结构,也不会包含在配置文件导出中,所以内容要写成"两个地方都能用"的形式。
这几条必须改成 hook / CI 强制
规则文件里可以写"禁止",但它拦不住任何事。下面这几条要搬到强制层:
git push --force | |
config/、.github/workflows/ | Edit|Write) |
判据很简单:这件事一旦发生,代价是不是不可逆。 不可逆的,必须有一层落在服务端。
治理:让这个文件活过三个月
规则文件最常见的死法是没人维护。三个月后它变成一份谁都不确定还作不作数的文档,而过时的指令比没有更糟——模型不知道哪条过期了,只会照单全收。
三个动作:
谁提。 官方给的触发条件是"Claude 第二次犯同样错误时 = 缺了一条规则,加一行"。团队里可以照搬:code review 中同一类问题第二次出现,就当场加一行,并在 PR 里注明出处。一次性的口头纠偏不写进文件,只有会重复出现的才写——这是控制文件膨胀最有效的一闸。
怎么审。 规则文件的改动需要 Tech Lead 批准,每条新增规则要能回答"上次谁因为没这条返工了"。答不上来的,多半是理想化规则。
多久清一次。 每季度扫一次,删过时内容、解决冲突条目。
怎么验证规则真的生效
写完不等于加载了,加载了不等于命中了。三个可操作的观察点(截至 2026-09,具体字段名随版本变化,先跑一次看结构):
Claude Code —— 在会话里执行 /context,看 Memory files 列表里有没有你的 CLAUDE.md 与 .claude/rules/*.md。这是最快的自查手段。
审计加载台账 —— 挂一个 InstructionsLoaded hook,它会在 CLAUDE.md 或规则文件加载时触发。先只做记录,不要急着解析字段:
#!/usr/bin/env bash# .claude/hooks/log-instructions.sh# InstructionsLoaded:把事件原始 payload 追加成 NDJSON,季度清扫时统计各规则的命中率# 先跑一次看结构:tail -1 .claude/instructions.ndjson | jq .mkdir -p .claudecat >> .claude/instructions.ndjson{"hooks": {"InstructionsLoaded": [ { "hooks": [{ "type": "command", "command": "bash .claude/hooks/log-instructions.sh" }] } ] }}Copilot —— 发起一次 chat,看 References 列表里有没有 .github/copilot-instructions.md。没有就说明文件路径或格式不对。
要诚实一点:规则层没有通过/不通过测试。 你只能观察"AI 产出的代码命中约定的比例",而无法断言某条规则一定被遵守。只有 hook / CI 层才存在确定性的红绿。
失败边界:这套东西什么时候会失效
规则不是法律。 社区里有个说法叫 "compliance theater"——规则被逐条承认,然后在长会话里被系统性地违反。这是社区讨论中的观察,不是官方结论,也不构成对任何具体模型的量化判断,但它指向的机制是真的:CLAUDE.md 是上下文,随着会话变长会被稀释。所以绝对不能发生的事必须进 hook。 否定式指令比肯定式更容易被突破。 GitHub issue #7777 里讨论过这个现象(同样是社区观察):「NEVER run git commands unless...」比「ONLY run git commands when explicitly requested」更容易被绕开。写规则时优先用肯定式描述期望动作,别依赖"不要"——尤其别把重要的"不要"只放在规则文件里。 超过 200 行遵守度会下降。 016 那篇从单兵视角讲过这条,团队视角下要补一句:团队文件更容易超标,因为每个人都想加一条自己踩过的坑,而删别人的规则比加自己的难得多。 两条规则冲突时模型会任意选一条。 项目级与用户级会拼接而不是覆盖,这是冲突最常见的来源。 @import不省上下文。 被导入的文件在启动时照样全部加载并计入上下文窗口。用它组织文件可以,别指望它省空间。顺带修正一个流行说法:Claude Code 对 CLAUDE.md 有 prompt caching,会话首个请求付全价,之后约 5 分钟内的请求命中缓存按更低价计——所以主要代价是上下文空间与信噪比,不是每轮计费。团队自己都不遵守的规则不要写。 官方把 aspirational rules 明确列进"不该写"。自检方法:这条能不能在 review 里被具体指出来?指不出来,就是理想化。 子目录规则与路径范围规则在 /compact后不会重新注入。 这条来自社区观察,与官方"中途编辑 CLAUDE.md 需要下次/compact或下个会话才生效"可以交叉印证。结论:不可协商的根规则放在项目根,别埋在子目录。**Copilot 对三类指令明确"不太可能生效"**:要求引用外部资源、要求特定回答风格、要求固定详细程度。你的规范里如果有这三类,删掉比留着好。
什么时候不该做这件事
团队规模小于 3–4 人、或者大家根本不在同一个仓库里工作时,先别建这套体系——维护成本会超过收益,两个人口头对齐更快。
更现实的前置条件是:团队得先有一套口头共识。 规则文件是把已有约定固化下来,不是替你发明约定。如果 review 时大家自己都说不清"到底该不该包 Result
最小起步动作:先把"构建与验证命令"、"分层依赖方向"、"统一响应体"这三条写进 AGENTS.md,让团队用一周,然后再按 review 里重复出现的问题往下加。
🔧 文中用到的完整模板
以上我讲了每条规则为什么这么写,完整版已按真实目录结构整理好:AGENTS.md 主体、.claude/rules/ 的两份路径规则、.cursor/rules/ 的 .mdc、四条 PreToolUse hook 脚本与配套 settings.json。改掉项目名和模块名就能提交进仓库。
文 章 精 选
第一个被AI做空的国家,出现了 把大脑外包给AI之后,人类正在集体变笨。 “我们不介意你抄代码,但请别删名字!”谷歌被扒“抄袭”开源项目:228个文件一模一样,3个作者名却被抹去 AI 正在制造 App 过剩时代 老板患上了AI狂热症,连决策都让AI来做,感觉公司快完蛋了,员工该怎么办?

更多精彩等待你的发现 
点分享 
点点赞 
点在看