ARTICLE · 1133207
把任意文档变成可问答的知识库:RAG + 自推理Agent + 自动维护Wiki,三合一!腾讯开源知识库神器WeKnora !
你们团队的知识管理是怎么搞的?
大部分人就是把文档往飞书、Notion、语雀里一丢,然后祈祷有人记得它放在哪了。等到真正要用的时候,要么搜不到,要么搜到三份不同版本的,最后还是在群里@人问"那个XX文档在哪"。
去年市面上倒是出了不少AI知识库产品,体验也还凑合。但有个问题——你的数据得传到别人服务器上去。对于很多团队来说,这一步就是过不去。
最近刷到一个项目,腾讯开源的 WeKnora,我觉得值得聊聊。
不只是"文档扔进去,问题吐出来"
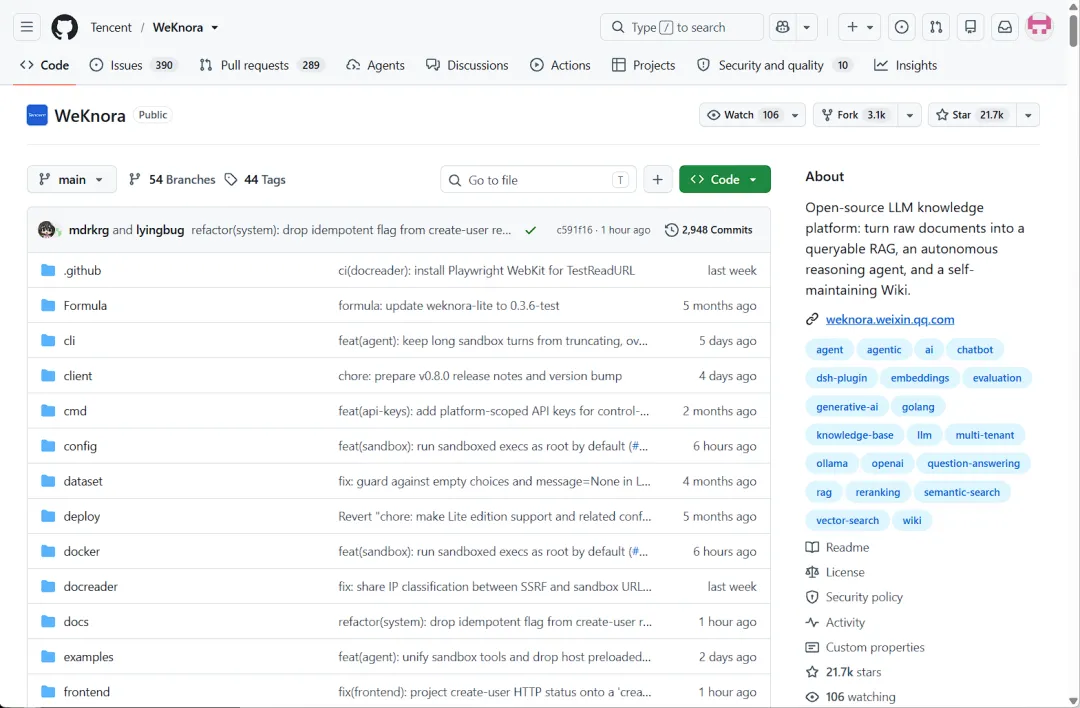
先说背景。WeKnora 是微信对话开放平台团队做的,MIT 协议,GitHub 上已经 21000+ 星了。腾讯出品的开源项目不少,但能涨到这个速度的,说实话不多见。
它跟一般的 RAG 知识库最大的区别在哪?三个字:不止步。
市面上大部分知识库做的事情是——你丢文档进去,它做向量化,你问问题它从文档里找相关片段,拼成答案给你。本质上就是个"高级搜索"。
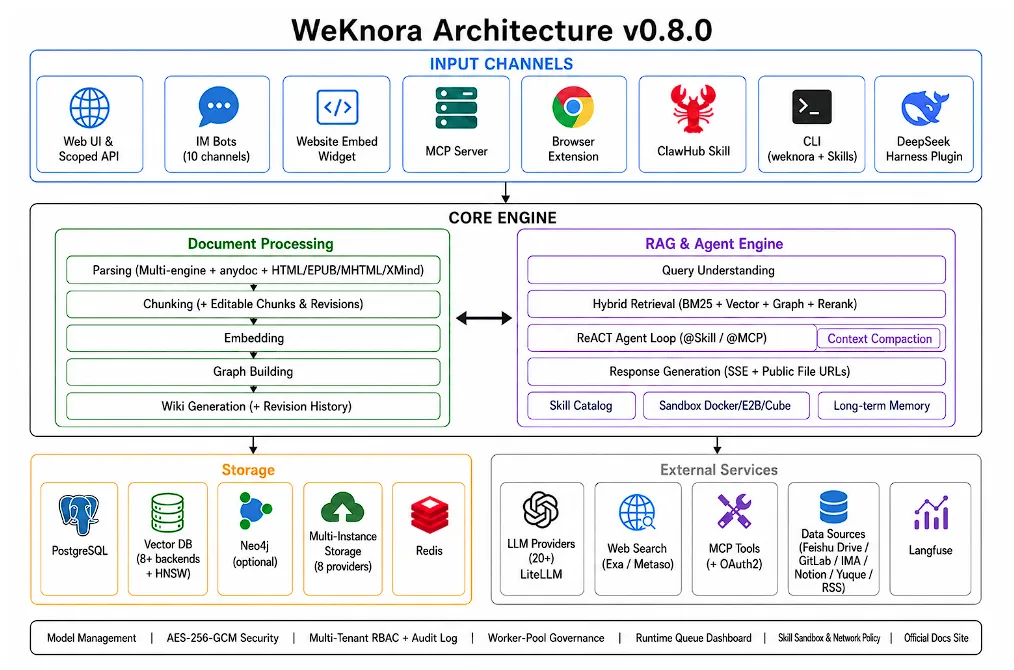
WeKnora 做了三层:
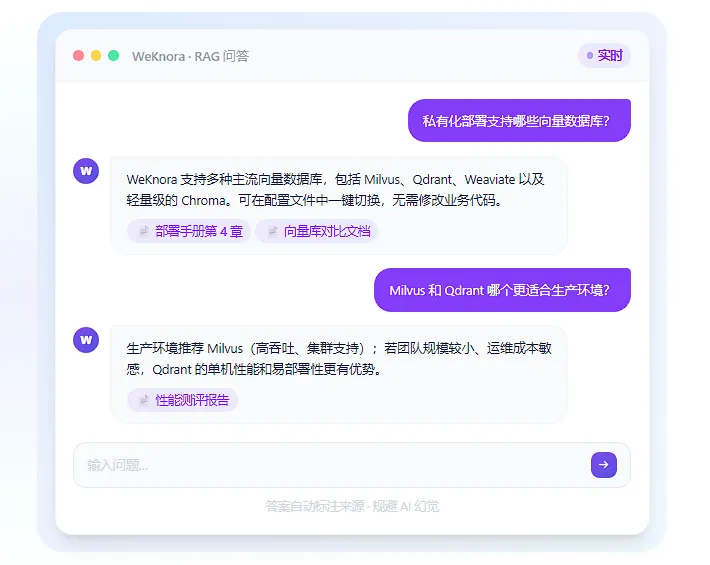
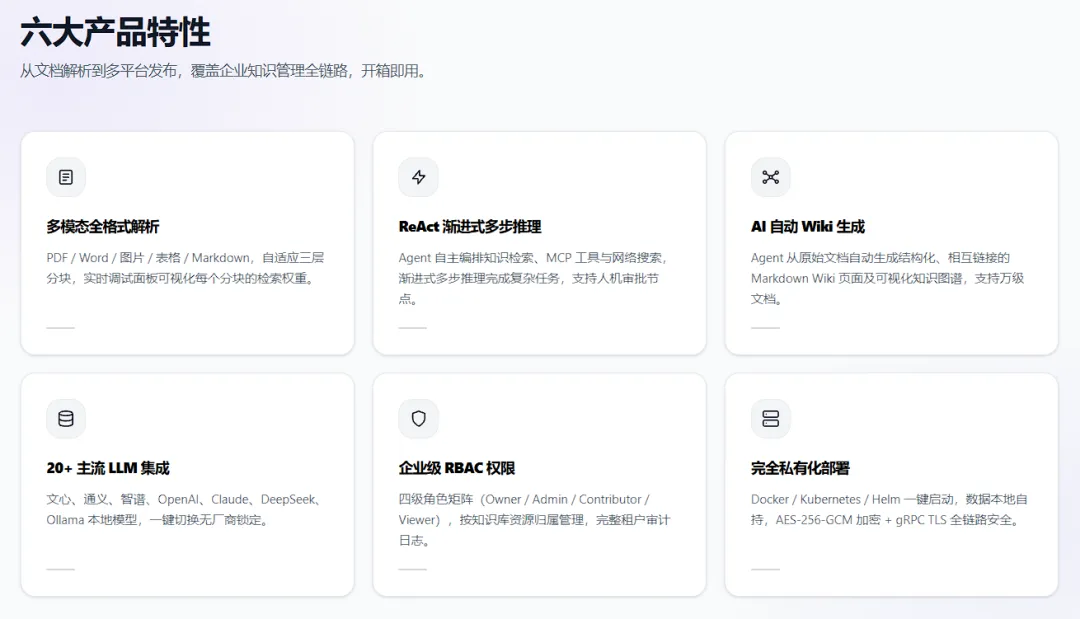
第一层:RAG 快速问答。 这就是基础操作。文档丢进去,问啥答啥,答案自动标注来源。它用的是语义+BM25混合检索,还加了知识图谱增强,不是简单的向量匹配。说白了,专有名词、报错代码这种向量检索容易漏的东西,它也能兜住。
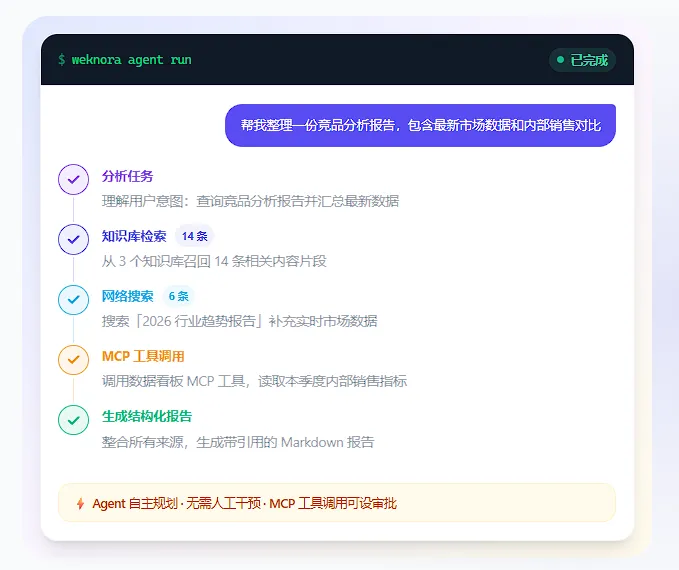
第二层:ReAct Agent。 这一层就有点意思了。你问一个复杂问题,它不只是去知识库里搜——它会自己规划:先搜知识库、再联网搜最新数据、再调 MCP 工具读你的数据看板,最后整合成一份报告。整个过程你能看到它每一步在想什么、调了什么工具。而且支持人工审批节点,不是完全放飞自我。
第三层:AI 自动 Wiki。 这个是我最感兴趣的。它有个 Wiki 模式,Agent 会主动阅读你的原始文档,然后自动生成结构化的、相互链接的 Markdown Wiki 页面,还能可视化成知识图谱。支持万级文档体量,而且会持续自动更新。
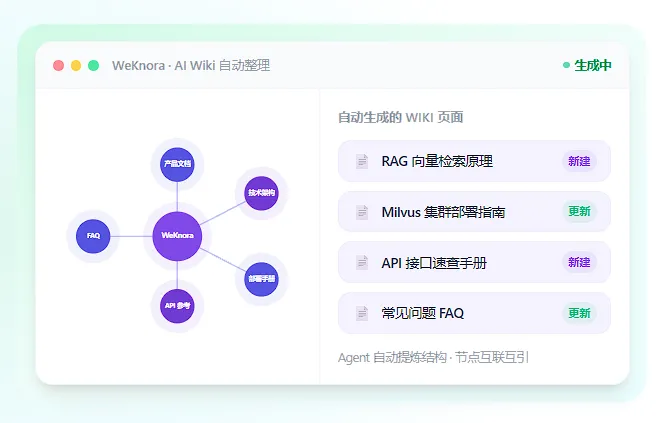
你想想,以前整理 Wiki 这事得靠人一个个写。现在 Agent 帮你干——而且它不会偷懒,不会觉得"差不多得了"。
能接的东西太多了
WeKnora 的集成能力有点"丧心病狂"。
模型方面:OpenAI、DeepSeek、通义千问、智谱、混元、Gemini、MiniMax、英伟达……一共 20 多家,加 Ollama 本地部署。没有厂商锁定,想用谁用谁。
文档格式:PDF、Word、TXT、Markdown、HTML、EPUB、图片(带 OCR)、CSV、Excel、PPT、JSON。基本上你能想到的办公文档它都吃。
数据源:飞书知识库、飞书云盘、Notion、语雀,支持自动同步。你把文档扔在这些平台上,WeKnora 自动拉过来建索引。
IM 渠道:企业微信、飞书、Slack、Telegram、钉钉、Mattermost……10 个。你可以直接在群里 @机器人 问问题。
向量数据库:pgvector、Elasticsearch、Milvus、Qdrant、Weaviate、Apache Doris、腾讯云 VectorDB,8 种随便选。
部署方面,docker compose up -d 一行命令就跑起来了。前端、后端、沙箱、文档解析服务、PostgreSQL、Redis 六个容器,全自动编排。想纯本地跑?配个 Ollama 就行,全链路不依赖外网。
谁适合用
说几个我觉得最实际的场景:
中小企业知识库:不用买 SaaS,不用把数据交出去。Docker 往自己服务器上一跑,所有内部文档都能查。四级权限控制(Owner/Admin/Contributor/Viewer),数据 AES-256-GCM 加密,审计日志齐全。
技术团队文档中心:开发者可以直接用 REST API 对接自己的系统。还有 Chrome 插件,浏览网页看到好内容一键存入知识库。MCP Server 也支持,Claude Code 这种 Agent 能直接调你的知识库。
公众号 / 自媒体:你可以把自己所有历史文章丢进去建个知识库,然后直接问"我之前写过关于 XX 的文章,核心观点是什么"。比翻自己的后台快多了。
个人知识管理:微信对话开放平台已经基于 WeKnora 做了线上版 chatbot.weixin.qq.com,扫码就能用,零部署。个人碎片知识往里丢,还能自动整理。
几个值得注意的细节
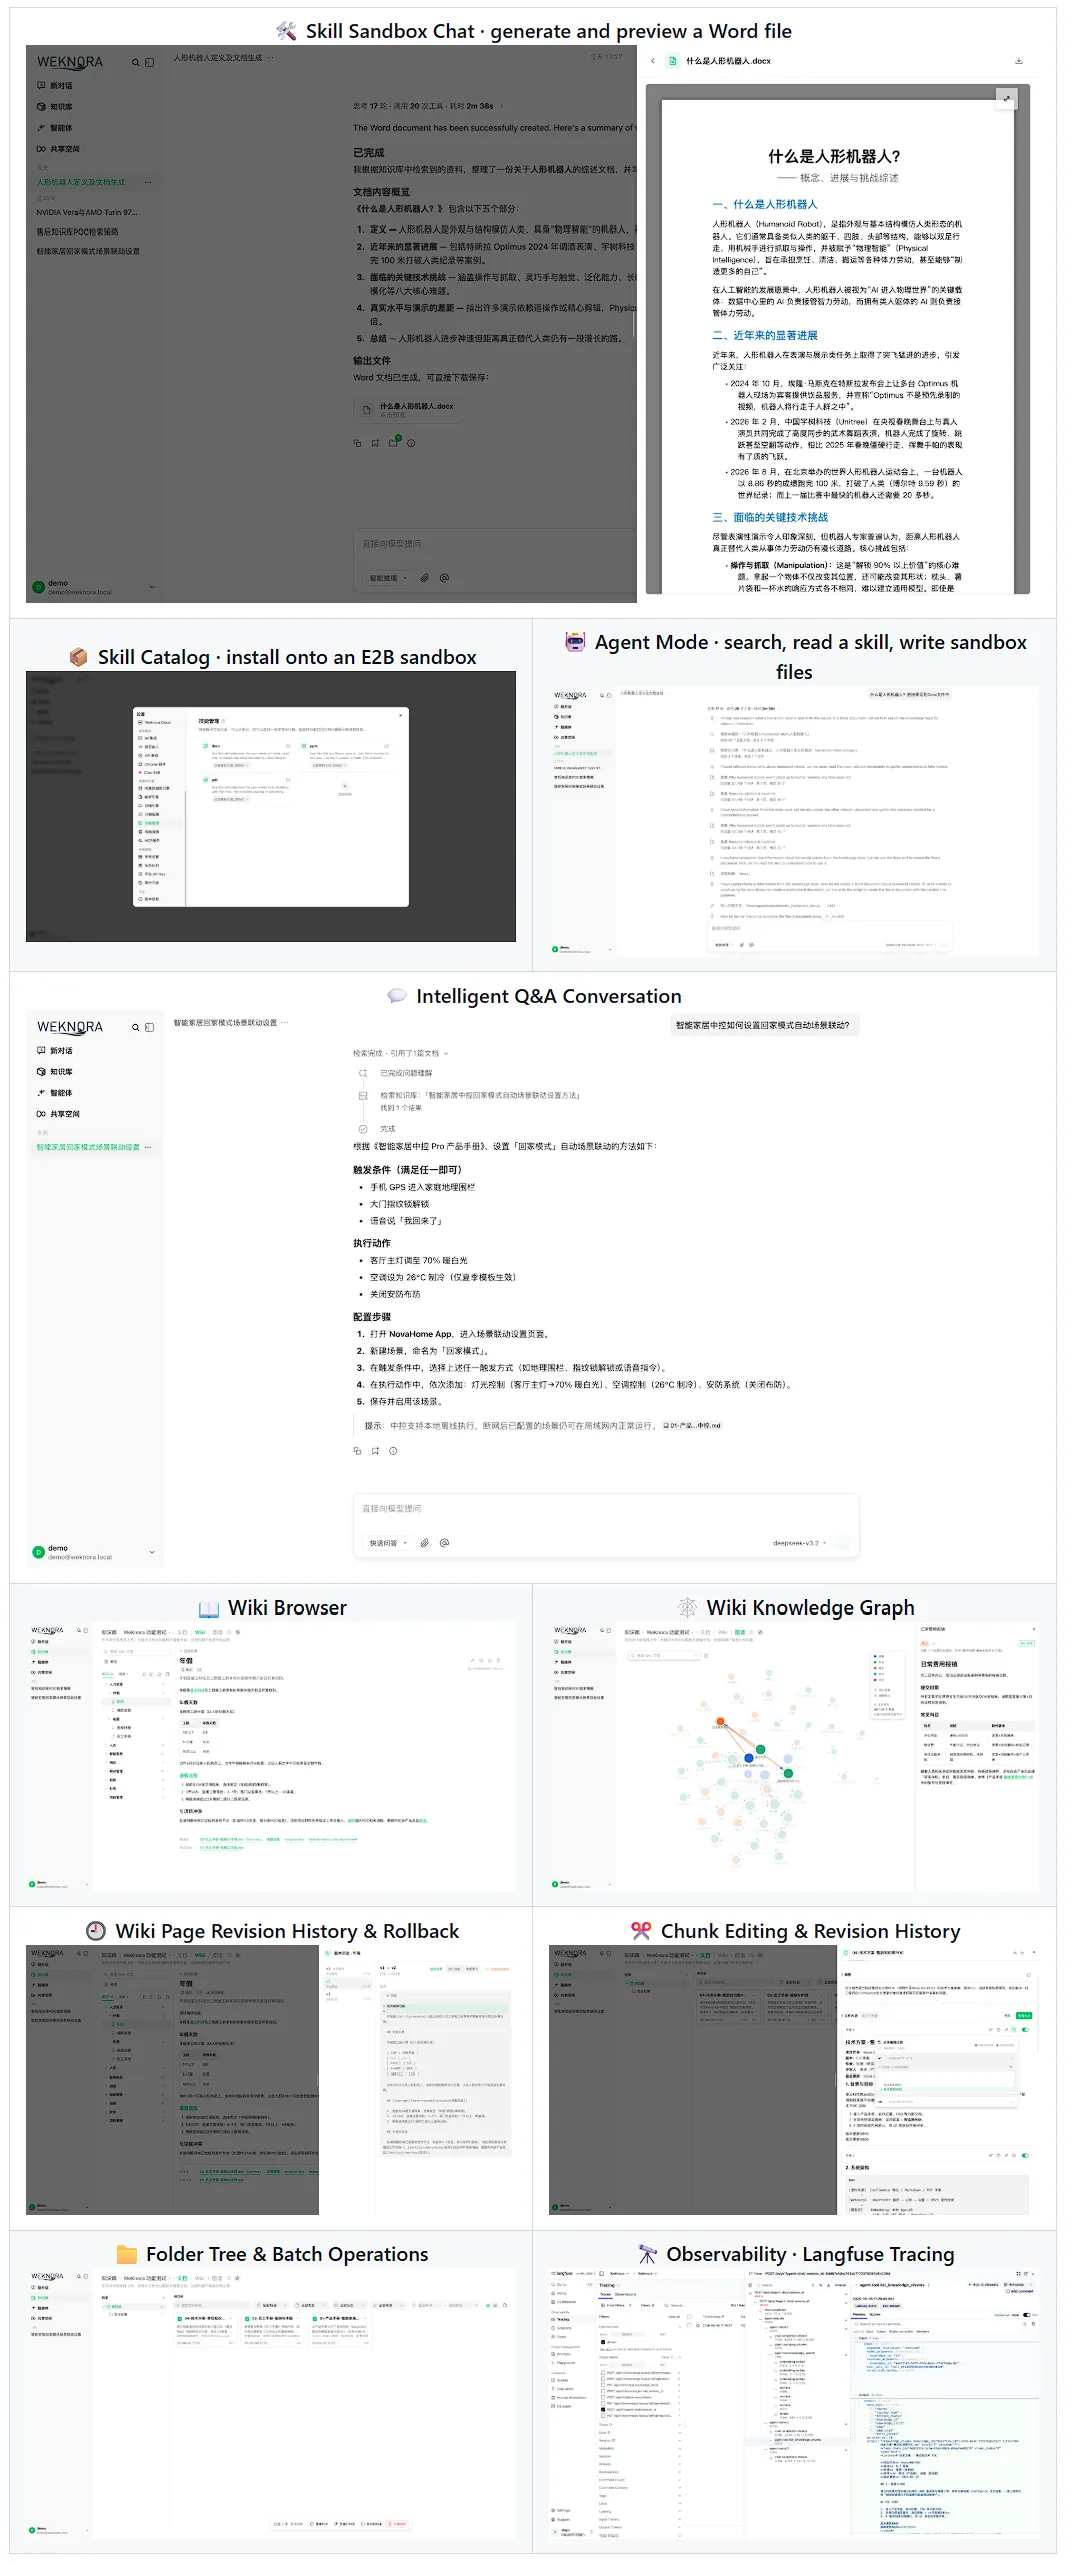
分块策略是自适应的。它不是无脑按字数切文档,而是先做文档画像——看标题密度、分页符数量、章节标记,自动选最合适的切分方式。技术文档用 heading 模式按标题切,PDF 用 heuristic 模式按排版切,普通文本用递归切。这个细节直接影响检索质量。
父子分块机制。小块(默认 384 字符)负责精准匹配,匹配到之后把大块(默认 4096 字符)整段返回给模型。解决了一个经典问题:匹配得准但上下文不全。
Chunk 可编辑。你在界面上直接改检索分块的内容,有版本快照和 diff 对比,一键回滚。改完自动重建索引。这对内容运营来说太实用了。
Langfuse 全链路追踪。每次问答的 token 消耗、检索路径、Agent 推理过程,全部可视化。出了问题你能精确定位是检索不行还是模型不行。
21000 星确实炸裂,但我得说——RAG 知识库这个赛道已经卷得飞起了。Dify、FastGPT、MaxKB、Anything LLM……哪个不香?
WeKnora 的差异化我觉得主要在三点:一是腾讯团队维护,微信生态无缝对接(企业微信、公众号、小程序直接接入);二是 Wiki 自动生成功能目前其他项目基本没有;三是工程完成度极高,2948 次 commit、8 种向量库、20+ 模型、10 个 IM 渠道,不是那种" demo 级开源"。
如果你正在找一个能私有部署、支持中文生态、而且不想折腾太多配置的知识库方案,WeKnora 值得一试。
毕竟,腾讯 MIT 开源 + 21000 星,这个组合在开源圈已经说明了一些事情。
往期精选
一周涨12,000星!这个开源项目把世界搬进了你的浏览器,而且数据全是真的!
AI 视频编辑神器:video-use!基于对话的专业视频制作工具,用文本推理干掉时间线!
OpenClaw 2.0!“史上最大”更新!可能是它最后一次证明自己的机会了!
OpenAI都在用的实时语音框架,支持300+模型,开源免费随便改!
22300星!上传PDF秒变互动课!清华开源多Agent课堂!
追踪AI前沿,深挖GitHub宝藏。
用优质内容陪你成长,
点击关注,携手启航。