ARTICLE · 1133873
自研量化软件分享(十):如何挖掘出好因子
聊量化的人都有过这一幕:熬夜刷帖看到一个「看起来很不错」的指标,抄进软件一试,当场灵光,隔天失灵。你也想过吧——挑指标这件事,能不能不靠运气?
手工想指标有三个口子堵不住。一是想得少:脑子里的组合翻来覆去就那几十种;二是试得多报得少:试了二十个,留下顺眼的那个,多半只是碰巧好看;三是没人续考:用顺手的指标,没人说得清它过去三个月还灵不灵。
方块量化里有块地方叫因子实验室。定位一句话:让机器自动去搜「选股公式」,搜出来的要连过四道闸,入册之后每天还得继续考试。
亮点三个:搜得到,拦得住,考得久。
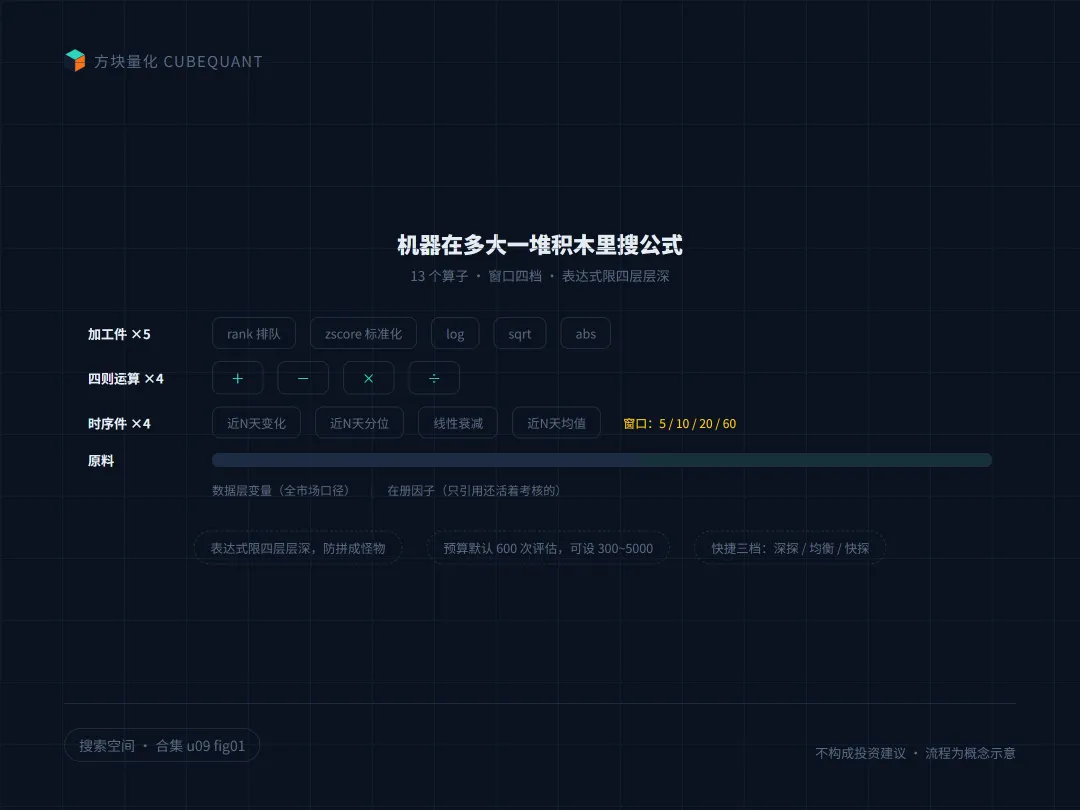
先说搜得到。点「生成因子」,设个目标它就开搜。公式由 13 个算子拼出来:rank、zscore、log 这类加工件,加减乘除,再加 ts_delta、ts_rank 这类「近 N 天变化/分位」的时序件,窗口固定 5、10、20、60 四档;原料是数据层变量加在册因子,表达式限四层层深。评估预算默认 600 次,可设 300 到 5000,界面上还备了三档快捷方案:深探、均衡、快探。
机器挖东西,怕的是「拿数量刷成绩」:试一千条公式,总有一条全靠运气看着漂亮。所以评分不看它调参的那段数据——前半段调参、后半段打分,成绩只认后半段;而且每跑一次挖掘就记一笔试验账,挖得越多,及格线自动抬得越高。这套闸门防的就是它自己。
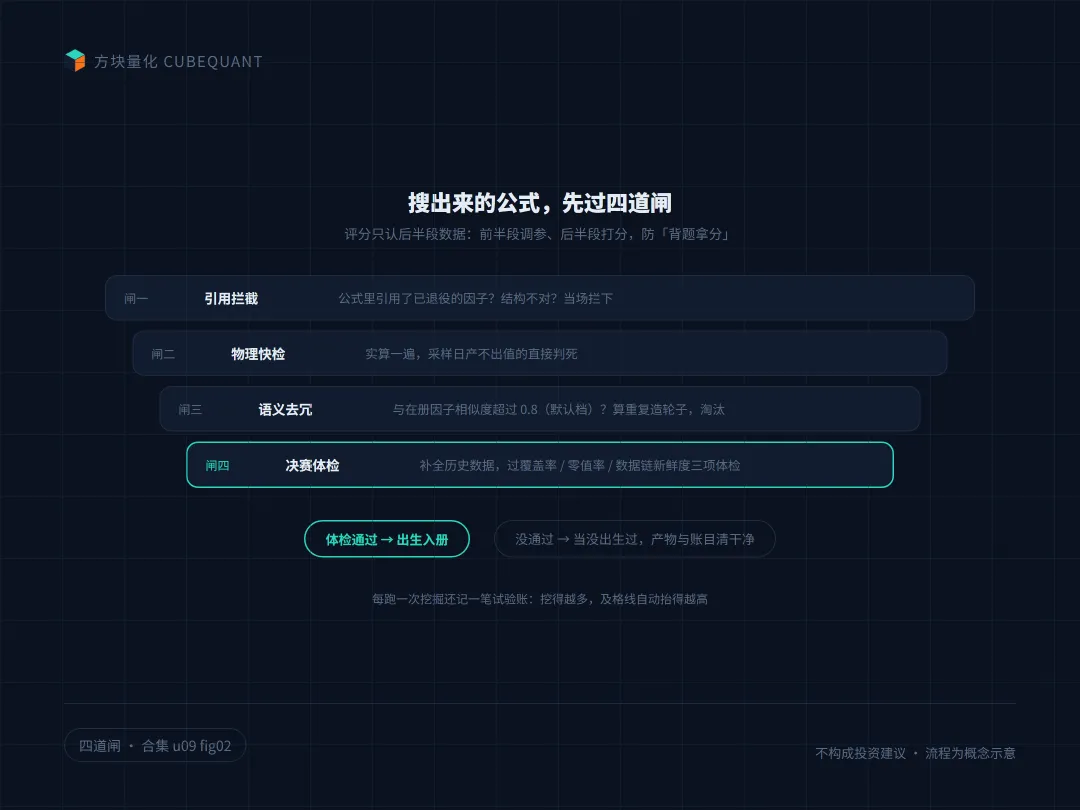
拦得住还有四道闸:先查公式有没有引用已经退役的旧因子,引了就拦;再实算一遍,当场产不出值的直接判死;跟在册因子长得太像的(相关性超过 0.8),算冗余淘汰;活到决赛的补全历史数据,再过覆盖率、零值率、数据链新鲜度三项体检——通过才算出生,不通过就当没出生过,产物和账目一起清干净。
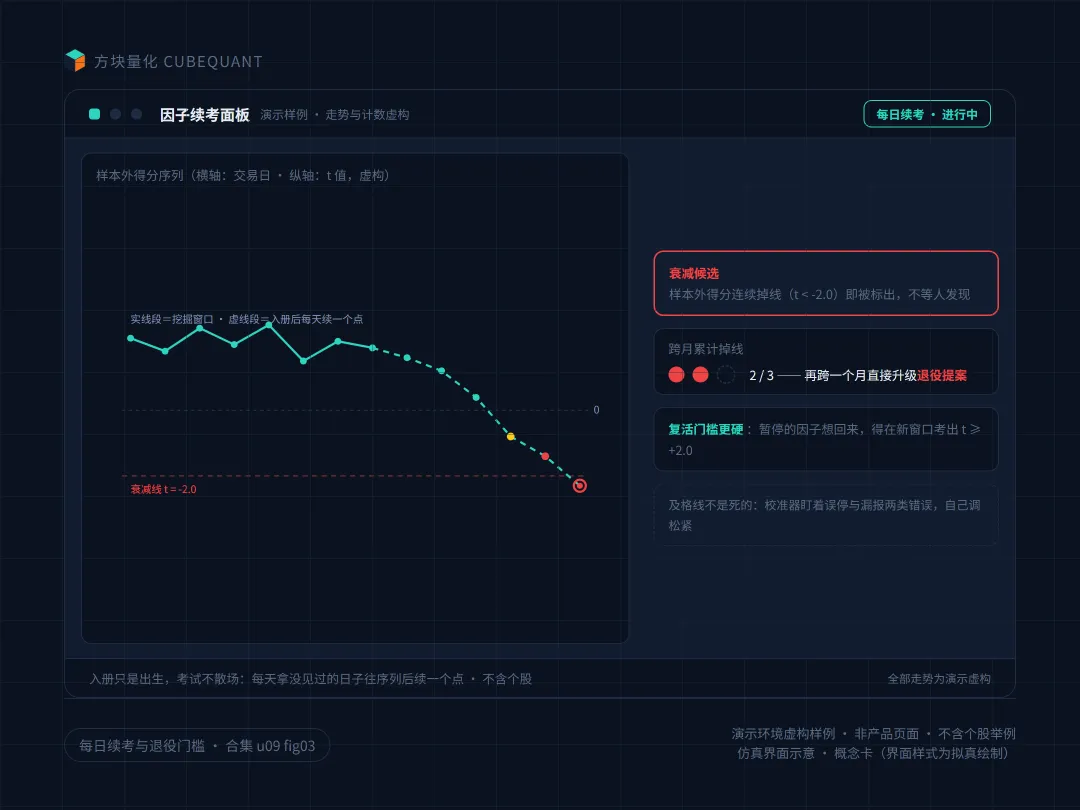
考得久是后半场。出生只是开始:每天有一条增量流水线,把每个因子的考核序列用新行情往后续一天,打分窗口真正延伸到挖掘时没见过的日子——这是拿没见过的题考试,不是原地复批。连续掉队会被标成衰减候选,跨月累计三次直接升级退役提案;暂停的因子想回来,得在新窗口里考出更硬的成绩。判定用的及格线也不是死的,校准器盯着误停和漏报两类错误,自己调松紧。
还能让它自己排班:自定义定时任务里挂一档「因子生成」,按周触发,机器周末自己开工,不用人盯。
给你看个演示场景:均衡档,预算 600。开搜前,机器先拿一小笔预算(八分之一,上限 120 次)枚举一批简单模板,活下来的塞进初始群体——先站在简单公式的肩膀上再找,不算盲搜;这些种子的成绩还带缓存,跨代不重复烧预算。
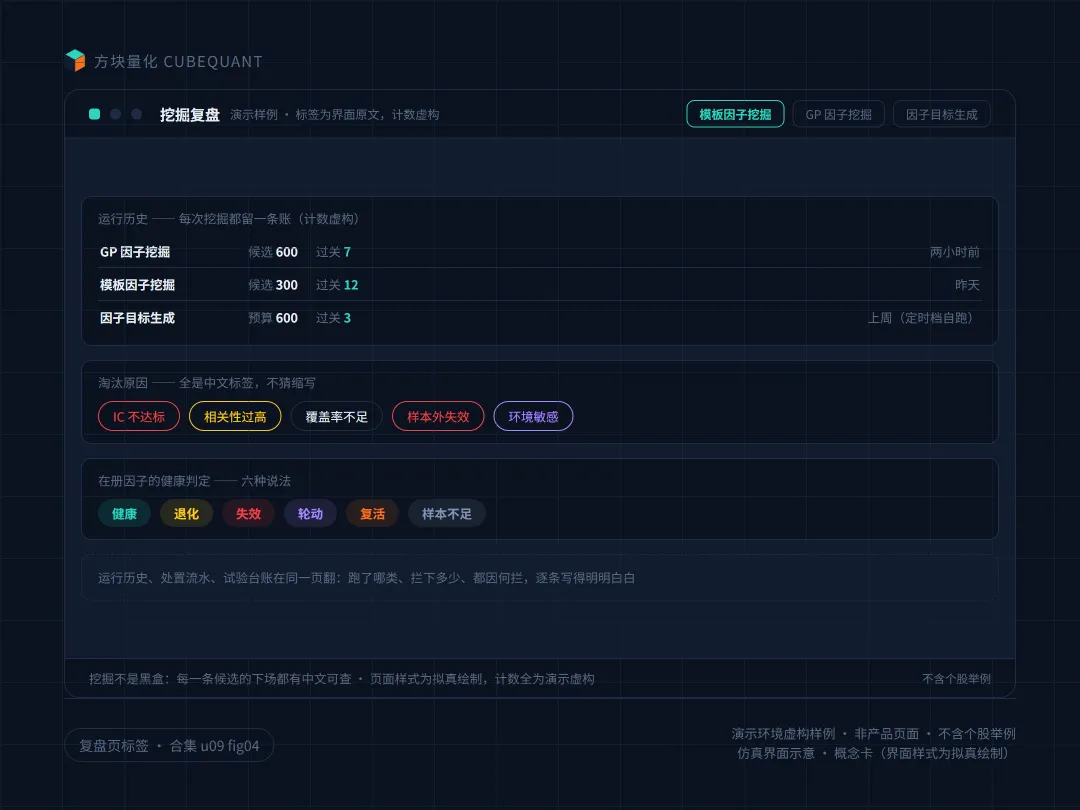
挖出来的东西都有账可查:复盘页里,运行分「模板因子挖掘」「GP 因子挖掘」「因子目标生成」三类,淘汰原因全是中文标签——「IC 不达标」「相关性过高」「样本外失效」;健康判定分六种:健康、退化、失效、轮动、复活、样本不足。
留个问题:如果机器搜出一条比你经验更好看的公式,你敢直接用,还是先让它考一个季度?评论区聊聊。想看哪块被拆开讲,评论区点单。
关注公众号「方块量化」,下一篇接着拆。
内容仅为工具功能与工程学习记录,画面数据均为演示环境样例,不构成投资建议。市场有风险,决策请谨慎。