ARTICLE · 1133881
10月9日 “软件新技术讲坛” 学术报告 - 李彦玮 长聘教轨助理教授
10月9日 “软件新技术讲坛” 学术报告 - 李彦玮 长聘教轨助理教授从语义到几何:视觉生成如何促进多模态理解与推理 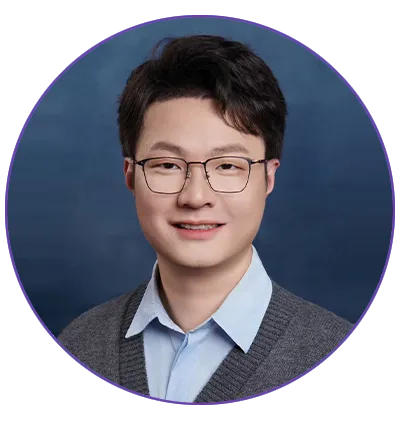
李彦玮, 长聘教轨助理教授上海交通大学 人工智能学院 统一多模态模型正在融合视觉理解与生成能力,但如何让两者有效协同,仍是值得深入探索的问题。本报告围绕“视觉生成如何促进理解与推理”,介绍从语义表征到空间几何的两项研究。首先,介绍语义生成式调优方法(SGT),通过系统比较不同层次的视觉生成任务,以图像分割作为连接理解与生成的桥梁,改善语义表征与跨模态对齐,促进视觉理解和图像生成能力的协同提升。随后,介绍几何理解与生成统一模型(GeoUG),探讨深度与多视角生成在训练阶段对空间理解的作用,并通过强化学习驱动的自适应交错推理,使模型按需生成深度图,利用几何证据验证和修正初步判断。报告将结合方法设计与实验分析,讨论生成能力如何在训练与推理阶段发挥作用,为多模态模型的能力协同提供思路。 欢迎参加
时间:2026年10月9日(星期五)14:00
地点:苏州校区南雍楼东530室
摘 要
报告人简介