ARTICLE · 1135204
可交互的"病理AI助手":TEAM在85个基准上全面领先,可以让病理医生实时改预测
精准肿瘤学日益依赖多尺度生物标志物——它们以形态学信号呈现在常规全切片图像(WSI)中。但多数计算病理模型把标志物谱分析与结局预测当成两个独立任务,又缺乏临床转化所需的交互性与可信度。
本文介绍 TEAM——一个交互式可信 AI 病理助手(Trustworthy AI Pathology Copilot)。预训练于 55,648 张泛癌 WSI 与 1,750,648 个 ROI,TEAM 通过临床元数据条件化与相对风险先验学习"风险感知嵌入";量化 tile 级数据/模型两类不确定性并传播到患者级;把谱分析得到的生物标志物作为中间特征参与预后与治疗估计;还集成视觉-语言模型做智能体化临床推理,并提供基于网页的"医生在环"交互精修接口。
① 规模与广度:48 个多机构队列、85 个基准(67 公开 + 18 自建)系统评估,预后 C-index 平均提升 +3.2%、TEAM* 中位 +19.9%;② 风险感知嵌入:不只看形态,还条件化临床元数据、对齐相对风险先验——"预后"长在表示里;③ 可量化可信度:tile 级 aleatoric/epistemic 不确定性传播到患者级,低不确定子集显著更准;④ 标志物驱动结局预测:谱分析结果作为中间特征参与预后/治疗估计,完全集成 C-index 0.783;⑤ 人在环:病理医生可通过网页界面按区域反馈精修预测,5 名病理医生评估 ICC 中位数 0.94。
生物标志物已从单一组学扩展到癌症分期/分级、肿瘤微环境(TME)、基因表达等多个尺度。但现实是:这些多尺度生物标志物常依赖昂贵且技术要求高的检测,敏感度、特异度与临床可重复性有限。好在它们背后的细胞过程在 H&E 染色组织上都有特征性的形态模式——这给了 AI 用常规切片替代/补充分子检测的机会。
然而既有计算病理模型大多把"谱分析"和"结局预测"当作独立任务:先预测 PD-L1、TMB,再另起炉灶预测生存。它们缺乏三样东西——① 把预后风险内化到表示中;② 量化并传播不确定性;③ 让临床医生介入并修正。TEAM 把这三件事做成了统一的框架(图 1)。
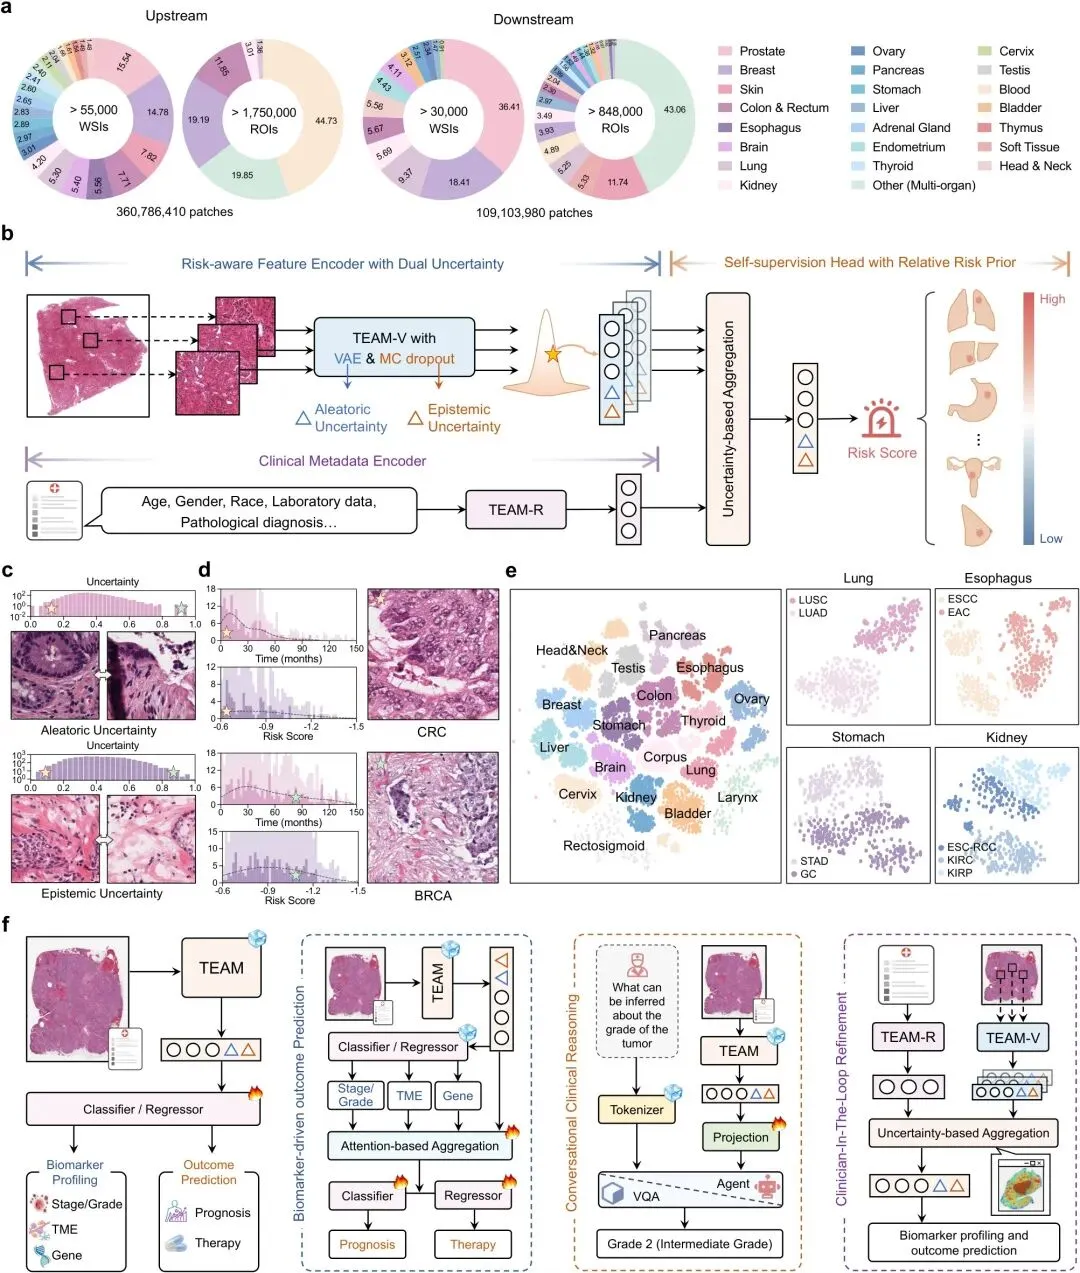
TEAM 的第一步是风险感知嵌入。它在大规模泛癌数据上预训练(55,648 WSI、1,750,648 ROI、3.6 亿 tile),与普通基础模型的关键区别是:嵌入学习被临床元数据条件化(如分期、分级等),并显式与相对风险先验对齐——同一幅形态,在不同的临床背景下被编码进不同的风险坐标系。
效果:在 NFH-CESC 队列上,TEAM 的患者嵌入呈现出与预测风险分数强相关的空间风险梯度(ρ = 0.94, P<0.001)——高危区与低危区在形态流形上自然分开。这意味着"预后"不再只是下游任务的标签,而是从表示层面就长在模型里。
可信 AI 的关键是"知道自己在多大程度上可信"。TEAM 在 tile 级分别量化两类不确定性:aleatoric(数据固有)与epistemic(模型不确定),再把它们传播到患者级预测。
用法很直接:设定不确定性阈值 <0.5,得到高置信子集 TEAM*。在预后任务上 TEAM* 的中位 C-index 提升达 +19.9%(平均保留 74.0% 病例)。以 NFH-CESC 队列为例,TEAM 在 1、3、5 年随访点的时间依赖 ROC AUC 分别达 0.760、0.831、0.944,整个随访期都稳定优于基线。不确定性不是锦上添花——它是把 AI 从"黑箱预测"推向"可信部署"的桥梁。
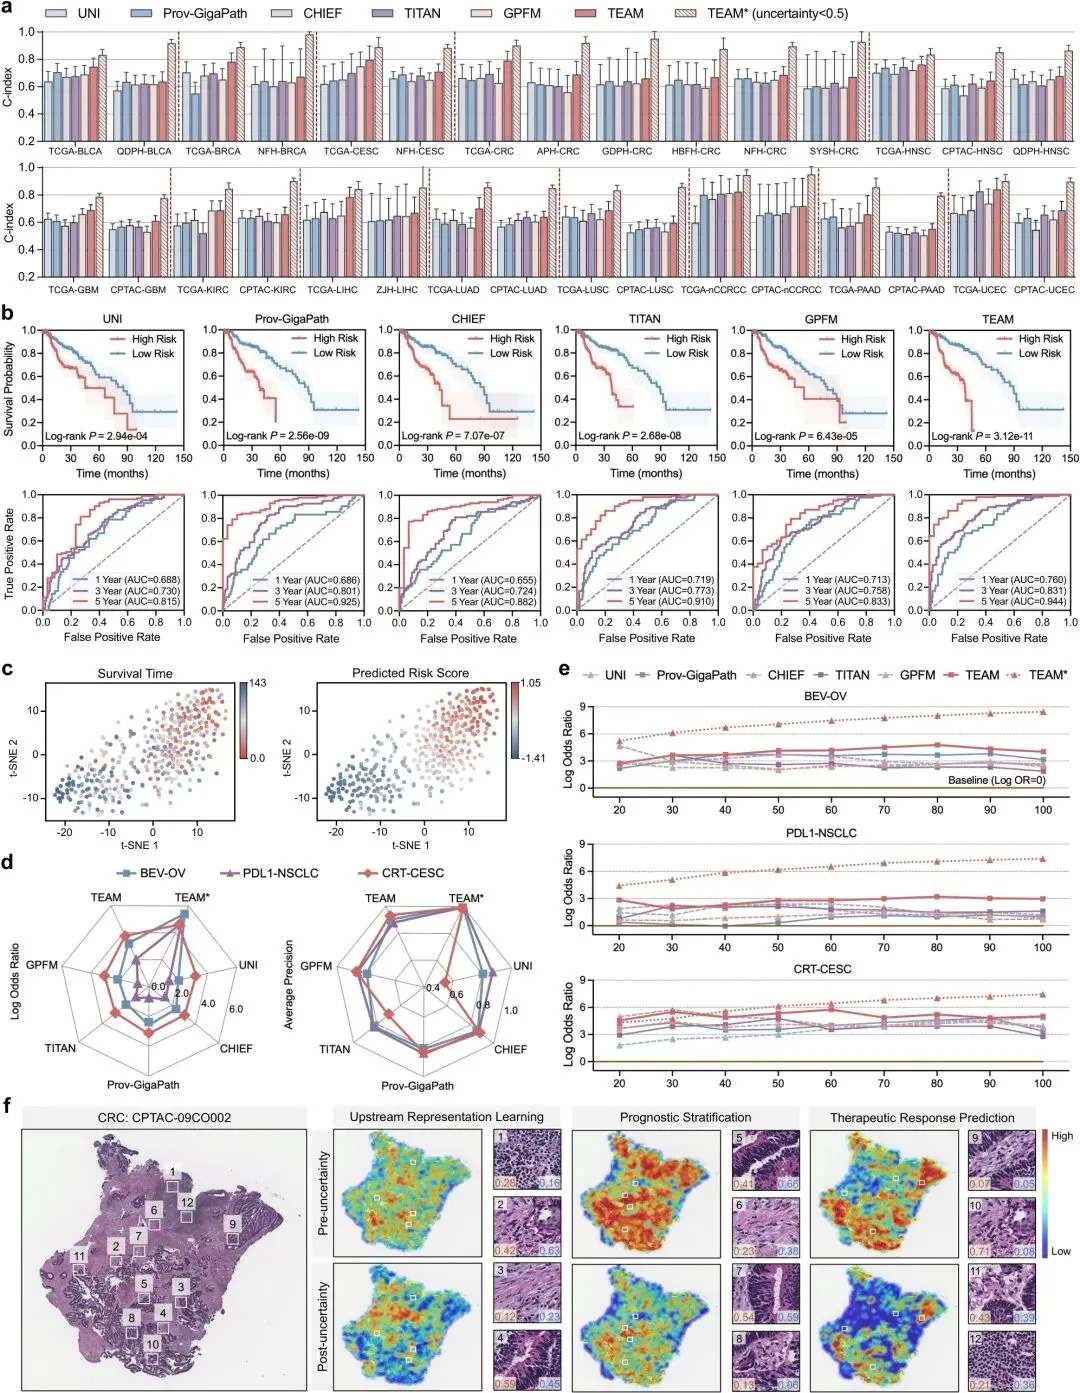
评估规模是空前的:48 个多机构队列、30,776 WSI、848,655 ROI、1.09 亿 tile、85 个独立基准(67 公开 + 18 自建)。在预后分层上,TEAM 相对已有方法(UNI、Prov-GigaPath、CHIEF、TITAN、GPFM 等)平均 C-index 提升 +3.2%;在治疗响应预测上,Log OR 达 3.00±0.67、AP 达 0.907±0.022,显著超过次优基线(图 2d)。
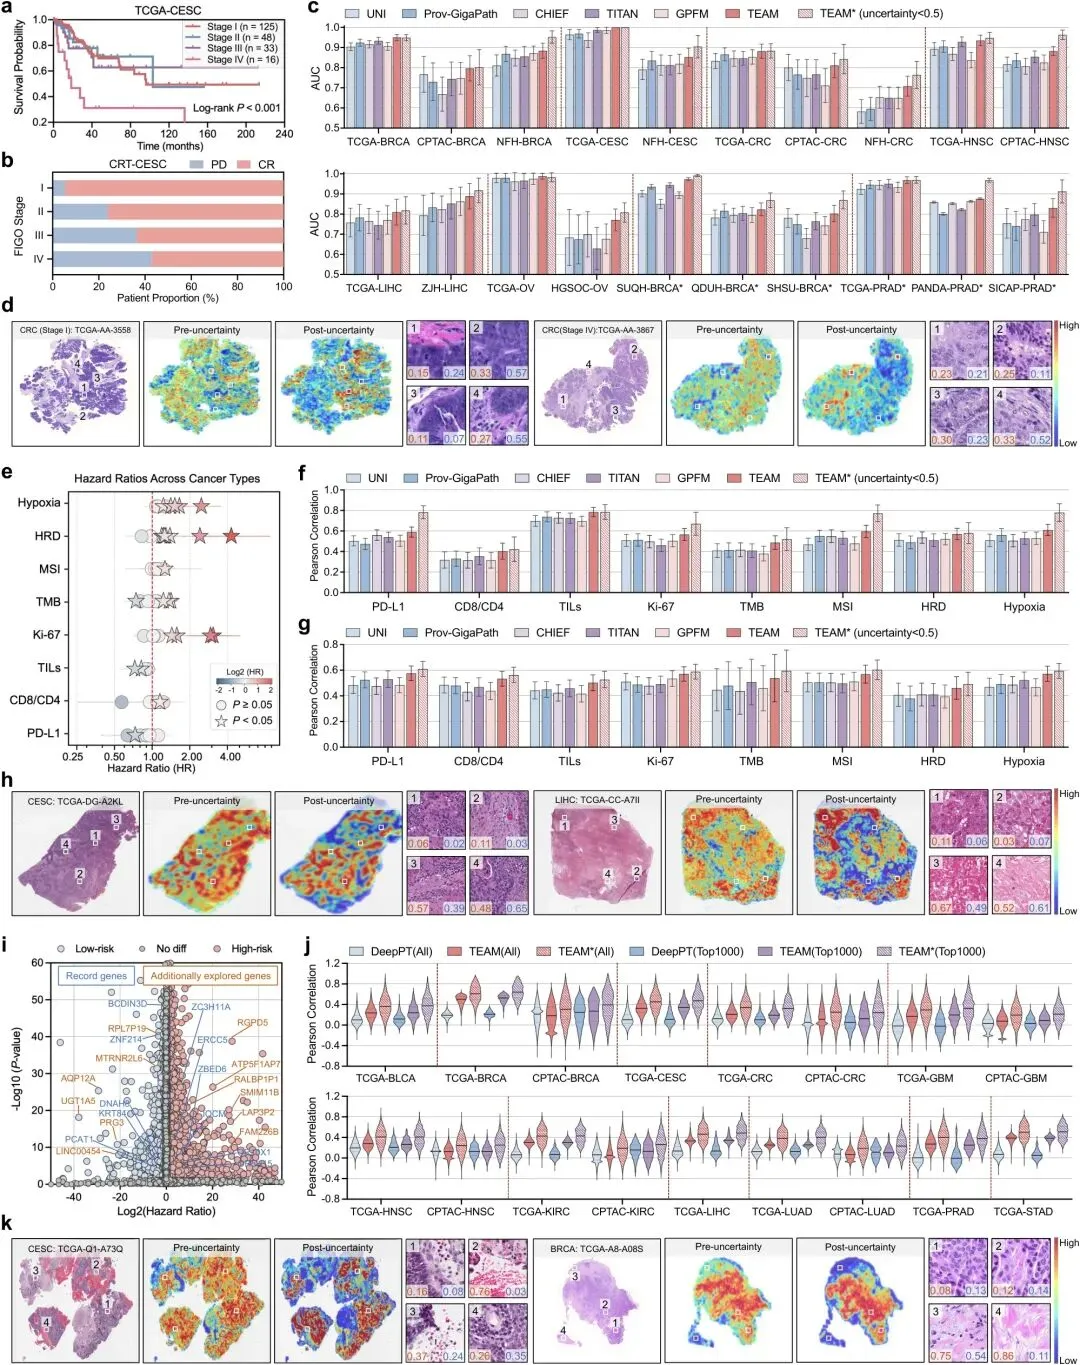
分期/分级同样领先:HNSC 分期在 TCGA 上 AUC 0.935、CPTAC 上 0.883;分级任务内部超过 0.95、外部超过 0.80;跨内外部队列一致。更重要的是这些提升不靠牺牲生物可解释性——注意力热图优先落在肿瘤富集区而非间质(图 3k),风险评分的生物学通路(GSEA)富集于侵袭相关通路。
TEAM 的谱分析覆盖癌症分期/分级、TME 特征、基因表达推断三层次。TME 侧:预测 PD-L1、CD8/CD4、TILs、Ki-67、TMB、MSI、HRD、缺氧的相关系数(PCC)在多个癌型上稳定领先;基因表达侧:全部基因与 top-1,000 预后基因的推断都能从形态中恢复,注意力热图显示预测优先关注肿瘤富集区域(图 3k)。
跨度之大意味着:从一张 H&E 切片,TEAM 能同时回答"这是什么分期/分级、微环境什么样、关键基因表达趋势如何"——为下游结局预测准备好了全套中间生物特征。
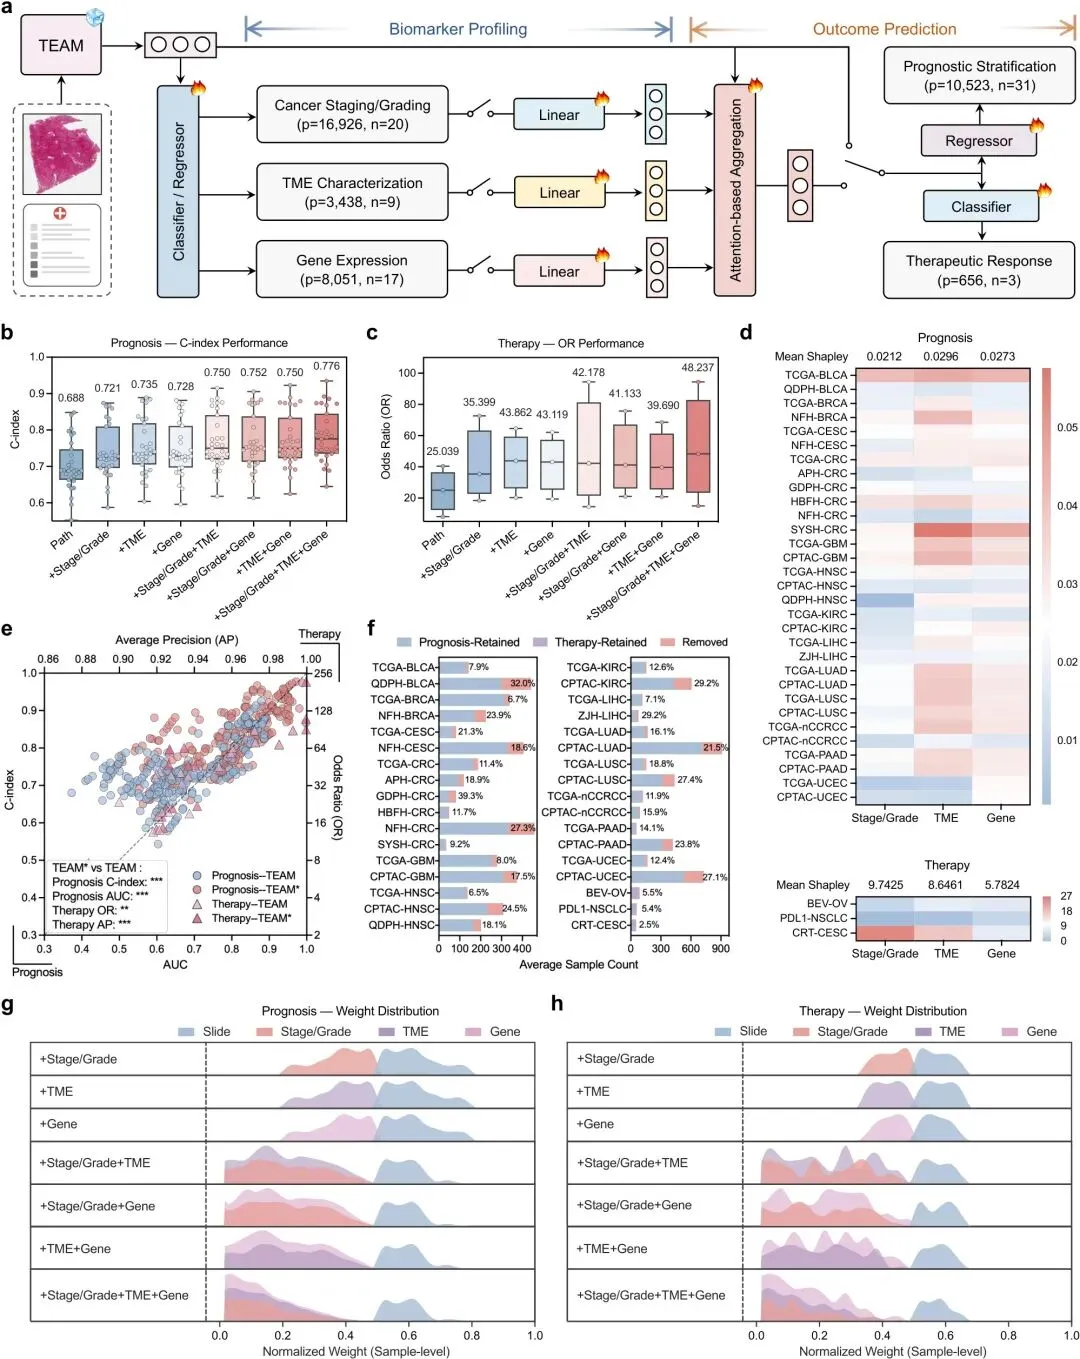
与"先谱分析、再另做结局预测"的管线不同,TEAM 让谱分析得到的生物标志物作为中间特征,参与到预后与治疗估计中。消融显示:单一标志物模型 C-index 0.74–0.75;逐步加入分期/分级、TME、基因表达,完全集成模型(Pathology+Stage/Grade+TME+Gene)达到 C-index 0.783——相对仅病理基线(0.701)平均增益 ∆C-index +8.1%。
这验证了一个设计哲学:结局预测不该是孤立的黑箱。把形态学谱分析与预后估计"串"起来,让模型先"读懂"生物状态、再据此预测结局,既提升精度,也保留了生物学可追溯性(图 4)。
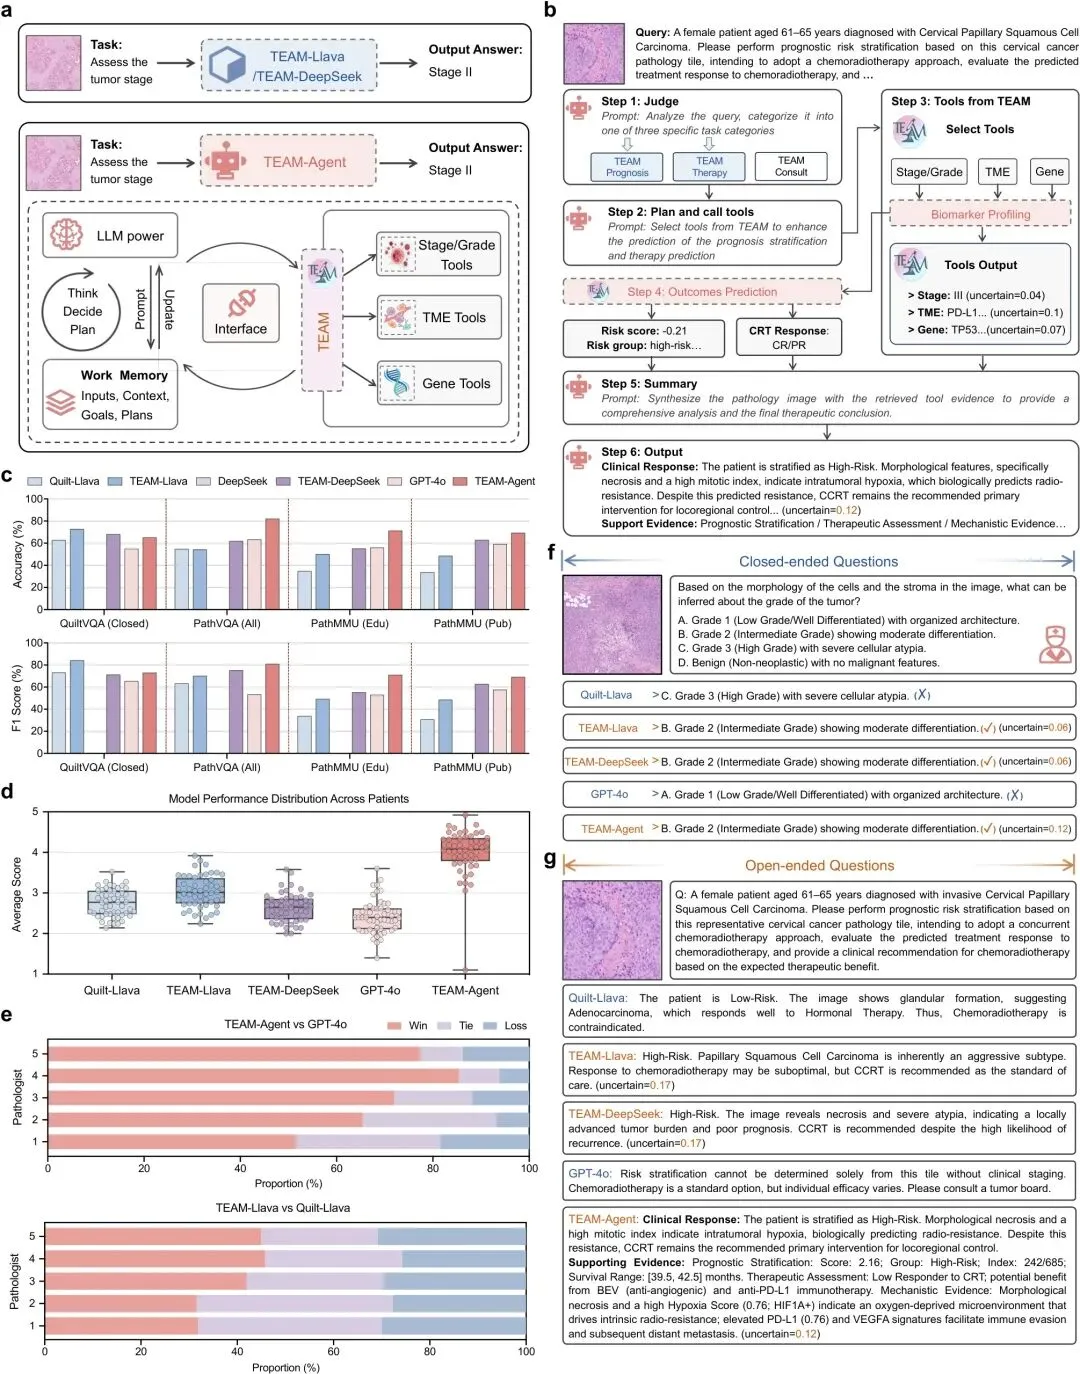
TEAM 不止于"给分数"。它把视觉-语言模型与智能体化编排结合,实现基于知识的临床推理——面对临床问题(如"61–65 岁女性,诊断为……,请评估肿瘤分期"),智能体调用工具、读取形态、生成带依据的回答(图 5)。
在 5 点量表上,TEAM-Agent 的平均分 4.12±0.58,显著优于 GPT-4o(3.08±0.62)与 Quilt-Llava(2.68±0.71)等通用病理 VLM——不是简单地"看图说话",而是带着临床推理链给出结论。
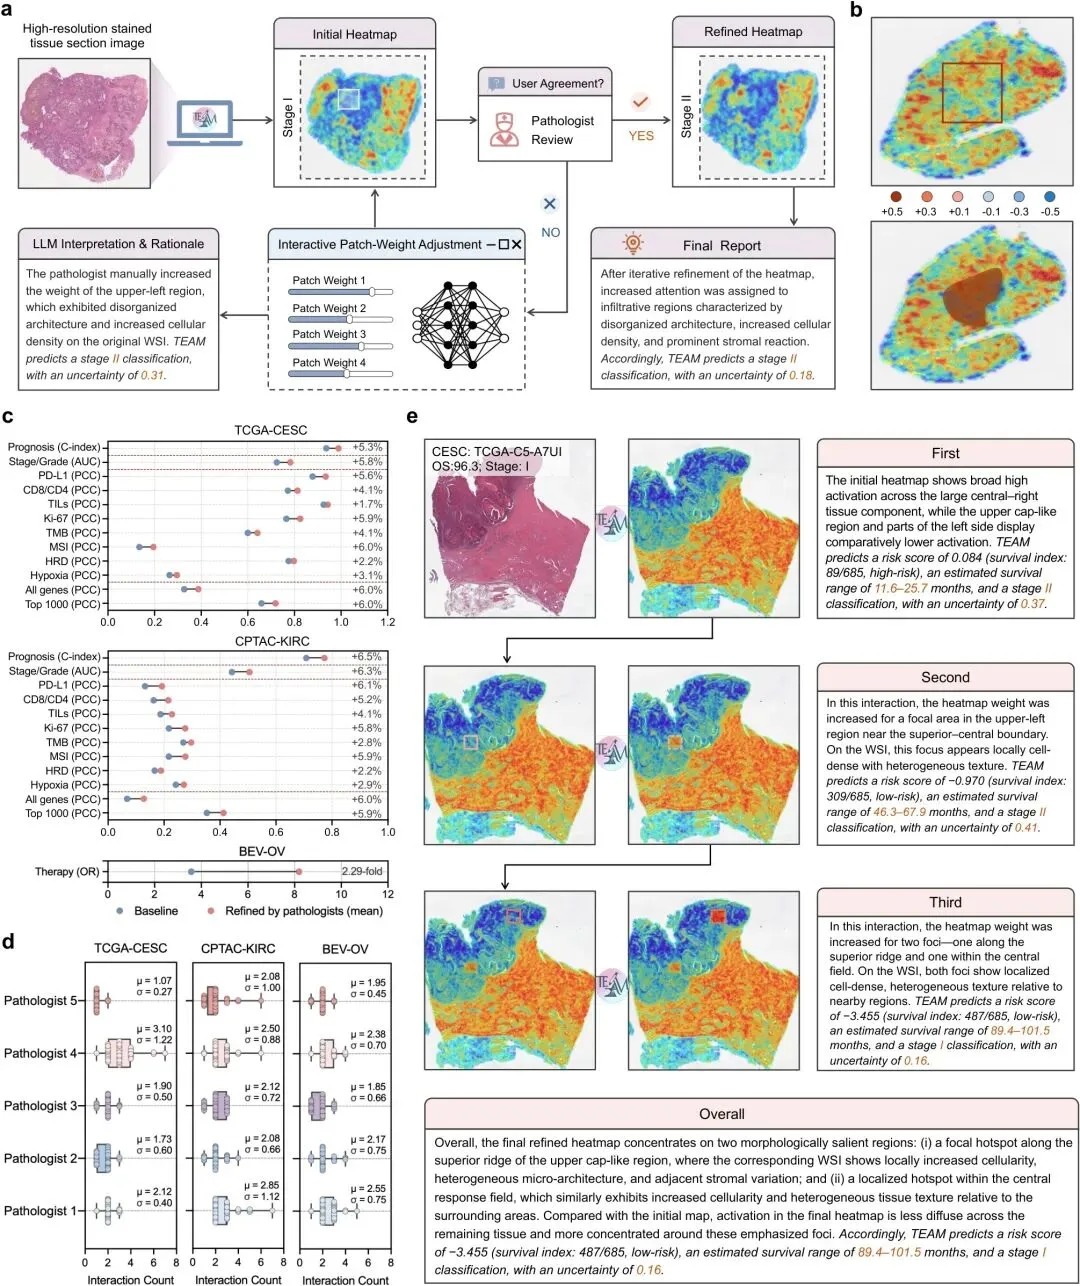
最后,也是最有临床味道的一环:医生在环的交互式预测精修。TEAM 提供基于网页的平台,病理医生可以直接在 WSI 上标注关注区域,模型据此调整预测——从初始热图到精修热图,注意焦点随医生反馈移动(图 6)。
评估:5 名独立病理医生使用交互界面后,预测一致性 ICC 中位数达 0.94——不同临床专家驱动的精修产生一致改善。跨 48 个队列的总体表现证明:把"人"放回决策环,不是降低效率,而是提高可信度与临床可接受度。
TEAM 想回答的问题很本质:一个能被临床真正使用的病理 AI,除了"准",还需要什么?它的答案是一套组合拳——风险感知的表示、量化的不确定性、标志物参与的结局预测、会推理的对话、人在环的修正。
对病理 AI 的启示:① 把"预后风险"内化进嵌入,比事后堆任务更根本;② 不确定性量化不是可选项——低置信子集的显著增益证明"知道不知道"本身就是能力;③ 谱分析与结局预测应当"串"起来,让生物标志物参与决策,既提精度又可追溯;④ 智能体推理 + 人在环,是把模型从"工具"推向"协作者"的必经之路。
当病理 AI 同时做到"答得准、说得清、可以商量",它才真正配得上"助手"这个称谓。TEAM 展示的正是这样一条可信 AI 辅助决策的路径——而路径的尽头,是临床决策桌上那个永远在场的病理医生。
主要来源:TEAM(medRxiv, 2026);UNI;Prov-GigaPath;CHIEF;TITAN;GPFM
萤火Lab · 关注前沿科技与产业落地