ARTICLE · 1135832
AI Coding 订阅怎么算账:跟 SemiAnalysis 学习拆解额度、缓存与补贴账
买模型额度,优先考虑官方订阅。 在官方工具满足工作流的前提下,优先购买官方订阅。原文中的 Claude 自有订阅,比Cursor等第三方提供的同模型,实际可用的Token量会有5~10倍的差距。 200 美元档的月度单价未必更低。 在受测模型和负载下,两家的 100→200 美元档,月度 token 上限约增至 2 倍,每美元额度基本相同。 5x、20x,要先看限制窗口。 Claude 官方的倍数指五小时会话额度;它不能直接换算成月度 token 上限。
同样每月支付 200 美元,你能用多少模型额度?“20x usage”能否换成固定 token 数?换了模型,折算价值为什么会变?
SemiAnalysis 近日发布了一篇关于主流Coding Plan订阅的研究,标题强调 同价位的Anthropic官方订阅,提供的等价API Token价值超过了OpenAI GPT Pro的 5 倍。要读懂这个数字,你需要先学会它的计量方法,再核对比较条件。
本文解读该报告的分析策略,你可以据此分清订阅额度、API 等价价值与任务产出,用自己的workload特点重新算账。
1. 比较订阅,先写清三个条件
你买的是固定月费服务,但模型的每次使用都可能消耗不同额度。
可以把它想象成一张食堂储值卡。相同余额,点不同菜品,能吃的次数不同。订阅里的模型和 token 类型,也有各自的额度消耗权重。
因此,比较对象应写成“套餐、模型、工作负载”的组合。工作负载(workload)指你实际执行的任务,以及任务产生的 token 构成。
与订阅这种套餐不同,API则是按调用计费的一种使用入口,可以理解类似单独点菜。
报告中,同一 200 美元 Claude 套餐使用 Opus 5.5,Agent 负载的理论 API 等价价值约为 11726 美元,Chat 负载约为 9200 美元。
套餐和模型都没换,只改变 token 构成,结果就不同。
请注意,“5x”或“20x”通常以厂商自己的基础套餐为参照。它不能直接与另一家厂商的同名倍率比较。
2. 为什么 Coding Agent 的缓存比例很高
模型读取同一份代码十次,算一次还是十次?答案是,要看每次读取是否命中缓存,以及服务怎样计量。
Coding Agent 指能连续读取文件、调用工具并修改代码的编程代理。它会在多轮请求中反复携带项目上下文。
你可以把这看成查阅同一本手册:第一次整理手册,后面按已有索引查阅,处理成本不同。
报告把 token 分为四类。MTok 表示一百万个 token;
Agent 比例经舍入,合计为 99.9%。这是报告中采用的Coding Agent workload设定,不同用户也许会有差异,但不影响理解分析思路。
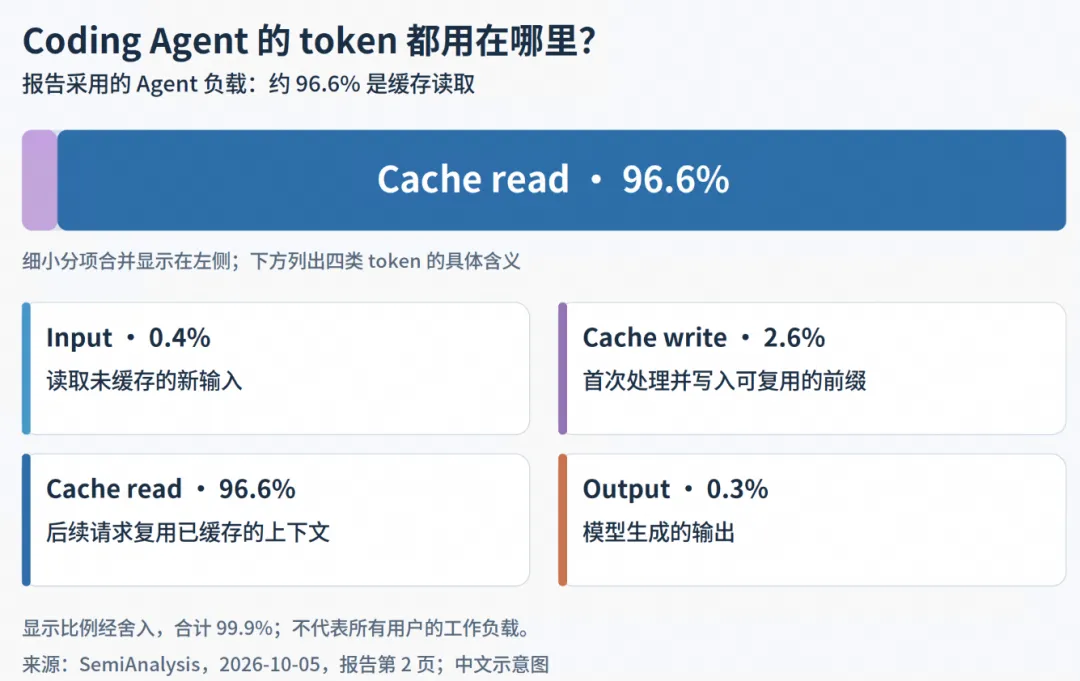
图 1:依据 SemiAnalysis 报告重新绘制;比例为该报告使用的负载构成。
Anthropic 的 Prompt caching 文档说明,缓存复用的是匹配的提示前缀,并有有效期。它不是把每次回答永久存起来,也不意味着后续请求全部免费。
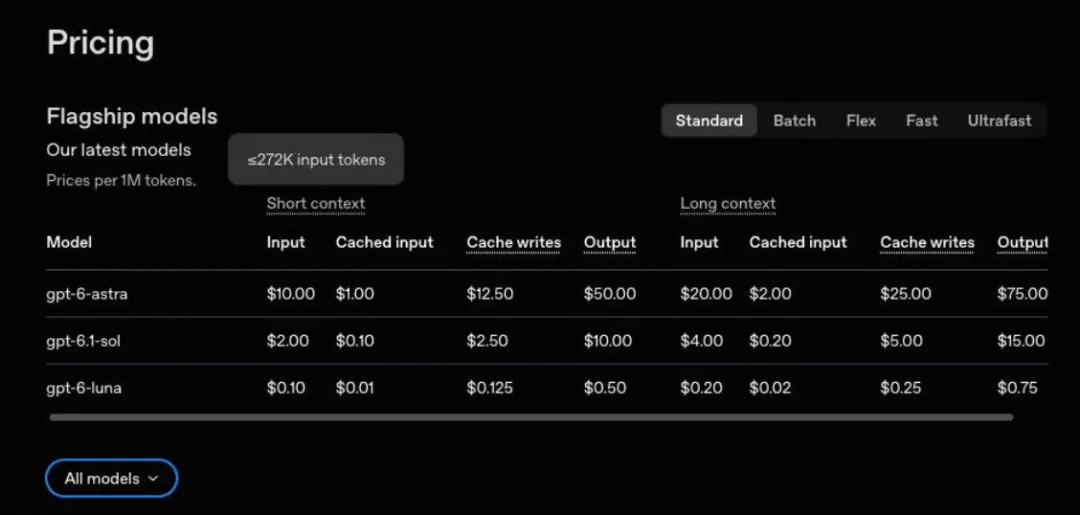
针对上述4类Token类型,目前各模型厂也都是分开定价的,下图是OpenAI官网对不同类型Token的定价:
3. 订阅用量表只跳百分比,怎样测出消耗率?
你看到订阅用量从 10% 变成 11%,能否知道刚才那次请求消耗了多少Token?不能,因为表盘可能只显示整数。
这像只显示整公里的里程表。你开了几百米,数字暂时不变;跨过刻度,数字才跳一下。不能把“不跳表”解释为“没有行驶”。
SemiAnalysis 的方法,是用重复请求突出一种 token 类型,再累计观察用量表的完整阶梯。
它为输入和缓存实验改变或固定前缀,为输出实验生成较长文本,并扣除其他类型 token 的影响。
消耗率可以写成:
沿用报告的示意条件,如果 1 MTok 消耗 5 个百分点:
也就是该窗口最多容纳约 2000 万个这种类型的 token。注意这里是方法示意,不能当成某个真实套餐的额度。
实验开始前,表盘可能已经走过半个刻度。实验结束时,也可能留着未走完的刻度。因此,报告去掉两端不完整区间,持续采样,直到估计范围收敛到其设定的 ±5% 目标。
SemiAnalysis的报告把累计 5 亿缓存读取 token 后仍不跳表的情况,按免费处理。这是一项测量假设,更严谨的解释是“该观察范围与分辨率下未检出消耗”。
4. 五小时限额与周限额
既然五小时额度会恢复,能否不断等重置,把月度用量拉得很高?还要看周额度。
可以把时间窗理解为多道闸门:短窗口限制一次集中使用,周窗口限制较长周期的累计使用,特定模型还可能有子额度。每一道适用的限制都要满足。
报告以 Claude Max 20x 上的 Fable 5.1 输入 token 为例,给出了以下折算:
在使用节奏足以消耗子额度的条件下,Fable 的周上限约为 57 MTok。按报告采用的平均每月 4.345 周计算:
舍入后,结果约为 2.48 亿 token;
官方说明,Max 套餐的 Fable 最多使用共享周额度的 50%。
如果你此前只用了 Fable,用完这一子额度后,仍可换用其他模型消耗剩余额度;如果已经用了其他模型,余量会减少。
5. API 等价价值,到底算的是什么
你支付 200 美元,却看到“11726 美元价值”,这笔钱从哪里来?它是把理论可用 token 按 API 标价重新计价的结果。
这像一张健身年卡:把可参加的课程全部按单次挂牌价相加,可以得到一个折算金额。你没有因此收到同额现金,也未必会参加全部课程。
令月费为 ,第 类 token 的比例为 ,订阅折算成本为 美元/MTok,API 单价为 美元/MTok:
其中, 是每 MTok 消耗的月度额度比例乘以月费,属于摊算值。
报告用 Claude Max 20x、Opus 5.5 和 Agent 负载展示了计算:订阅混合成本约 0.00699 美元/MTok,理论月量约 28606 MTok,API 混合单价约 0.4099 美元/MTok。
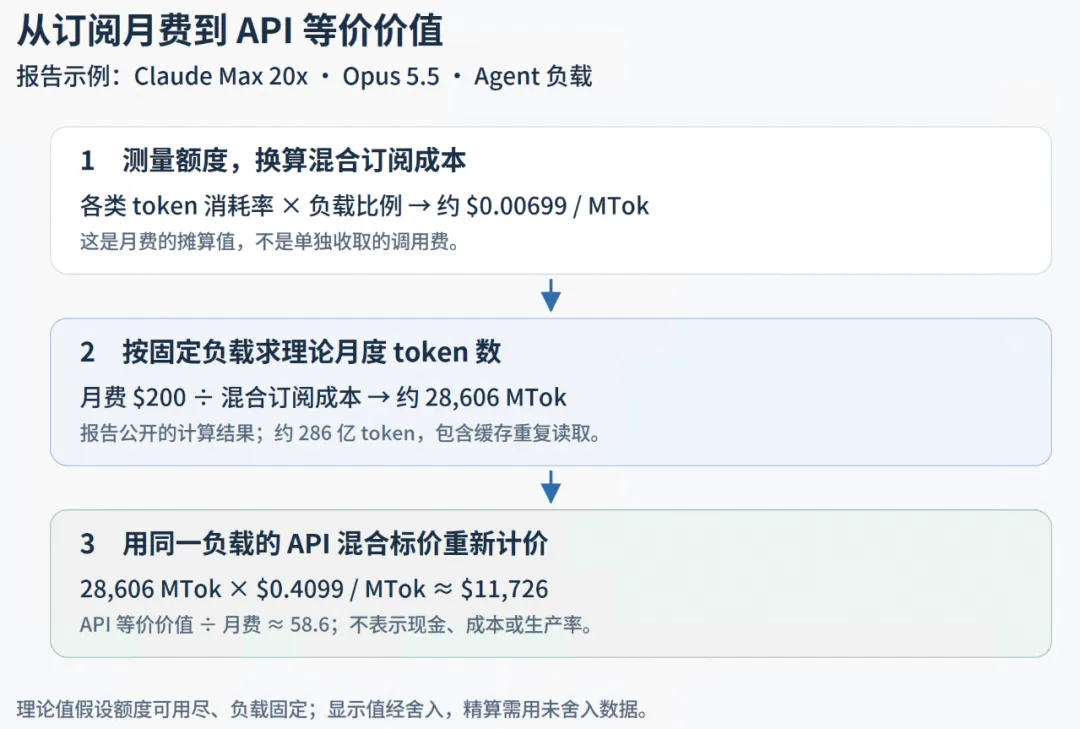
图 2:数据来自报告的 Opus 5.5 示例;显示值有舍入,精算需使用未舍入数据。
请注意,58.6 是 API 标价折算倍率。它不等于厂商的成本补贴倍率,也不等于你节省了 11726 美元。只有你确实需要并使用相同调用量,才有对应的 API 支出可比较。
6. Semi报告标题里的五倍,需要拆成两个指标
报告说 Claude 价值超过五倍,是否意味着它能完成五倍的工作?
不是的,这只是代表Claude Max的Plan,包含的Token量对应API调用的价值,约为GPT Pro Plan的5倍。
先看同为 200 美元月费的两个组合。它们采用报告的 Agent 负载,数据为理论月度上限:
分别计算倍率:
两种倍率不同,因为两个模型的 API 混合单价不同。类似两张流量卡,既可以比较流量,也可以按各自的零售价折算金额;价格差异会改变后一个结果。
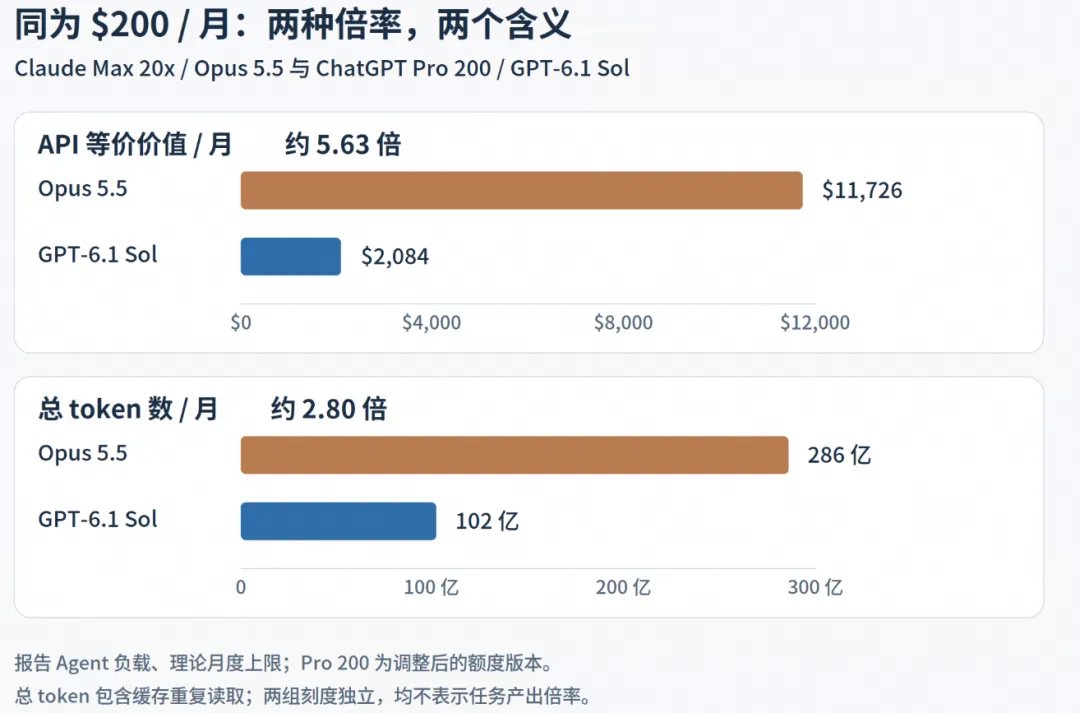
图 3:SemiAnalysis 报告快照,使用其 Agent 负载;两组条形分别使用自己的刻度。
当模型换成 Fable 5.1 与 GPT-6 Astra,报告给出的金额约为 2485 与 2897 美元。
但前者受 Fable 子额度约束,后者对应套餐总额度。不能把它们与完整 Opus 用量直接相加。
请注意,总 token 包含大量缓存重读。成功率、重试、人工修改量和交付耗时,都没有被这两个倍率测量。
7. API 降价,为什么折算价值也会下降
API 更便宜了,订阅的 API 等价价值也会降低。
把折算价值看成“数量乘单价”,就容易理解。拿到相同数量的商品,单价下降,按挂牌价计算的总额也会下降。
报告的 Pro 200 比较显示:
请不要把第二行的约 65% 全部解释成 token 额度削减。比较中的模型版本也发生了变化。
在单独比较 Sol 换代时,报告图表里的 Pro 200 token 量约增加 5%,API 等价价值却约下降 28%。增加 token 的幅度没有抵消混合 API 单价的下降。
官方说明也确认:Pro 200 新订阅采用较低额度;符合规定资格窗口的旧用户,可在订阅有效时保留原额度至 2026 年 10 月 29 日。
8. 从 100 美元升到 200 美元,额度翻几倍
月费越高,单位额度是否越便宜?需要把总量除以月费。
这像比较不同包装的商品。大包装总量更多,但单价是否下降,要按同一单位计算。
先比较报告中的同模型月度 token 量,负载仍为其 Agent 设定。ChatGPT Pro 200 使用调整后的额度版本:
额度与月费都约翻倍。Sol 两档每美元均约 5100 万 token;Opus 两档约为 1.40 亿与 1.43 亿,差异约 2%。
按报告口径,200 美元档增加总量,单位 token 成本与 100 美元档基本相同。
Max 5x 升到 20x,为什么不是四倍?官方说明,倍率指相对于 Pro 的五小时会话额度。周额度另有限制,会话额度四倍不能推成月度总量四倍。
请注意,如果你先撞到五小时限制,更大的会话额度仍有价值;如果 100 美元档已经够用,升级并没有显著的单位价格优势。
中国模型的 API 价值/月费也各不相同:报告中的 MiniMax-M3 约 19.4–23.7倍,GLM-5.3 约 7.7–11.6倍,Kimi K3 约 2.5–6.7倍。
这些数值不表示模型质量。
报告中的新 500 美元套餐也一样:相较调整前的 Pro 200,Astra 额度约增加 21%,月费增加 150%。
小结:月度额度约翻倍、月费也翻倍,200 美元档没有显著的单位价格优势。因此在考虑从$100套餐升级到$200时,请核对你先耗尽的是五小时额度还是周额度,再判断升级是在解决总量不足。
9. 主要购买模型额度时,为什么先看官方订阅
通过 Cursor 或 Devin 使用 Claude,与直接购买 Claude 订阅,差别在哪里?先核对计量边界。
第一方是模型厂商自己的服务。第三方产品调用外部模型,并提供工具能力,类似采购原料后提供加工服务。
如果你主要购买指定模型的额度,官方入口也能满足任务,就优先核对官方订阅。先看报告中的比较。
报告在 Opus 5.5、Agent 负载、同为 200 美元月费的条件下,给出了以下折算:
以官方订阅和 Cursor 为例:
请注意,这里的分母是月费,分子是 API 标价折算金额。
固定同一模型与负载时,它也对应“订阅理论用量/同额预算的 API 用量”;换模型或负载后,就不能只凭这个倍率比较 token 总量。
你也许会问:差距由什么决定?从成本结构看,第三方通常要支付外部模型采购费用。折扣、补贴、工具成本与产品策略都会影响额度;合同未披露,不能把倍率全部归因于 API 折扣。
还要分清额度池。Cursor 官方文档区分 Cursor Models 与 Other Models,后者用于第三方模型。
OpenRouter 的标准付费服务则是充值后按 token 用量扣费,并收取购入 credits 的平台费用。
它属于 API 聚合计费,原报告未提供其订阅补贴倍率,不能套用上表。
请不要把同一额度池的模型上限相加。如果你购买的是编辑器集成、任务环境或多模型路由,还需要单独核对这些功能的价值。
小结:以指定模型额度为主要目标时,先比较官方订阅;第三方功能与 API 聚合服务需另行算账。
10. 订阅方式厂商亏本吗?这取决于你能用掉多少
你也许会问:200 美元能换算出上万美元 API 价值,厂商怎么承受?先要分清 API 标价和服务成本,再看额度兑现率。
额度兑现率指你实际消耗的额度,占理论可用额度的比例。它不同于 GPU 硬件利用率。可以把它理解为自助餐顾客吃掉了多少可供应份额。
沿用报告的条件模型:假设 为月度推理服务成本, 为估算的月度订阅套餐毛利率, API 毛利率为 ,额度价值为 ,月费为 ,兑现率为 。
再假设服务成本随用量线性变化,且同负载下成本率相同:
代入 Opus 示例的 、、:
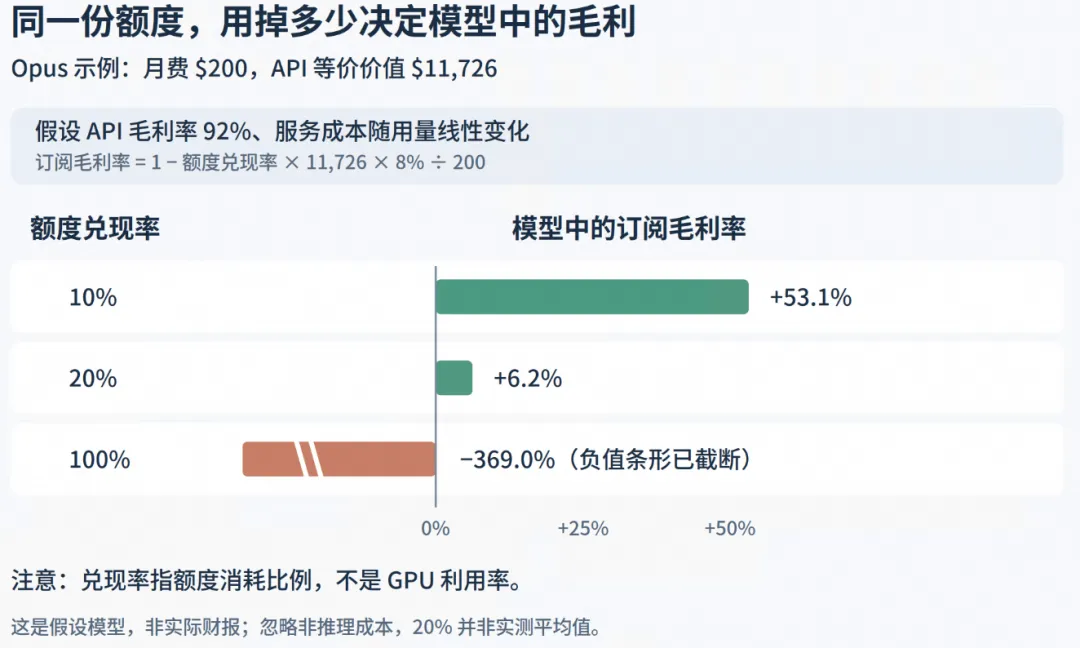
图 4:按报告示例重新计算;假设 API 毛利率 92%,忽略非推理成本,非厂商实际财务数据。
上面的计算里,通过API调用的Token,92%的毛利率,是一个经验值的分析参考,并不是Anthropic官方财报公布的数值,因此仅作参考。
11. 少量订阅收入可能占用了大量推理算力
只看订阅收入占比,能否推断它占用了多少推理资源?不能,因为不同业务的单位资源收入可能不同,而且不是每个订阅的人都会把额度用满。
这像停车场的月卡与临时停车。收入占比和车位占用时间占比,可以有明显差异。
SemiAnalysis 在报告开头给出 Anthropic 的粗略模型:订阅贡献约 10% 收入,占用约 41.7% 推理算力;API 贡献约 90% 收入,占用约 58.3% 算力。
它们是研究机构估算,不是审计财报。
按该模型,比较两类业务的相对收入密度:
也就是在这些假设下,API 每单位推理算力对应的收入约为订阅的 6.4 倍 。
难怪很多API中转站价格能做到比官方还便宜,也难怪官方要大力封杀通过订阅帐号反代提供服务的API中转站,毕竟600%的差价摆在这呢😀
12.国内厂商的Coding Plan怎么样?
原文也比较了 MiniMax、Moonshot、Z.ai 等厂商。这里最有用的不是另排一张名次表,而是同时看两个轴:每美元得到多少 token,以及这些 token 按 API 标价值多少钱。
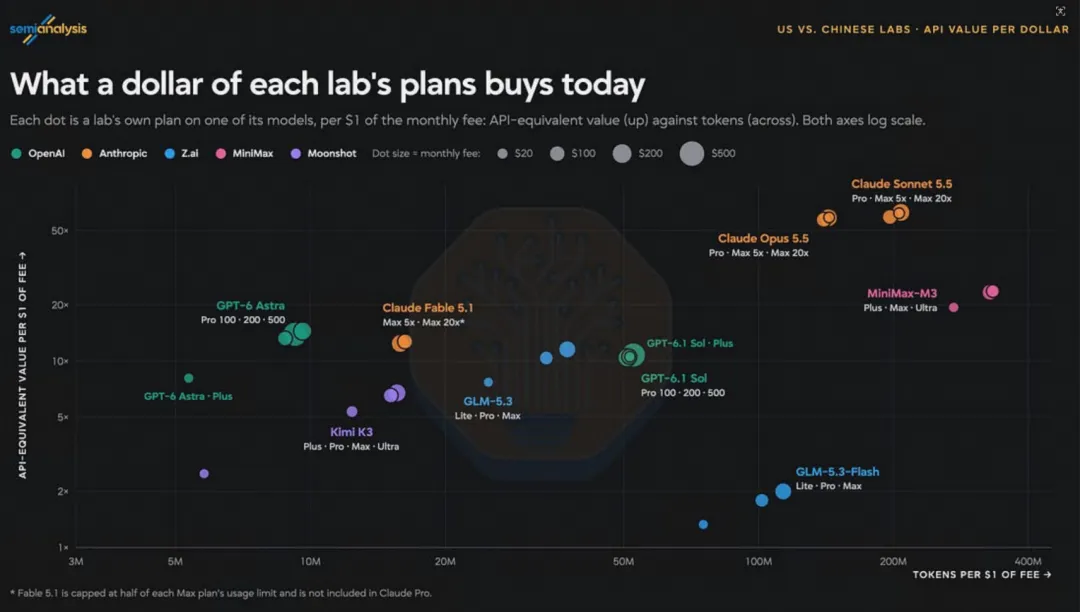
图 3:横轴为Coding Plan 每 $ Token量相较于API价格的倍数,纵轴为每 $ 可使用的Token数量,两轴均为对数刻度;点大小表示月费。它比较额度,不包含模型任务成功率。
图中的 GLM-5.3-Flash,位置偏右,但纵轴不高。这意味着按原文负载,它每美元给的 token 很多,但这些 token 的 官方API 单价相对低。
不能因为纵轴更低,就直接断言某个模型“不划算”。
SemiAnalysis 同时观察到,其测试的国内套餐在更高档位上,单位月费获得的折算额度通常更高;但不同模型差别很大。
对工程团队而言,真正的问题仍然是:在满足质量要求的任务上,你能否稳定用到这些额度。如果一个模型的 API 本来便宜,订阅相对 API 的优惠倍数小,直接使用API并不妨碍它在你的任务里总成本更低。
https://newsletter.semianalysis.com/p/anthropic-subscriptions-offer-5x