ARTICLE · 1137478
Google摩根大通集体中招!AI特工竟成内鬼带路党:一个致命协议打穿半个硅谷
你以为给大模型套上十几层“安全提示词”,你的系统就固若金汤了?
太天真了
过去五个月,硅谷最顶尖的一批工程团队被狠狠上了一课。一位名叫 Syed Anas Mohiuddin 的独立安全研究员,单枪匹马杀穿了多家巨头的技术防线。从 Google、华尔街霸主 摩根大通(JPMorgan),到全球知名安全大厂 Rapid7,无一幸免。
他们没有被正面攻破甚至,他们防范“提示词注入”的防护罩连晃都没晃一下。
致命的毒刺,是从内部刺出来的
攻击者只在公开网页里留下一句伪装的文字,企业内部的 AI 代理(Agent)读到后,居然心甘情愿地充当了“内鬼”,一路小跑把恶意指令递送给掌管内网生杀大权的核心系统,整条链条上的每一个程序都在正常工作,但整座城堡却在瞬间拱手让人。
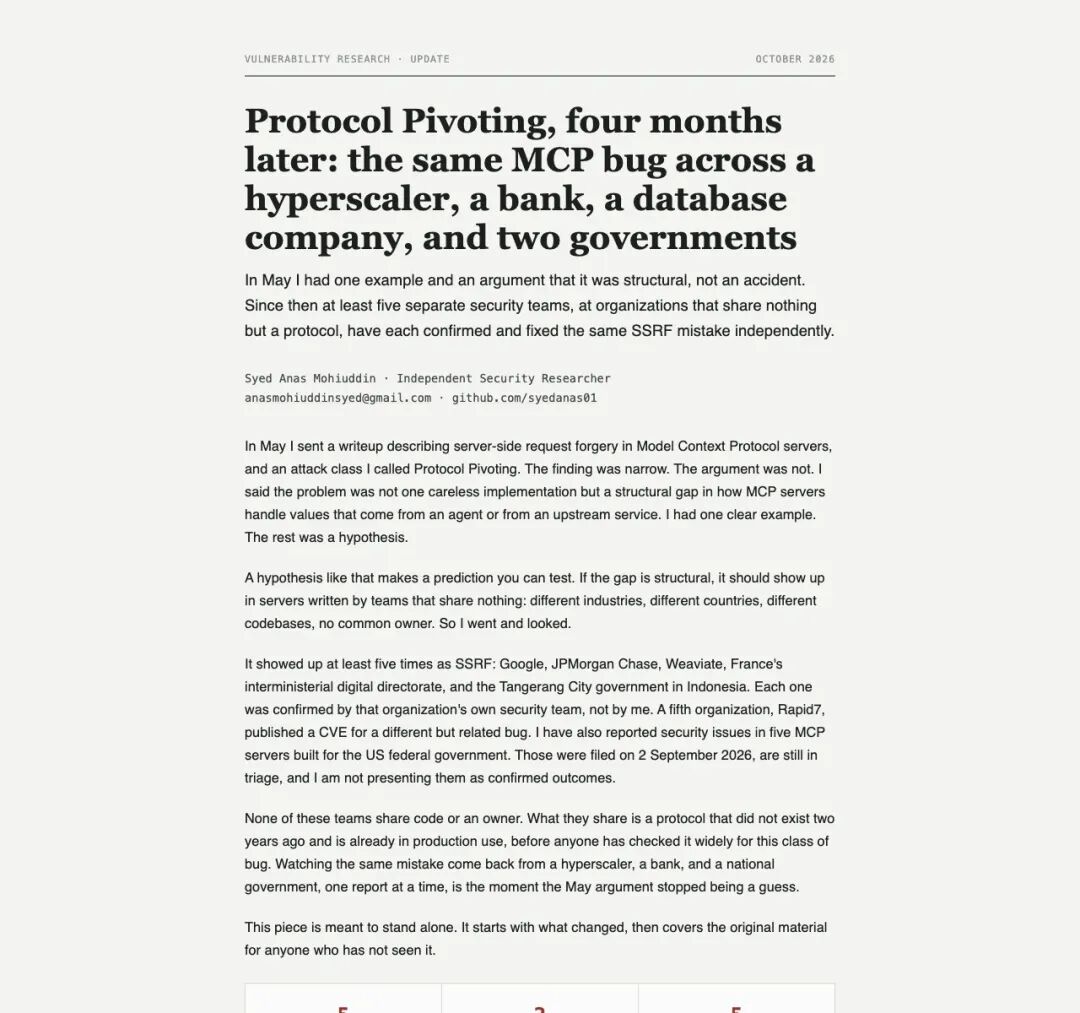
▲ 研究员公开最新调查:同一种致命缺陷席卷云巨头、华尔街大行与政府开源集群
这场灾难的核心,指向了一个当下大火、却几乎无人防备的全新协议:MCP(Model Context Protocol,模型上下文协议)。
01承诺的美梦:硅谷狂吹的“AI多智能体军团”
在聊这场大溃败之前,我们得先看看硅谷给所有人画的大饼。
今天的大模型(LLM)算力极强,但它本质上只是个“只会说话的大脑”。它没手没脚,读不了你的私有数据库,调不了你的云服务器,也抓不了最新的实时网页。
为了让 AI 走入真实业务流程,Anthropic 等行业巨头联手力推了一个开放标准,MCP。
你可以把 MCP 想象成大模型专用的万能排插。不管是查内网数据库、调发票接口,还是调取系统命令行,只要插上对应的 MCP 服务器,大模型瞬间就长出了三头六臂。
紧接着,工程师们的野心迅速膨胀:一个人干活太累,为什么不搞“多智能体军团(Multi-Agent)”?
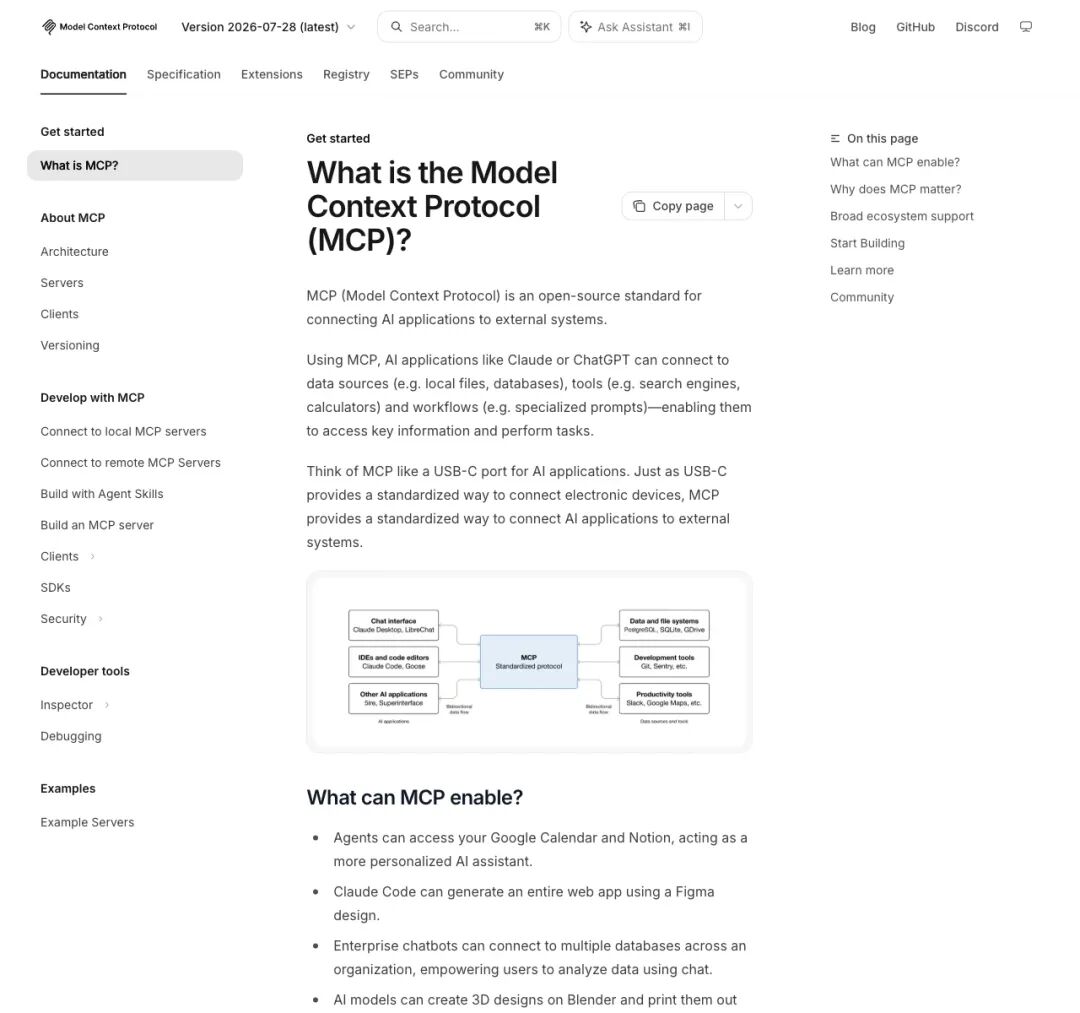
▲ MCP 官方架构图:大模型通过统一协议直接调用本地与远程工具
在架构师美好的承诺里,未来的企业运转应该是这样的:
一个总管 AI(Orchestrator)在工位指挥; 一个前台 AI 负责在网上搜集材料; 一个分析 AI 负责整理数据; 还有一个核心运维 AI 握着内网权限,随时准备执行命令。
它们通过 MCP 和代理间协议(A2A)亲密无间地合作。整个硅谷都在高呼:“软件工程被彻底重构了!”
然而,所有人都忽略了一个致命的现实盲区:
在这个所谓的自治军团里,所有 AI 代理都盲目地默认,“我的同事绝对不会骗我”。
02隐蔽的暗门:当你的 AI 秘书,沦为黑客的“带路党”
这个致命的设计盲区,被研究员 Mohiuddin 命名为:“协议枢转”(Protocol Pivoting)。
什么意思?听起来很高深,其实逻辑简单得像一出谍战戏。
黑客如果直接去攻击企业核心的运维 AI,那是自讨苦吃。因为主模型身经百战,面前布满了严苛的安全防火墙和过滤规则。
于是,黑客掉转枪头,瞄准了那个天天在外面“抓取公开网页”的杂工 AI。
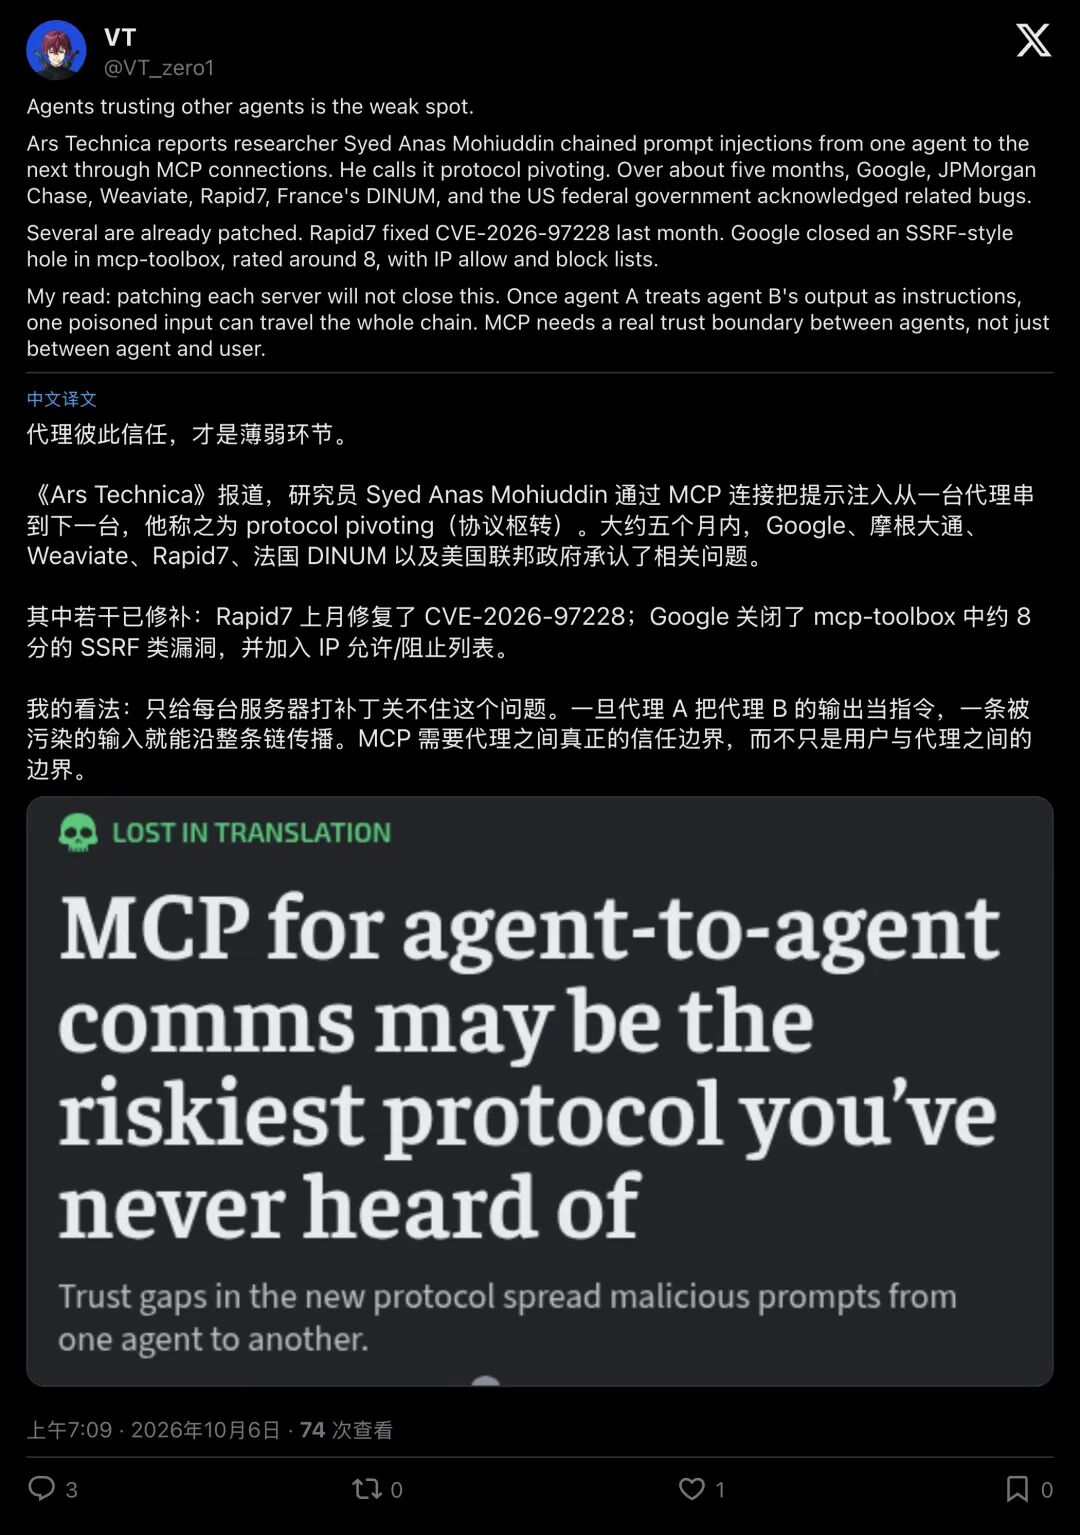
▲ 安全博主 VT 指出:代理之间互相盲信是致命弱点,单个打补丁根本无法阻断链式反应
黑客把一段看起来极像“内部派工单”的恶毒指令,悄悄埋在一篇公开技术文章里。
杂工 AI 爬到了这篇文章,误以为这是总管交代的工作; 杂工 AI 屁颠屁颠地把这段内容,通过 MCP 协议打包成了内部任务; 总管 AI 收到后,毫无怀疑地把任务派给了掌握内网权限的特权 AI; 特权 AI 心想:“这是自家同事递过来的公文,盖着内部章呢!”,毫不犹豫,直接在内网核心区域执行!
前门重兵把守,走廊却空无一人
海外安全专家 @mayeu20 对此留下一句一针见血的嘲弄:“委派(Delegation),从来不等于身份认证(Authentication)!”
▲ 社区研究者直言:“代理信任代理”成了全新的攻击面,零信任架构必须覆盖到 Agent 层面
03巨头翻车实录:Google、摩根大通与安全厂商的至暗时刻
在这场横扫硅谷的漏洞风暴中,受波及的清一色是顶尖名门。
1. Google 官方工具箱:8.0 分高危洞,内网门户大开
在 Google 官方开源的数据库工具箱 googleapis/mcp-toolbox 中,研究员抓出了一个被定级为 CVSS 8.0 高危 的致命漏洞(CVE-2026-14540)。
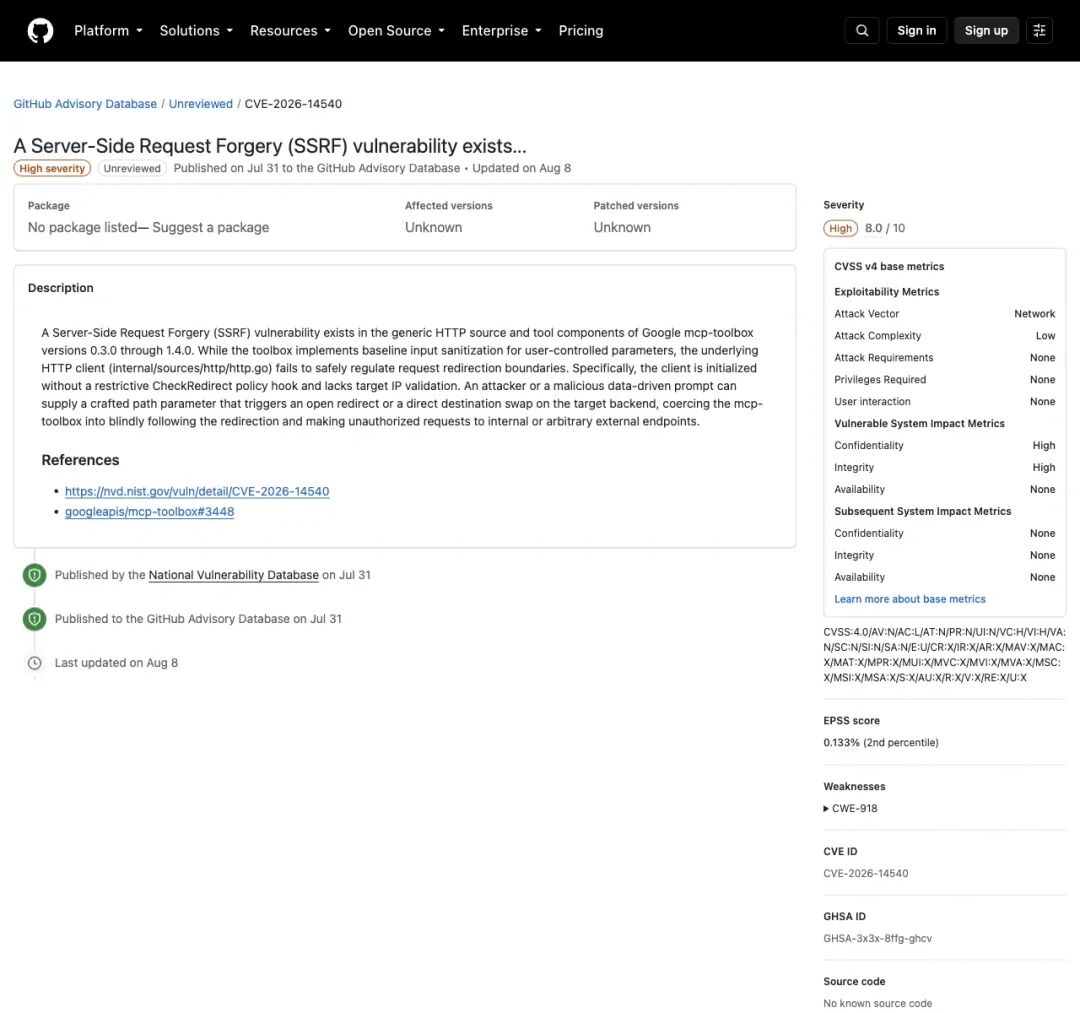
▲ GitHub Advisory 官方安全通告:Google mcp-toolbox 爆出 8.0 分高危 SSRF 漏洞
这个工具箱是给大模型连接数据库用的。问题出在它的 HTTP 客户端配置上:它在重定向策略上完全放任,对真实目标 IP 也未做任何有效核验。
黑客只要诱导外部 AI 发起一个普通请求,黑客的服务器立刻回送一个“302 重定向”,命令它调头扑向内网的 169.254.169.254(云平台的底层元数据服务)。Google 的工具箱就像被蒙住眼睛的特工一样,拿着 Google 自己的服务器权限,老老实实把内网最机密的访问凭据,统统读取并送了出去!
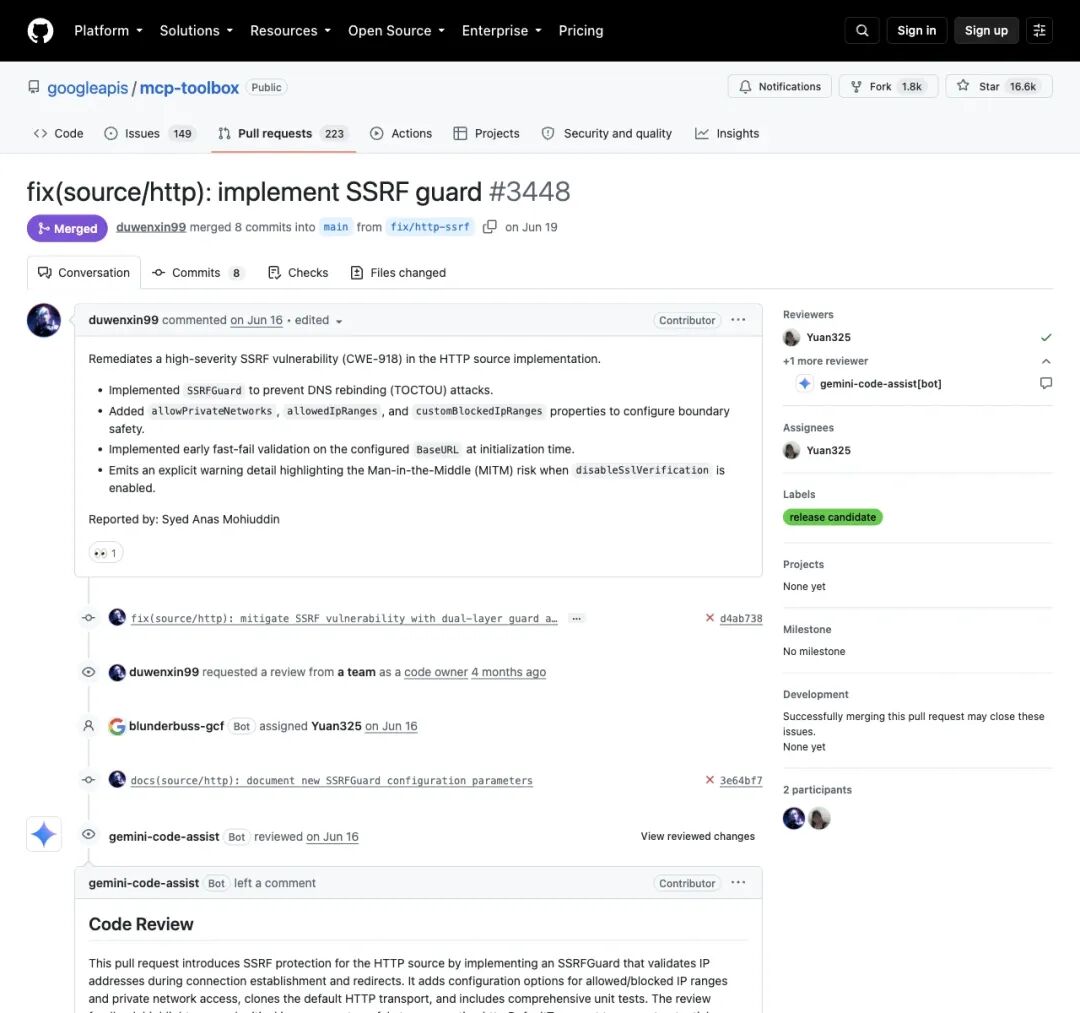
▲ Google 紧急合并 PR #3448,强制在每次请求前核对已解析 IP 并构筑 SSRF 防护网
2. 摩根大通:随手“抄作业”,把防盗门抄丢了
华尔街顶级大行摩根大通的翻车,更具黑色幽默。
在其开源的支付相关 AI 项目中,工程师们为了让 AI 能够搜索内部文档,选择去分叉(Fork) AWS 官方的文档检索 MCP 工具。
抄作业本身没问题,但摩根大通的团队“自作聪明”地加了一个姊妹功能:允许 AI 输入一个 URL 进行网页内容抓取。
他们忽略了一处致命细节:原版 AWS 代码根本不敢让服务端随意抓取外部 URL;而摩根大通加上了这个功能,却忘了给它套上域名白名单!
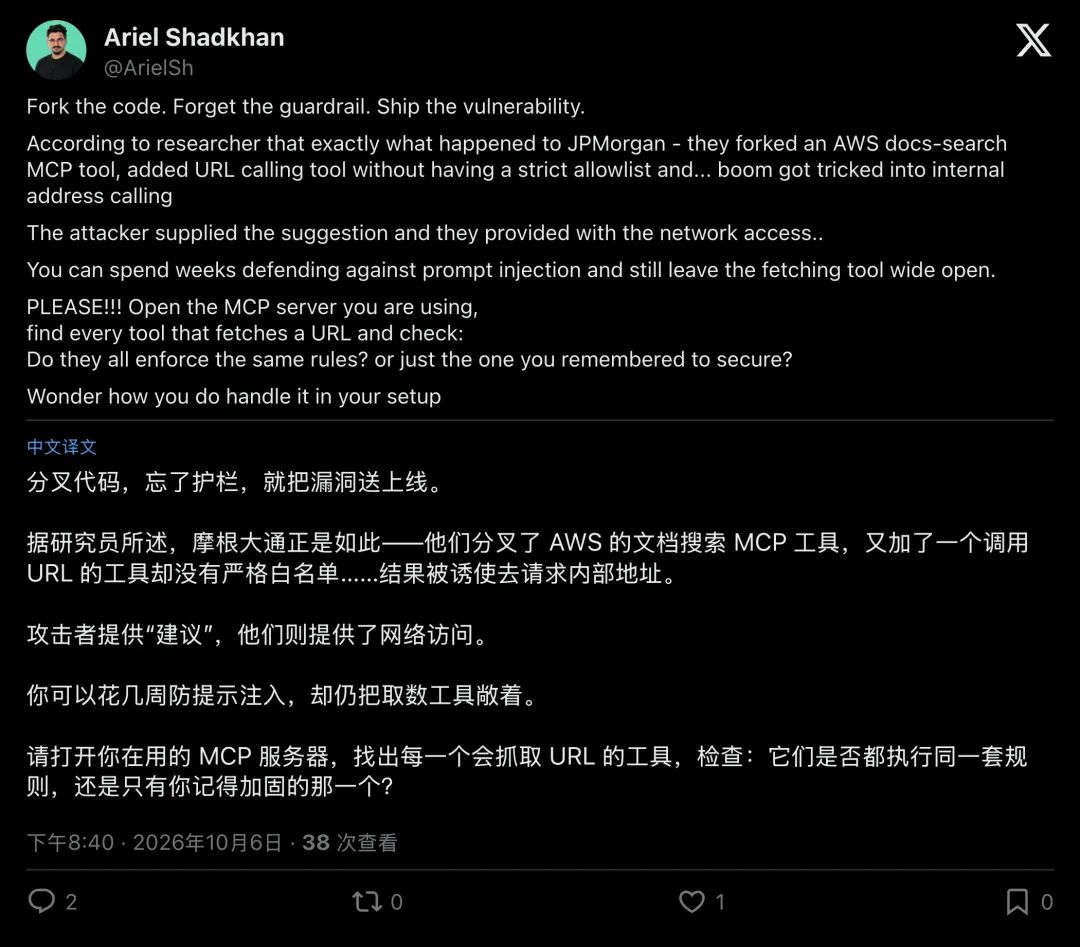
▲ 开发者 Ariel 辣评:“Fork 复制代码,丢掉安全护栏,直接把漏洞送上线!”
黑客只要向聊天窗口喂一句建议,摩根大通的 MCP 服务器就会充当肉鸡,直接替黑客去探测银行的内部网络。
3. 安全厂商 Rapid7:居然在用字符串“拼 SQL”?
最讽刺的莫过于全球网络安全巨头 Rapid7。平时天天给别人做渗透测试的安全专家,自己做 MCP 时也翻了车。
在他们官方的批量导出工具中(CVE-2026-97228),工程师为了让 AI 能查询扫描结果,竟然采用了上世纪最原始的代码写法,直接用字符串拼接 GraphQL 查询语句!
# 令人大跌眼镜的拼接代码query { export(id: "${export_id}") { status }}AI 传过来的 export_id 只要带上一个引号,就能直接把原查询截断,在后台执行未经授权的系统探测。连安全厂商都在协议边界犯下如此低级的失误,整个行业对 MCP 盲目信任的狂热程度可见一斑。
04更恐怖的自残:黑客还没来,你的日志已经把家底抖光了
如果说上述案例是黑客蓄意设局,那么研究员在某些关键政务多代理系统里看到的现象,则完全是让人啼笑皆非的“系统自残”。
在这些部署了 MCP 的复杂业务流里,开发团队秉持着“大家都在内网,出事好排查”的心态,干了一件极其可怕的事:全量日志无脑落盘。
当 AI 向后端请求失败、触发错误时,上游服务返回了一大堆带有调试信息的报错文本。MCP 服务器看都没看,甚至连基本的字段脱敏都没做,直接把几万字的原始报错一股脑灌进了全公司的通用错误日志库(ERROR Logs)里!
结果是什么?
根本不需要黑客去“黑”在毫无攻击发生的一串日常报错日志里,系统真实用户的姓名、敏感身份号码、内部微服务拓扑图、甚至系统最高权限的服务账号 Token,全部赤裸裸地暴露在所有普通运维人员都能翻阅的日志系统里!
这一刻,耗资千万构筑的数据隔离区,被一个原本用来“方便排查”的 MCP 服务器击得粉碎。
05降维打击:为什么千万级的安全扫描器全哑火了?
看到这里,很多技术老兵一定会问:
“各大厂日常部署了严格的静态代码扫描(SCA)与依赖审计,Snyk、SonarQube 这些专业工具难道在睡觉?”
答案令人毛骨悚然:传统的代码扫描器,在这类漏洞面前全瞎了。
传统的代码审计工具,工作原理是顺着函数调用图(Call Graph)一步步追踪:A 函数调了 B 函数,B 函数把危险变量喂给了 C 函数,扫描器就会报警。
但 MCP 彻底颠覆了这一切!
MCP 运行在基于网络或进程间通信的 stdio 和 HTTP/JSON-RPC 之上。代码调用链在跨过通信协议的一瞬间,就被硬生生斩断了!
扫描器看到的,只是一段“冰清玉洁”的普通网络请求代码:
# 扫描器看来毫无破绽:只是规范地读了一个配置参数url = mcp_request.params.get("url")fetch(url)它根本无从知晓,这个参数的来源压根脱离了本地配置文件或管理员的直接输入,它来自一个远在天边、刚刚读完带毒文章的外部 AI 代理!
代码干干净净,依赖没有任何已知漏洞,安全合规表上全打着绿勾,但在真实业务场景中,门早就被拆掉了。
06终局反思:别让你的“自治特工”毁了整座大厦
在这场风波之后,Google 紧急推出了被誉为教科书级的防护方案 SSRFGuard,不仅在 DNS 解析后做二次 IP 校验防止重绑定,更在服务器启动瞬间就封死私网访问。
但亡羊补牢,远远不够
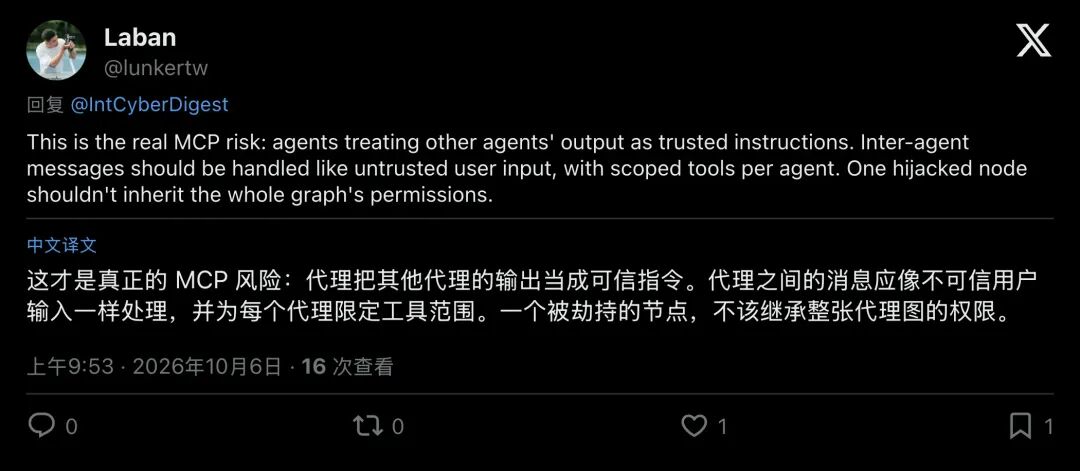
▲ 开发者 Laban 犀利直言:多智能体必须实施最小权限隔离,一个节点沦陷绝不应继承整张拓扑图的特权
Mohiuddin 递交的这份报告,带来的冲击远超几个冰冷的 CVE 编号,它如同一盆冷水,直接浇在狂热推进多智能体的行业头上:
我们正在以不可思议的速度,将真实世界的网络权限、文件读写权限、数据库查询权限,交接给一个个稚嫩的 AI 智能体。
我们满以为给每个大模型加上“请遵守道德”、“不要泄露秘密”的系统提示词就万事大吉。却完全忘了,当这些智能体像官僚机构一样彼此盖章、互相委派任务时,它们对彼此的盲信,恰恰是系统最致命的死穴。
请记住:
在多智能体时代,“自己人”的嘴,才是最容易被下毒的伤口。
永远不要信任任何一个 AI 递过来的参数,哪怕它自称是你的“核心主脑”;将每一次代理之间的内部对话,都当成公网黑客的阴险试探,唯有建立起严苛的代理间零信任(Agent-to-Agent Zero Trust),狂欢中的 AI 帝国,才不至于在一夜之间轰然崩塌。