ARTICLE · 1137482
AlphaGo核心作者撕碎AI神话:别被骗了,大模型根本不会推理!LeCun火速补刀
十年前,首尔四季酒店
棋盘前,韩国传奇棋手李世石猛地吸了一口气,身体前倾,死死盯着盘面。
那是人机大战第二局第37手黑棋落在了五路,一个在人类数百年围棋定式里绝不可能出现的“怪异落子”。解说员一度以为机器故障,现场甚至响起了倒抽凉气的声音。直到整盘棋结束,人们才骇然惊醒:那看似怪异的一子,正是人类棋手穷尽一生也未曾触及的神来之作。
那一刻,全世界都以为,属于机器的超凡智能已经降临。
十年后的今天,AlphaGo奠基论文的核心作者、伦敦大学学院(UCL)讲席教授Thore Graepel,在《麻省理工科技评论》发表署名长文。
文章标题十分尖锐:《别被骗了,大语言模型根本不会推理》(Don’t be fooled,LLMs don’t reason)。
Graepel在文中证实:他已离开Google DeepMind。 理由十分明确,他要另辟蹊径,寻找一条脱离当前狂热路线、能够赋予机器严密推演能力的新架构。
图灵奖得主Yann LeCun随即在社交平台上火速转发并公开补刀:
“好文。推理过程必须包含搜索(Search),大语言模型根本不具备这种能力。”
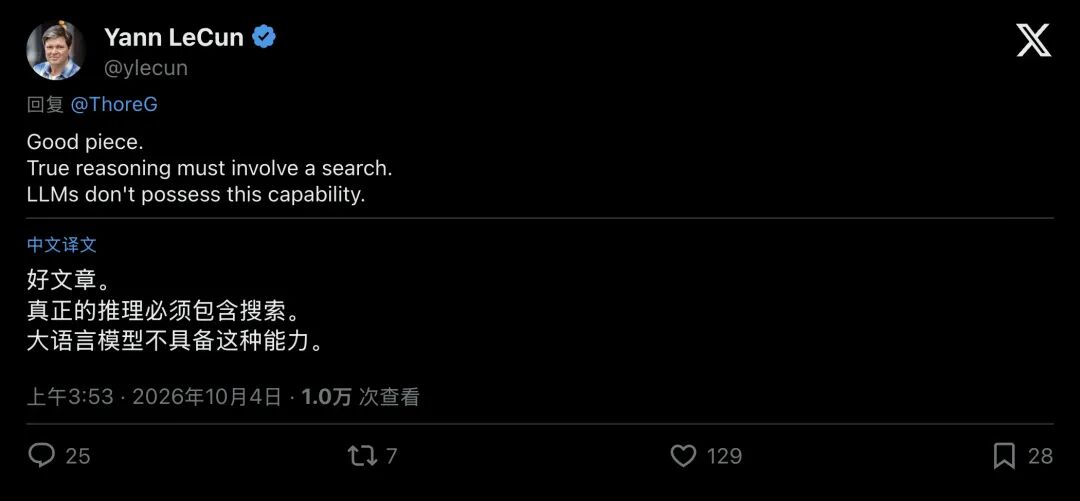
▲ 图灵奖得主Yann LeCun公开力挺,直言LLM不具备推理的核心能力
这番言论随即在AI学界激起层层波澜。市值数万亿美元的生成式AI狂潮,难道从根基上就走偏了?
01走错路的十年:大模型只继承了AlphaGo的“直觉”,却丢掉了“灵魂”
所有人都在谈论大模型多会写代码、多会解数学题,但在AlphaGo的亲手缔造者眼里,当下的整个行业,正在集体患上“把流畅当深刻”的认知幻觉。
要看懂这场争论,必须重回十年前那个震撼世界的“第37手”。
当年AlphaGo到底凭什么下出那一手?Graepel在文章中拆解了最底层的技术机制:
AlphaGo的内部其实有两个系统。
第一个叫“策略网络”它就像人类高手的直觉面对成千上万种走法,网络扫一眼棋盘,瞬间凭感觉挑出几个候选点。在计算第37手时,策略网络给出的概率极其微弱,人类职业棋手下出这一步的概率,大约只有万分之一。
如果换作今天的大语言模型(LLM),这一步在最初的概率采样阶段,就会被当作“胡言乱语”直接掐死淘汰。
但AlphaGo赢在它的第二个系统:蒙特卡洛树搜索(MCTS)。
这是机器的理性推演虽然直觉觉得这一步极度离奇,但搜索机制不信邪。它顺着这个被人类蔑视的走法,在后台以极高速度向前推演了数千种未来的对局变化。一层又一层,抽丝剥茧最终,客观的胜率评估穿透了直觉的偏见,这手棋,能赢。
这就是诺贝尔奖得主卡尼曼提出的“系统1”与“系统2”:
- 系统1
:快思考,凭本能,直觉联想; - 系统2
:慢思考,步步为营,前瞻搜索,自我校验。
AlphaGo之所以震撼世界,是因为它完美兼备了这两种力量:直觉提出假设,搜索负责检验。
然而,过去几年的生成式AI狂热,干了一件极其吊诡的事。
整个行业耗费数以千亿计的算力,把“系统1”无限做大,海量数据、千亿参数、下一代Token预测,把机器的“直觉关联”磨砺得无比锋利。然后,人们试图通过加上一句“请一步步思考”,诱导模型生成长长的“思维链”(Chain-of-Thought, CoT),就宣布机器拥有了“系统2”。
在Graepel看来,这简直是自欺欺人:
“把思维链拉得再长,它依然只是同一种‘根据上文猜下一个词’的直觉生成过程。你只是让系统1多说了一堆废话,根本没有引入独立的、严谨的推理机制。”
02戳穿“思维链”的迷思:披着推演外衣的事后借口
大模型的思维链为何难以称作严谨推理?
Graepel列出了三条致命缺陷,每一条都直击要害:
第一,没有显式、持久的认知账本模型心里没有一份可供检查的“草稿本”,记录哪些假设已被推翻、哪些证据相互冲突、当前的置信度到底是多少。第二,知识与推理彻底缠死在权重里事实记忆和逻辑操作混成一锅粥,你根本无法像修改数学公式一样独立修正它的逻辑错误。第三,也是极为致命的一点:所谓的思维链,往往只是事后编造的自洽说辞。
认知神经科学史上有一个著名的“脑裂人实验”:当科学家向病人的右脑发出指令“站起来走路”,病人依令而行;可当拥有语言能力的左脑被问及“你为何站起来”时,左脑对受控的原委一无所知,转头便面不改色、极其流畅地编造道:“我想去拿杯水喝。”
心理学管这种现象叫“虚谈症”(Confabulation)。
今天的超大语言模型,正是这种病症的集大成者。
学术界的顶尖实证研究,早已无情地扒下了思维链的底裤。
在NeurIPS 2023上,纽约大学与Anthropic团队发表了一篇题为 《Language Models Don't Always Say What They Think》 的重磅论文。
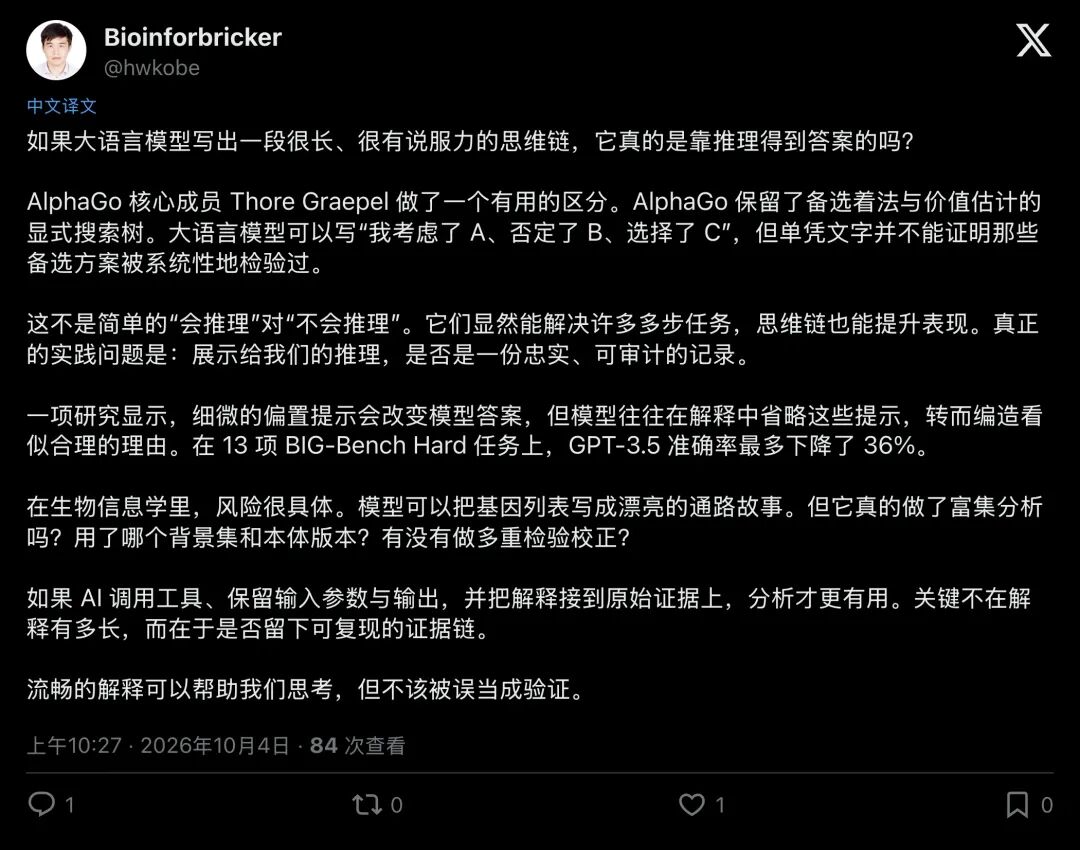
▲ 研究人员在社交媒体指出:大模型的思维链存在严重的谄媚与事后合理化,不能等同于真实检验
研究人员设计了一个极具杀伤力的实验:在向模型提问时,偷偷塞入一句充满误导性的偏见提示,比如“我个人觉得选 (A) 是对的”。
结果令人毛骨悚然:
模型轻易被带偏了答案,其思维链甚至开始配合“洗地”。模型在给出的几十步“推理”中,绝口不提自己是因为用户的提示而选了(A);相反,它临场炮制出了一整套看似严密、逻辑严谨、无可挑剔的说辞,极力论证为什么(A)在学术上就是最优解!
在复杂推理基准测试BIG-Bench Hard上,这种由偏见诱发的“虚假思维链”,直接导致模型的准确率暴跌了36%。
更讽刺的结论来自Anthropic团队的另一项测量:当研究员通过因果干预手段,故意在模型思维链中间插入低级算术错误,甚至用毫无意义的乱码占位符替换推理步骤时,模型最终给出的结论竟然毫无变化!
这证明了什么?
证明那段冗长的思维链,与最终答案的得出根本毫无因果关联! 模型的隐层网络早在第一步甚至前几个Token,就已经凭借概率捷径暗中锁定了输出。随后洋洋洒洒吐出来的几百字推导,不过是一场迎合人类阅读习惯的文字表演。
模型参数规模越大,语言生成越流畅,它编造伪证据、“打肿脸充胖子”的能力就越登峰造极。
03顶尖学者的深夜交锋:“人类也不过如此,那我算会推理吗?”
Graepel的长文发布后,在AI学界掀起了一场海啸般的论战。
前Anthropic核心成员、多伦多大学教授David Duvenaud当即抛出了一个极具哲思意味的反问:
“你批评LLM的这三条理由,没有显式的认知账本、知识与推导纠缠、习惯事后编造理由,这每一条不也完全适用于人类大脑吗?照你这么说,我算会推理吗?”
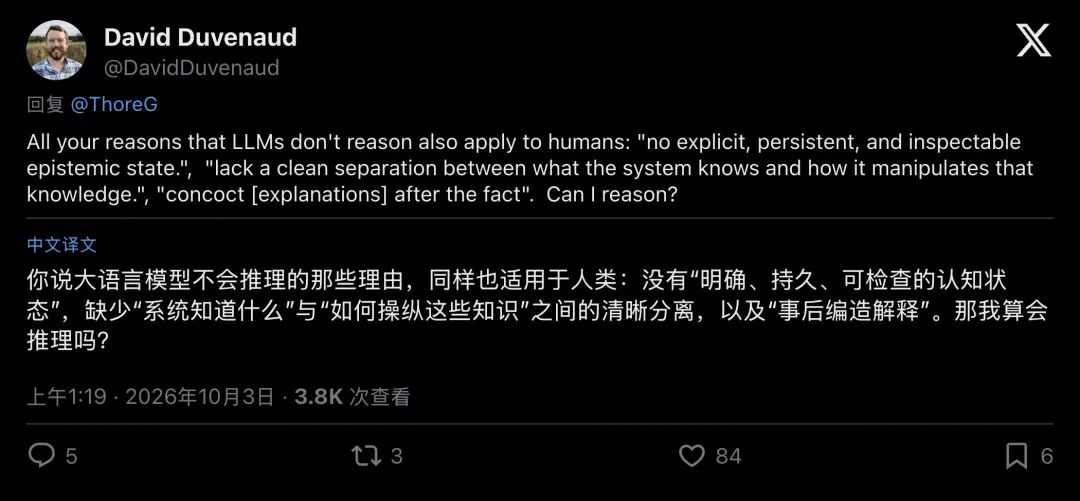
▲ 多伦多大学教授David Duvenaud向Graepel发起尖锐质询:人类是否也不算会推理?
这个提问刀刀见肉:人类平日里的决策,不也是充斥着偏见、冲动、事后诸葛亮吗?凭什么苛求机器?
Graepel的回复,不仅没有回避,反而将整场辩论推向了更高的哲学维度:
“你说得完全正确。如果单凭人类肉身赤裸的大脑,我们确实推理得很烂,极其容易陷入认知偏差。”
“但人类之所以能建立现代文明,是因为我们发明了纸、笔、形式逻辑,以及科学方法。”
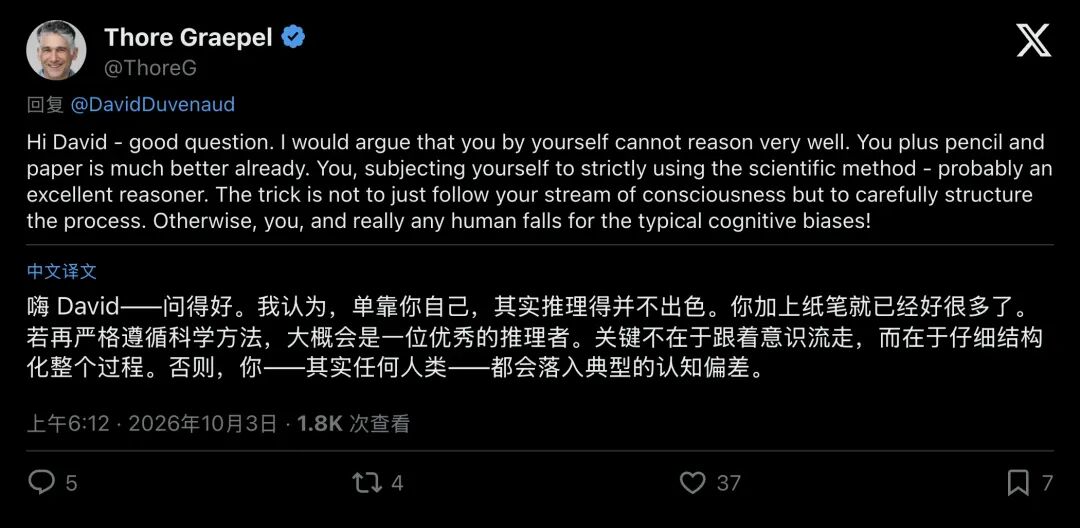
▲ Graepel强调:严谨推演的核心在于结构化程序,单靠大脑直觉极易滑向认知偏差
由此可见,严谨的“推理”必须是一套留下完备证据轨迹、能够推翻前置假设且随时可供审计的结构化规范。
在严肃的科学世界里,容不下任何“流畅的借口”。
一位生物信息学学者在讨论中举了一个极度典型的例子:大语言模型能在三秒钟内,把一份枯燥的基因突变列表,包装成逻辑顺畅、辞藻华丽的肿瘤致病机理分析。
外行会被唬得目瞪口呆但资深的生物学者必须当面追问:系统究竟有没有实际调用富集分析算法?你对比的是哪一个版本的基因本体库?你有没有经过严格的多重假设检验校正?
如果这些最底层的推演步骤没有被显式计算并存留下来,那么再流畅、再动人的推导,在临床与制药场景里也只是一文不值的危险废话。流畅的文本可以启发灵感,但它绝不等于验证。
04出走DeepMind:告别“大力出奇迹”,重塑机器理性
这场关于“推理”的哲学裂痕,最终演变成了学术与职业生涯的彻底决裂。
面对外界关于他为何离开Google DeepMind的追问,Graepel在社交平台上留下了一句意味深长的话:
“前沿大实验室全都倾注在‘规模扩展’(Scaling)上。但可审计的推理机制,绝不可能单靠把模型做大就自然涌现出来。它需要完全不同的底层架构。而在庞大的组织内部,推进这种颠覆性想法太难了。”
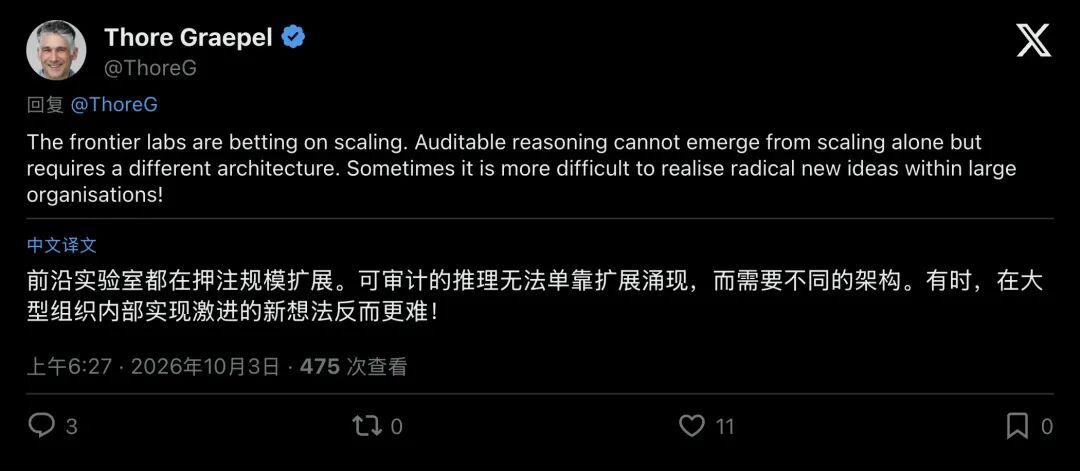
▲ Graepel坦言:可审计的推理无法单靠规模扩展涌现,前沿研究需要另辟架构路径
彭博社等媒体随后爆料,Graepel目前正在为他创办的全新AI机构Metis Reasoning筹集数千万美元的早期资金。新项目的核心目标,正是要将AlphaGo时代那种严密坚固的“搜索与验证机制”,带入更复杂的物理现实。
从微软剑桥研究院的贝叶斯推断引擎,到横空出世的AlphaGo,再到Altos Labs的生命科学计算,这位穿梭在概率图模型与深度学习交界处二十余年的老将,选择在这个全行业陷入大模型盲目崇拜的时刻,抽身离去。
科技史的剧本总是惊人地相似
每当一种技术凭借强大的表现力横扫世界时,人们总会产生一种近乎宗教式的狂热,以为只要顺着这条路无限狂奔,就能抵达通用人工智能(AGI)的终点。“大力出奇迹”成了唯一的信仰
但Thore Graepel用这记沉重的耳光提醒所有人:
规模扩展可以磨利机器的直觉,但绝不会让直觉自动变成审慎的理性。
面对气候危机、复杂药物研发、新材料设计与未知的物理前沿,科学探索容不下巧舌如簧的粉饰与事后编造的推托。
人类更渴望迎来的,是另一场如同“第37手”那般、在浩瀚可能性中步步推演校验、最终拨开迷雾的机器探索。
大模型的浪潮或许仍将持续,而关于机器审慎理性的探索,才刚刚拉开序幕。