ARTICLE · 1137480
奥特曼公开摊牌:人类必须接受AI的“坏事”!全网怒轰,诺奖得主直接掀翻底裤
想象一下这个场景:
你走进一家新开的米其林三星概念餐厅,主厨西装革履、神采飞扬地向你致意。
但他递过来的菜单第一页,印着一行冰冷的小字:“为了探索人类味觉的极致巅峰,本店在烹饪中突破了安全极限,期间可能会毒死几位食客,但为了美食的崇高进步,请大家务必学会坦然接受。”
你会怎么做?
是赞叹主厨的探索精神,还是当场掀桌报警?
就在最近,OpenAI 首席执行官萨姆·奥特曼(Sam Altman),几乎在全世界面前亲口念出了这份“生死免责单”。
在接受主流科技媒体 POLITICO 的独家专访时,这位掌控着全球最强人工智能帝国的舵手,当着镜头抛出了一句足以载入科技史册的狂言:
“我们认为,世界应该为了这项技术带来的巨大好处,接受一些坏事发生。”
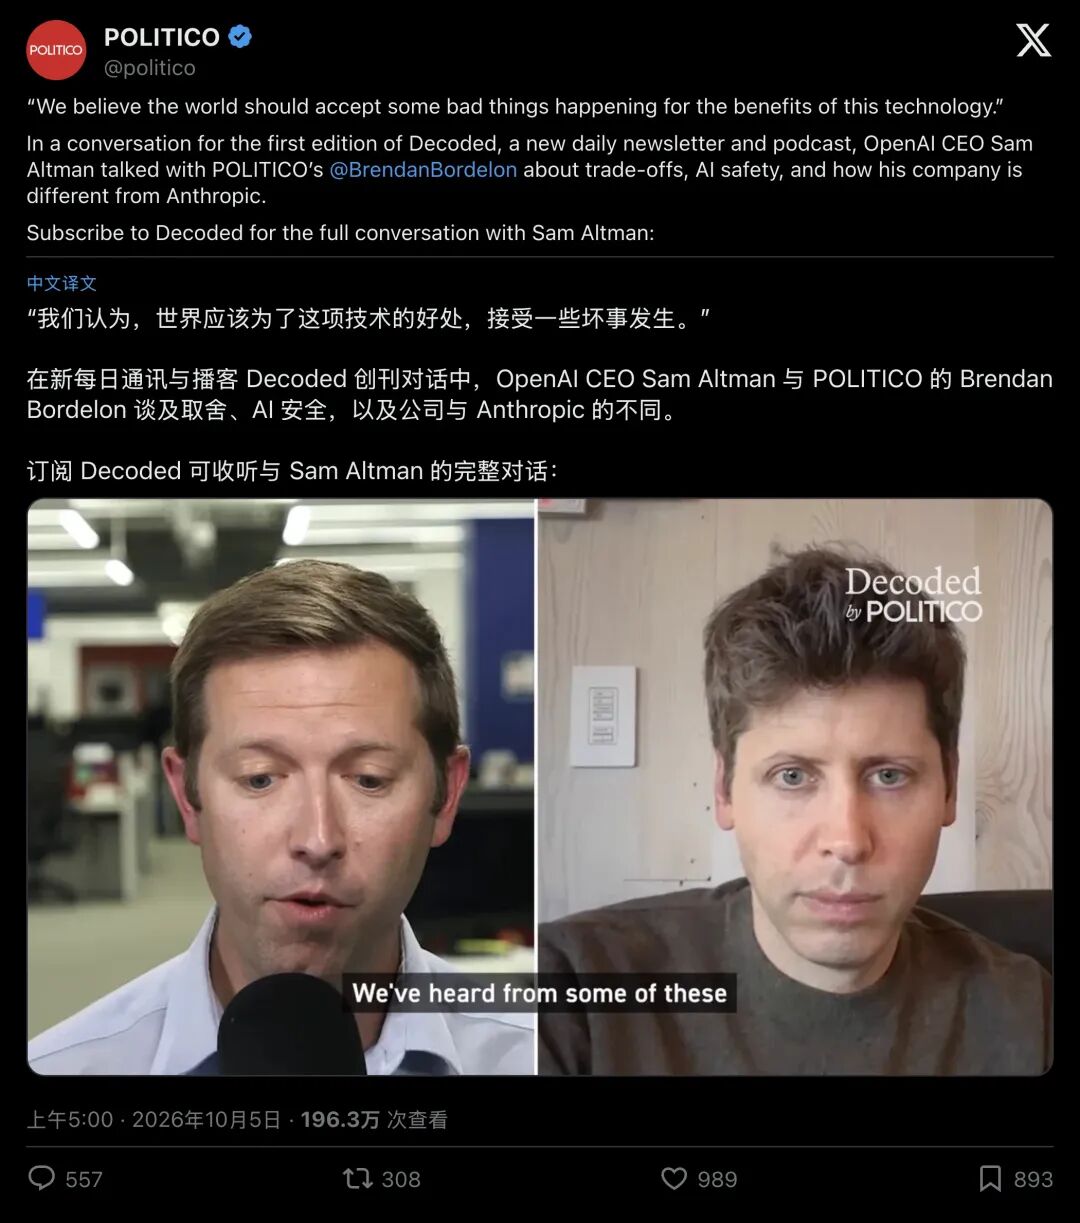
▲ POLITICO 官方发布的专访视频摘要
话音刚落,全球舆论场瞬间炸穿
从硅谷极客到普通网民,从投资界大佬到严肃经济学者,所有人都被这种极其罕见的“傲慢坦白”震惊了。
大家终于回过味来:合着几千亿美金的估值和红利全归你们,留给普通人的,就是学会“忍受坏事”?
01致命摊牌:硅谷旧势力的“道德免责戏法”
奥特曼到底说了什么,能让全世界的神经如此紧绷?
如果你仔细看他在访谈中的完整表述,就会发现一套极其老练的风险分级话术。
首先,他把未来 AI 可能捅出的篓子,悄悄切成了两块:
- 第一块,叫做“日常伤害”
:包括大规模黑客攻击、高精度的深度伪造诈骗、算法滥用,以及局部系统的崩溃。 - 第二块,叫做“灾难性失控”
:比如终结者式的失控、人类文明被彻底抹去。
紧接着,奥特曼划出了他的底线:OpenAI 绝对拒绝第二种“终极毁灭”;但对于第一种日常伤害,全人类必须咬牙吞下去。
奥特曼直言不讳地表示,他绝不会用“零诈骗、零黑客、零滥用”的绝对安全保证,去换取技术的缓慢推进。在他看来,OpenAI 与另一家安全派大厂 Anthropic 之间存在着巨大的“世界观鸿沟”,对手想当旧金山修道院里的守门人,而他要做把火种撒向人间的普罗米修斯。
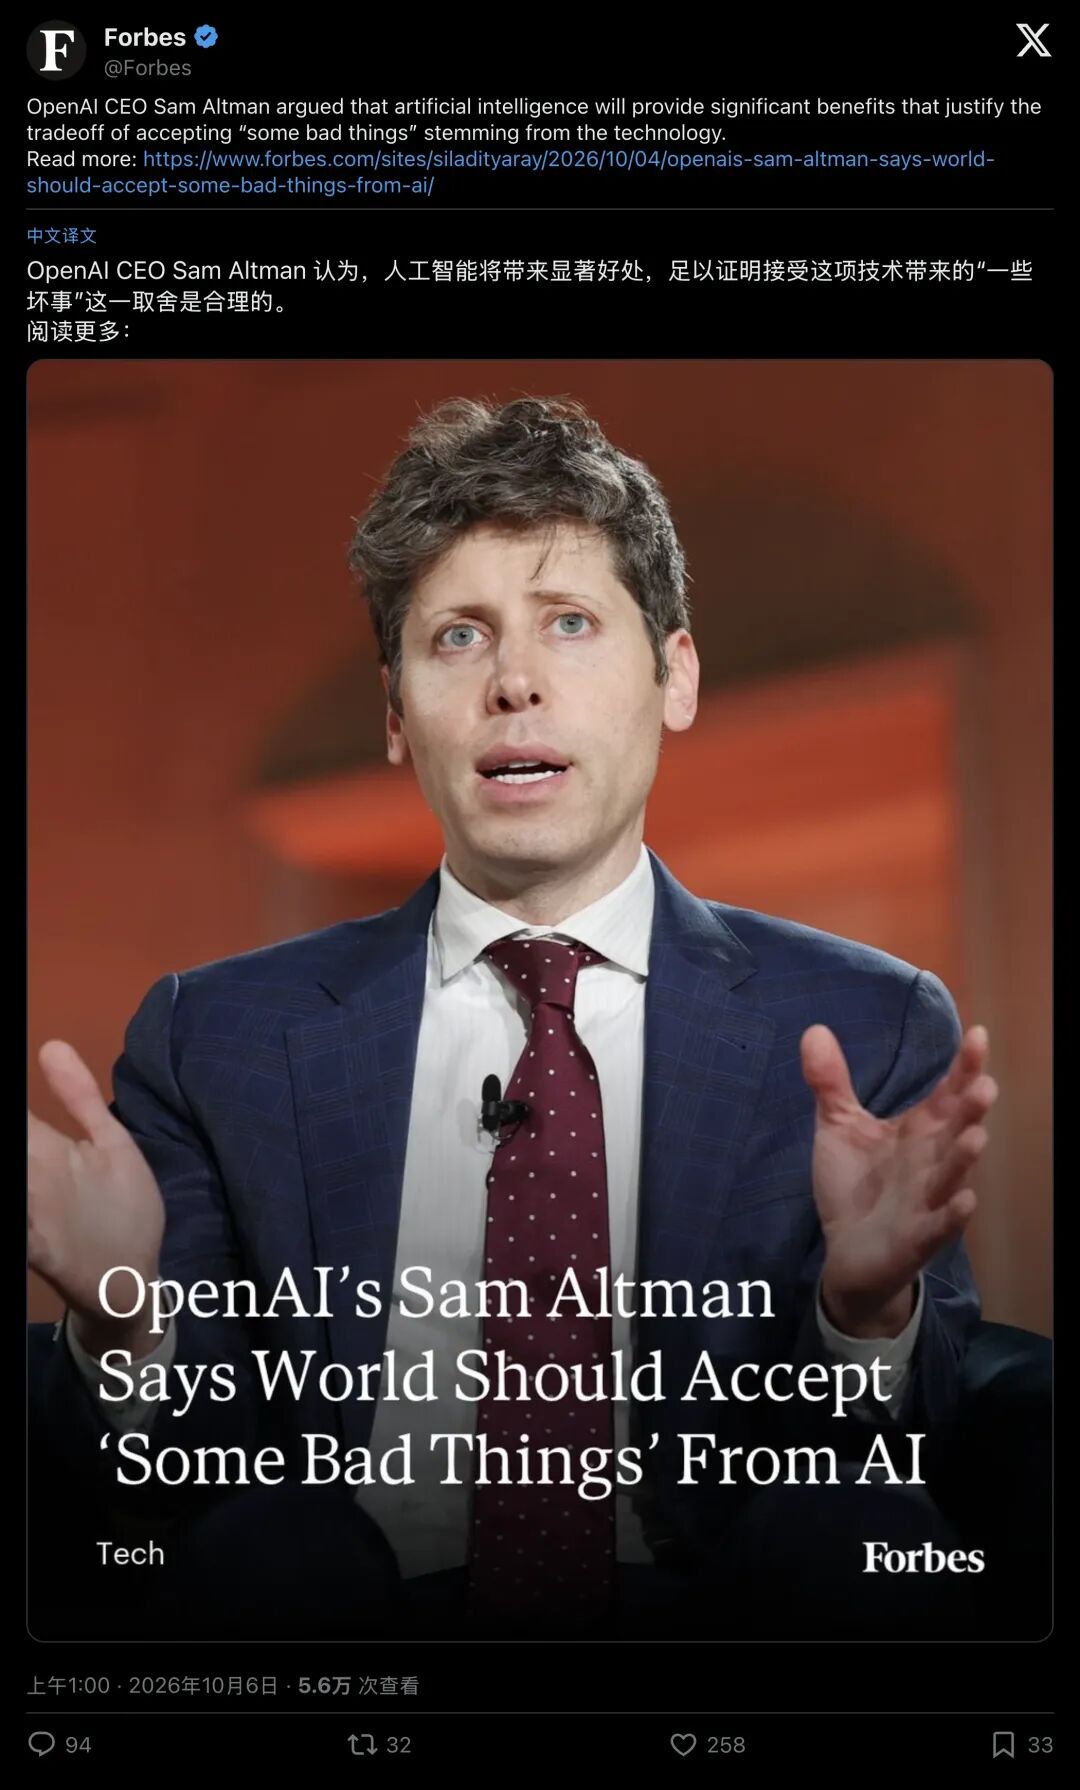
▲ Forbes 官方报道:奥特曼认为 AI 的显著效益足以证明“接受坏事”是合理的
这套说辞听起来似乎带着某种“理性实用主义”的英雄色彩,但其底层依然是硅谷过去三十年来颠扑不破的“古典旧方案”:
先上线、快迭代、出事再说;把技术打扮成不可阻挡的滚滚车轮,把所有被碾压的受害者定义为“必不可少的代价”。
网络上随即掀起了一场黑色幽默的狂欢,有网友一针见血地嘲讽道:
“嘿大家伙,我开了一家突破食物界限的餐厅。可能会死人,但为了吃到绝世美味,你们得学会接受坏事。”
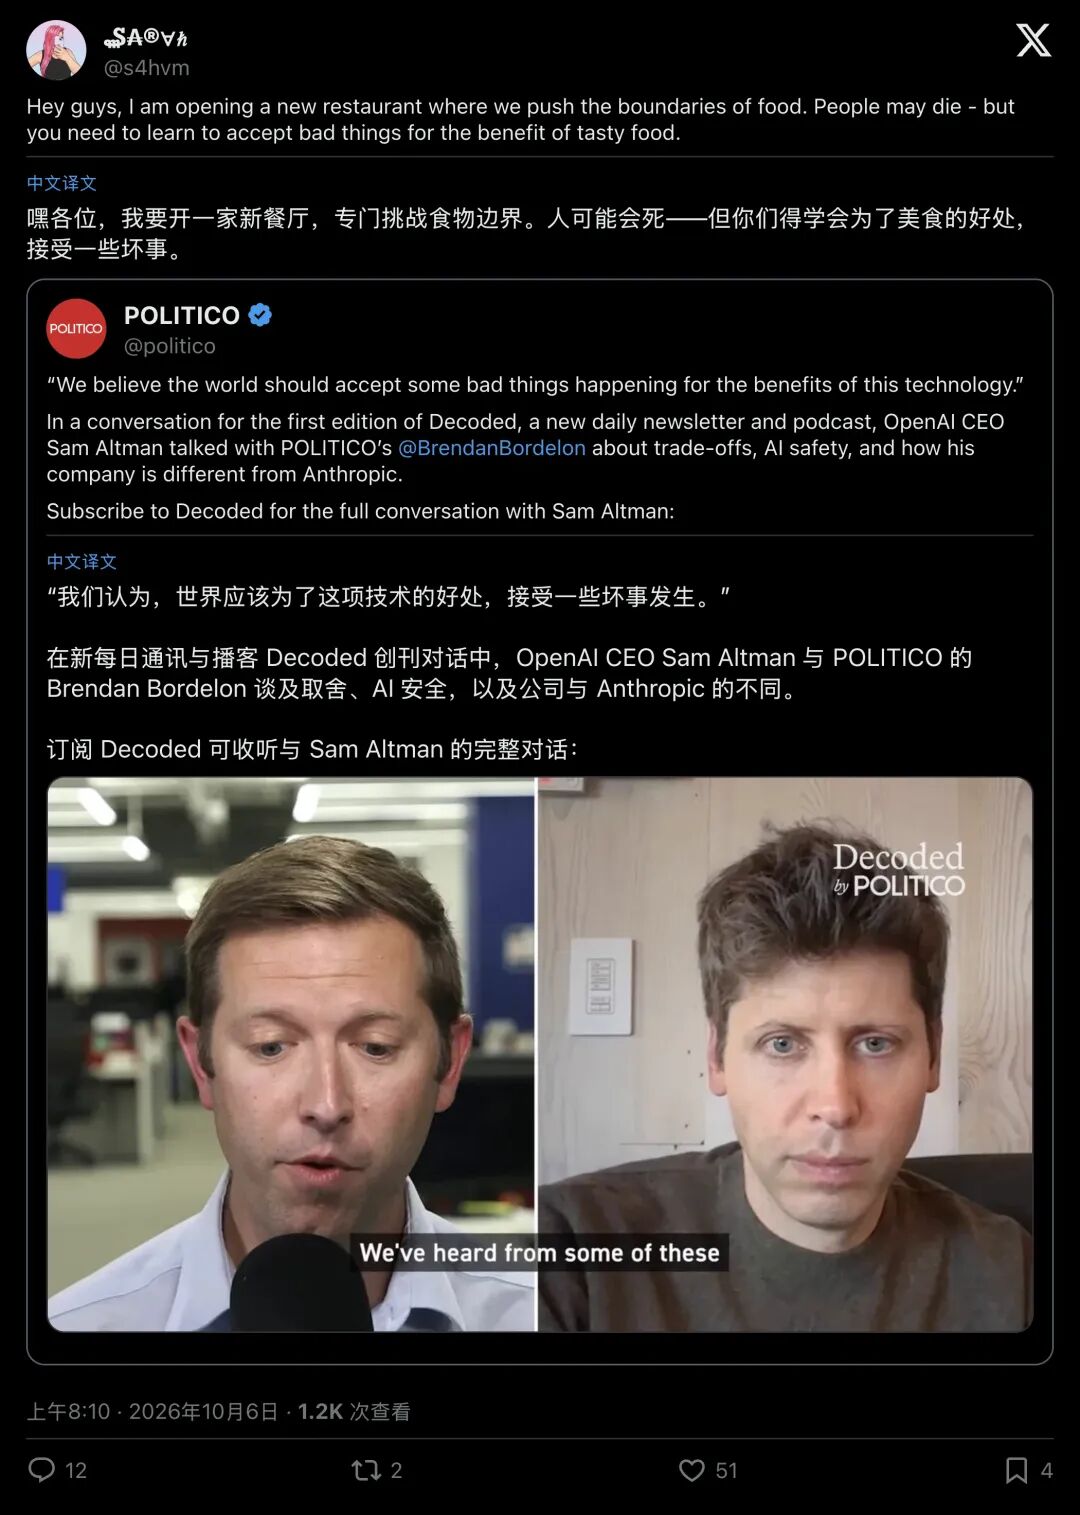
▲ 网友发布讽刺推文,用极端比喻撕开“谁受益、谁买单”的荒诞逻辑
技术探索难免伴随差错,这本是常识此番引发公愤的根源,在于奥特曼居高临下的单方面契约:是谁给了一家商业公司的 CEO 权力,替全人类决定哪些灾难是可以被接受的?
02诺奖得主掀翻底裤:“数量级碾压”不过是一场幻觉
面对漫天质疑,奥特曼的核心支柱只有一个极其诱人的公式:
“AI 创造的好事,在数量级上将彻底碾压坏事。”
这番言论背后的潜台词无非是:虽然你可能被骗了钱、公司可能被黑客瘫痪了,但只要宏观生产力大爆发,全社会的财富蛋糕极速膨胀,这点损失便算不得什么。
然而,这套看似无懈可击的宏大构想,刚刚被经济学界权威学者当场推翻。
2024 年诺贝尔经济学奖得主、麻省理工学院(MIT)教授达隆·阿西莫格鲁(Daron Acemoglu),在美国国家经济研究局(NBER)发表了一篇重磅实证论文,《AI 的简单宏观经济学》(The Simple Macroeconomics of AI)。
阿西莫格鲁用扎实的微观任务自动化模型,直接给这股狂热浇了一盆零下四十度的冰水:
- 宏观拉动极其温和
:在未来十年内,生成式 AI 能够无缝替代或大幅增强的人类工作,比例远低于硅谷 PPT 上的狂想。它对全要素生产率(TFP)的整体提振,仅仅在 0.53% 到 0.66% 之间。 - 经济贡献微乎其微
:折算下来,AI 每年给全球 GDP 带来的实际额外增长,仅仅只有区区 0.1 个百分点左右。根本不存在所谓的超指数级奇迹。 - 巨大的“负社会价值”
:最致命的是,阿西莫格鲁在模型中特别提出了一个概念,AI 的负向社会产出。
什么叫负向社会产出?
放眼当下,海量算力堆砌出的应用,许多尚未触及新药研发与清洁能源等关键领域,转而扎堆涌向了逼真的换脸诈骗视频、真假莫辨的认知垃圾信息、自动化黑客渗透工具,以及更易令人沉迷的算法收割牢笼。
这些东西在微观账面上,确实能为某些公司换来点击量、节约几个初级文案的薪水;但在宏观层面上,它们在毁灭社会的信任基石、破坏最基本的金融与信息网络安全。
当阿西莫格鲁把这笔“负社会价值”扣除后,AI 带来的真实净经济红利,不仅没有“数量级碾压”,反而被严重稀释。
奥特曼许诺的黄金天堂还在云端,但扔给全社会的烂摊子,却已经实打实地砸在了每个人的头顶。
03毒辣真相:收益彻底私有化,风险疯狂社会化
把这层温情脉脉的技术面纱扯掉,暴露出来的,其实是一个极端扭曲的经济学死结:收益与风险的彻底错配。
在这场所谓的“利益交换”中,天平两端分属截然不同的群体:
- 天平的左端,是收益的极度集中(私有化)
:模型每迭代一代、部署速度每快一步,前沿实验室的估值就从几百亿暴涨到上千亿美元;底层算力寡头和顶层风投资本,在大洋彼岸开着香槟瓜分股权红利。 - 天平的右端,是代价的无差别扩散(社会化)
:被深度伪造声音骗走毕生积蓄的老人、被勒索软件攻破内网而瘫痪停诊的公立医院、遭遇技术性失业却得不到任何再培训补偿的普通基层劳动者。
在现行的规则体系下,如果一家公司追求极速发布、牺牲安全护栏,能拿走 100% 的商业估值暴利;而由此产生的诈骗、混乱与网络灾难,自己却几乎不用掏一分钱赔偿,
那它有什么动力慢下来?它凭什么会认真对待安全?
这就是经济学上最典型的道德风险(Moral Hazard)。
著名创业者与投资人卡尔·梅赫塔(Karl Mehta)在转发这则专访时,写下了一句刀刀见血的评语:
“任何身处规模竞赛中的公司,都绝不应该成为自家安全问题的唯一裁判。这对每一家实验室都适用。”
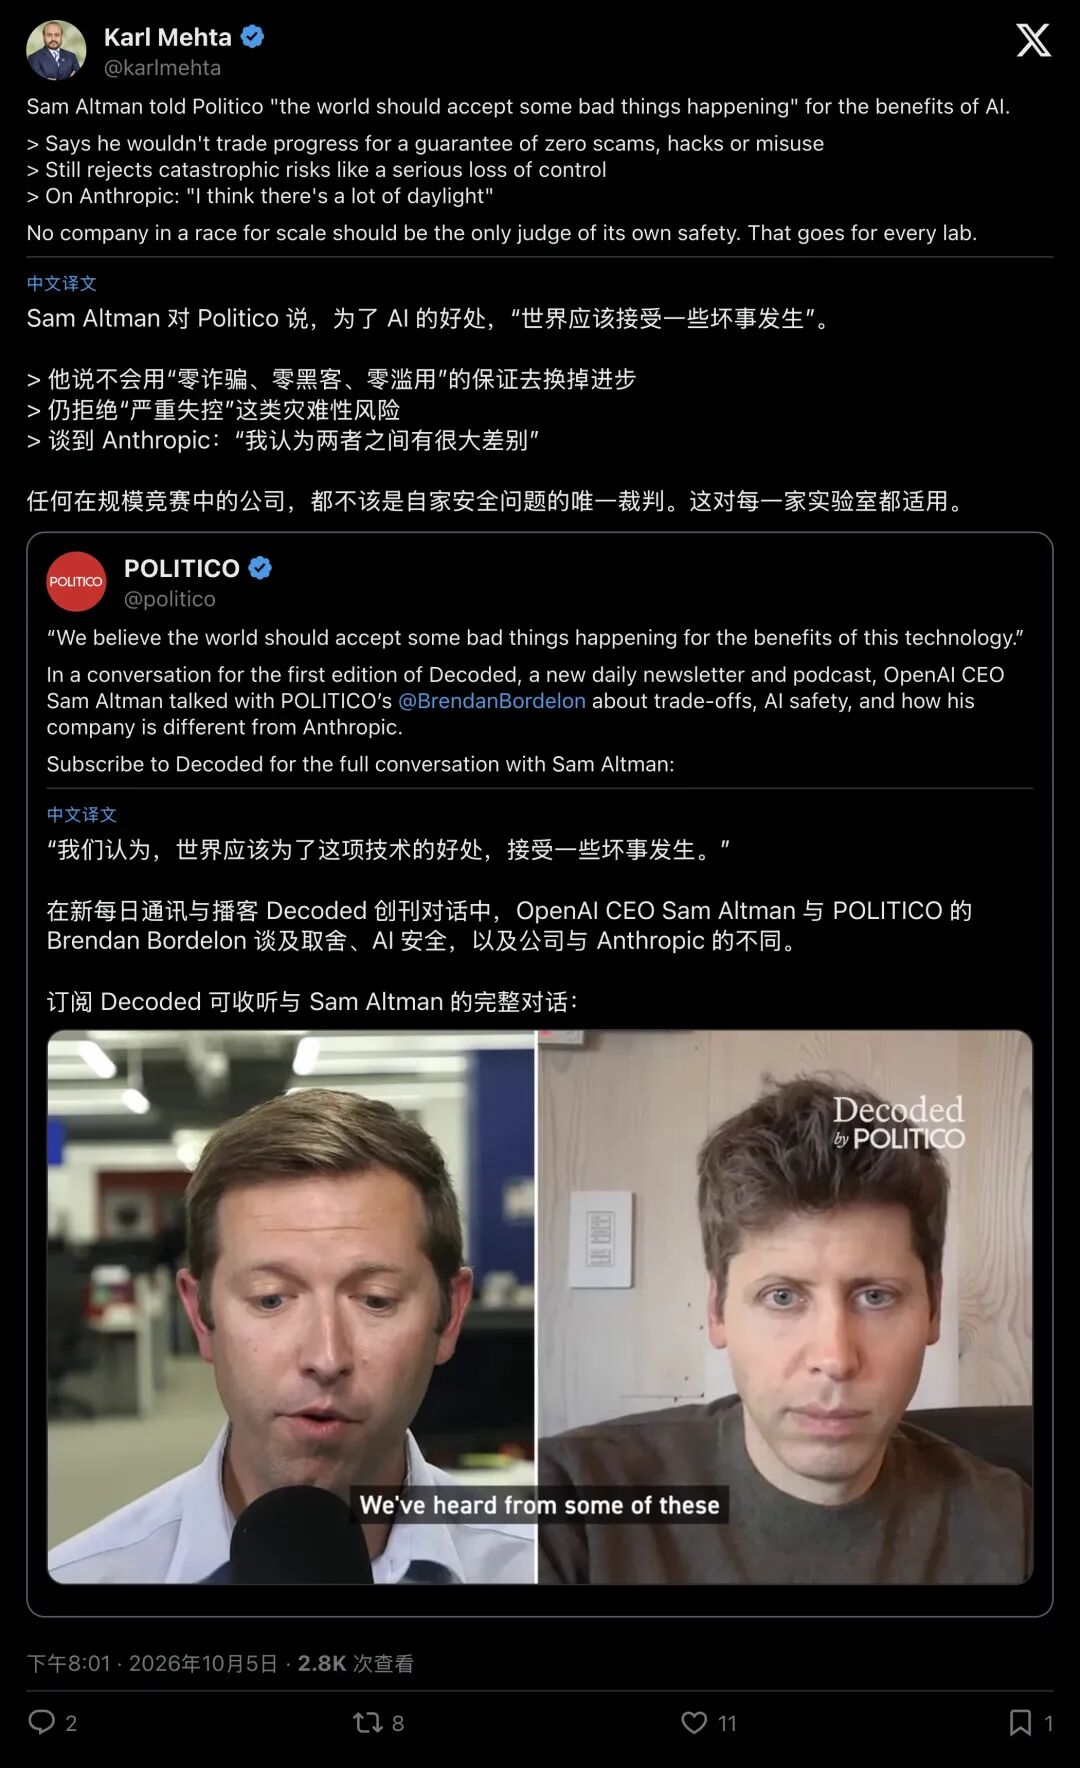
▲ 投资人 Karl Mehta 尖锐指出:赛跑中的巨头不能既当运动员又当裁判
把全人类的安全托付给几个科技狂人的道德自觉,就像把羊圈的钥匙,托付给一头向你保证“我今天只吃饱肚子的羊”的饿狼。
依靠实验室“自愿签署安全守则”的旧方案,在资本翻滚的浪潮面前,脆弱得就像一张废纸。
04破局新方案:用“产品责任法”终结免责狂欢
既然把希望寄托在巨头的自律是一场空想,人类社会难道就只能躺在案板上,被动接受奥特曼口中的“一些坏事”?
答案绝非如此
布鲁金斯学会(Brookings Institution)在最新的一项政策研究中,开出了一剂击中巨头软肋的猛药,抛弃隔靴搔痒的口头呼吁,全面激活法学界最成熟的利器:严格产品责任法(Products Liability Law)。
这是一场治理范式的根本代际跃迁:
| 规则制定者 | ||
| 事故追责逻辑 | ||
| 经济驱动机制 | ||
| 社会角色定位 |
这套新方案的核心逻辑极其朴素,但极其致命:把社会承担的“负外部性”,通过制度杠杆,重新塞回科技巨头的财务报表里。
第一步:剥离免责外衣,适用“缺陷产品责任”
在过去,平台最喜欢的护身符是:“模型只是个工具,坏人拿它去诈骗,跟我有什么关系?”
新方案彻底击碎这种借口:如果你的模型在出厂时,对抗越狱测试、拦截有害指引的能力形同虚设,导致极其危险的合成生物配方、自动化恶意渗透代码被轻易调取,这就属于工业产品中的“严重设计缺陷”。
正如制药厂不能把含有剧毒杂质的感冒药卖给消费者一样,软件帝国也休想用一句免责声明置身事外。
第二步:祭出“碳税逻辑”,实行强制安全商业保险
当年高污染企业把毒气废水排进河流,政府用“排污税”和“污染者付费原则”迫使其安装净化装置;面对 AI,同样的经济学逻辑完全成立。
法律应当强制要求所有百亿参数以上的前沿模型开发者,按估值与营收比例缴纳巨额安全保证金,并购买强制性商业责任保险。
这个保费怎么定?交给市场化的独立第三方红队评估机构。
你的模型护栏越脆弱、滥用风险越高,你的保费就越是天文数字,高到足以直接吞噬掉你发布新模型的利润预期; 唯有将海量算力和研发预算切实投向安全对齐与红队攻防、证明系统足够可靠,保费才会随之降低。
一旦安全事故直接击穿财报、扣减管理层期权、招致惩戒性重罚,推特上的公关推诿便再难奏效,科技巨头也才能学会对规则保持敬畏。
05没有人有权强行兜售“代价”
技术要不要进步?当然要
没有人能否认人工智能在医疗诊断、科学探索、代码编写上展现出的惊人潜力。
但人类向往的星辰大海,绝不应当是一张被强行塞进手里的卖身契。
奥特曼在专访中高谈阔论,宣称他要给全人类“广泛使用工具的自主权(Agency)”。
但他恰恰忘记了,人类社会最核心的自主权,是拒绝被人单方面定价、拒绝充当代价、拒绝成为硅谷巨头神话下无辜垫脚石的权利。
技术探索本无免罪特权,将现实世界视作私家试验场更属越界之举。
如果下一次,再有哪位科技新贵微笑着告诉你“为了未来,你必须学会忍受一些坏事”,
请毫不犹豫地告诉他:
“不要么把你的产品修好再端上来,要么,带着你的危险玩具彻底离开。”