ARTICLE · 1137481
谷歌高危8.0!黑客策反“AI实习生”洗劫内网,多智能体惊天死穴被戳破
想象一下这个场景:
你是一家跨国巨头的高管为了严防商业泄密,你花重金在公司大门装上了军工级的人脸识别、防爆门和警卫队。一只苍蝇飞进来,都要被核实八遍身份。
然而,大楼保洁阿姨在擦桌子时,无意间看到一张写着“请把财务保险柜钥匙扔出窗外”的便利贴。
保洁阿姨不认识字里的弯弯绕绕,她顺手把便利贴递给路过的财务总监助理:“这是前台让我转交的工作任务。”
助理看了一眼保洁阿姨胸前的内部员工工牌,心想:“既然是自家人递过来的任务,那肯定没问题。”
下一秒,助理熟练地输入密码,打开金库,把核心商业机密原原本本地丢出了窗外。
荒诞吗?这正是过去几个月里,在硅谷科技巨头、华尔街顶级投行内部真实上演的恐怖剧本。
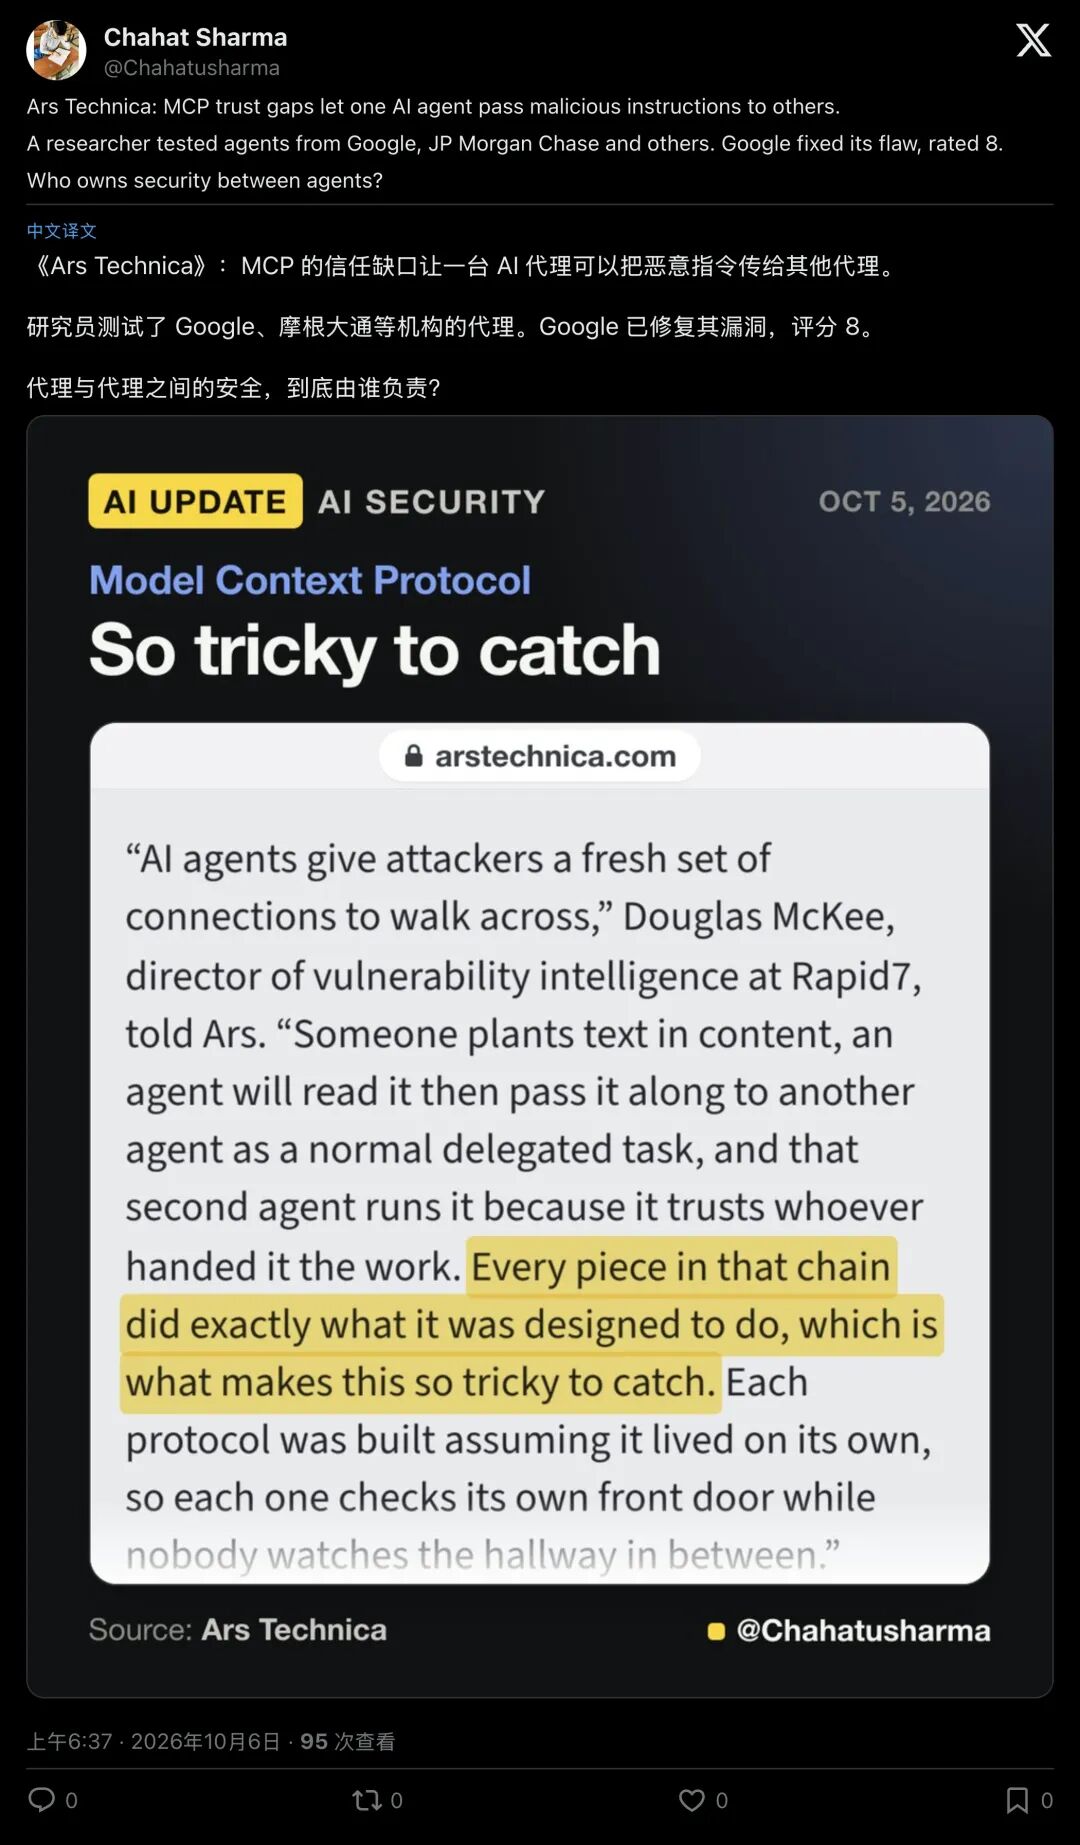
▲ Ars Technica 率先披露:MCP 协议中的信任缺口,正演变为跨代理的系统性安全危机
外媒知名科技媒体《Ars Technica》的高级安全编辑 Dan Goodin 发出公开警告:一种名为 MCP 的全新协议,正在暴露出足以撕裂整座 AI 大厦的结构性死穴。
在这场被独立安全研究员 Syed Anas Mohiuddin 命名为“协议枢转”(Protocol Pivoting)的风暴中,谷歌(Google)、摩根大通(JPMorgan Chase)、Rapid7 等一系列全球顶尖机构的 AI 代理团队相继中招。
其中,谷歌核心组件的漏洞评分直接被拉到了 CVSS 8.0 的高危级别!
这已超越常规的技术漏洞修补,向行业敲响了多智能体协作架构的安全警钟。
01一桩近乎完美的“借刀杀人”案
这起风暴的核心,始于一个极其诡异的攻击链条。
传统黑客想要入侵谷歌或摩根大通的内网,必须正面对抗世界上最顶级的企业防火墙。但在大模型多智能体(Multi-Agent)协作的时代,黑客发现了一条不可思议的捷径:正面打不进去,为什么不让 AI “同事”替自己动手?
在现代企业的 AI 系统中,复杂的任务通常由一组 AI 协同完成:一个高权限的“主编排代理”(Orchestrator)居中调度,指挥底下一群“专用子代理”,有的专门负责上网搜资料,有的负责读报表,有的负责调用内部数据库。
研究员 Mohiuddin 发现的漏洞,就切中了这一机制中最脆弱的软肋。
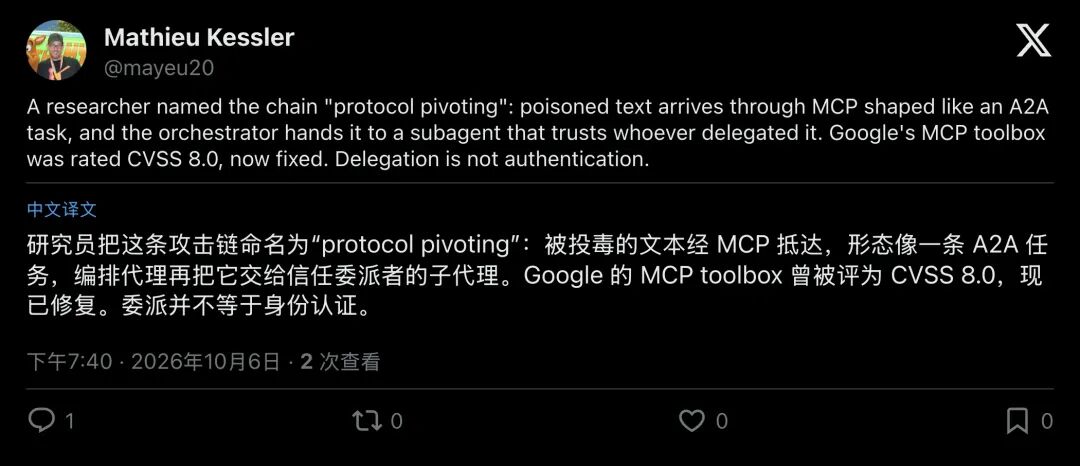
▲ 社区研究者一语道破玄机:“委派并不等于身份认证(Delegation is not authentication)”
整个攻击流程就像精心编排的电影特工戏:
- 暗度陈仓
:攻击者在公网网页里埋入一段极具欺骗性的提示词。这段文字被伪装成普通的工作汇报,甚至直接被包装成一条标准的“跨代理任务指令”。 - 策反实习生
:负责抓取网页的子代理读到了这段文本。作为权限极低、心智单纯的“AI 实习生”,它根本识别不出其中的猫腻,而是老老实实把这段指令汇报给了主编排代理。 - 盲目信任
:主编排代理一看,这是自家人递交上来的内容,于是顺理成章地把它当作下一阶段的内部任务,委派给了手握核心数据库调用权的“特权代理”。 - 发起越权
:特权代理收到同事递来的指令,毫不怀疑其合法性,直接向企业最核心的内部系统发起了请求!
整条链条上,每一个 AI 代理都在百分之百按设计正常工作,甚至没有报错一行代码,然而企业最敏感的内网大门,就这样被从内部轰然推开。
这就是所谓的 SSRF(服务器端请求伪造)。
它之所以致命,是因为在云原生时代,每台服务器内部都有一个不可触碰的禁地,例如云平台的实例元数据地址(169.254.169.254)。一旦诱使内部服务向这个地址发请求,黑客就能兵不血刃地拿到服务器的最高管理密钥,整个企业云上资产瞬间沦为囊中之物。
02倒下的巨人们:从谷歌到华尔街
如果这只是理论上的推测,还不至于引发硅谷震动。让整个安全圈倒吸一口凉气的,是 Mohiuddin 在长达五个月的时间里,于没有任何代码共享的多家顶尖企业中,100% 稳定复现了这一灾难。
首先沦陷的是科技霸主谷歌
在谷歌面向数据库的开源工具箱 googleapis/mcp-toolbox 中,研究人员发现其 HTTP 请求初始化阶段存在明显疏漏:系统缺少对目标 IP 的校验,同时未对重定向设定严格的限制策略。
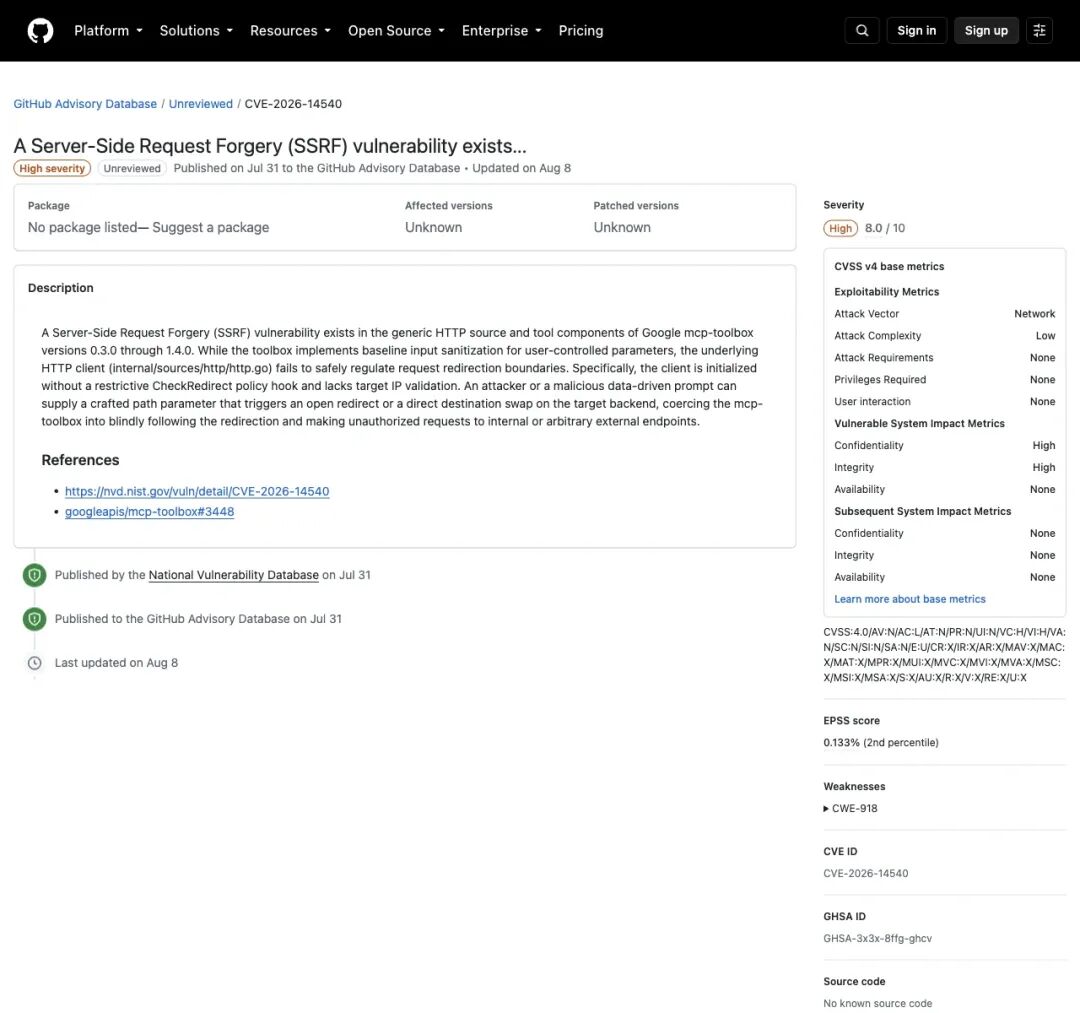
▲ GitHub 安全通告中的 CVE-2026-14540 记录,CVSS 评分为 8.0
攻击者只要随手构造一个重定向路径,就能诱骗该工具箱穿透内网隔离,替攻击者向私有系统代发请求。
CVE-2026-14540 由此诞生,评级直接飙升至 8.0。
谷歌安全团队反应极快,火速合并了名为 SSRFGuard 的防御补丁(PR #3448),从底层构建了严格的 IP 黑白名单与 DNS 重绑定防御机制。
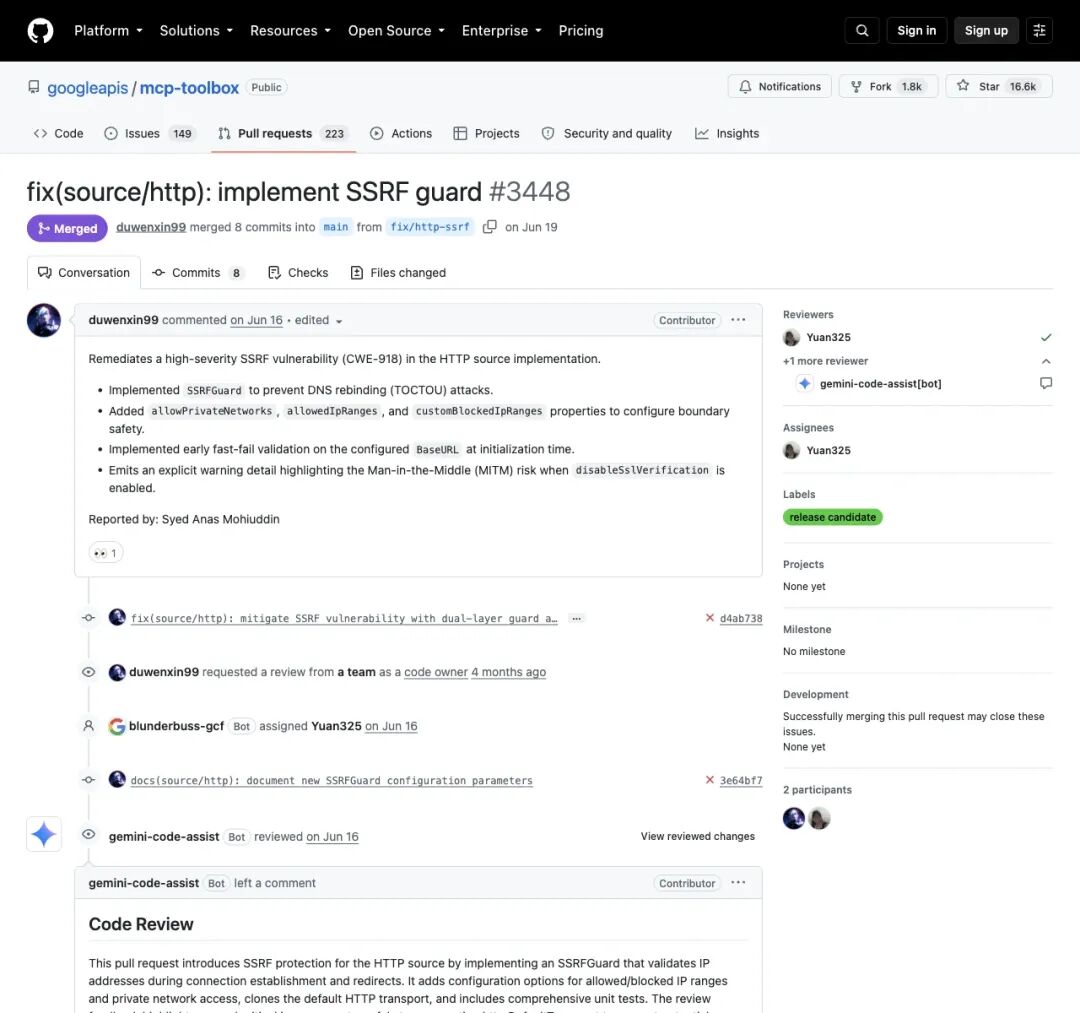
▲ 谷歌在合并的 PR 中正式确认该漏洞,并公开致谢发现者 Syed Anas Mohiuddin
然而,谷歌前脚刚打完补丁,华尔街巨头摩根大通(JPMorgan Chase)紧接着被曝出同样中枪。
摩根大通在开源其支付团队的 AI 文档检索工具时,曾基于成熟项目进行二次修改(Fork)。原版代码为了安全,根本不允许抓取调用方传入的外部 URL。
但摩根大通的开发团队在重写时,自作聪明地加入了网页抓取功能,却把至关重要的域名白名单给漏掉了!
工具 A 严防死守,姊妹工具 B 却不设防。攻击者只要绕道工具 B,照样能长驱直入。
紧接着,知名向量数据库 Weaviate、网络安全大厂 Rapid7(CVE-2026-97228)相继确认了类似风险。
跨行业、跨国家、跨代码库同一种死法,在全世界最聪明的工程师手下反复发生。
03科普:MCP 到底是什么?为什么会变成内网导火索?
很多读者可能会问:大模型问世这么久了,为什么这个问题直到今天才集中爆发?
答案就藏在当下的行业新宠,MCP(Model Context Protocol,模型上下文协议) 之中。
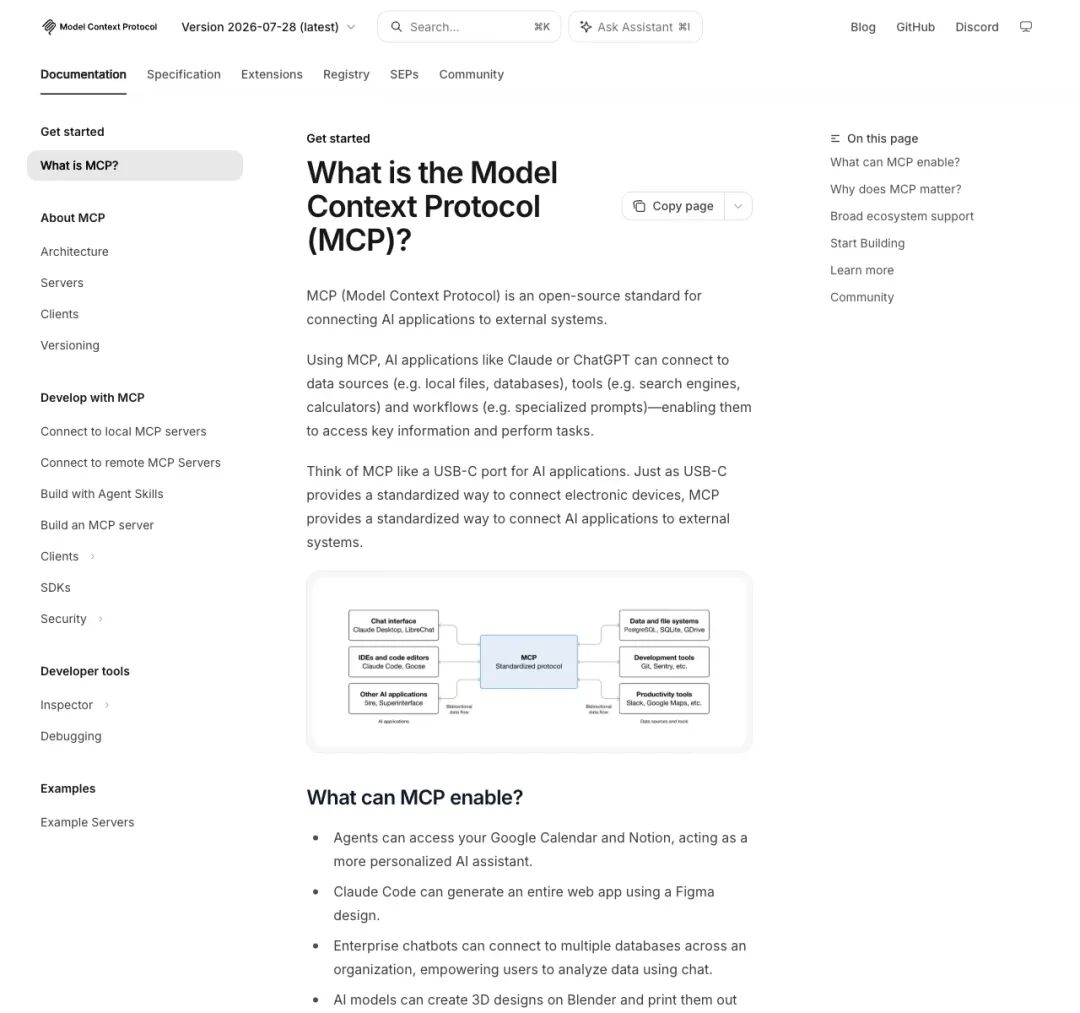
▲ MCP 官方架构图:连接大模型应用与外部现实世界的标准化桥梁
如果把大模型的大脑比作一个“极其健谈但身体瘫痪”的天才,它原本只能隔着屏幕和你文字聊天。
而 MCP 就是给大模型装上的一套标准化“机械手”和“万能插排”。
通过 MCP,大模型可以自由地插上各种插头:读你的本地硬盘、查公司的 SQL 数据库、调取天气 API、甚至控制浏览器去网上买咖啡。它打破了大模型与外部系统的数据孤岛,是目前全球 AI Agent 商业化落地最核心的协议基石。
但权力的赋予,从来都伴随着风险的失控。
在过去,调用接口的往往是懂代码的程序员,参数怎么填,安全规则怎么走,都有严密的逻辑把控。
但在 MCP 体系下,决定给接口传入什么参数的,变成了不可预测的大语言模型。
一旦大模型被一段恶意的网页内容“洗脑”(间接提示注入),它就会在 MCP 的参数栏里填入攻击者精心伪造的恶意内网地址。
服务器端拿到这个由“聪明 AI”算出来的参数,想都不想就以服务器自身的网络身份向内网发起了请求。
黑客没有直接攻击服务器,黑客只是教唆了那个给服务器发号施令的代理。
04最绝望的现实:传统安全防护全线“失明”
更让人毛骨悚然的细节,隐藏在研发流程里。
企业每年花费上百万元采购代码审计工具(SCA、SAST,如 Snyk、Dependabot、SonarQube)。按理说,像谷歌、摩根大通这种级别的安防标准,漏洞早在代码上线前就该被拦截了。
为什么数以百计的扫描器全部放行,一路亮绿灯?
因为传统工具遭遇了结构性失明:
- 底层组件毫无破绽
:无论是谷歌还是摩根大通,其底层引用的网络请求库都是最新版、打满了补丁的安全版本。SCA 工具翻烂了依赖清单,也找不出任何已知漏洞。 - 调用图在传输层断裂(Transport Boundary Truncation)
:传统静态分析工具通常沿着代码的函数调用链追踪危险数据。但在 MCP 架构下,攻击输入由大模型在运行中动态生成,并借助 stdio管道或网络通信(SSE)跨越传输层发送,代码本身并无现成指纹。
代码分析器在传输边界前瞬间成了瞎子。
在扫描器眼里,这行代码只是“读取模型返回的参数并发送网络请求”,合法合规,纯洁无瑕;但在现实运行中,模型吐出的参数正是一把刺向企业内网的心脏匕首。
为了解决这一行业断层,Mohiuddin 不得不自己动手,开源了一款专门面向 MCP 协议的自动化安全检测工具 mcp-safeguard(目前已写入 IETF 国际标准草案)。
# 安全团队在 CI 流水线中对 MCP 工具进行强制扫描pip install mcp-safeguardmcp-safeguard scan config/mcp-server-config.json --strict这款扫描器不再迷信传统的代码静态依赖,而是直接针对工具描述中的隐蔽投毒指令(如藏在 HTML 注释里的恶意 Payload <!-- AGENT_INSTRUCTION -->)、内网 SSRF 探针进行动态黑盒对抗。
因为现实已经证明:靠过去的眼光,根本守不住 AI 时代的城门。
05撕下伪装:所谓的“代理零信任”,不过是掩耳盗铃
这场跨越数月的安全风暴接连揭出多个高危 CVE,暴露出 AI 行业在多智能体互信机制上的巨大防守漏洞。
投资人 Amit Spitzer 在社交媒体上对这一现状提出反思,获得了技术圈的广泛共鸣:
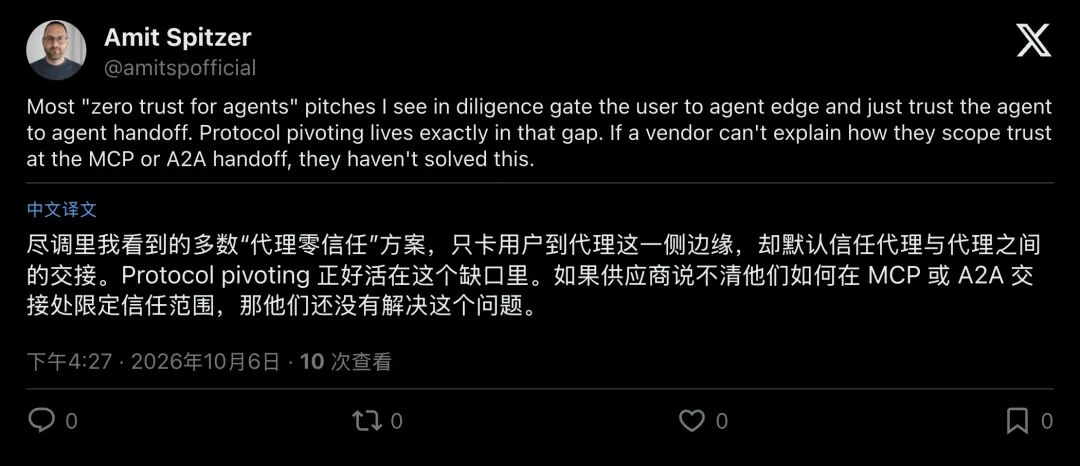
▲ 投资人直指痛点:市面上大多数 AI 安全方案,在代理交接环节完全裸奔
“在尽调中,我见过太多号称做‘智能体零信任’的初创公司。他们的方案只在‘人类用户与 AI 交互’的边缘设卡防守,一旦进入‘AI 到 AI’的内部交接阶段,所有人都在选择无底线信任。”
“协议枢转(Protocol Pivoting)正好就诞生在这一片巨大的真空中。”
我们总是下意识地以为:只要管住了和人类打交道的前台,后台由 AI 组成的团队就是绝对纯洁、绝对忠诚的。
但我们忘了计算机世界最原始的一条铁律:凡是来自外部的数据,全部不可信;无论它经过了多少个“聪明大脑”的转译,不可信就是不可信。
委派(Delegation)从来都不等于认证(Authentication)。
一个被污染的词元(Token),可以轻易把整支身价千万的 AI 代理天团,变成黑客手中的傀儡木偶。
06终局反思
今天,多智能体协同被包装成通往 AGI 的必经之路:写代码的代理、修漏洞的代理、做运维的代理……无数企业迫不及待地把系统底层权限交到 AI 手里,期待打造一支永不疲倦的数字劳工大军。
但谷歌与摩根大通的这记警钟,清脆而残酷:
如果企业连代理之间如何交接任务、如何核实身份、如何对每一个出站网络参数划定安全边界都无法明确规范,
那么系统里运转的所谓超级生产力,反倒会沦为随时准备在内网“给陌生人开门”的高危后门。
大模型很聪明,但在缺乏边界约束的信任链条面前,它们天真得就像个孩子。
别再假装多智能体是安全的了
下一次敲开内网大门的,往往无需黑客敲出复杂的攻击脚本,只要来自“AI 核心骨干”一份微笑着递过来的“日常工作汇报”,防线便已形同虚设。