ARTICLE · 1138743
小白也能看懂的 AI 术语讲解(一)
小白也能看懂的 AI 术语讲解(一)
不少朋友对 AI 感兴趣,也有人已经在用各种 AI 工具了。可一碰到行业里的术语就犯迷糊:Agent、Skills、工作流……名词一个接一个冒出来,学起来总被这些"拦路虎"绊住。 所以我打算开个系列,用大白话把 AI 领域的高频名词挨个讲明白,帮大家清理学习路上的绊脚石。 这一篇先从 11 个词说起:从大语言模型,到 Token、Agent、Skills、工作流,一个个看它们是什么、干什么用、相互之间什么关系。 
不少人是从 2023 年前后的 ChatGPT 开始关注这波 AI 浪潮的。而这类聊天产品背后真正干活的,就是大语言模型,英文缩写 LLM(Large Language Model)。 它吃了海量数据"长大",掌握了理解和运用语言的本领。你用日常口吻提问,它就能结合你的需求和给出的信息,分析、梳理,然后用自然的语言回应你——不管是解释概念、拆解文章,还是帮你起个草稿,靠的都是这套能力。 那它和豆包、DeepSeek 是什么关系?豆包、DeepSeek 是我们实际打开使用的 App,背后调用的才是大语言模型。应用把模型能力和对话界面、文件上传等功能打包在一起,让我们用起来顺手。 一句话概括:模型负责"动脑",应用负责"装门面"。 
大家习惯了打字跟 AI 聊天,但我们交给 AI 的信息远不止文字,还有图片、声音、视频。每一种信息形式,就是一个模态 所谓多模态,就是能同时处理多种信息形式。输入端可以"边看边读",比如同时理解文字和图片;输出端也能"一鱼多吃",比如根据文字描述生成图片。 举个例子:你给模型发一张文章封面加正文,问它配色如何、人物够不够醒目、跟文章内容搭不搭。它需要同时读懂文字、看懂图片,再用文字给出评价——这就是多模态能力。 具体到某个模型能不能听声音、画图、做视频,得看它的支持范围。 
提示词(Prompt)听起来像一个"词",实际上你发给 AI 的任何文字都算提问、派任务、补充背景、闲聊,全都包括,可以是一句话,也可以是好几段说明。 比如我让 AI 读一篇文章,分析结构、判断每段适合配什么图,这一整段要求就是一条提示词。如果还想让图片带上我的 IP 形象或特定风格,也一并写进去。AI 只有知道了"要什么、交什么",才能干好活。 在 AI 时代,把意图清楚传达给 AI,是每个人都该练的基本功。要求说得越明白,AI 帮得越到位。 
Token 在别的领域常译作"令牌",但在大语言模型这里,它是模型处理文字时的最小单元,官方中文译名叫「词元」。 模型读文字时,会按规则把内容切成一个个小块,这些小块就是 Token。一个 Token 可能是一个字、一个词,也可能只是某个词的一部分。各家模型切法不同,所以 Token 和字数之间没有固定换算比例。 平时主要在两处会碰到它: 计费:不少模型服务按输入 Token 数和输出 Token 数分别收费。输入包括你的要求和材料,输出是模型生成的内容。聊天应用则可能走会员订阅路线。 上下文长度:宣传里说某模型支持多少万 Token 上下文,说的是它能"装下"的信息量,不能直接等同为汉字数。 
上下文,就是 AI 回答这次问题时能参考的全部信息——之前的聊天记录、你这次发的提问、文章和资料,都算。我们常说的"历史聊天记录"就是最常见的上下文来源。 举几个用法: 想让 AI 帮我做自媒体视觉设计,先把品牌调性、人物形象、参考资料喂给它,生成的插图才贴脸; 让它陪我聊人生选择,把我的经历、现状交代清楚,建议才更接地气; 做项目时,把背景资料、最新会议纪要给它,它整理纪要、更新进展时才有据可依。 但容量是有限的,这个上限叫「上下文窗口」,一般用 Token 衡量。聊得太久、塞得太多时,早期内容可能被压缩成摘要,甚至干脆不带入。它最后能参考多少,取决于当时实际给了它什么。 
聊到这里自然有个疑问:换个新对话,AI 还记得之前的事吗?这就涉及"记忆"。 说一个 AI 工具有记忆,意思是它能把某些信息存下来,以后再用——比如你的个人情况、表达习惯、手头项目。如果工具支持记忆功能且确实生效,你就能省下重复交代背景的功夫。具体能记什么、在哪些对话里生效,各家产品规则不同。 区分一下:上下文管"这次回答能看什么",记忆管"哪些信息被留下来、以后还能用"。 被调出的记忆,也会并入当次上下文。 如果工具没有记忆功能,也可以手动"曲线救国":一段对话收尾时,让 AI 整理一份 handoff(交接文档),写清重要背景、已完成的进展和下一步计划。开新对话时把文档贴进去,就能接着聊。不过新对话掌握的只有文档里的内容,所以关键决定要写全,交接才顺。 
前面提到的资料,总得有个"仓库"。知识库就是把资料系统组织起来、方便随时取用的一套集合。 它最大的价值是补上"你知道、AI 不知道"的信息缺口,让回答有出处、有依据。 我自己就维护着一个个人知识库,分门别类:个人资料、知识积累、项目文件、创作素材……整理工作也交给 AI 干——我先说明每类东西是什么,再让它帮忙分类归档。之后写文章找旧素材、讨论项目翻资料,直接让 AI 进库检索就行。 公司场景同理:业务介绍、产品文档、客户信息都能入库,AI 答相关问题时先查库,再结合公司实际情况作答。 注意分工:知识库负责存和整理,AI 负责按任务取料。 文件躺在库里,不代表 AI 每次回答前都读过。 
Agent,中文常译"智能体",指一种围绕目标自主推进任务的 AI 系统。你交代目标,它自己拆解步骤、调用工具、检查结果,再决定下一步动作。 其实我们天天用的豆包、DeepSeek,日常聊天里已经带一点 Agent 属性了——比如开了联网搜索,它能自己去查资料再作答。只不过这类能力通常局限在 App 自带功能内。 而 WorkBuddy、Codex 这类电脑端的任务执行工具,能调用的工具更多、任务范围更广。授权之后,它们能读写本地文件、操作浏览器、对接其他软件,把多步骤任务一路做下去。 举些实际用法: 写文章:让它翻旧素材 → 整理可用内容 → 汇总成新稿 → 存进飞书文档; 连上邮箱:从广告和订阅邮件里筛出有用信息; 有代码环境加持时,它甚至能自己造工具——比如批量提取资料,先写个脚本,再跑起来处理。 分工是这样的:大语言模型负责理解和判断,工具负责干活,Agent 负责组织调度,边做边看结果边调整。至于能走多远,取决于接了什么工具、拿到什么权限、任务本身多难。 
Agent 能做的多了,我们自然希望某些任务按固定套路反复执行——这就轮到 Skills 出场,单个叫 Skill。 Skill 可以理解为给 Agent 备好的"标准化操作手册",里面可以包含任务说明、参考资料、模板,甚至辅助脚本。 还以文章封面为例:我的要求是"基于文章内容和标题,生成带个人 IP 形象、符合指定风格的封面"。没做 Skill 之前,每做一次都要重发一遍提示词、重传参考图;整理成 Skill 后,这些固定要求和素材一次存好,永久复用。 以后写完文章,直接喊它"调封面 Skill",它就按保存好的风格和人物形象出图。一次配置,反复使用。 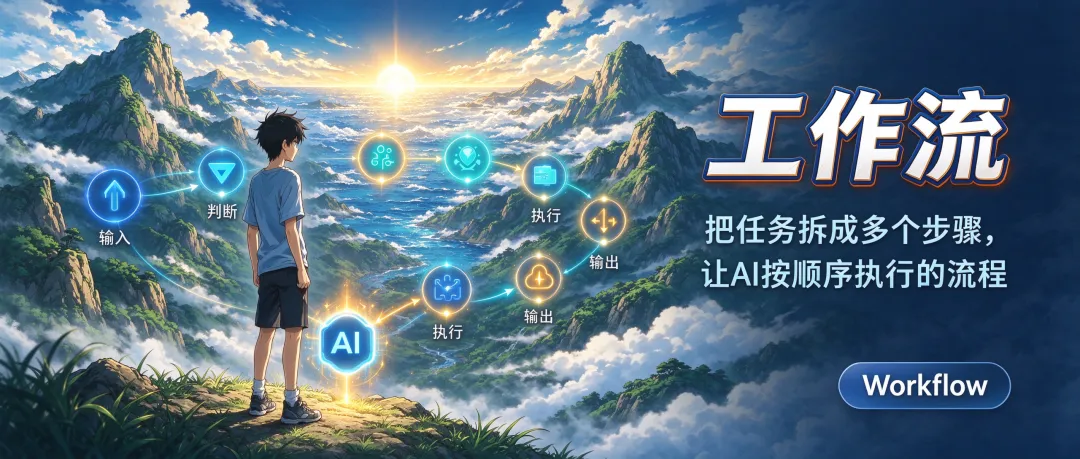
工作流,就是把一件事的步骤编排好、按序执行。比如处理一篇文章:读内容 → 标重点 → 生成封面 → 配图。 在扣子、n8n 这类平台上,每个步骤是一个节点,连线即成流程,系统按图施工。即便流程里用了 AI,整体仍属"工作流"范畴。 三者关系可以这么看: 工作流是"按剧本走",步骤固定; Agent是"看情况办",根据目标和执行结果自己决定下一步; 工作流里可以让 Agent 负责其中某一步,取两者之长。 Skill 也能用来搭更灵活的工作流:你把流程和配图要求写清楚,但具体配几张图、插在哪些段落,交给 Agent 根据文章内容自行判断。换一篇文章,直接复用这个 Skill 即可。 
AI 会答题、会调工具、会干活,但输出并不保证正确。其中最典型的坑,叫 AI 幻觉。 常见两种情形: 无中生有——它给你列出一篇论文,标题、作者煞有介事,一查根本没这篇; 张冠李戴——论文确实存在,但内容压根不支持它的说法。 相关研究中仍能观察到虚构引用、引文与结论不匹配等问题——工具变多了,幻觉并不会自动消失。 AI 答得不理想通常有两种原因:缺背景(不了解你的情况,建议太泛)和有幻觉(编造事实或给出资料不支持的结论)。 联网搜索能补充新信息和可查出处,有助于压减幻觉,但不代表回复就百分百可靠——资料找到了,理解偏了、引错了的情况依然有。 所以,对准确性要求高、需要真实来源的场景,务必亲自核对原文,确认资料是否存在、是否真的支持 AI 的结论。 这一期,我们从 AI 背后的模型,聊到怎么交代任务、提供资料,再到让它调用工具帮我们做事,也认识了回答中可能出现的 AI 幻觉。 下一期,我们会接着聊聊和 AI 对话、用 AI 查资料时经常遇到的一些名词,看看这些说法分别是什么意思,又有什么用。
1. 大语言模型(LLM)
2. 多模态(Multimodal)
3. 提示词(Prompt)
4. Token(词元)
5. 上下文(Context)
6. 记忆(Memory)
7. 知识库(Knowledge Base)
8. Agent(智能体)
9. Skills(技能)
10. 工作流(Workflow)
11. AI 幻觉(AI Hallucination)