ARTICLE · 1142377
AI 技术日报 · 2026-10-08
Anthropic 发布 Claude Haiku 5.5,10 万 token 以内的请求单价是 Haiku 4.5 的十分之一,Terminal-Bench 4.0 从 0 分升到 39.2%;OpenAI 把 GPT-6 带进 ChatGPT 聊天,回答可以直接生成按钮、图表和小工具,同时推出只回答“是否、选哪个、打几分”的 Decisions API,开源小型决策模型也一天出了两个。
模型发布
01 Claude Haiku 5.5 发布:短请求单价降到十分之一,首次支持推理强度调节
Anthropic 10 月 7 日发布 Claude Haiku 5.5,定位是高并发、对成本敏感的任务,比如摘要、上下文压缩、数据库查询、分类,以及给 Opus 5.5 和 Sonnet 5.5 当编码子 Agent。官方称它是 Anthropic 目前最快的模型,也是第一款可以调节推理强度的 Haiku 级模型。上一代 Haiku 4.5 发布已近一年,在 Terminal-Bench 4.0 上得 0 分,Haiku 5.5 得 39.2%;OSWorld 2.1 离线子集从 15.7% 升到 72.4%。同一天 Anthropic 还把 Sonnet 5.5 的缓存读取价格减半,并给 Max 和 Team 订阅用户发放每月 API 额度。
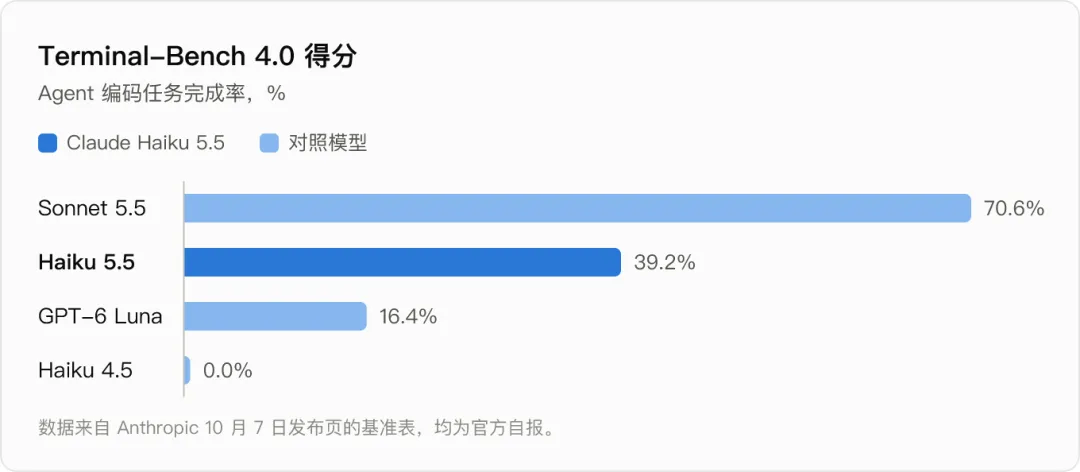
10 万 token 以内的请求每百万 token 输入 0.10 美元、输出 0.50 美元,超过 10 万 token 涨到 0.50 和 2.50 美元;Haiku 4.5 是 1 美元和 5 美元。官方称平均运行成本约降 75%,这已计入新分词器带来的 token 数增加。 Simon Willison 实测,同一段长提示词在 Haiku 5.5 上约是 Haiku 4.5 的 1.25 倍 token;10 万 token 以内与 OpenAI GPT-6 Luna 同价,超过之后 Luna 更便宜。 官方成绩(对照 GPT-6 Luna):Terminal-Bench 4.0 39.2% 对 16.4%,OSWorld 2.1 离线子集 72.4% 对 48.9%,FrontierCode 1.1 46.4% 对 42.4%;Sonnet 5.5 在前两项分别为 70.6% 和 83.9%。 推理强度分 low 到 max 五档,默认 medium,不能完全关闭推理。模型 ID 为 claude-haiku-5-5,已在 Claude Platform、AWS、Google Cloud 和 Azure 上线。 Sonnet 5.5 缓存读取从每百万 token 0.20 美元降到 0.10 美元,官方估计多数 Agent 任务成本因此降约 20%。Max 5x、Max 20x 每月分别送 100 和 200 美元 API 额度,Team 最多 500 美元,额度不结转。 Python 和 TypeScript SDK 同时加入电脑操作与浏览器操作的 beta 支持。
为什么值得关注:分类、路由、摘要这类大批量调用的成本直接降了一个数量级,Haiku 也第一次能胜任终端和电脑操作类任务。长上下文请求超过 10 万 token 后价格跳 5 倍,换模型前要按自己的请求长度分布算一遍。
来源:Anthropic 发布页[1] · Simon Willison[2]
02 GPT-6 进入 ChatGPT 聊天:Intelligent UI 让回答变成可交互的图表、按钮和小工具
OpenAI 10 月 7 日开始把 GPT-6 推到 ChatGPT 的聊天(Chat)标签页,并配套推出 Intelligent UI。回答不再以纯文字为主,而是按问题自动加入图表、可点按钮、表单、地图、清单,或者现场做一个小工具,比如存钱计算器、分账工具、小游戏。据 MacRumors 转述,OpenAI 说这套界面由一组可流式输出的原生组件和一个编译器组成,模型一边生成,界面一边被处理出来。GPT-6 还可以边思考边作答,The Decoder 引述 OpenAI 的数据称等待时间缩短 44%。
Plus、Pro、Business、Enterprise 用户当天开始推送,用的是 GPT-6 Sol;Free 和 Go 用户 10 月 8 日开始,用的是 GPT-6 Luna。 GPT-6 只用于聊天标签页,Work 和 Codex 背后的模型不变。 据 TechCrunch,可视化程度可以在个性化设置里调低,不想要太多图的用户可以减少。 Google 5 月已在 Gemini 应用里上线过类似的生成式界面功能。 OpenAI 发布页对本站抓取返回 403,以上细节来自 TechCrunch、MacRumors 和 The Decoder 的报道。
为什么值得关注:生成式界面从实验功能变成了最大聊天产品的默认形态,做 ChatGPT 应用或在自家产品里嵌对话的团队,用户对“回答里能直接操作”的预期会随之提高。
来源:TechCrunch[3] · MacRumors[4] · The Decoder[5]
研究
03 NVIDIA 用 Nemotron 3 微调出 IOI 和 IMO 金牌水平的系统,模型、数据和流程开源
NVIDIA 10 月 7 日在 Hugging Face 介绍,他们以 Nemotron 3 为基础,用监督微调、强化学习加上“生成、评估、修正”的推理循环,在 IOI 2026 和 IMO 2026 两项竞赛上都达到金牌线。IOI 方面,5500 亿总参数、550 亿激活的 Nemotron-3-Ultra-CC 在与人类选手相同的时间、联网和提交限制下实时参赛,拿到 535.4 分(满分 600)。IMO 方面,系统完全用自然语言作答,不调用形式化证明器或外部工具,由官方阅卷人评出 30 分(满分 42),高于 29 分的金牌线。NVIDIA 想说明的是,一套可复用的专精化流程比为每个任务重训基座更划算。
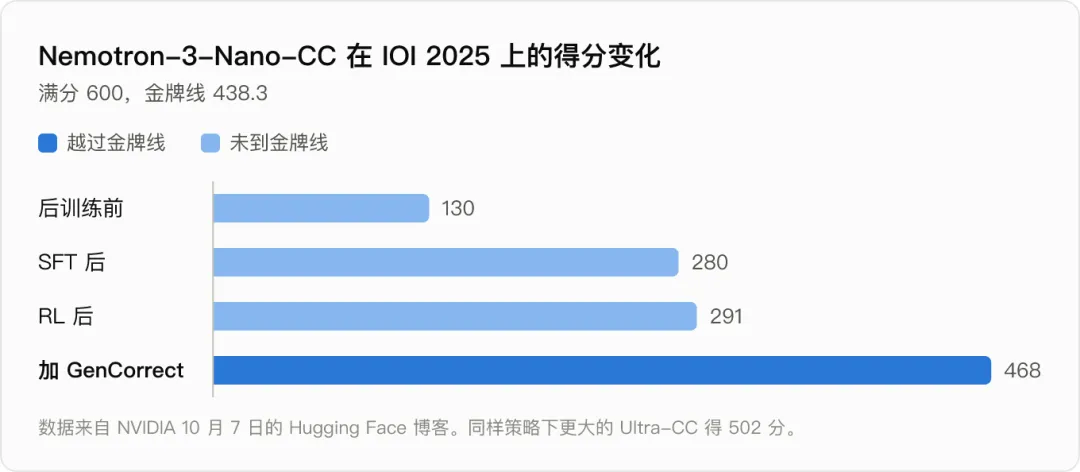
IOI 2026 成绩高于金牌线 361.12 分和人类最高分 498.27 分;但这是非官方、无监督的测试,不计入官方排名。 编程方向整理了 2.2 万道题并合成推理轨迹。在 IOI 2025 上,300 亿参数的 Nemotron-3-Nano-CC 从后训练前的 130 分升到 SFT 后 280 分、RL 后 291 分,加上迭代修正策略 GenCorrect 后到 468 分,越过 438.3 分的金牌线。 数学方向的 SFT 语料有 414,890 条,覆盖 15,818 道证明题,内容包括写证明、找漏洞、回应批评和判断证明是否完整;RL 用了 9,597 道接近模型能力边界的题。 IMO 六题中四题拿满分。最终系统同时使用 SFT 和 RL 两个检查点,NVIDIA 发现两者互补,比从单一检查点多采样更有效。 SFT、RL 检查点、两份训练数据和含 200 道奥赛题的 Nemotron-IMO-Bench 已发布在 Hugging Face,推理流程和提交的证明在 NeMo-Skills 仓库。
为什么值得关注:开源权重模型加上公开的训练数据和推理流程,就能复现奥赛金牌水平,这给想在垂直领域做专精模型的团队提供了一份可照搬的配方。
来源:NVIDIA(Hugging Face 博客)[6]
开源项目
04 开源小型决策模型一天两款:Strands Decider 2B 和 Liquid AI d1,可在本地和边缘设备跑
继 TypeSafe AI 的 Jev 之后,开源的决策模型也多了起来。Agent 框架 Strands 团队开源了 Strands Decider 2B,做法是拿 Qwen3.5-2B 作躯干,去掉语言模型输出头,换成一个约 100 万参数的指针头,给每个候选选项打分,躯干用秩为 16 的 LoRA 微调。Liquid AI 同日发布 d1 系列的 d1-3B 和实验性的 d1-omni-600M,基于自家 LFM 模型,一次前向计算就给出答案,不逐个生成 token。两者都主打低延迟,并给出置信度分数,适合 Agent 里的路由、工具选择和护栏判断。
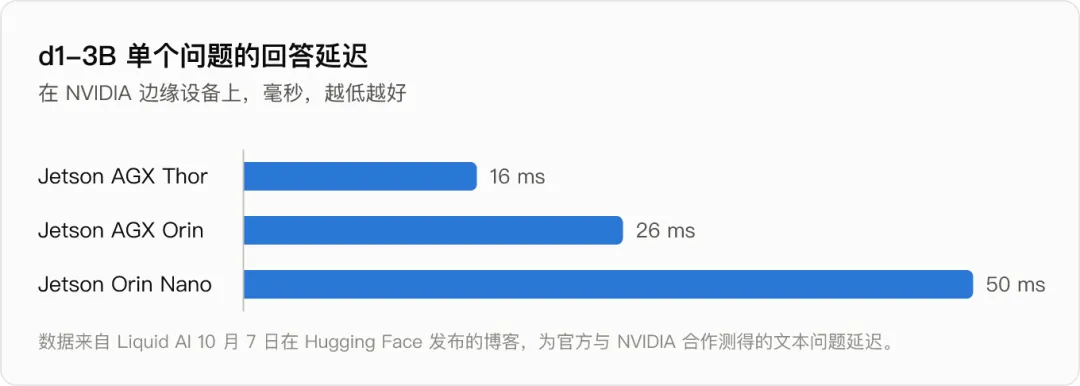
Strands Decider 2B 在 JevBench 公开集上的准确率与校准度在 2B 级别 33 个模型中排第 3;在 RTX 3090 上中位延迟约 115 毫秒,M3 MacBook 上小任务约 153 毫秒。权重、训练数据和脚本全部开源,可用 pip install strands-decider 上手。 Strands 的示例:Agent 调用工具前先让决策模型回答两个是否题,参数是否来自用户原话、现在调用是否为时过早,以此拦下 Agent 自己编出来的参数。 Liquid 称 d1-3B 在 Decision Index 0.2.1 上得 48.57 分,是 10B 以下决策模型中最高;在七个公开数据集上平均 82.9 分。 d1-3B 支持文本加图像输入;d1-omni-600M 由双向编码器改造,可接文本加图像或文本加音频,目前是早期研究版本。 决策模型的局限也很明确:Strands 指出,它们一次并行给出所有输出,复杂问题明显不如推理模型,也不能生成文本,不适合写代码、聊天或摘要。
为什么值得关注:与 OpenAI 的 Decisions API 前后脚出现,说明“让小模型做简单判断、大模型做难题”的混合 Agent 架构正在成形。需要离线或在设备端做判断的场景,现在有了可以直接下载试的开源选项。
来源:Strands Agents 博客[7] · Liquid AI(Hugging Face 博客)[8]
开发工具
05 OpenAI 推出 Decisions API:只答是否、选项和评分,只收输入费
OpenAI 上线 Decisions API 公测,这是一个只做“决策”的接口:开发者给出问题、允许的答案集合和一段文本或图片,模型只能从给定选项里返回结果。支持三种题型,是否题返回概率,选择题从预设类别里挑一个,评分题给出量表分数。The Decoder 引述 OpenAI 的说法,它比 Responses API 快约 10 倍。这类“决策模型”是 TypeSafe AI 9 月发布 Jev 之后兴起的新品类,Simon Willison 认为 OpenAI 的接口形态与 Jev 在概念上非常接近。
目前只支持 gpt-6-luna,每百万输入 token 0.10 美元,输出不收费;Jev 是每百万输入 token 4.2 美分。 与 Jev 不同,OpenAI 的决策模型支持图片输入,官方举的场景包括照片定损、客服工单路由和文档分类。 支持零数据保留,并可在美国和欧洲用于符合 HIPAA 的场景;正式版“即将推出”。 同时 OpenAI 把 API 付费等级从 5 档简化为 Build、Launch、Grow 三档,月度用量上限分别为 500、5,000 和 200,000 美元,累计充值到门槛后自动升级。 Simon Willison 已发布 llm-openai-decisions 插件,可在命令行直接调用。
为什么值得关注:输出空间被限定在给定选项内,消灭了“编造标签”这一类错误,但不保证选对。Agent 里大量的路由、护栏、工具选择判断,可以从通用大模型调用换成更快、更便宜的专用接口。
来源:The Decoder[9] · Simon Willison[10]
06 Google 向所有人开放 SynthID 检测器,可查图片、视频和音频的 AI 水印
Google 10 月 7 日宣布,SynthID 检测器即日起在全球开放(目前只有英文界面),任何人都能上传图片、视频或音频,检查它是否由 Google 或合作方的 AI 生成。这个工具去年只对部分记者、媒体从业者和研究者开放测试。它检测的是 SynthID 隐形水印,Google 自家的 Nano Banana、Veo、Lyria 以及 Gemini、Flow、Vids 等产品生成的内容都会带这种水印。需要注意的是,它不是通用的 AI 内容检测器,没有 SynthID 水印的内容查不出来。
Google 称自 2023 年推出以来,已给超过 1,800 亿张图片和视频、以及累计 24 万年时长的音频加了水印。 合作方包括 OpenAI、NVIDIA 和 Kakao,Apple 即将加入;OpenAI 另有自己的内容核查站点。 据 TechCrunch,支持 JPG、PNG、WEBP、AVIF、HEIC、GIF 等图片格式,MP4、MOV、WEBM 视频,以及 WAV、MP3、FLAC、M4A 等音频格式。 搜索、Gemini 应用和 Chrome 里已内置 SynthID 核查,Google 称每天稳定处理超过 100 万次请求。
为什么值得关注:内容平台和审核团队多了一个免费的一手核查渠道,但只能证明“是”,不能证明“不是”。微软、Meta 用的是各自的水印标准,跨厂商的统一检测仍未实现。
来源:Google 官方博客[11] · TechCrunch[12]
行业动态
07 Anthropic 把网络安全验证计划分成三档:防御、红队、特殊授权
Anthropic 10 月 6 日发布新版网络安全验证计划(Cyber Verification Program,CVP),把此前只给少数关键软件维护方的 Project Glasswing 并入其中,按工作范围分三档开放更强的网络安全能力。通用版模型对大部分网络安全工作默认拦截,通过审核的安全团队可以申请放宽。三档都能用 Opus 5.5、Sonnet 5.5、Mythos 5.1 和今后的新模型。Anthropic 用 CyScenarioBench 测了每一档的拦截效果,并公布了 Glasswing 半年来的漏洞发现数据。
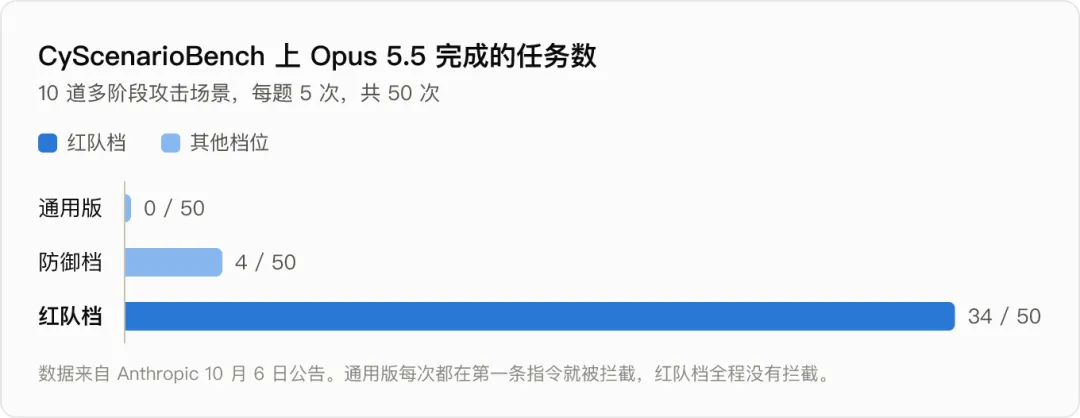
防御档面向安全运营、应急响应、恶意软件逆向和漏洞验证,适用对象包括企业和政府安全团队、地方医院和水电等关键基础设施运营方、开源维护者和有漏洞提交记录的个人研究者,申请几天内答复。 红队档增加授权渗透测试和红队演练,只对机构开放,审核需要几周;部署勒索软件、破坏物理系统等操作仍会被实时拦截。特殊授权档留给需要测试航空、电网、电信、银行间转账等系统的少数机构,与美国政府一起逐家审核,Glasswing 成员直接转入。 参加计划必须保留数据以便监测滥用;今秋 Enterprise Frontier Safeguards 上线后,可以把数据存在客户自己控制的云上。计划支持 Claude Platform、Vertex AI 和 Microsoft Foundry,Amazon Bedrock 只对 EFS 合格客户开放。 Anthropic 称 Glasswing 合作方在 2026 年 4 月至 7 月发现了至少 12.9 万个经核实的漏洞,Anthropic 自己的开源扫描另外发现约 5,500 个,其中 3.3 万多个被评为严重或高危;这些数字基于部分合作方的问卷。
为什么值得关注:安全团队不必再在“通用模型频繁拒答”和“拿不到前沿模型”之间二选一,按工作性质申请对应档位即可。分档的拦截效果有公开测试数据,也方便用户评估自己会碰到多少限制。
来源:Anthropic 公告[13]
参考资料
[1] Anthropic 发布页:https://www.anthropic.com/claude-haiku-5-5
[2] Simon Willison:https://simonwillison.net/2026/Oct/7/claude-haiku-5-5/
[3] TechCrunch:https://techcrunch.com/2026/10/07/chatgpt-is-getting-a-lot-more-visual-with-the-launch-of-a-new-interface/
[4] MacRumors:https://www.macrumors.com/2026/10/07/chatgpt-intelligent-ui/
[5] The Decoder:https://the-decoder.com/chatgpt-with-gpt-6-ditches-mostly-text-output-for-interactive-ui-with-charts-buttons-and-mini-apps/
[6] NVIDIA(Hugging Face 博客):https://huggingface.co/blog/nvidia/nemotron-ioi-and-imo-2026
[7] Strands Agents 博客:https://strandsagents.com/blog/introducing-strands-decider/
[8] Liquid AI(Hugging Face 博客):https://huggingface.co/blog/LiquidAI/open-d1
[9] The Decoder:https://the-decoder.com/openai-launches-decisions-api-that-reduces-complex-evaluations-to-yes-no-or-pick-one/
[10] Simon Willison:https://simonwillison.net/2026/Oct/6/llm-openai-decisions/
[11] Google 官方博客:https://blog.google/innovation-and-ai/models-and-research/google-deepmind/synth-id-ai-content/
[12] TechCrunch:https://techcrunch.com/2026/10/07/googles-new-synthid-website-can-identify-ai-generated-media/
[13] Anthropic 公告:https://www.anthropic.com/news/cyber-verification-program
本文由 AI 检索整理,可能存在疏漏,请以原文链接为准。点击「阅读原文」查看带链接的网页版。