ARTICLE · 1142384
回顾AI发展历程(下)
01
THE RENAME
2006:先换个名字,再重新出发
上篇讲到 2000 年,神经网络还在坐冷板凳。1990 年代末到 2000 年代初,学术会议的主流是支持向量机(SVM,Support Vector Machine)、随机森林(Random Forest)、提升方法。神经网络发论文难,拿经费更难。
转机不是从一次算法突破开始的,是从一次改名开始的。
2006 年,辛顿和他的学生发表了几篇论文,提出“深度信念网络”(Deep Belief Network,DBN)。核心是一个训练技巧:先让网络每一层单独做无监督预训练(Unsupervised Pre-training),把权重初始化到一个合理的位置,再整体微调(Fine-tuning)。这一步解决的是深层网络训不动的问题:层数一多,误差从后往前回传时梯度(Gradient)会衰减到接近于零,最前面那几层几乎学不到东西。
技术评述:这个技巧本身的意义不在模型,在它把“深”这件事变可行了。此前大家只用浅层模型,不是不知道深的好,是深层训不出来。现在有了可用的初始化办法,层数第一次可以往上加。
另一件事当时看起来只是措辞。此前这批人管自己做的是“多层神经网络”或者“连接主义”(Connectionism),背着三十年的坏名声;2006 年之后,他们开始统一用“深度学习”(Deep Learning)这个说法。
同一个东西,换了个名字,重新被听进去了。这话听着滑稽,但它就是发生过。
(顺带说一句,这跟 1987 年那次改名正好相反:那一次是行业把“人工智能”四个字藏起来,这一次是把神经网络重新立起来。)
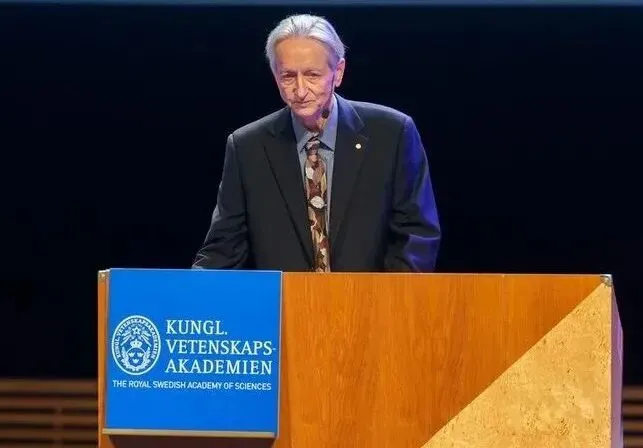
杰弗里·辛顿(Geoffrey Hinton)在诺贝尔奖讲座上,2024 年 12 月|Niklas Elmehed,诺贝尔奖官方
02
THE DATASET
2009:李飞飞去干了那件累活
算法有了,还缺两样东西:数据,算力。先说数据。
2009 年,普林斯顿的助理教授李飞飞(Fei-Fei Li)和同事发表了 ImageNet:一个包含一千多万张标注图片、两万多个类别的图像数据库。
技术评述:ImageNet 解决的是神经网络的“饥饿”问题。此前公开的图像数据集大多只有几万张,模型很容易背下训练集,换一批图就失效。要让深层网络学到通用的图像特征,需要的是数量级更大的标注数据。
真正难的不是想法,是执行。一千多万张图要一张张标出来,李飞飞团队没有雇人逐张标,而是把任务拆细,放到亚马逊的众包(Crowdsourcing)平台上,招全球的标注者来做。这件事在当时的学术评价体系里几乎不加分,是典型的脏活、慢活。
李飞飞(Fei-Fei Li),2017 年|CC BY 2.0
后来发生的事我们都知道了。2010 年起,基于 ImageNet 的 ILSVRC(ImageNet Large Scale Visual Recognition Challenge)挑战赛成了计算机视觉的年度擂台。神经网络重新回到舞台中央,起点就在这个数据库上。
03
THE SHOT
2012:AlexNet,方向在一夜之间逆转
2012 年,辛顿的两个学生,亚历克斯·克里泽夫斯基(Alex Krizhevsky)和伊利亚·苏茨克维(Ilya Sutskever),用卷积神经网络(CNN,Convolutional Neural Network)参加了 ILSVRC。这个网络有八层,后来被叫作 AlexNet。
成绩是这样:top-5 错误率 15.3%,第二名 26.2%。在一个已经卷了很多年的比赛里,这个差距不像是同一代技术之间的。
技术评述:AlexNet 不是算法上的原创突破,它是三件事凑齐了。
第一,数据。用的是 ImageNet 那一百多万张标注图。
第二,算力。他们把两块消费级显卡(GPU,Graphics Processing Unit)GTX 580 拿来训练网络。GPU 原本是为游戏画面设计的,长处是并行;而神经网络的训练恰好是海量的矩阵运算,天然适合并行。
第三,几个关键改动。用 ReLU(Rectified Linear Unit)替换传统的饱和激活函数,加快收敛;用 Dropout 随机丢弃一部分神经元,压住过拟合(Overfitting);再加上图像增强。三样合在一起,深层网络第一次在真实任务上稳定跑赢。
方向没有问题,之前缺的是燃料。这一次燃料到齐了。
再补一个后来的细节。2012 年底,辛顿和这两个学生成立了一家公司,叫 DNNresearch,没有产品,没有营收,就是一个三人团队。他们在 NIPS 会议期间办了一场拍卖,起拍价 50 万美元。几家公司通过邮件轮流出价,百度一度加到 4400 万美元。最后辛顿选了谷歌,理由是谷歌答应让他继续做基础研究。
三个人的空壳公司拍到 4400 万美元,这被看作 AI 商业化重启的标志性一幕。
04
THE INTUITION
2016:AlphaGo 与李世石
2016 年 3 月,DeepMind 的 AlphaGo 在首尔以 4 比 1 战胜围棋世界冠军李世石。
围棋为什么比国际象棋难?国际象棋每一步的分支大约 35 个,围棋大约 250 个。深蓝当年那种“穷举加评估”的路子,到围棋这里直接搜不完。
技术评述:AlphaGo 的做法是把三样东西叠起来。一个策略网络(Policy Network),用人类棋谱训练,负责“这一手往哪儿下”;一个价值网络(Value Network),负责“照这么走下去,局面是赢是输”;外面套一层蒙特卡洛树搜索(MCTS,Monte Carlo Tree Search),把两者结合起来,在关键分支上多算,在没希望的分支上早停。三样东西都是神经网络,都不是规则。
第四局是整场比赛里最有名的一局。李世石下出第 78 手,一步在职业棋手看来不合常理的“挖”。AlphaGo 之后的应对明显乱了,输掉了这一局。事后的分析认为,在它的估算里,人类走出这一手的概率低到万分之一,所以它几乎没有为这个局面准备过应对。
这一局透露的信息比前三局加起来都多:它会算,也会漏。而它漏的那个地方,恰好是人的直觉出没的地方。
05
THE ARCHITECTURE
2017:Transformer,把地基换掉
2017 年 6 月,谷歌的八位研究者发表了一篇论文,题目是《Attention Is All You Need》,提出的结构叫 Transformer。
技术评述:它解决的问题是,此前的循环网络(RNN,Recurrent Neural Network,LSTM 那一类)必须一个词一个词地顺序处理,没法并行,长距离的信息也容易衰减。Transformer 换了办法:句子里每个词都和其他所有词直接算一次相关度,按相关度加权求和,这就是自注意力(Self-Attention)。好处有两个:任意两个位置之间都是“一步之遥”,而且整个计算可以并行。
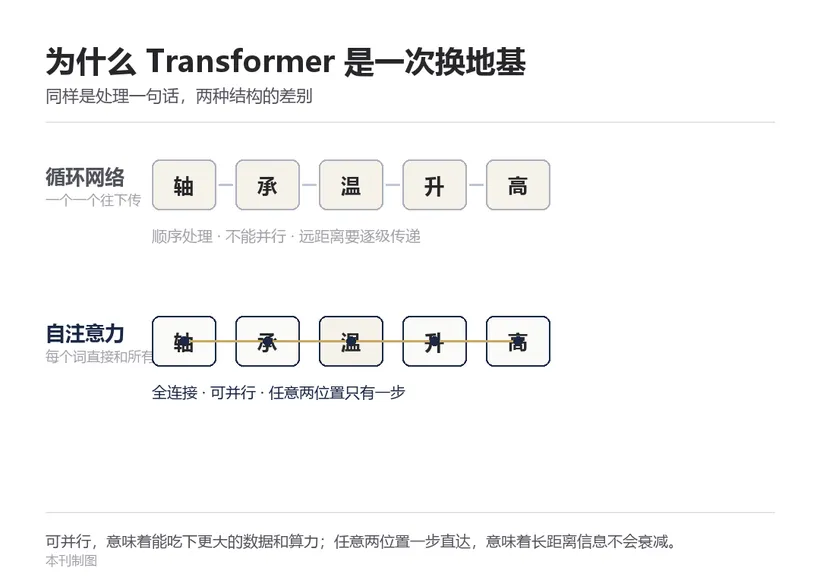
循环网络与自注意力的结构对比
这两个好处的兑现时间不一样。
并行能力的价值,当时就能看见:可以喂进去更大的数据、更大的算力。
另一件事要到几年后才显出来:它把“堆规模”变成了一条走得通的路。
今天所有的大语言模型(LLM,Large Language Model),骨架都是它。
06
THE SCALING
2018—2020:图灵奖,与一条没写进论文的规律
2018 年,图灵奖(Turing Award)颁给了辛顿、杨立昆(Yann LeCun)、约书亚·本吉奥(Yoshua Bengio),表彰他们在深度神经网络上的奠基性工作。三十多年前被导师每周劝退一次的方向,拿到了计算机领域的最高奖项。
2020 年,OpenAI 发布 GPT-3,1750 亿参数。它做的事情很朴素:给一段前文,预测下一个词,然后重复。但它证明了一件超出预期的事:只要模型足够大、数据足够多,很多能力会自己长出来。不用专门训练,给几个例子,它就会做。
这件事后来被总结成“规模定律”(Scaling Law):损失随模型规模、数据量、算力的增长而平滑下降,并且在一定范围内可以预测。
技术评述:规模化不是“大力出奇迹”那么简单,它需要三样东西同时到位:Transformer 提供可并行的结构,GPU 集群提供算力,互联网提供语料。但反过来看,这是 AI 历史上第一次出现一条不需要新算法就能持续变强的路线:只要继续加。
07
THE PUBLIC
2022:ChatGPT,最快的一次技术普及
2022 年 11 月 30 日,OpenAI 发布 ChatGPT。两个月后,月活用户破亿。这项纪录此前属于 TikTok,用了九个月。
技术评述:ChatGPT 和 GPT-3 的关键差别,是一步对齐(Alignment)工作,也就是基于人类反馈的强化学习(RLHF,Reinforcement Learning from Human Feedback)。做法是:先让人给模型的多个回答排序,用这些排序训练一个打分模型,再用打分模型去调整大模型说话的习惯。它没有给模型增加知识,改的是模型“愿意用什么方式回答”。
山姆·奥尔特曼(Sam Altman),OpenAI 联合创始人|CC BY 2.0
效果是决定性的。同一个基座模型(Base Model),对齐之后从一台续写引擎,变成了一个能对话的对象。
这一步的意义,可能比它的技术含量更大。它让一项前沿技术第一次以产品的形态,落到了普通人手里。
08
THE TURN
2024—2025:诺贝尔奖,与辛顿的转身
2024 年 10 月,诺贝尔物理学奖授予约翰·霍普菲尔德(John Hopfield)和杰弗里·辛顿,表彰他们在人工神经网络上的基础性发现。颁奖理由里有一个关键点:这些网络本身就是物理系统,能量、状态、稳定性都是物理概念。1985 年那台玻尔兹曼机(Boltzmann Machine),用的正是统计力学的框架。
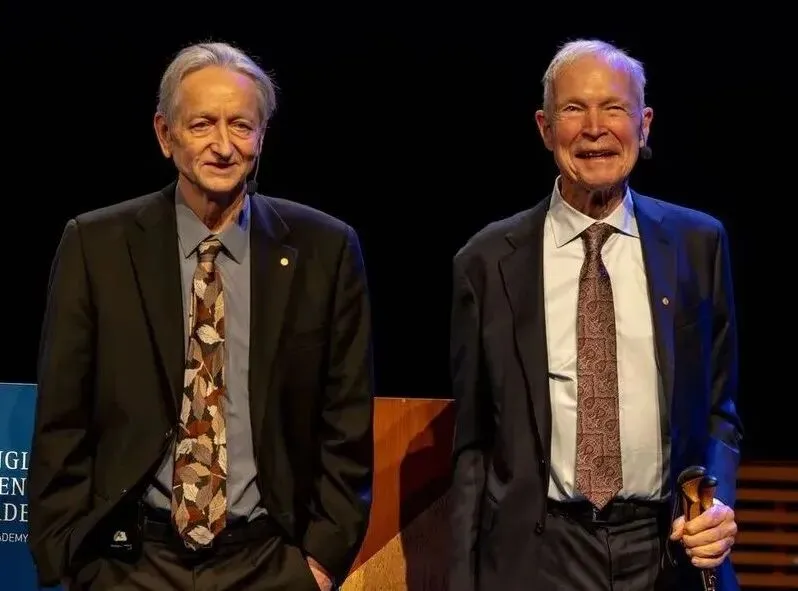
约翰·霍普菲尔德(John Hopfield,左)与杰弗里·辛顿,2024 年诺贝尔物理学奖得主|CC BY-SA 4.0
2023 年 5 月,辛顿已经从谷歌辞职。他离开时说得很清楚:他要能自由地谈论风险。
2025 年 7 月 26 日,他第一次到中国,在上海世界人工智能大会发表演讲,题目是《数字智能是否会取代生物智能》。
他把人类和 AI 的关系比作养一只小老虎当宠物:幼崽很可爱,但它长大后是否还认你,没有人能保证。他说,人类没有“摆脱它”这个选项,因为在医疗、教育、气候变化这些领域,它已经不可替代。他给出的方向是,需要一套让 AI“不想夺取控制权”的技术,而这套技术与让 AI 变聪明的技术在一定程度上是分开的;所以各国在其他事情上未必谈得拢,但这件事可以先合作起来。
他在演讲里说的那句话,后来被反复引用:我花了一生让 AI 变得智能,现在要花余生让它变得友善。
09
THE PRESENT
2026:GPT-6 Astra,机器开始教机器
2026 年 9 月,OpenAI 发布 GPT-6 Astra。
挑几个硬的参数:上下文窗口(Context Window)105 万 token,单次输出上限 12.8 万 token;API 定价为每百万输入 token 10 美元、每百万输出 token 50 美元。
几个被反复引用的基准(Benchmark):ARC-AGI-3 官方口径 98.6%,上一代 GPT-5.6 Sol 是 7.8%;前沿数学的 FrontierMath 第四档 97.6%;网络安全测试 ExploitBench 100%。它也是 OpenAI 第一个达到内部“关键级”网络安全能力的模型。按这家公司的定义,这类模型拿到工具和权限之后,能在防护严密的系统里找出此前未知的漏洞,并写出利用方法。
发布当天,OpenAI 总裁布洛克曼(Greg Brockman)说了一句被引用最多的话:现在感觉自己身处 AGI 时代,这种感受并不算离谱。
技术评述:这一代真正值得注意的不是分数,是训练方式。GPT-6 的预训练(Pre-training)在 2026 年 3 月 24 日完成,用的是一个约十万块 H100 的集群。而按 OpenAI 的介绍,这是他们第一次让上一代模型参与监督下一代模型的训练。
也就是说,从这一代开始,AI 开始生产自己的训练信号。
回到 1950 年,图灵问的是“机器能不能思考”。七十六年之后,我们手上多了一个更具体的问题:当机器开始教机器,人还在链条的哪一格。
10
THE FIELD
不止 GPT:这条路上还有几家,还有我们
上面这一串节点,几乎都发生在 OpenAI 一家身上。但过去六年,跑在同一条路上的远不止它一家。2022 年之后,大模型从“一家领先”变成了“一群并跑”。
Anthropic 的 Claude。2021 年,OpenAI 的前研究副总裁达里奥·阿莫代伊(Dario Amodei)带着一批人出走,创办了 Anthropic。2023 年 3 月,Claude 首发。它走的技术路线和 GPT 一样,差别在取向:把安全和“企业可用”放在前面,提出了一套叫“宪法 AI”(Constitutional AI)的对齐方法。2024 年 10 月,Claude 上线 computer use,能直接操作电脑界面;此后它把主要力气压在写代码和智能体(Agent)上,2026 年迭代到 Opus 5。
中国的 DeepSeek。2024 年 12 月,DeepSeek-V3 发布。真正让行业震动的不是分数,是账单:公开报道里,这一代模型的训练成本是百万美元量级,而同级模型的常见说法是数千万到上亿美元。2025 年 1 月,R1 发布,用强化学习(RL,Reinforcement Learning)直接把推理能力训了出来,把“推理模型、开放权重(Open Weights)、MIT 许可”写进了一句话里。它证明了一件事:前沿能力不一定要烧掉最多的钱。
智谱的 GLM。清华系团队,2023 年做出第一代对话模型 ChatGLM,开源版本全球下载量上千万。之后一路迭代:GLM-4、GLM-4.5、GLM-5,到 2026 年 8 月的 GLM-5.3。它的技术底色和主流略有不同:预训练用的是“自回归空白填充”(Autoregressive Blank Infilling),把 BERT 的双向理解和 GPT 的生成能力拼在一起。
同一时期还有一批:阿里的通义千问(Qwen)、月之暗面的 Kimi、MiniMax,以及 Meta 的 Llama、谷歌的 Gemini、xAI 的 Grok。
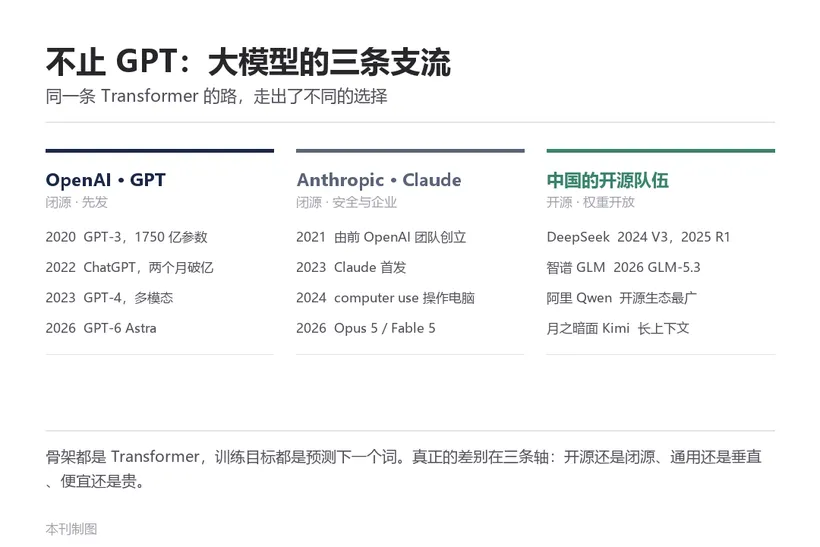
主流大模型的三条支流|本刊制图
技术评述:这些模型的骨架都是 Transformer,训练目标都是预测下一个 token,都在同一条缩放曲线上。差别在三条轴:开源还是闭源、通用还是垂直、便宜还是贵。对使用者来说,这意味着选择第一次变多了,你不必用最贵的那一个。
对做工业 AI 的人来说,这一点比谁的分高更重要。一个可以本地部署、权重开放、成本可控的模型,和只有一个闭源接口的模型,能做的事完全不一样。
11
THE DEBATE
物理模型与世界模型:下一场分歧
大模型正当时,但有一批人不认为这条路能走到终点。声音最大的,是杨立昆。
他从 2022 年就在说同一件事:大语言模型靠预测下一个词,学不到世界是怎么运转的。他举过一个例子:问“洗车店在一百米外,我该走过去吗”,不少模型会答“该”,因为近;它漏掉了“车得开进去”这个最基本的前提。这不是幻觉,是模型根本没有对物理世界的内部建模。
2025 年 11 月,他离开工作了十二年的 Meta。2026 年 3 月,他在巴黎创办 AMI Labs,种子轮融了 10.3 亿美元,是欧洲历史上最大的一笔种子轮,投后估值 35 亿美元。他赌的是一个走了二十多年的方向:世界模型(World Model)。
这里要把两个概念分清楚,它们经常被混在一起。
物理模型(Physical Model):把物理规律显式写进模型。方程、机理、仿真引擎,比如有限元(FEM,Finite Element Method)、多体动力学、计算流体力学(CFD,Computational Fluid Dynamics),都属于这一类。它的长处是可解释、可复现,每一步都有出处;短处是真实世界的复杂写不全,摩擦、磨损、材料非线性,建模成本极高。这条路,本质上还是“把知识写进去”。
世界模型(World Model):让模型从视频、图像、传感器数据里,自己学出一个能预测“下一刻世界会变成什么样”的内部模拟器。它不写方程。长处是能处理写不出方程的复杂现象;短处是不可解释、可能出现幻觉、物理一致性没法保证。这条路,是“让机器自己从数据里找”。
所以物理模型与世界模型的分野,说到底,还是七十年前那场“符号对连接”的争论——只是这一次,战场从文字换到了物理世界。
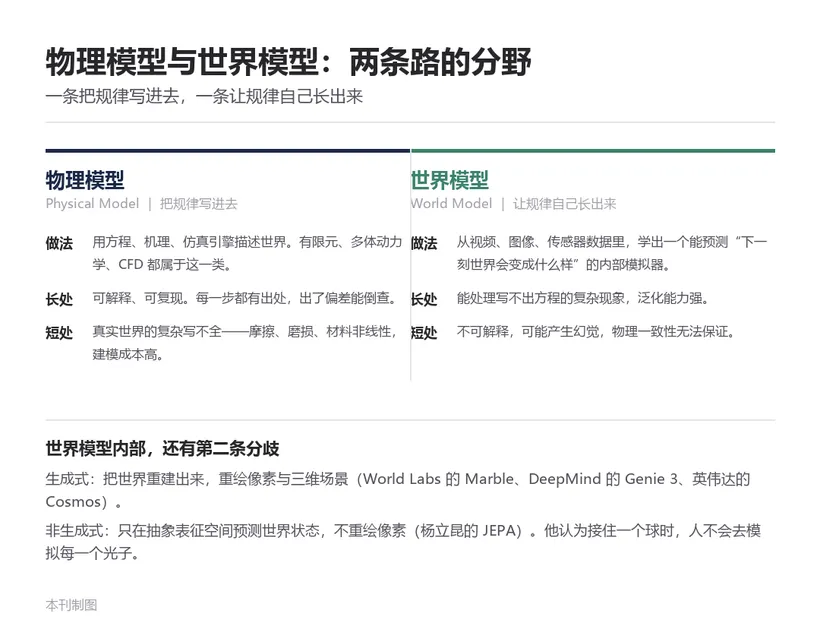
物理模型与世界模型对照|本刊制图
世界模型内部,还有第二条分歧。
一条是生成式(Generative):把世界重建出来,重绘像素和三维场景。李飞飞的 World Labs 走的是这一路,从一张图生成可交互的三维场景;谷歌 DeepMind 的 Genie 3 做实时交互式世界生成;英伟达的 Cosmos 用约两千万小时真实数据训练了一个“世界基础模型”,已经在给 Figure、Uber、小鹏做机器人和自动驾驶开发。
另一条是非生成式,代表是杨立昆 2022 年提出的联合嵌入预测架构(JEPA,Joint Embedding Predictive Architecture)。它的做法是不重建像素,只在抽象的表征空间里预测世界的下一个状态。杨立昆的比喻是:你伸手接住一个球的时候,不会去模拟场景里的每一个光子,你跑的是一个压缩过的心智模拟。他的团队做出来的 LeWorldModel 只有 1500 万参数,在 Push-T 这类控制任务上成功率做到 96%,而主流的视觉-语言-动作模型(VLA,Vision-Language-Action)动辄几十亿到上百亿参数。
杨立昆的判断很重:大语言模型是“死路”,VLA“基本上已经失败”,而且“本质上不安全”,因为模型没有内部的世界模型,就无法预判自己动作的物理后果。他给了一个具体的时间点:到 2027 年初,“需要范式转变”这件事会变得不言而喻。他也留了余地:这说的是认知上的转变,不等于到那时候就有答案了。
他并不主张用世界模型取代大语言模型,而是分工:大语言模型管语言和知识,当接口;世界模型管物理和规划;外面再套一层管安全约束的决策层。他用认知科学的说法打比方:大语言模型是“系统一”,快,凭直觉;世界模型是“系统二”,慢,会推演。
12
THE DEAL
82 亿美元:芯片公司把“世界模型”买了下来
2026 年 9 月 28 日,AMD 宣布收购 World Labs,全股票交易,作价约 82 亿美元(约 550 亿元人民币)。这是 AMD 历史上第二大收购,仅次于 2022 年约 490 亿美元买下赛灵思(Xilinx)。
World Labs 是李飞飞 2024 年 4 月创办的,总部在旧金山,做的是空间智能(Spatial Intelligence)和世界模型。2024 年底推出第一个产品 Marble,能从一张图或一段文字生成可漫游、可编辑的三维场景;2026 年 9 月发布 Atlas,号称全球首个多模态世界模型,支持像素级的相机控制、三维重建和视频换机位,还能把一段真实场景快速复制成机器人训练环境。
融资节奏也快。2024 年 9 月融资 2.3 亿美元,估值 10 亿美元;2026 年 2 月又融约 10 亿美元,Autodesk 领投,AMD 和英伟达都跟了进来,估值约 50 亿美元。七个月后,整家公司被 AMD 买下。
人事安排是这次交易最受关注的部分。李飞飞出任 AMD 执行副总裁兼首席科学家(Executive Vice President and Chief Scientist),直接向董事长兼 CEO 苏姿丰(Lisa Su)汇报;两位联合创始人继续带团队。她保留斯坦福的教职。交易预计 2026 年底前完成,还要过监管。
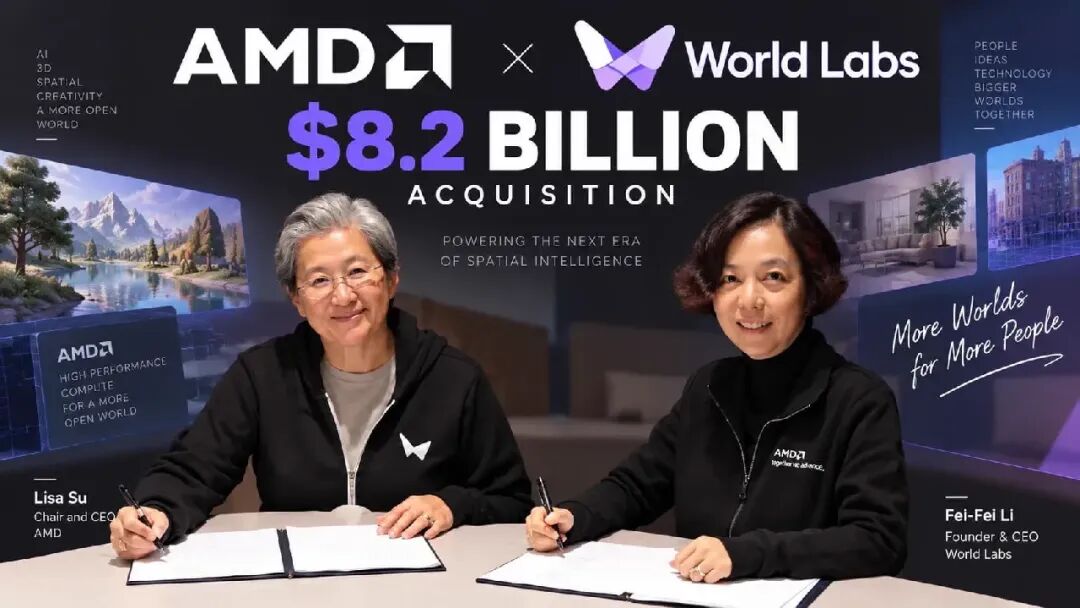
AMD 收购 World Labs
技术评述:芯片公司买模型公司,这是头一回。AMD 的长处在硬件(CPU、GPU),短处在模型和软件生态。苏姿丰把理由说得很直白:“你对整个端到端流程了解得越深,就越能构建出更好的系统。”换句话说,要设计下一代 AI 芯片,你得先知道下一代模型长什么样。而世界模型需要的算力形态(视频、三维、仿真),和大语言模型需要的不一样。买下做世界模型的人,等于提前拿到了下一代工作负载的路线图。
这一步的分量,不在一笔交易本身。2026 年一个季度里,世界模型方向涌进了二十多亿美元:World Labs 估值 50 亿,杨立昆的 AMI Labs 估值 35 亿。当一家芯片公司愿意掏 82 亿美元买“世界模型”,说明这条路线已经不是论文里的争论了。
回到 1950 年图灵那个问题。七十六年里,我们先把知识写进去,又学会让机器自己从数据里找规律。现在,问题换成了:除了文字,机器能不能理解一个有重量、有摩擦、有因果的世界。这一次下注的,是卖算力的人。
∞
THE END
下篇小结
把上下两篇并起来看,AI 的七十六年只走了两步。
第一步,把知识写进机器。花掉三十年,撞在墙上:知识写不完,写下来的还会过期。
第二步,让机器自己从数据里把知识找出来。花掉四十年,走通了。从感知机到反向传播,卷积网络, 再Transformer,直到 GPT-6。
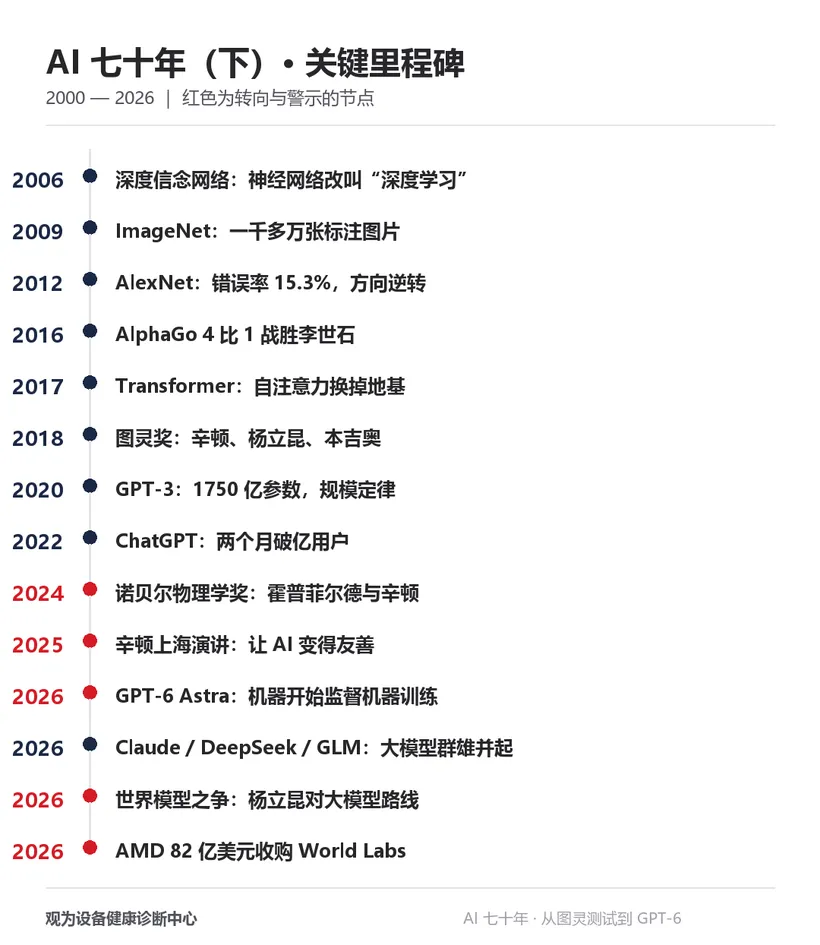
下篇关键节点,红色为转向与警示的节点|本刊制图
这两步之间隔的不是一次算法突破,是四样东西凑齐了:可并行的结构、足够大的算力、足够大的数据,以及一群愿意在冷板凳上坐二十年的人。
最后一样最容易被低估。辛顿 1972 年进爱丁堡读神经网络的时候,导师每周劝他放弃一次;他 2018 年拿到图灵奖,中间隔了四十六年。这四十六年里的绝大部分时间,没有掌声,也没有经费。
而第二步还没有走完。2026 年的这两场争论(大模型够不够用,世界模型是不是下一步)说明,这条路上没有终点,只有下一个问题。
下篇到此。这个系列讲的是别人的历史。我们这个行业也走过一条类似的路,那是另一个题目,改天再写。
互动话题:你还知道哪些起步时没人相信、最后却改变了整个领域的科研项目?欢迎在留言区聊聊。
联系我们
0510-85388855 | contact@mhccenter.com
www.mhccenter.com
 | 让设备隐患「看得见」「听得到」「诊得准」。 从专业的国际振动分析师培训认证,到视觉增强系统、「工业小郎中」无线智能诊断分析服务、安德时多功能振动分析仪,再到 MechAI 智能诊断分析平台,我们把人才培养、多模态数据感知、设备检测、智能诊断和 AI 驱动的全生命周期设备健康管理连成一套完整方案,陪着企业更早发现隐患、提升资产价值。 |
常稳安
本文由观为监测设备健康研究院整理撰写。史料照片来自 Wikimedia Commons(公有领域或 CC 授权)。我们长期做工业装备的预知性维护与故障诊断,也长期跟踪 AI 技术本身的演进。这个系列梳理 AI 七十年的关键节点,把每一步的技术和人物讲清楚。
如果这篇有收获,欢迎点赞、在看、转发三连。我们下期见。