ARTICLE · 1142391
Nature:AI自己“悟”出了城市人流的引力定律
开篇问题 预测城市之间的人流,到底需要多复杂的模型?深度学习可以塞进POI、商业、教育、人口等几十个变量,但代价是模型越来越难解释。Nature Communications 这篇论文反过来问:如果让“机器科学家”自己寻找公式,会不会找到一个更简单、但预测并不差的答案? |
答案非常有意思:Bayesian Machine Scientist(BMS)自动搜索出的闭式数学模型,只需要出发地人口、目的地人口和两地距离三个变量,就能在多个数据集和空间尺度上达到与复杂机器学习模型相当的预测能力,并在跨区域外推中表现出更好的稳健性。
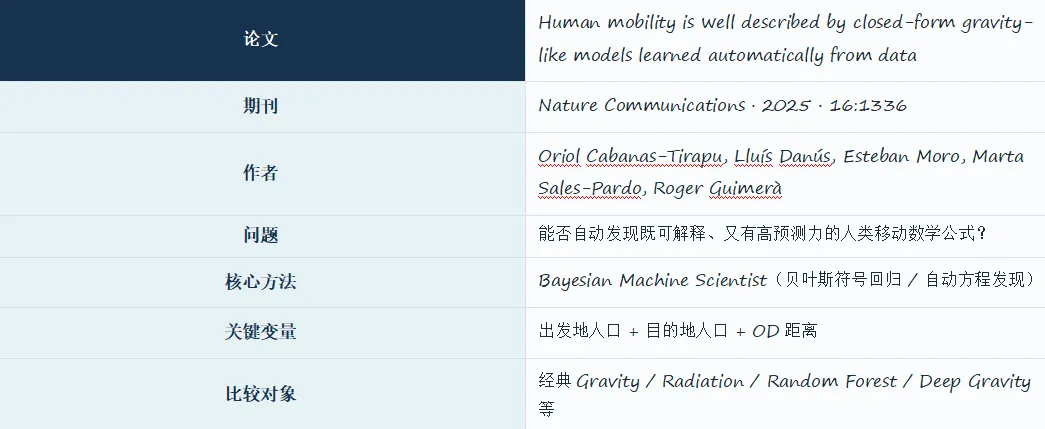
一句话读懂 这篇论文不是“用AI预测人流”这么简单,而是让AI自动发现一个人类能够读懂的公式:城市间流动随两端人口增加而增强,随距离增加而衰减,而且这种结构在不同地区反复出现。 |
01 一个经典矛盾:简单模型能解释,深度模型更会预测
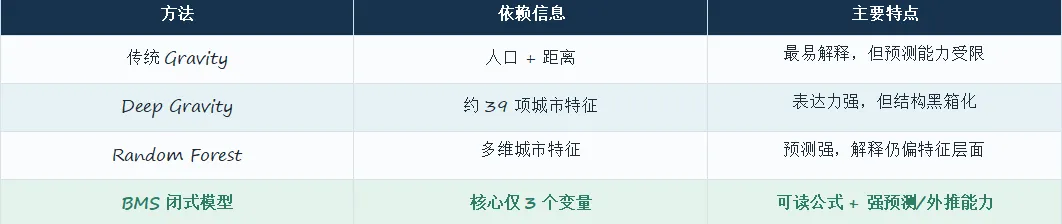
人类移动研究长期存在两条路线。经典引力模型很像牛顿万有引力:两个地方越“有质量”、距离越近,流动越强。它结构清楚、容易解释,但往往牺牲预测精度。
另一边是机器学习和深度学习。Deep Gravity 可以同时使用人口、POI等大量特征,通常比传统引力模型更准确,但模型内部究竟学到了什么,很难被直接写成一个可读的数学规律。
论文真正的问题 有没有可能同时拿到“两边的好处”:模型像引力公式一样简单,却拥有接近复杂机器学习的预测能力? |
02 BMS做的事情:不是调一个网络,而是在“公式空间”里找答案
Bayesian Machine Scientist 可以理解为一种贝叶斯符号回归:它不是预先规定公式长什么样,而是在大量候选数学表达式中进行搜索,并根据数据拟合能力与模型复杂度共同判断哪些公式更可信。
研究者在美国纽约、马萨诸塞、加州、佛州、华盛顿州和得州的人类移动数据上训练模型。关键的是,测试城市在训练阶段完全不可见,因此实验不是简单随机抽样,而是在验证模型能否迁移到新的城市区域。
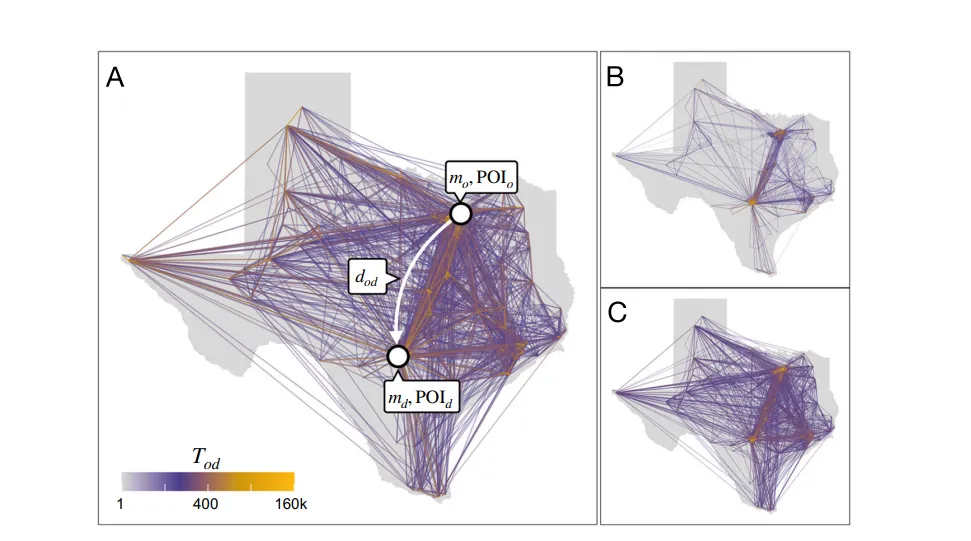
原论文 Figure 1|得州真实OD流、Deep Gravity预测与BMS闭式模型预测对比。
Figure 1 很直观:A是真实流动网络,B是使用39个特征的Deep Gravity,C则是BMS自动找到的闭式模型。BMS只使用三项信息——出发地人口、目的地人口和距离,却能恢复出非常接近真实分布的流动结构。
03 最反直觉的结果:复杂模型并没有形成压倒性优势
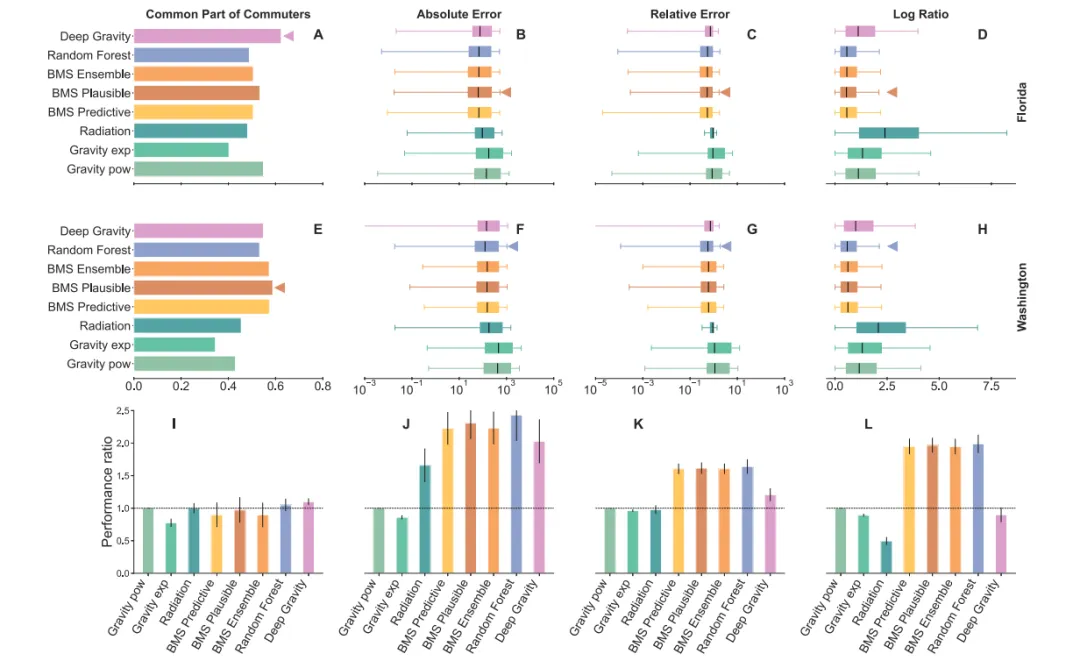
原论文 Figure 3|六个州、四类指标下的模型预测表现。
作者没有只挑一个指标。除了移动研究常见的 CPC,还比较绝对误差、相对误差和对数比误差,因为城市OD流往往跨越多个数量级,只看大流量容易掩盖小流量上的系统性偏差。
结果并不是“BMS每个指标都第一”。更准确地说:BMS闭式模型整体达到与最强机器学习方法相当的水平,并在不少州和指标上占优;Random Forest也在部分场景最优。Nature正式版强调的结论是:简单闭式模型能够达到复杂机器学习的预测水平,同时具有更好的外推能力。
为什么这比单纯刷榜更重要? 如果一个只有3个输入变量的公式,能接近依赖几十个变量的黑箱模型,那么研究者获得的不只是一个预测器,还获得了一个可解释、可迁移、能继续被理论分析的规律。 |
04 机器科学家最后找到了什么?——“引力模型”竟然自己长出来了
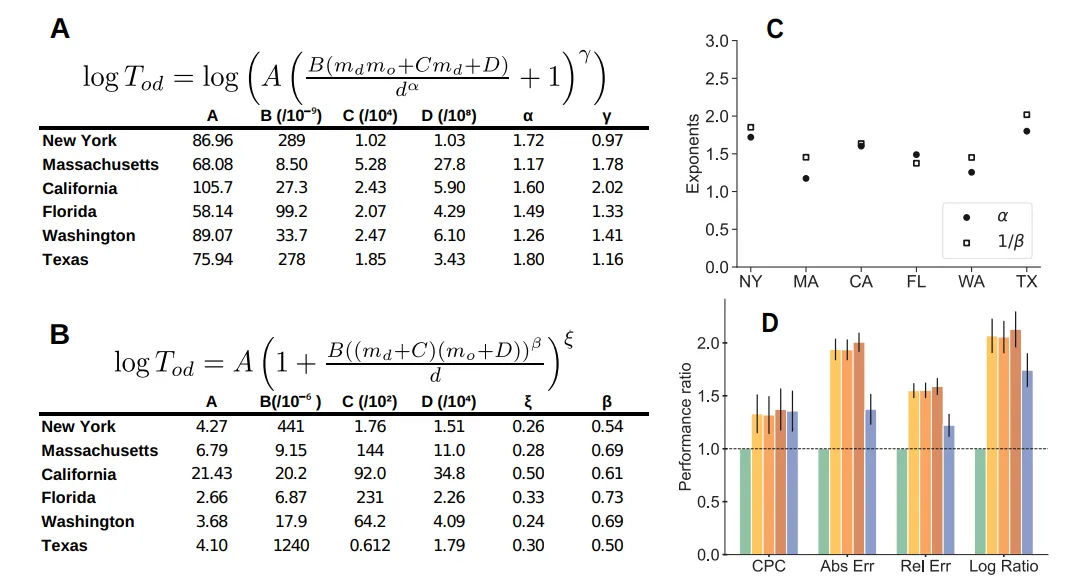
原论文 Figure 6|BMS自动识别的代表性闭式模型及距离/人口指数关系。
更有意思的是,研究者并没有告诉BMS“你应该找一个引力公式”。但在采样得到的大量高质量模型中,绝大多数都包含明显的gravity-like结构:流动随出发地和目的地人口的组合增加,随地理距离增加而下降。
论文进一步分析105个采样模型:17%是纯粹的gravity-like模型,70%包含gravity-like项并叠加其他项,只有13%完全不包含这类结构。也就是说,经典引力思想并不是研究者硬塞给模型的,而是从数据中反复“长”出来的。
在代表性闭式模型中,距离和人口项的指数关系在不同州也相当集中。作者据此认为,聚合尺度下的人类移动可能存在跨数据集、跨地区较稳定的统计规律。
05 为什么“跨区域外推”比普通测试集更值得关注?
如果训练集和测试集来自同一批城市随机拆分,模型可能只是在记住这些城市的统计特征。论文采用的是municipality-level拆分:测试区域的城市、人口特征和相互距离在训练时都没有出现。
这正是闭式模型的优势所在。深度模型可以通过大量特征提升拟合能力,但也更容易把特定城市的细节一起学进去;简单公式保留的变量更少,反而可能更容易捕捉跨区域稳定的规律。
06 客观评价:它不是在证明“深度学习没用”
值得学习 • Nature Communications 2025,问题非常干净:预测性能与可解释性如何兼得; • 用符号回归自动发现公式,而不是人工先规定公式形状; • 测试区域与训练区域分离,更接近真正的空间外推; • 从“预测”进一步走向“发现规律”,很适合交通与复杂系统研究。 | 需要注意 • 结论成立在聚合人流尺度,不等于个体轨迹也能由3个变量描述; • Deep Gravity等基线使用的额外特征并未在所有尺度都转化成优势,但不能据此否定深度学习; • 闭式公式描述的是统计规律,不等于已经证明了人口与距离的严格因果机制; • 不同数据源、国家、出行目的和突发事件下,规律仍需要继续验证。 |
07 如果继续做,可以怎么改?
方向一:动态“公式发现”——让规律随城市状态变化 当前闭式关系更偏静态聚合。可以把节假日、事故、天气和政策变化加入上下文,让符号模型在不同状态下自动切换或修正公式,研究“什么时候引力规律会失效”。 |
方向二:图神经网络 + 符号蒸馏 先训练高性能时空图网络,再让符号回归去拟合其局部响应和跨节点作用,把黑箱模型中的空间传播规律蒸馏成可读公式,实现“先追求性能,再提取规律”。 |
方向三:可信外推——给闭式公式配上预测区间 简单公式也会在新城市、极端事件和分布漂移下失效。可以结合Conformal Prediction,为每个OD预测同时给出可靠区间,并在线监测何时需要重新发现或更新公式。 |
08 最后总结
这篇论文最有传播力的地方,不是“简单模型战胜大模型”,而是它展示了AI另一种价值:AI不仅可以给答案,还可以帮助人类重新发现能够写在纸上的规律。
在人类移动这个问题上,复杂城市行为经过聚合后,人口与距离依然留下了稳定而强烈的统计结构。对交通预测研究来说,这提醒我们:更深的网络不是唯一方向,“高性能 + 可解释 + 可外推”的模型同样值得认真追。
论文:Nature Communications 2025|Human mobility is well described by closed-form gravity-like models learned automatically from data