ARTICLE · 1142712
olmOCR:PDF 一转文字就串行、错表格?先把知识库的入口修好
把几十份研报和论文往知识库里塞,往往第一步“PDF 转文字”就直接踩坑:双栏排版左右疯狂打架、表格里的金额脱离表头满地乱滚、页眉页脚隔几行就蹦出来污染上下文。如果前置解析吐出来的就是一堆乱码,后面分块(Chunking)切得再细、向量检索做得再讲究,也不过是在给垃圾数据做深加工。
Ai2 开源的 olmOCR 切的就是这个工程痛点:把 PDF、PNG、JPEG 等文档还原成结构干净、能直接入库的 Markdown,专门攻克自然阅读顺序、复杂表格、数学公式与多栏排版混排难题。
它最大的亮点在于思路转变:不再把 PDF 当成一串生硬的字符流去生搬硬套,而是当成需要理解视觉版面的二维页面来处理。
它是怎么看懂页面的?
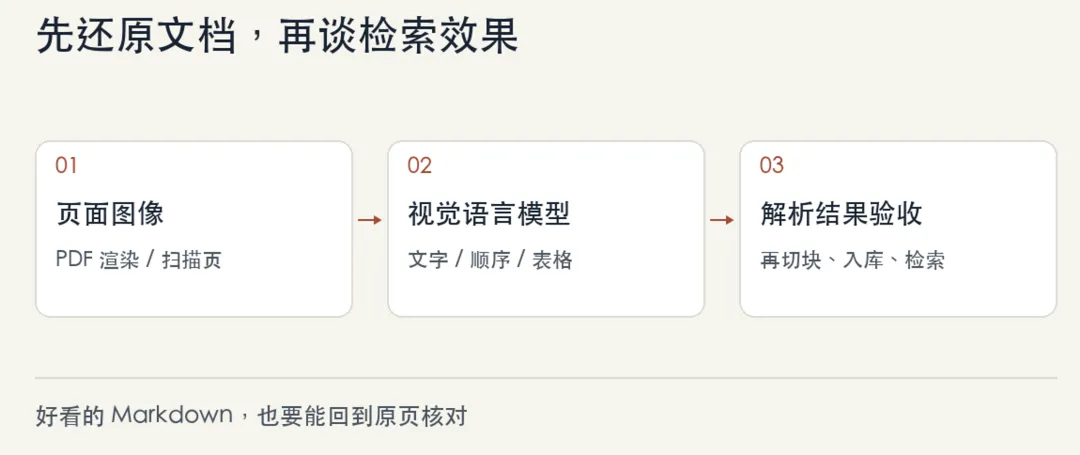
olmOCR 当前的处理 Pipeline 会先把 PDF 页面渲染为高分辨率图像,组装成多模态请求,再交由视觉语言模型(VLM)去端到端读图。模型解析出的语义流经过整理,最终导出干净的 Markdown 文件。
走多模态视觉路线,天然保留了坐标和留白等版面信息,对付双栏切块、扫描倾斜和复杂表格极其奏效。不过在工程落地时别盲目乐观:输出是否靠谱,依然受限于扫描件本身的清晰度与模型的识别边界。遇到财务报表、负号和跨行跨列表头时,千万不能因为导出的 Markdown 看起来工整美观,就跳过人工抽样复核。
另外提醒一个版本差异:早期的社区文章很喜欢把 olmOCR 的“文本锚定机制”(Anchor Text)当成核心卖点来吹。但去看最新代码就会发现,当前的 Pipeline 已经切到了无锚点的 Prompt 构造方案,target_anchor_text_len 参数上也明确标注了新模型不再启用这一套。读开源项目源码,务必让本地代码版本和网上的二手教程对上号。
选本地跑,还是走远程推理?
官方 README 给出了两条落地路径:如果图省事,可以直接调远程 API 推理;如果对数据安全和离线隐私有要求,就必须在本地拉起完整的 GPU 推理环境。
本地跑的硬件门槛并不低,官方列出的起步配置包括:较新的 NVIDIA 显卡、至少 12GB 显存,以及大概 30GB 的空闲磁盘空间。这还只是跑通 Demo 的基线,一旦批量并发拉高或者页面分辨率拉满,显存开销还会进一步上探。普通轻薄本哪怕插了 64GB 内存,没有正经独显支撑也跑不转这条本地路线。
环境配齐后,单文件转换的命令非常精简:
olmocr ./localworkspace --markdown --pdfs ./report.pdf转换好的 Markdown 会自动归档到对应工作区的 markdown 目录下。初次上手验证,先别急着一股脑甩进去几千份大文件,拿一本二三十页、排版复杂的样例文档逐页对比,把整个输出链路跑通最稳妥。
如果想搞明白这类视觉语言模型为什么能精准识别图文空间布局,网上有网友分享了一套《人工智能深度学习系统班(11期)》,里面的“多模态与交叉注意力应用”以及“对比学习与多模态任务”章节很适合拿来做理论补充:https://yunpan.plus/t/11417。理解了底层视觉和文本 Token 是如何在注意力层交互的,调参时心里才更有底;至于具体的环境搭建,还是老老实实盯紧 olmOCR 的官方文档。
拿什么材料测试,最能验出真本事?
建议从业务真实数据里挑出三类硬骨头页面来压测:一页紧凑双栏论文、一页带层级表头的财务表格、一页轻微倾斜或字迹发虚的扫描件。
开始测试前,先写下几条刚性指标:段落阅读顺序有没有错位、某个单元格的数值到底归属哪一年、计量单位有没有丢、页眉页脚有没有被洗掉。对比结果时,先盯着这几个硬指标查,再去读文风是否顺畅。大模型最擅长输出“通顺的废话”,但一旦丢掉一个负号或者错配一行数据,业务上就是灾难性的事故。
值得一提的是,项目自带了一个 olmOCR-Bench 评测工具。它的工程价值远不止刷榜,而是提供了一套断言式的校验范式——把字符是否存在、阅读顺序是否颠倒、表格行列键值是否绑定拆解为自动化用例,极具实战参考价值。
批量解析时,别只盯着吞吐量跑分
近期仓库的 Issue #480 提到一个有意思的监控 Bug:在后端 Worker 已经停摆不再产生新数据的情况下,面板上的“近期吞吐量”窗口可能依然定格显示着虚高的速率,相关的修复 PR 此前还在开放排队中。这提醒我们:界面上跑得很欢的性能数字,不等于后台文件真的在平稳推进。
自己做工程脚本时,务必老老实实落盘几个真实指标:已完成页数、失败页数、重试次数和最后一次心跳落盘时间。碰到解析卡死的脏样本,要能把原始文件和页码单独揪出来打日志,走人工兜底;别把单页崩溃隐匿在一句笼统的“任务执行完成”里。
先把文档入库这一层的物理对应关系焊死,再往后接切块与向量召回。否则一旦终端用户发现问答翻车,你可能甚至不知道到底是大模型在胡说八道,还是从最初的 PDF 识别起就南辕北辙了。
项目地址:
源码仓库: github.com/allenai/olmocrCV、NLP、大模型、强化学习: yunpan.plus/t/11417
这里是 《异或Lambda》,专注大模型前沿落地与底层架构拆解。如果这篇解析工具的梳理对你有帮助,欢迎点赞、转发并关注支持。
标签: #olmOCR #PDF解析 #多模态大模型 #RAG #知识库构建 #开源项目
近期发布: