ARTICLE · 1147340
AI时代,软件测试人员必做的三项自检
上个月我们组接了第一个正经 AI 应用的质量保障。我照着干了十几年的测试老套路铺了一遍:手工写了三百多条用例、把 Selenium 和 Playwright 的 API 背得滚瓜烂熟、覆盖率报告刷到 85%,自我感觉挺良好。结果上线前,一个真实用户的 prompt 把模型问崩了,吐出来一堆一本正经的胡话。我们那三百多条用例,一条都没盖到。那天晚上我盯着那张覆盖率报告,第一次认真想:我花大力气练的这身本事,是不是有哪几样,正在悄悄变成「过时功夫」?后来我重新盘了一遍,哪些事在 AI 时代 ROI 在塌、哪些反而更值钱。先给结论,再讲三个我踩过的坑。
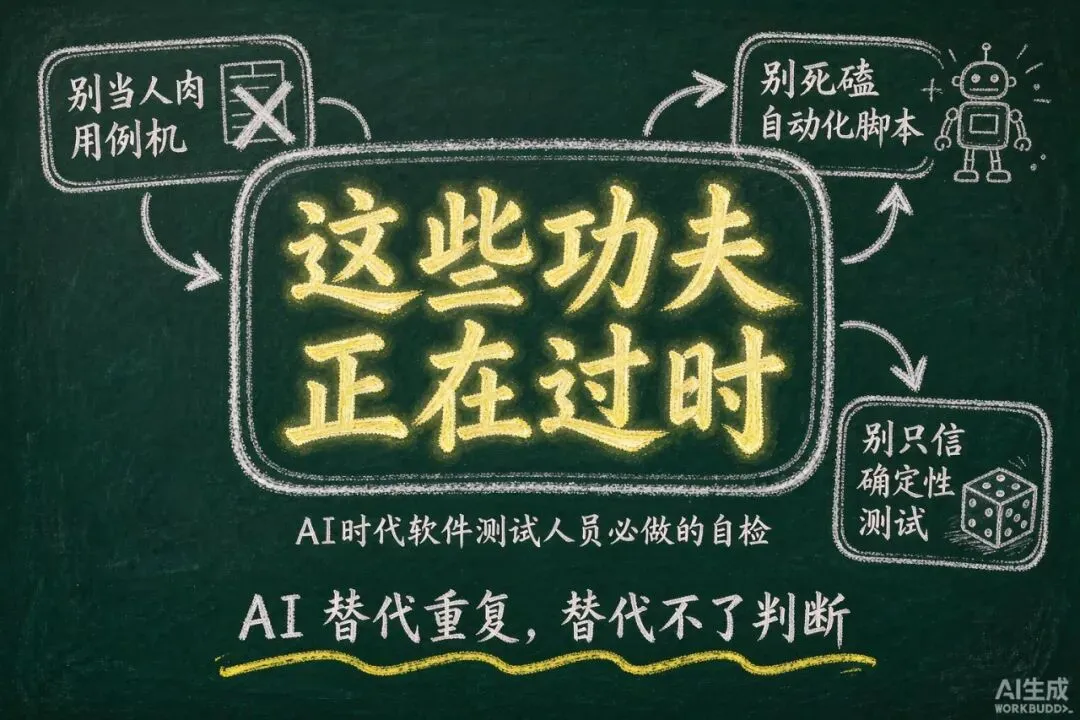
一、别再当「人肉用例机」
我那三百多条用例,大半是照着需求文档一条条手敲的。以前这叫「踏实」,现在叫「贵且慢」。我试了一次让 AI 从需求直接出用例、再自己维护,半小时干完我三天的活,质量还不差。
真正值钱的,不是「你能写多少条」,而是「你知道该测什么、能看出 AI 写的用例哪里漏了」。等价类、边界值、状态迁移这些测试设计的内核,比任何时候都重要——只是它从「你亲手写」变成了「你审 AI 写」。
二、别死磕自动化脚本的「手艺」
我曾经引以为傲:XPath 怎么写、Playwright 的等待策略怎么选、框架样板怎么搭,门儿清。现在 AI 写脚本、自愈脚本,都比我手快还不容易翻车。
脚本编写正从「核心技能」退成「基础操作」。你真正该琢磨的是:什么该自动化、什么压根不该自动化、脚本为什么 flaky、怎么诊断。决定「测什么、怎么测、何时不测」的那个人,才不容易被替掉。
三、别只信「确定性测试」
老测试信一句话:输入固定,输出就固定,断言一比对,完事。可你测的越来越多是 LLM、是 Agent、是 RAG 召回——模型会胡说、会跑偏、会越权,根本没有「标准答案」。
这套确定性打法正在失效。你得学的是概率性评估、评测集(eval)怎么搭、红队怎么打、幻觉怎么测。覆盖率刷到 100% 也没用——AI 轻松就能把覆盖率填满,填满≠真放心。
一张图记牢(板书图解风,存下来当屏保也行)
别误读:不是「没用」,是「换姿势」
我得说清楚,上面三样不是废了。测试设计思维更值钱,脚本能力是底子,确定性测试在它该在的地方依然硬。真正在贬值的,是「价值主要来自重复执行和记忆」的那部分——因为 AI 比人能重复、比人能记。
那劲往哪使?
我建议把自己的精力挪去了这几块,供你参考:
▪︎ AI 系统测试:prompt 测试、RAG 评估、Agent 可靠性、幻觉检测、eval 集、红队
▪︎ 编排力:用 agent 搭测试流水线,让 AI 生成+维护,你当总控
▪︎ 质量工程:可观测性、契约测试、混沌、测试左移到生产
▪︎ 编程再深一点:真写 eval harness 和工具,这是你多走一步的本钱
▪︎ 领域风险建模:比 AI 更懂业务会怎么翻车
一张图记牢 5 个方向(板书图解风,存下来当屏保也行)
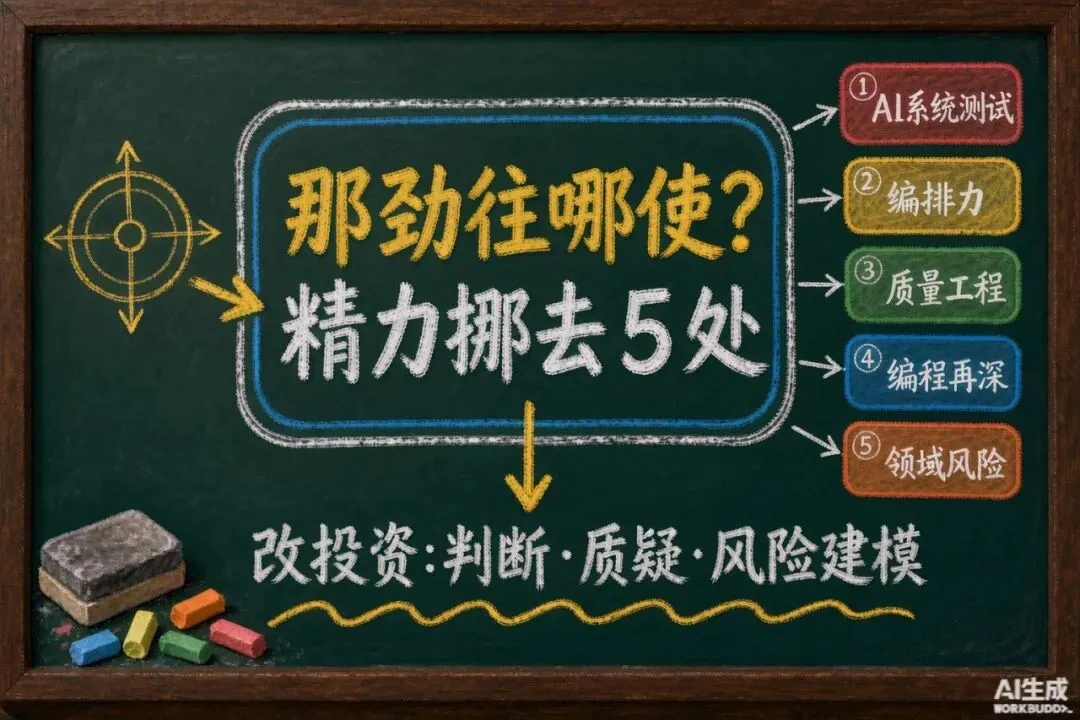
一句大白话收尾:别再投资「人比机器能重复、能记忆」的部分,改投资「人比机器会判断、会质疑、会建模风险」的部分。
如果这篇对你有帮助:
👍 点赞,让更多同行刷到 ⭐ 在看,收藏起来慢慢消化 💬 评论,你觉得AI时代软件测试人员如何转型并生存?评论区聊聊
THE END