ARTICLE · 1153525
【软件架构系列1-本体】Palantir本体架构(OMS和OS)解析及实践建议
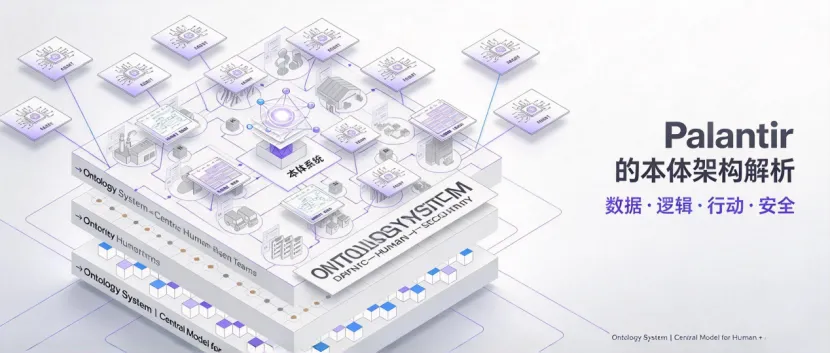
随着大语言模型(LLM)在企业业务系统中的规模化落地,一个新的行业矛盾随之凸现:大语言模型在处理不确定性业务诉求方面具备天然优势,然而业务边界、合规条款等刚性业务约束,不能完全交由概率模型自主决策。也正因如此,规则、约束、领域本体这些看上去有些“复古” 的知识工程手段,重新回到大家讨论的中心。
研究Palantir 的技术架构及演进,能够帮助我们在建设本体时少走弯路。本次材料内容体量较大,可结合标题根据需要阅读。在内容取舍上:既希望表述精简,又想保留足够细节支撑理解;暂从学习的角度出发,优先保证内容完整性。
本次总结涉及内容:
Palantir的技术架构介绍及演进分析。
Palantir与其它数据产品(知识图谱和政务一网统管)的差异。
当前AI业务遇到的典型问题及参考Palantir的本体实践方案。
参考来源:
Palantir Foundry Object Backend Overview
https://www.palantir.com/docs/foundry/object-backend/overview
从Palantir的FDE与本体论受追捧,感受其背后“追求卓越”的企业文化
https://mp.weixin.qq.com/s/5Ha1NEGogo-W56ziRJsExw
一、Palantir的架构介绍
1、Ontology 是什么
(1)面向决策的中央系统
目前大部分组织都面对一项难题:在内外部环境快速变化的VUCA和BANI时代,如何实时执行最佳决策?Palantir 本体(Ontology)旨在对企业决策进行建模。
Palantir 将其定位为“The Central System for Orchestrating Decisions Across Human+AI Teams”——用于协同「人+ AI 智能体团队」进行决策的中央系统。
(2)四大支柱
ONTOLOGY SYSTEM 的四大支柱为:DATA — LOGIC — ACTION — SECURITY(数据、逻辑、动作、安全)。
(3)整体架构逻辑
整个系统的运行遵循一条清晰主线:
底层异构数据,经过本体模型做语义映射,把杂乱数据库变成机器和人都能看懂的现实业务对象;
本体作为统一中间层,同时供给人类操作员和AI Agent;
人与AI 智能体在同一个业务语义模型上协作、推理、做决策、执行业务操作;
所有访问、推理、执行动作,统一受安全层管控。
(4)组织的操作层与数字孪生体
Foundry Ontology 是组织的操作层。它位于数字资产(数据集和模型)之上,并将其连接到现实世界的对应物——从工厂、设备和产品等物理资产,到客户订单或金融交易等概念,充当组织的数字孪生体,包含启用各种应用案例所需的语义元素(对象、属性、链接)和动态元素(操作、函数、动态安全)。
2、核心概念:TBox(OMS)与 ABox(OS)
(1)本体的二元构成
本体(Ontology)是面向复杂业务领域的语义建模底座:通过 TBox(类型、属性、关系、动作定义)描述业务“概念契约”,通过 ABox(实例数据)承载真实业务实体与关联关系。
(2)落地实现:TBox—OMS,ABox—OS
Palantir Foundry Ontology 包含:TBox——OMS(Ontology Metadata Service),以及 ABox——OS(Object Storage),是工业界成熟的本体落地实现。但其默认架构偏向全量物化模式:源数据经过数据漏斗(Funnel)同步至对象数据库,所有本体实例最终落地到统一对象存储(OS)。
(3)OMS 的底层实现:PostgreSQL + JSON 元模型
OMS(Ontology Metadata Service)本体元数据服务,底层使用关系库(PostgreSQL)存储TBox 元模型;自研 ObjectType、LinkType、ActionType 与权限定义。
元模型核心由四张元数据表承载:
ontology_class:管理类(对象类型)定义;
ontology_property:管理属性定义;
ontology_linktype:管理关系(链接类型)定义;
ontology_axiom:存放自定义公理约束。
备注:个人从Metadata 名称推断,OMS是从大数据平台的元数据管理演变而来
(4)OS的底层存储架构:AtlasDB 与存储组件
OS(Object Storage)对象存储,OSv2 底层依赖 Palantir 自研的 AtlasDB,并搭配多种存储组件,各司其职:
AtlasDB(Palantir 自研事务 KV 层):底层运行在 Apache Cassandra 之上,提供 MVCC 可序列化事务与宽表 KV 存储;用于承载对象主体事实数据(S1),是 OSv2 最核心的底库,主要用于查询;
Elasticsearch / OpenSearch:倒排索引,负责属性过滤、全文检索;
图存储引擎:社区推测基于JanusGraph,负责 Search Around 对象关联遍历;
对象湖存储:S3 / ABFS + Parquet(Foundry Dataset),持久化原始变更、批量底数据;
Kafka:Funnel 漏斗的消息队列,承担流式变更同步与增量索引管道;
lPostgreSQL / etcd:负责元数据、分片路由、Catalog,以及 OMS 本体元数据服务。
备注:从技术论坛获取,非官方,仅供参考。
3、Ontology 的能力分层(Ontology Core)
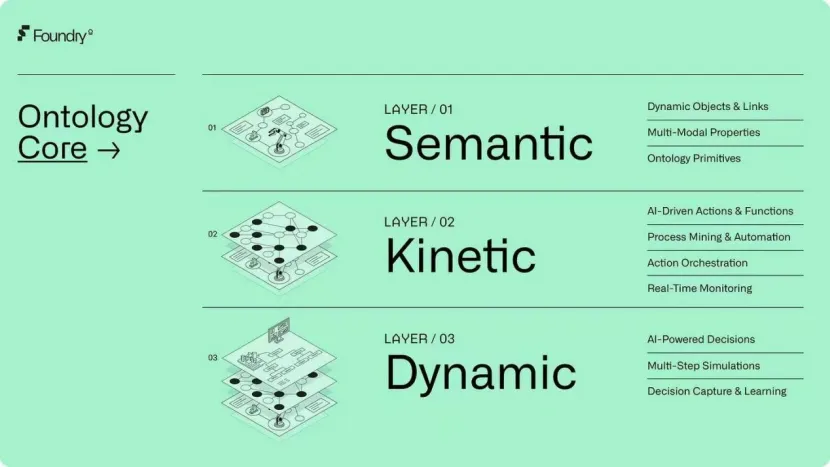
Ontology Core 自上而下可分为三层,分别对应语义描述、动作执行与动态推演能力:
Semantic(语义层):Object、Link、属性(TBox + 静态 ABox)——定义业务对象及其关系;
Kinetic(动力层):Action、Function、自动化、执行——承载可执行的业务逻辑与操作;
Dynamic(动态层):仿真、多步推演、时间旅行、闭环决策——支持对未来的推演与决策闭环。
4、本体OS存储演进:OSv1 → OSv2
(1)演进概述
从Object Storage v1 到 v2 的演进,也是浮现式设计、持续和演进式架构的一个范例。v2 的最大改动包括:新增 Object Data Funnel(对象数据漏斗),解耦源数据接入与对象数据库;引入OQL(Ontology Query Language)查询语言,作为「本体原生ABox」对应的底层实现。核心改进在于区分了源数据集、数据漏斗、对象数据库三个层次。
(2)OSv1(Phonograph):大单体架构及其痛点
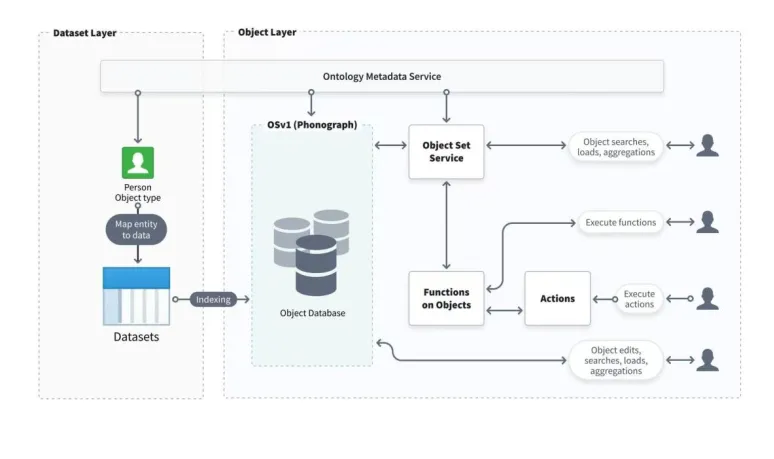
OSv1(Phonograph)是初代 Foundry 对象存储,属于大单体服务,一个组件包揽了全部职责:
原始数据接入、对象模型映射;
构建并维护对象索引;
接收用户查询、执行过滤/ 聚合 / Search Around;
处理用户编辑、写回数据、事务编排;
元数据管理、权限校验、对象链接关系维护。
单体架构带来的痛点主要包括:
索引压力大(海量数据增量重建索引)时,会挤占查询资源,导致查询延迟升高;
查询负载高(大量并发分析、Search Around)时,反过来拖慢索引更新;
扩容只能整体扩容整个Phonograph 集群,无法单独给索引层扩容,也无法单独扩容查询层;
API 暴露大量底层数据库能力,耦合很重,模型、查询、索引改动互相影响,大版本变更风险高。
备注说明:
Kinetic(动力层):就是图里Functions on Objects + Actions这一组,是本体的“可执行、能改变实例” 的能力,也是 Palantir 本体区别于传统静态知识图谱的核心;
Dynamic(动态层):广义指代本体中动态计算、事件触发、运行时权限、动态推导属性,依托Object Set Service 做对象集查询、动态过滤、聚合;
仿真逻辑:Dynamic 层负责 “怎么组织一场仿真”(场景、分支、多步串联);Kinetic 层负责 “跑仿真模型算结果”;OSv2 只提供仿真的原始真实对象,不参与仿真计算。
(3)OSv2:重设计,索引与查询分离
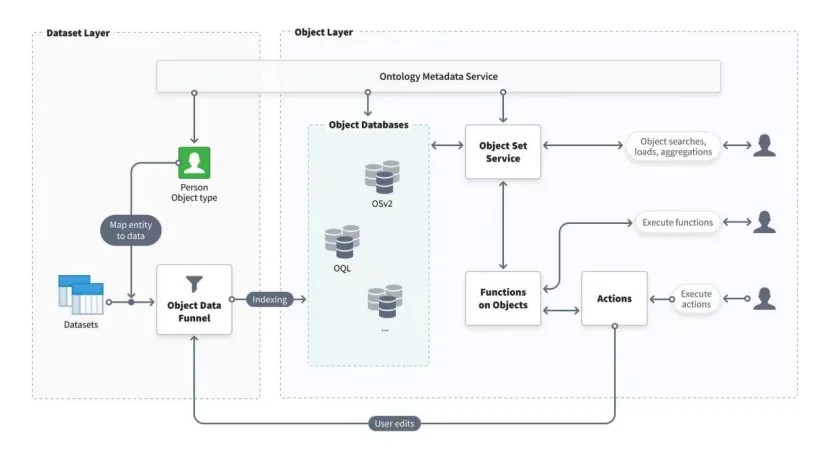
OSv2 从底层重设计,把原先揉在一起的职责拆成独立子系统,最核心的拆分就是索引子系统与查询子系统分离,新增核心组件Object Data Funnel(对象数据漏斗,简称 Funnel)。
(1)Funnel 管道:独立的索引/ 写入子系统(负责构建对象索引)
Funnel 是专门做数据变更、增量索引的离线 / 准实时管道,不再与在线查询引擎绑定:
自动捕获上游数据源变更,以及用户在Ontology 上的编辑操作;
自动计算变更日志(changelog),默认对全对象类型开启增量索引,不再每次全量重建;
将原始数据转换成对象索引文件,灌入专用的对象数据库;
可以独立扩容索引任务,支持单对象类型处理数百亿对象实例,索引吞吐能力大幅提升。
Funnel 是后台批处理 / 准实时流水线,只管把数据变成可查询的索引,不承接前端在线查询请求。
(2)专用对象数据库:独立的查询子系统(负责对外响应查询)
索引建好之后,索引文件被加载到专用对象数据库(specialized object databases),专门承接 Ontology 在线查询:
接收Workshop、API、前端应用的对象查询、过滤、聚合、Search Around;
独立扩缩查询节点,不影响后台Funnel 索引任务;
支持多后端异构存储:不同对象类型可以挂载不同专用数据库,按查询模式选型,不再只能用Phonograph 单一引擎。
一句话区分:Funnel 负责“把数据做成索引”,专用对象数据库负责“基于索引回答用户查询”,两者独立伸缩。
(4)解耦如何带来横向扩展
横向扩展= 增加更多机器节点来承载负载。
在OSv1 中,索引负载、查询负载混在同一集群:业务高峰期如果索引任务吃满资源,查询就会卡顿;想要扩容必须整体加机器,成本高、资源错配。
OSv2 让两个子系统独立扩缩:
当数据源持续新增、海量对象需要更新索引→ 只扩容 Funnel 索引管道,不影响在线查询服务;
当前端并发查询、大量Search Around 分析 → 只扩容查询对象数据库节点,不占用索引构建资源;
两个子系统的资源瓶颈互不传导,负载隔离。
职责解耦还带来附加收益:
增量索引默认启用,不再需要全量重刷,大规模数据集的更新延迟大幅下降;
架构更灵活,不同对象类型可以选用不同存储后端,适配不同查询模式;
系统迭代解耦:改动索引逻辑不需要改动查询引擎,优化查询性能也不影响Funnel 数据灌入;
权限、Actions(操作编排)、对象编辑能力独立封装在 Funnel 体系,不再耦合在数据库内核里。
(5)架构转变与兼容性保障
这一架构转变导致两类主要变更:其一,专用的对象数据库被设计用于特定的应用案例,可能无法提供与Object Storage v1 相同的功能,可能需要以不同于 OSv1 的方式建模工作流;其二,分离 OSv1 中整合的关注维度,需要对一些直接与 OSv1 API 交互的现有查询进行重构。(OSv1->OSv2要做数据迁移)
在兼容性方面,OSv2 依然保留 Ontology Metadata Service 作为全局语义契约;Object Set Service / Functions / Actions 等上层接口保持兼容。
二、Palantir与其知识图谱和政务一网统管等数据产品的差异
(1)四种方案的对照
传统RDF/OWL本体:TBox 与 ABox 全部集中在 RDF 库,ABox 是静态知识库,只读为主;
普通知识图谱:重在描述实体与关系;Palantir Ontology 是可操作、带权限、面向决策闭环的业务语义操作系统:实体上绑定业务逻辑与可执行动作,AI Agent 可以直接在本体上完成「查询→推理→决策→执行」的完整闭环。
政务一网统管:ABox 物理汇聚到中台数据库,实体、工单是两套独立表,外键关联;没有“虚拟 ABox 投影”的原生能力;跨委办局回写是项目定制或工单形式下发任务,没有标准化Action 与 同步队列;
Palantir:分布式ABox,多真值源;TBox 全局统一;Link 只绑定语义 ID,与物理位置解耦;写操作走 Action,变更先落在本体意向 ABox,再异步回源。
本质差异:有语义、可操作、带权限、面向决策闭环
(2)差异背后的约束:体制与权责壁垒
Palantir 分布式 ABox 的根基是:同一组织下、源系统愿意开放可控读写接口、业务流程可重塑,把语义层作为统一执行底座。
一网统管的底层约束则是多行政主体、数据共享单向、流程由法规固定、存量系统改造难。
因此,技术上可以复刻语义映射、混合ABox、对象 ID 关联这些能力;但体制与权责约束是最大的壁垒——这也是为什么国内产品看起来相似,但底层运行范式很难对齐。
三、当前AI应用遇到的问题及方案建议
1、从当前LLM的两类典型应用场景,剖析 LLM 在语义层面存在的核心问题
(1)智能问数主要链路(Rag+ LLM 工作流)
意图分析:基于元数据定义意图类型;指标类问题提取指标类型(元数据)+ 指标名称(指标名称-元数据)
指标语义匹配:匹配指标ID(指标名称-元数据语义)
查询执行:后端组装查询语句,查询MySQL / ES / 向量库
结果封装:返回带语义信息的元数据DTO,LLM 基于语义理解结果,汇总回答用户问题(指标名称-元数据语义)
(2)AI推荐主要链路(Rag+ LLM 工作流)
意图分析:基于元数据定义意图类型;需求类型(元数据)+ 需求关键词(关键词名称-元数据,关键词值-对象数据)
关键词语义匹配:匹配业务对象ID(比如:公司、行业、产品和岗位)(关键词值-对象数据语义)
查询执行:后端组装查询语句,查询MySQL / ES / 向量库
过滤排序:返回带语义信息的元数据DTO,LLM 基于语义理解结果,匹配过滤最合适的数据项。(关键词名称-元数据语义)
备注:专家推荐场景,根据客户的需求,在专家库中搜索推荐专家。
(3)当前核心现状问题
LLM 本身不稳定:大模型输出、意图识别受Transformer架构的限制,本身就有概率性。
LLM数据源异构:LLM多系统 / 多厂商数据源口径(训练数据和实时数据)、实体名称不统一。
公共本体需要持续维护:外部公共本体需定时同步,沉淀为稳定基准数据源。
核心根源:
缺少统一语义层,LLM 无法稳定理解业务实体、指标、跨系统同一实体,智能问数和AI推荐容易理解偏差、匹配错误。
2、本体语义层重点解决的两类语义对象
(1)本体概念(Object + 属性)
用于LLM 理解业务逻辑、意图分析
概念同义对齐:建立实体等同语义体系,如:Company / Enterprise / Organization;中文 “公司、企业、机构”。
作用:统一内部业务逻辑,支撑AI 智能问数、用户意图识别。
(2)实体实例(数据实例)
用于搜索、数据推荐、AI 问数。
实例别名归一:不同名称指向同一个业务实例,如:滴滴、小桔为同一主体。
作用:实体检索、关联数据召回。
(3)核心映射组件(语义映射层,建立主数据)
ObjectMapping 对象映射:物理数据表 → 业务对象模型
PropertyMapping 属性映射:多系统间字段 / 属性定义对齐
IdentityResolution 身份解析:跨系统识别同一业务实体(MDM 配套)
RelationMapping 关系映射:标准化业务关系,统一跨系统关联语义
(4)公理和推理:
业务规则,企业专属业务规则,世界公共知识规则。
推理逻辑,简单的利用推理三段式,图数据库多跳查询,复杂的需要沙箱。
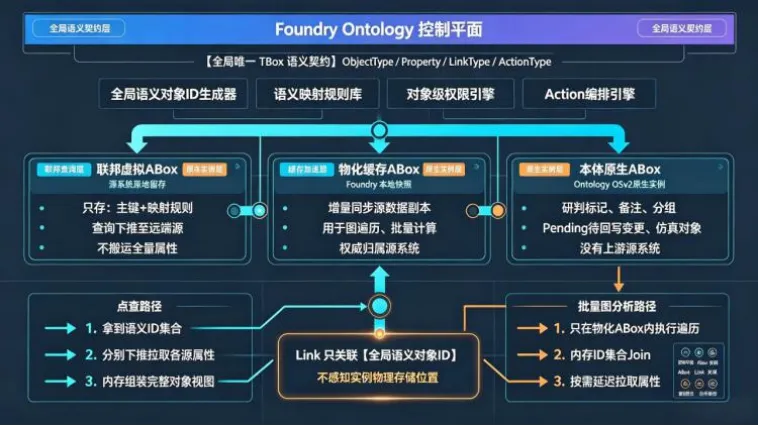
3、建议的本体实践方案:逻辑统一,物理分离
(1)核心改造思想:
逻辑上完成本体的统一规划,物理上业务代码与本体语义可兼容、可治理、可演进。
TBox管定义与规则(静态不变),ABox管实例与事件(动态可变),公理管约束,行为管动作,事件管触发,推理管增值。在TBox和ABox上叠加语义适配层。
(2)TBox + 语义适配层
业务系统内轻量化落地:摒弃厚重通用框架,按业务实际场景分层搭建。
通过模型构建、运行调度、规则复用,形成「业务实体骨架+配置化语义公理」。
直接定义成业务Entity(本体较少,自运营SaaS服务)或DB 竖表(Palantir的方式,适合本体比较多,通用的产品)。
统一封装独立语义适配层,标准化语义流转、收敛语义差异。使用时直接进行语义Entity赋值或MapStruct语义映射。
业务规则公理统一规则配置文件,调用LLM时进行占位符动态替换。
行为和函数,统一在代码中分层封装,根据需要封装API/MCP接口对LLM开放。
(3)ABox + 语义适配层
核心设计思想:语义契约全局统一,实例存储形态分离,链接与存储解耦,查询路径自适应。
基于现有业务系统,设计三存储池ABox 模型(联邦虚拟ABox + 物化缓存 ABox + 本体原生 ABox),实现“按需物化、可联邦、可本地原生实例”三种实例形态共存;Link 统一绑定全局语义对象 ID,对底层存储位置透明,根据查询类型自动路由执行路径。
设置语义映射层:对于涉及需要LLM调用或语义查询的实例,按需要设置数据语义映射层,类似:别名、简称等语义描述。
联邦虚拟ABox:真正“数据留在原地”,适用于源系统不能导出、不可复制、有强数据主权 / 合规要求、数据量巨大、或属于实时主库的场景。数据的专属性强,主数据只有1个来源,没有必要做物化同步。
物化缓存ABox:最常用的折中方案,Palantir的方案,强制物化。外部业务数据通过数据接入平台写入数据。
本体原生ABox:本体自有的实例,一些外部公共及内部沉淀的知识。
九篇分篇规划:
篇次 | 篇名 | 定位 | 核心内容(一句话) |
1 | Palantir本体架构(OMS和OS)解析及实践建议 | 入门总起篇 | 六种架构、三层链路:业务定目标、产品转需求、应用搭系统、数据管信息、技术打底座、项目来落地、本体补语义 |
2 | AI时代的架构设计:究竟需要什么样的架构师 | 定位篇 | AI 让架构师价值分化,真正稀缺的是定义问题、驾驭复杂性的架构师 |
3 | 架构的本质:围绕业务属性与质量属性的决策集合 | 本质篇 | 架构,是在给定约束下,围绕业务属性与质量属性做出的一组关键决策集合 |
4 | 架构设计的方法论:从定义问题到化虚为实 | 方法论篇 | 讲架构设计的思维过程:四原则、四步思维、模型观与概念分离 |
5 | 架构设计的原则与模式 | 原则篇 | 给出可执行的设计准则和可参考的模式 |
6 | 组织与架构:康威定律与演进式架构 | 组织篇 | 架构是组织问题:康威定律、演进式组织实践与大型敏捷 |
7 | 架构评估:围绕架构的适应度函数,尽早、反复、持续 | 评估篇 | 怎么判断架构好坏:围绕架构的适应度函数,评估金字塔、问题彩虹与评估仪式感 |
8 | 架构设计的十大反模式:看起来正确,实则错误 | 反模式篇 | 架构设计的“四个坑”与十个常见陷阱现象,以及应对的措施及方案 |
9 | 架构师的成长:从方案设计者到AI 系统构建者 | 成长篇 | 回扣开篇:沉淀知识资产、成为让AI 基于自己经验运行的架构师 |
参考书目:
1.演进式架构(Building Evolutionary Architectures)[美] 尼尔·福特(Neal Ford)、[美] 丽贝卡·帕森斯(Rebecca Parsons)、[澳] 帕特里克·柯(Patrick Kua);第2版新增作者普拉莫德·萨达拉奇(Pramod Sadalage)
2.持续架构实践(Continuous Architecture in Practice)[美] 穆拉特·埃尔德(Murat Erder)、[美] 皮埃尔·普约尔(Pierre Pureur)、[英] 伊恩·伍兹(Eoin Woods)
3.架构师修炼之道(Design It! From Programmer to Software Architect)[美] 迈克尔·基林(Michael Keeling)
4.面向模式的软件体系结构(POSA,Pattern-Oriented Software Architecture)[德] Frank Buschmann、Regine Meunier、Hans Rohnert、[瑞士] Peter Sommerlad、[德] Michael Stal(卷1)
5.企业应用架构模式(Patterns of Enterprise Application Architecture,EAA)[英] 马丁·福勒(Martin Fowler)(David Rice、Matthew Foemmel等参与贡献)
6.整洁架构之道(Clean Architecture)[美] 罗伯特·C·马丁(Robert C. Martin,Bob大叔)
7.浮现式设计(Emergent Design:专业软件开发的演进本质)[美] Scott L. Bain(斯科特·贝恩)
8.架构思维:从程序员到CTO郭东白(美籍华人)
9.左耳听风:传奇程序员练级攻略(博文视点出版,陈皓文集)
10.架构的本质(极客时间《许式伟的架构课》)