ARTICLE · 1154376
Skill生成Excel用例,附源码,直接照抄就能用!
引言:为什么测试用例生成不能只靠一条Prompt?
做测试的你,一定经历过这样的场景:产品经理给你一份PRD,前端丢来几张截图,后端给了一份Swagger文档,接口联调时又补了一份Postman集合,历史项目还留着字段完全不同的Excel表格。你把这些材料一股脑丢进一个大Prompt里,指望AI帮你生成测试用例。
结果呢?同一份需求,第一次输出的格式和第二次不一样;截图里看不到的业务规则,AI自己"脑补"出来了;性能需求明明没写SLA,AI却给你填了一个未经确认的响应时间。更可怕的是,生成了一百多条用例,看起来很多,但真正覆盖了边界值、异常流程的却没几条。
今天,我想分享一个真正能解决这些问题的Skill——lemon_testcase。它不是让AI一次写出更多标题,而是稳定地把测试事实转换为可评审、可执行、可继续维护的测试用例资产。直接照抄就能用,文末附源码。
一、 lemon_testcase 是什么?
一句话说清楚:它是一个以"统一案例模型"为中心的测试用例生成Skill。
它把输入识别、需求事实提取、测试场景设计、案例建模、模板适配、质量审核和格式导出拆成独立环节。它不是一个只能输出表格的脚本,也不是一个可以替代测试评审的"万能生成器"。
它的目标很明确:
1. 把不同来源转换为同一种测试语义——不管你给的是PRD、截图还是接口文档,最终都变成同一种结构。 2. 用公共测试方法系统扩展场景——正向、反向、边界值、等价类、状态迁移、场景法,一个都不少。 3. 让同一组用例输出为团队需要的不同格式——Excel、Markdown、CSV、JSON、XMind,一份数据,多种交付。 4. 用自动检查暴露结构、覆盖、断言和安全问题——不是生成完就完事,还要检查质量。 5. 把无法确认的信息保留为待确认项——不伪造结论,不确定的就明确标出来。
二、 设计思路:为什么要拆成多层?
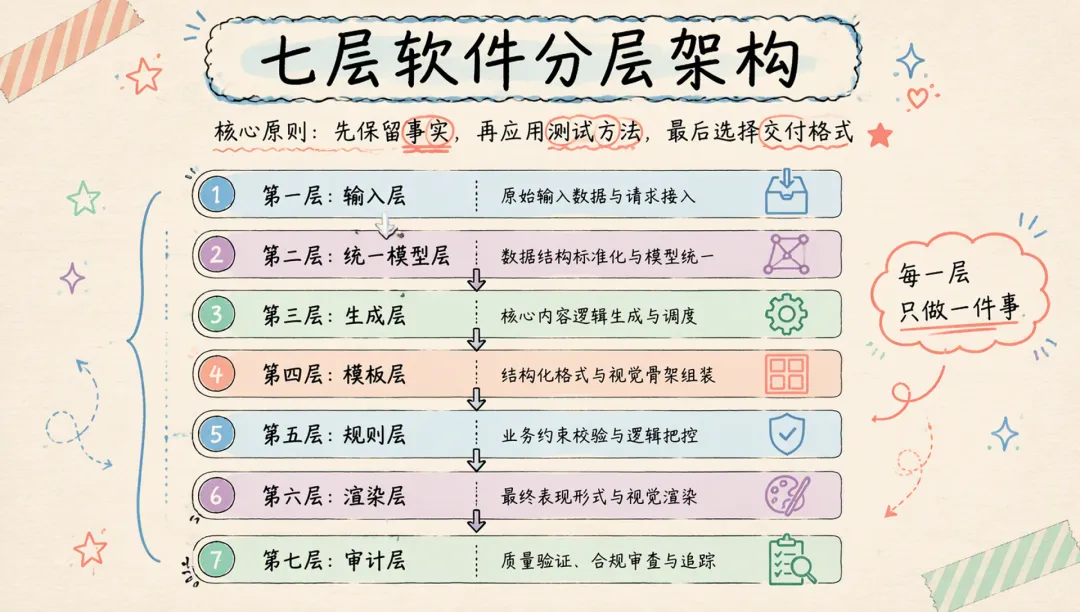
lemon_testcase 的设计遵循一条核心原则:先保留事实,再应用测试方法,最后选择交付格式。
它把整个流程拆成了七层,每一层只做一件事:
第一层,输入层。 只负责读材料,不提前决定列名,不从截图推测后台规则。你给它什么,它就识别什么。
第二层,统一模型层。 不同来源最终进入一份统一的JSON结构。这份JSON包含用例编号、标题、模块、类型、流程类型、测试方法、优先级、前置条件、操作步骤、预期结果、测试数据、实际结果和来源引用。所有后续操作都基于这份统一模型。
第三层,生成层。 只负责测试设计。在已有事实上应用正向、反向、等价类、边界值、状态迁移、场景法和风险驱动等公共方法。举个例子:需求写了"密码长度8~64",它可以推导出7、8、9、63、64、65等边界数据;但需求没写"失败5次锁定",它就不能自己决定。
第四层,模板层。 只控制字段和顺序,不重新理解业务。团队想改Excel表头时,改模板就行,不会顺带改变用例含义。
第五层,规则层。 负责最低质量标准,读取规则后输出error、warning、info三个级别。模板回答的是"交付长什么样",规则回答的是"什么结果不能直接交付"。
第六层,渲染层。 只负责格式。Excel、Markdown、CSV、JSON和XMind都读取同一份统一模型,渲染器不补写新的业务规则。
第七层,审计层。 证明过程是否稳定。结构检查、标准检查、覆盖报告、安全检查和格式回读,分别回答不同问题。一个valid=true只说明对应检查没有发现阻断项,不等于真实系统已经通过测试。
三、 支持哪些输入,分别适合什么场景?
不管你是哪种输入,它都能帮你把散落的材料收进同一个结构里。
四、 五类测试用例是怎样设计的?
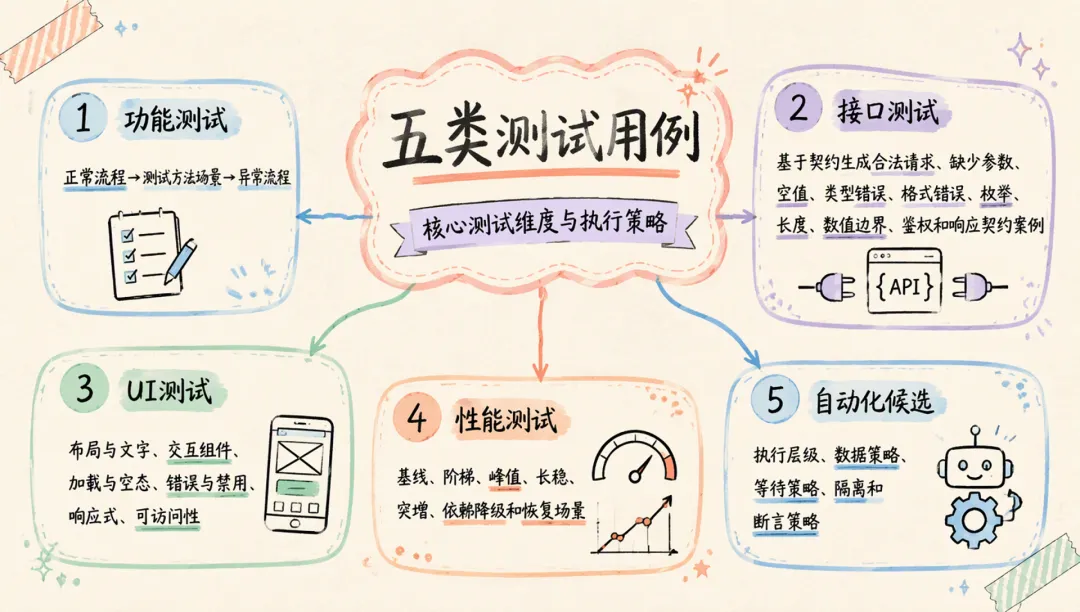
功能测试:按照"正常流程 → 测试方法场景 → 异常流程"组织案例。覆盖主流程、合法输入、非法输入、空值、边界、权限、状态变化、依赖失败和恢复。测试工程师仍要结合历史缺陷、业务风险和环境限制补充项目特有场景。
接口测试:基于契约生成合法请求、缺少参数、空值、类型错误、格式错误、枚举、长度、数值边界、鉴权和响应契约案例。必须保留请求方法、路径、请求数据和响应断言。契约只声明候选错误码时,不能替接口负责人决定某个异常一定返回哪个状态码。
UI测试:从布局与文字、交互组件、加载与空态、错误与禁用、响应式、可访问性等维度建立检查矩阵。只有截图时,它提供的是可见事实和通用检查方向;字号、色值、元素属性和真实交互仍需设计规范或运行页面。
性能测试:生成基线、阶梯、峰值、长稳、突增、依赖降级和恢复场景,并要求记录P50、P95、P99、吞吐、错误率和资源指标。没有SLA时可以设计测量方案,但结果必须写明"不判定为通过",不能伪造验收线。
自动化候选:补充执行层级、数据策略、等待策略、隔离和断言策略。标记为自动化候选,表示值得进入候选评审,不表示必须马上写脚本。验证码、第三方依赖、共享账号、视觉主观判断和维护成本,仍需人工评估。
五、 从0到1跑通完整流程
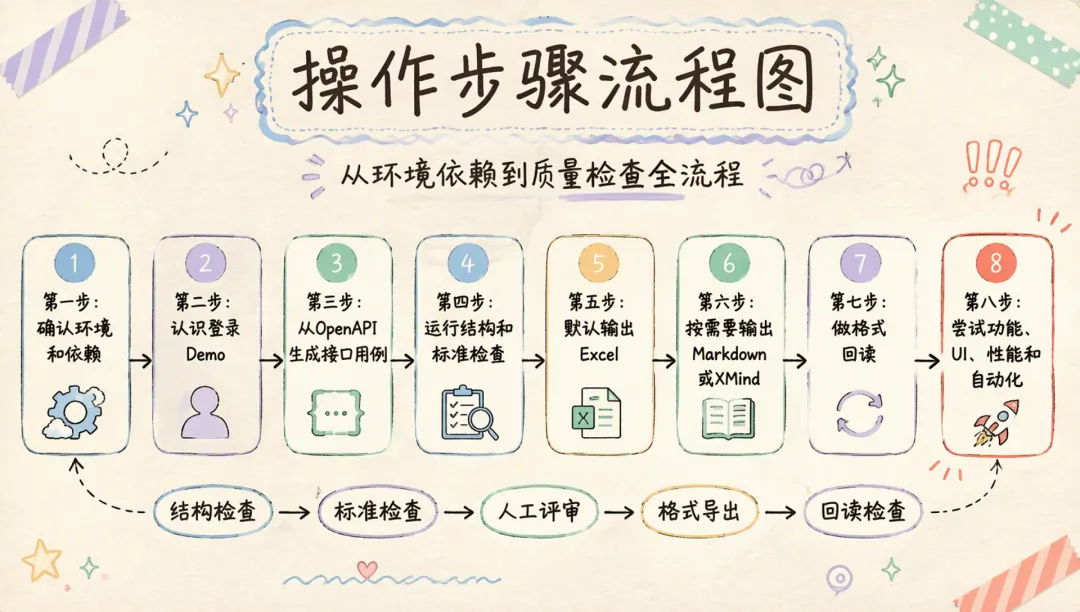
第一步:确认环境和依赖。 进入项目目录,运行依赖探针,检查YAML、Excel、DOCX、PDF和XMind相关能力是否可用。
第二步:认识登录Demo。 它自带一套完整的示例材料,包含PRD、OpenAPI文档、Postman集合、旧用例CSV、登录页面截图、性能场景和状态迁移文件。
第三步:从OpenAPI生成接口用例。 运行生成脚本后打开JSON,确认每条接口案例包含请求方法、路径、数据和预期状态码。密码等敏感值应使用环境变量占位。
第四步:运行结构和标准检查。 分别检查结构是否有效、错误/警告/提示的数量,以及请求方法、路径、参数模式和状态码覆盖。警告不应被静默忽略,需要确认是接受、修正还是补充事实。
第五步:默认输出Excel。 未指定格式时默认生成Excel。Excel适合用例评审和执行,但建议保留对应JSON,后续格式转换和差异检查都以JSON为稳定来源。
第六步:按需要输出Markdown或XMind。 通过命令行参数即可切换格式,满足不同团队的交付习惯。
第七步:做格式回读。 确认目标文件可以打开、用例数量一致、核心编号、步骤、测试数据和预期结果没有丢失,XMind是有效压缩包且包含必要入口文件。
第八步:尝试功能、UI、性能和自动化。 分别生成不同类型用例,然后重复"结构检查→标准检查→人工评审→格式导出→回读检查"的闭环。
六、 怎样审核生成结果?常见误区有哪些?
拿到生成结果后,按这个顺序检查:
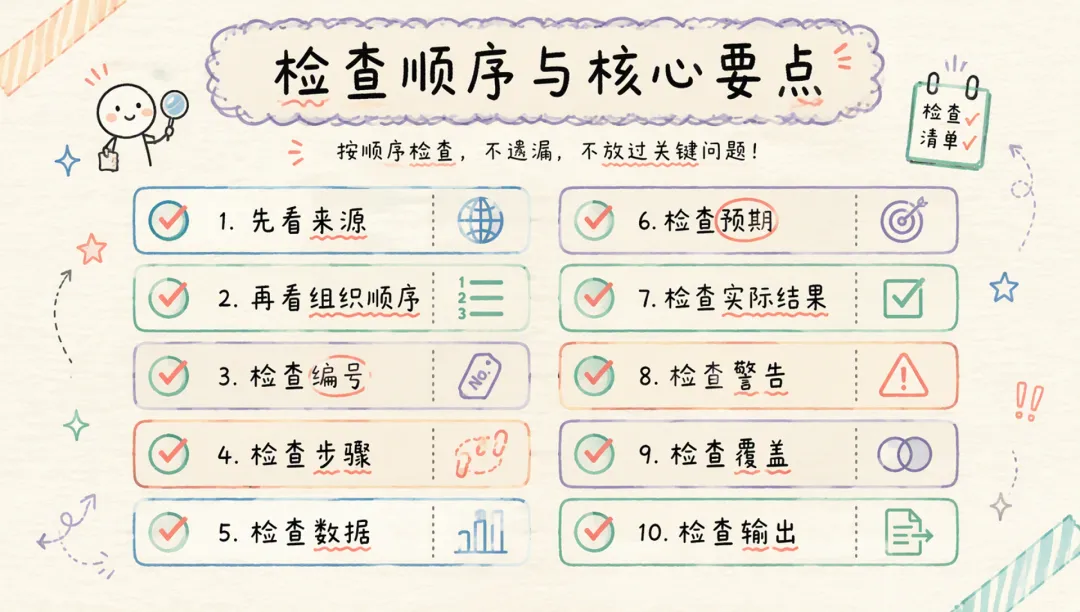
1. 先看来源:每个业务结论是否能回到PRD、接口契约、截图或状态规则。 2. 再看组织顺序:正常流程在前,测试方法场景居中,异常流程随后。 3. 检查编号:功能模块使用拼音首字母大写加序号,例如登录 DL_001、注册ZC_001。4. 检查步骤:另一名测试人员能否不依赖作者口头解释完成执行。 5. 检查数据:接口地址、参数和具体数据是否齐全,敏感值是否脱敏。 6. 检查预期:是否可观察、可判定,避免"系统正常"这类模糊表达。 7. 检查实际结果:生成阶段保持为空,只有真实执行后才能填写。 8. 检查警告:明确负责人和处理结论,不要只看 valid。9. 检查覆盖:用例数量不能替代需求、状态、边界和接口参数覆盖。 10. 检查输出:回读Excel、Markdown、XMind,确认核心语义没有漂移。
常见误区也要避开:
• 生成100条就比30条完整?——查看需求、边界、状态、参数和风险覆盖,不以数量替代质量。 • 截图里有按钮就推导后台规则?——截图只支持可见事实,业务规则回到PRD或接口契约。 • valid=true代表业务正确?——它只说明对应自动检查没有发现阻断问题。• 自动化候选都应该写脚本?——继续评估频率、稳定性、数据、隔离、维护和诊断成本。 • 没有SLA就填一个常用指标?——先做基线探索,明确指标待确认,不伪造通过线。 • 只保存最终Excel?——同时保存统一模型JSON、质量报告和待确认项。
使用边界也很重要: 这个Skill输出的是可评审、可修改的测试用例初稿,不是未经执行的测试结论。没有事实依据的错误码、性能阈值、权限规则和隐藏状态,不能被写成产品事实。
七、 团队落地建议
如果你想把lemon_testcase引入团队,建议按这个顺序推进:
1. 选择一个低风险模块试点。 登录Demo可以验证流程,但团队试点应选择规则清楚、现有用例可对照的真实模块。 2. 先统一字段,再讨论生成数量。 确认编号、标题、流程类型、测试方法、优先级、步骤、预期和实际结果的含义。 3. 指定三类责任人。 模板负责人维护交付格式,规则负责人维护质量门禁,业务评审人确认事实和风险。 4. 把警告纳入评审。 记录处理人、结论和是否需要修改需求或用例。 5. 保留版本资产。 至少保存输入、统一模型JSON、最终Excel、质量报告和差异报告。 6. 从真实反馈迭代规则。 长期被忽略的警告应重新评估;反复出现的人工遗漏可以沉淀为新规则。
八、 结语与Skill领取
lemon_testcase 的核心公式:多源输入识别 + 统一案例模型 + 公共测试方法 + 模板适配 + 质量审核 + 多格式导出。
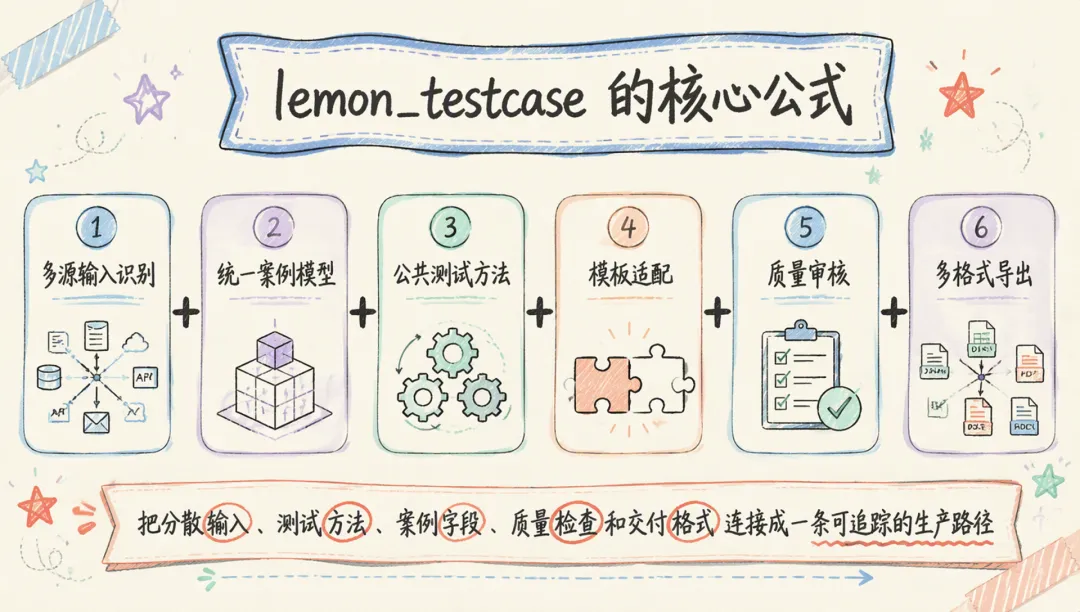
它真正解决的不是"替测试工程师写完所有用例",而是把分散输入、测试方法、案例字段、质量检查和交付格式连接成一条可追踪的生产路径。测试工程师仍然负责确认事实、识别风险、准备环境、执行验证和解释结果;这个Skill负责让这些工作有一个更稳定、更一致的起点。
【读者福利】关注本公众号,后台回复关键词【666】,即可获取:
SKILL.md 配置文件与统一案例模型定义。拿去在Cursor里跑一次,体验一次框架成型的爽感!