ARTICLE · 1158490
做 AI 漫剧的人注意:配音这道门槛,昨天被砸到地板上了
前阵子我做完了一部国风 AI 漫画《鲧禹治水》。12 格分镜、工笔重彩、铁线描勾勒,画面部分整整返工了一次——第一版被朋友一句话打回来:"你这画的是中国神话,怎么人物一股日式味儿?"于是推倒重来。画面定稿那天,我卡住了。卡的不是画,是声音。一部能看的 AI 漫剧,光有画面是不够的:旁白得是沉稳的中年男声,禹是二十出头的青年,部落长老是老年音,还得有个女孩。四个角色,我一个配音演员都请不起——市面上 30 秒报价 200 起,12 段下来两千多,改一句词再掏一次钱。自己录?我这张嘴念出来的上古旁白,听着像在念年终述职。最后我用开源模型把这四个人全造出来了。一分钱没花,而这四个人,没有一个真实存在过。这个东西叫 VoxCPM2,来自 OpenBMB(做 MiniCPM 那拨人),地址 github.com/OpenBMB/VoxCPM。我把官方文档、榜单和社区 issue 全翻了一遍,也在自己机器上从头跑了一遍。下面讲的是我实际验证了的部分。
一、它到底能做到哪一步
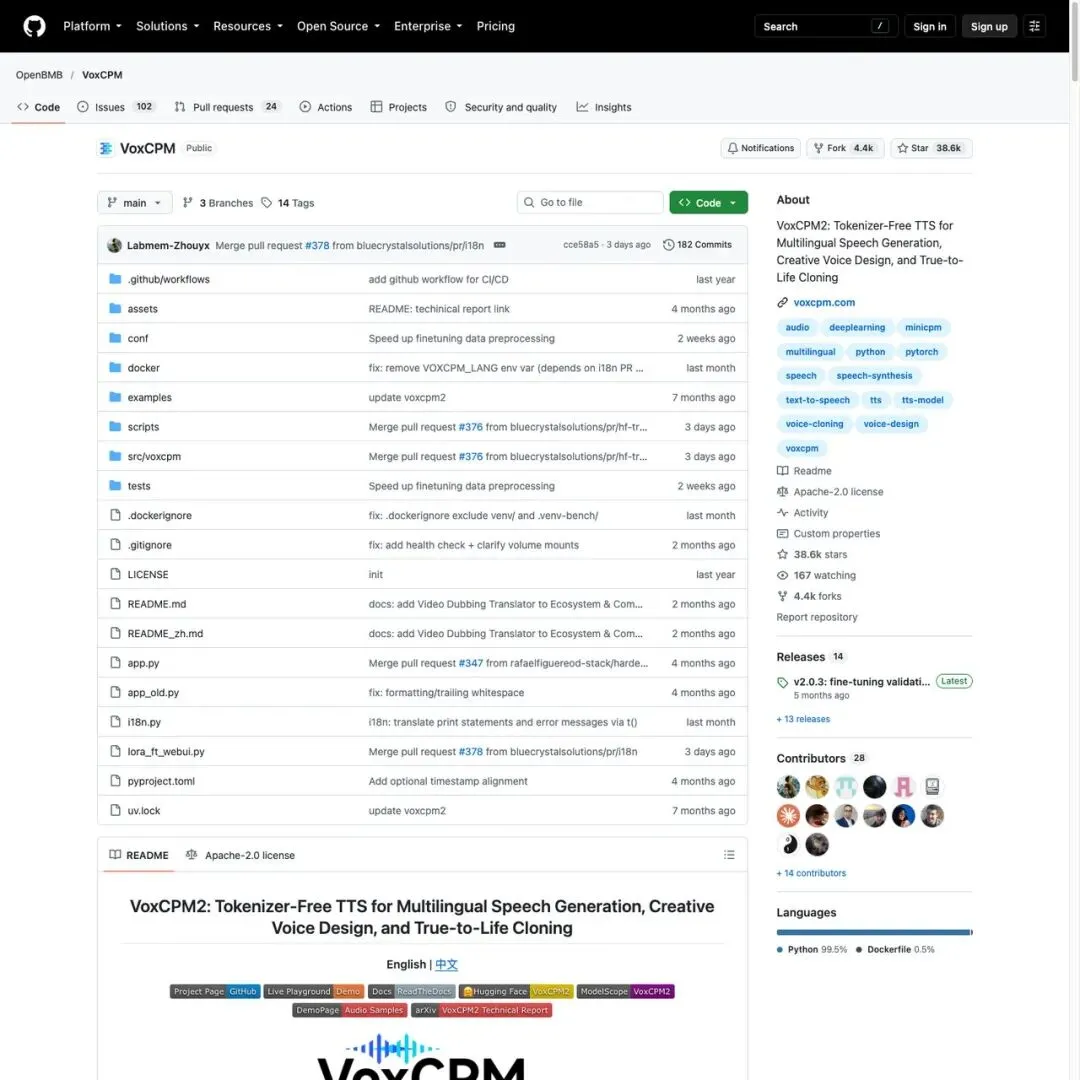
▪︎ Star 38,622,Fork 4,365,开放 issue 126(GitHub API 实查)
▪︎ Apache-2.0 协议——代码和权重都能商用,不用给任何人付费
▪︎ 48kHz 原生输出,录音棚采样率那一档
▪︎ 30 种语言 + 9 种中文方言:粤语、四川话、吴语、闽南话、东北话、河南话、陕西话、山东话、天津话
▪︎ 2B 参数,训练数据 200 万小时以上,底座是 MiniCPM-4
真正让我决定用它跑漫画的,是这三个能力:
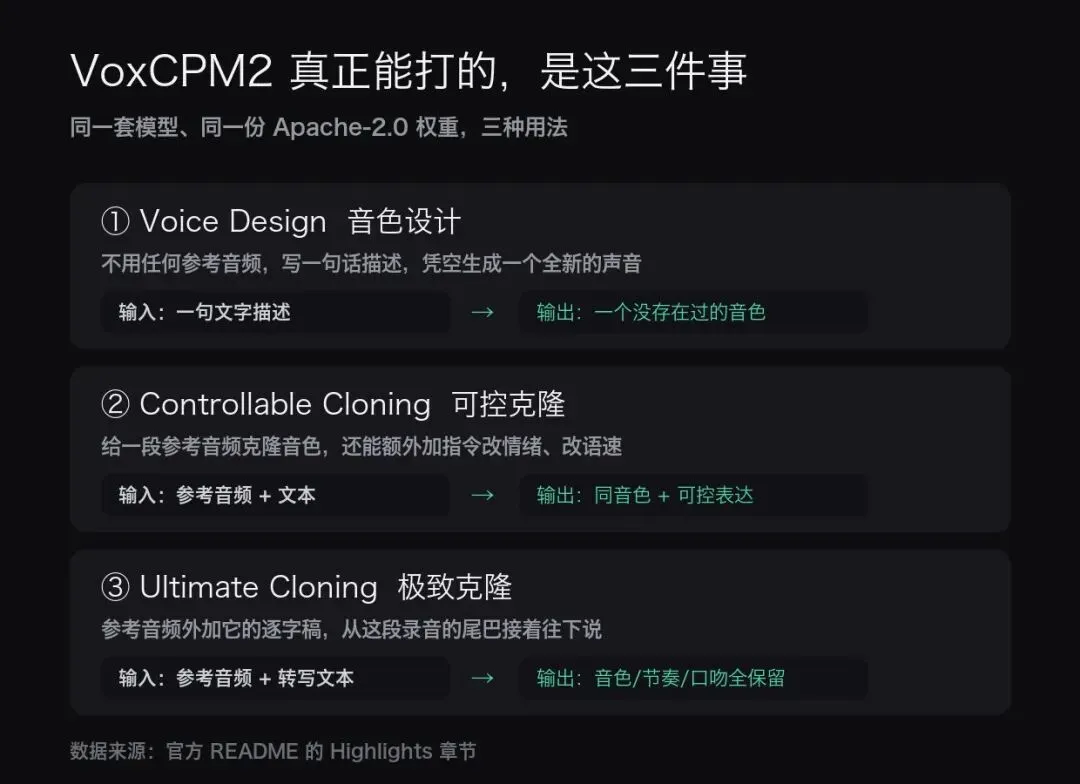
① Voice Design——凭一句描述,造一个不存在的人。
这是它跟其他开源 TTS 最大的区别。Kokoro、Chatterbox 那类模型,要么给你几个固定音色包,要么必须上传一段参考音频。VoxCPM2 不用:在文本最前面加一对括号写清楚条件就行。
(沉稳的中年男声,上古神话旁白,语速偏慢,字正腔圆)尧之时,洪水滔天,浩浩怀山襄陵。
对我这种"要四个完全不同的人"的场景,这条是救命的——它解决的不是"克隆得像不像",是"我一个人手都没有"。
② Controllable Cloning——克隆完还能改情绪。给一段参考音频克隆音色,再叠加一句指令:"说得欢快点""语速慢一点"。克隆的声音不再是死的。
③ Ultimate Cloning——贴着原声往下接。提供参考音频加它的逐字稿,模型从这段录音的尾巴接着说,音色、节奏、情绪、说话习惯一起继承。
二、为什么它敢标 48kHz,也真能"像本人"
这里有一条技术路线的分岔,讲清楚你就明白它贵在哪。
大部分 TTS 走的是"先压再还原":把音频切成离散的 token,模型预测 token,最后还原成波形。这条路成熟、省算力,但代价也很直接——离散化那一下,人声的细枝末节就被压掉了一部分:轻微的呼吸、尾音处理、情绪浓度。
VoxCPM 走的是 Tokenizer-Free:不切离散 token,直接生成连续的语音表征。代价是更难训,好处是细节保留得多,尤其体现在韵律、情绪和克隆一致性上。
落到两个看得见的结果:
一个是 48kHz。它的 AudioVAE V2 是非对称编解码——就算你喂进去的参考音频只有 16kHz,它也能直接吐出 48kHz,内置超分,不用在外面再接一个放大模块。
另一个是 79.5 分。
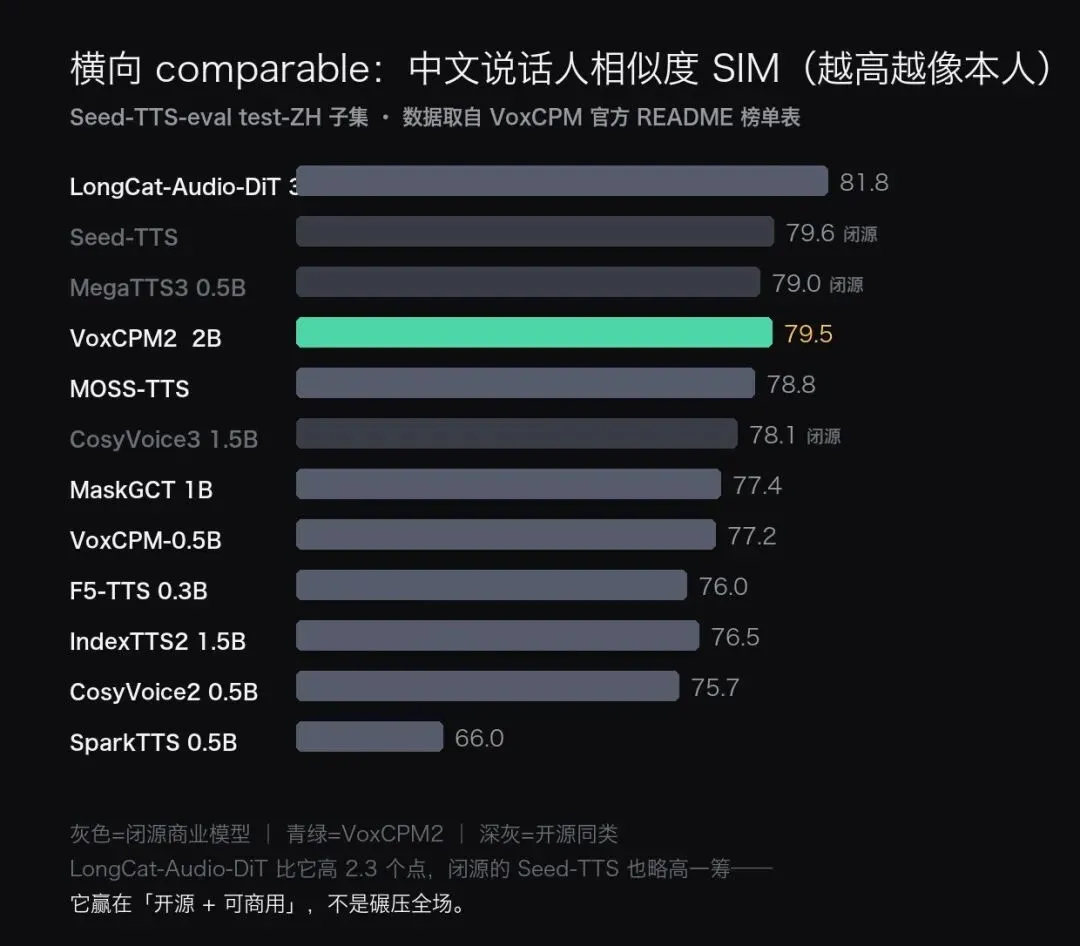
这张图是我按官方 README 的 Seed-TTS-eval 榜单(test-ZH 子集)画的,SIM 越高越像本人。老老实实念一遍:
▪︎ 它 79.5,排在前面的还有 LongCat-Audio-DiT(81.8)和闭源的 Seed-TTS(79.6)、MegaTTS3(79.0)
▪︎ 但它把同一梯队的开源同类甩开一截:MaskGCT 77.4、F5-TTS 76.0、CosyVoice2 75.7、SparkTTS 66.0
▪︎ 跟自家上一代比:VoxCPM-0.5B 77.2 → VoxCPM2 79.5,一年进步 2.3 个点
它不是碾压全场,它赢在"开源 + 可商用"这个组合拳上。LongCat 那个 81.8 是 3.5B 参数;而 VoxCPM2 是 Apache-2.0 白纸黑字写在仓库首页——权重随便下载、随便改、随便放进自己的产品里,不欠任何人钱,不看任何人脸色。
顺带说清楚"辨不出真假"这件事:79.5 分的意思是短句、干净素材容易以假乱真,长段落仔细听还是有破绽。别指望它百分百骗过耳朵,但用来出片,够用了。
三、我把它跑起来,花了多久
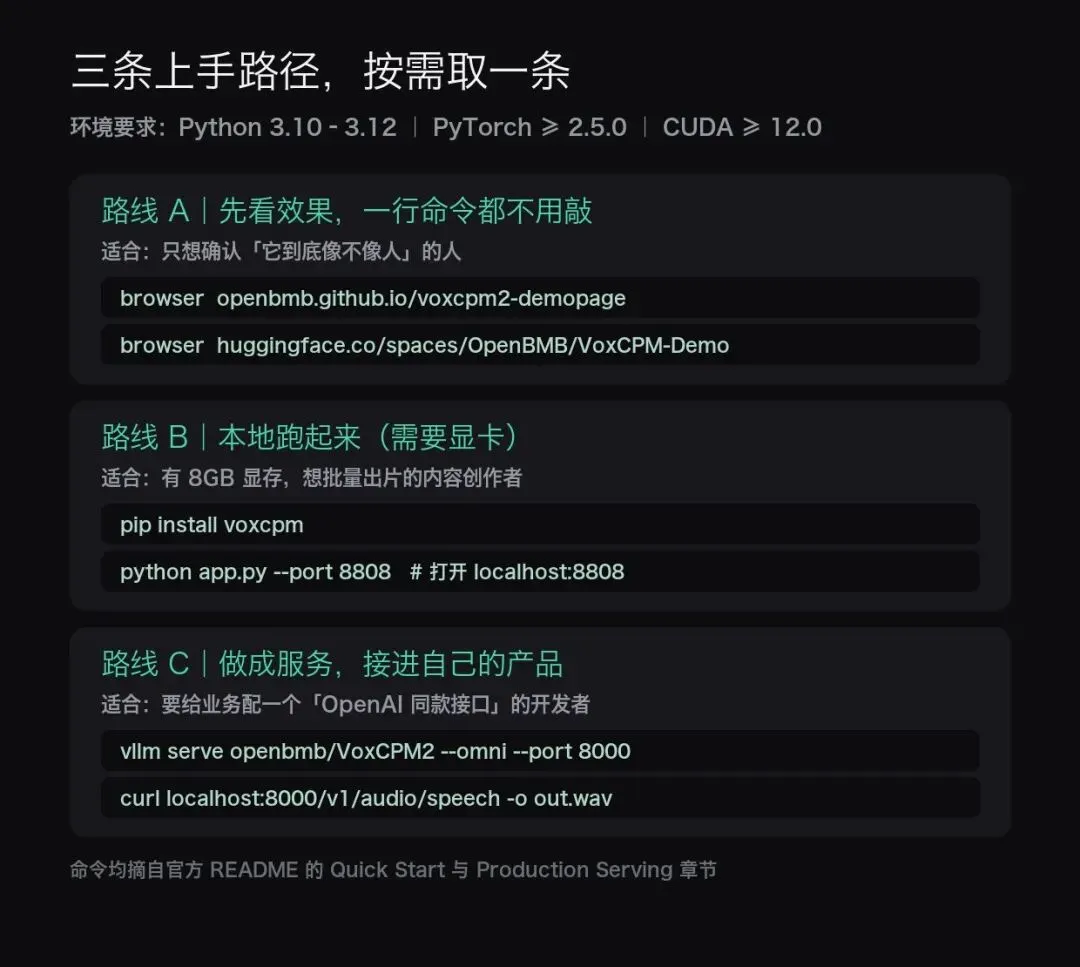
第一步,装。官方文档写得很规矩:pip install voxcpm。环境要求:Python 3.10–3.12、PyTorch ≥ 2.5.0、CUDA ≥ 12.0。
这里有个坑,我踩了:默认用最新的 Python 3.13 装不进去——项目明确要求低于 3.13。所以我另外起了个 3.10 的虚拟环境才装上。这条文档里写在小字里,很容易漏。
第二步,看效果。想先听听成色,不用装任何东西,直接开官方样音页 openbmb.github.io/voxcpm2-demopage(国内直连顺畅,优先用这个)。HuggingFace 上也有个 Space 可以实时试,但国内访问时好时坏,连不上就别较劲。我从这一步开始确认:就是这个味儿。
第三步,本地跑。有显卡的同学最省事:python app.py --port 8808,浏览器打开 localhost:8808,起一个本地 Web 界面,三种模式都能点点选选,直接在里面挑声音。
第四步,做服务。要接进自己的产品:vllm serve openbmb/VoxCPM2 --omni --port 8000。起完就是一个 OpenAI 兼容的 /v1/audio/speech 端点,原来调 OpenAI TTS 的代码改个地址就能跑。
顺便说个速度的实话。官方标的 RTF 是 RTX 4090 上 0.30(RTF < 1 表示快过实时,0.30 就是 1 秒生成约 3.3 秒音频),Nano-vLLM 加速到 0.13。但社区里真实报出来的数是这样的(issue #223 里的实测):
▪︎ RTX 5070 Ti:单并发 RTF 约 0.16,20 并发时吞吐 50 字/秒
▪︎ RTX 5060 Ti 16G:RTF 约 1.2
▪︎ Intel Arc A770:RTF 约 0.55
同一模型,不同显卡能差出七八倍。所以别信任何"快到飞起"的说法,先看自己手头那张卡。没有 N 卡的也别急:Mac 上 app.py --device mps 能跑 Apple Silicon 的 MPS,慢一些但能用;想跑在手机或树莓派上,社区已经有 llama.cpp-omni + GGUF 的方案。
然后是我自己的实测记录——这台 M1(16GB,无独显)。
我把《鲧禹治水》的四个角色全跑了一遍:旁白、禹、少女、部落长老,四条全部出声。模型加载 80 秒左右,四条音频分别用了 60.6 / 42.5 / 45.0 / 79.3 秒生成,RTF 6.02 / 4.22 / 5.11 / 6.79——比 4090 慢十几倍,但比"完全跑不了"强得多。下面这张图的波形不是我画的示意图,是从生成的 wav 里直接采出来的:
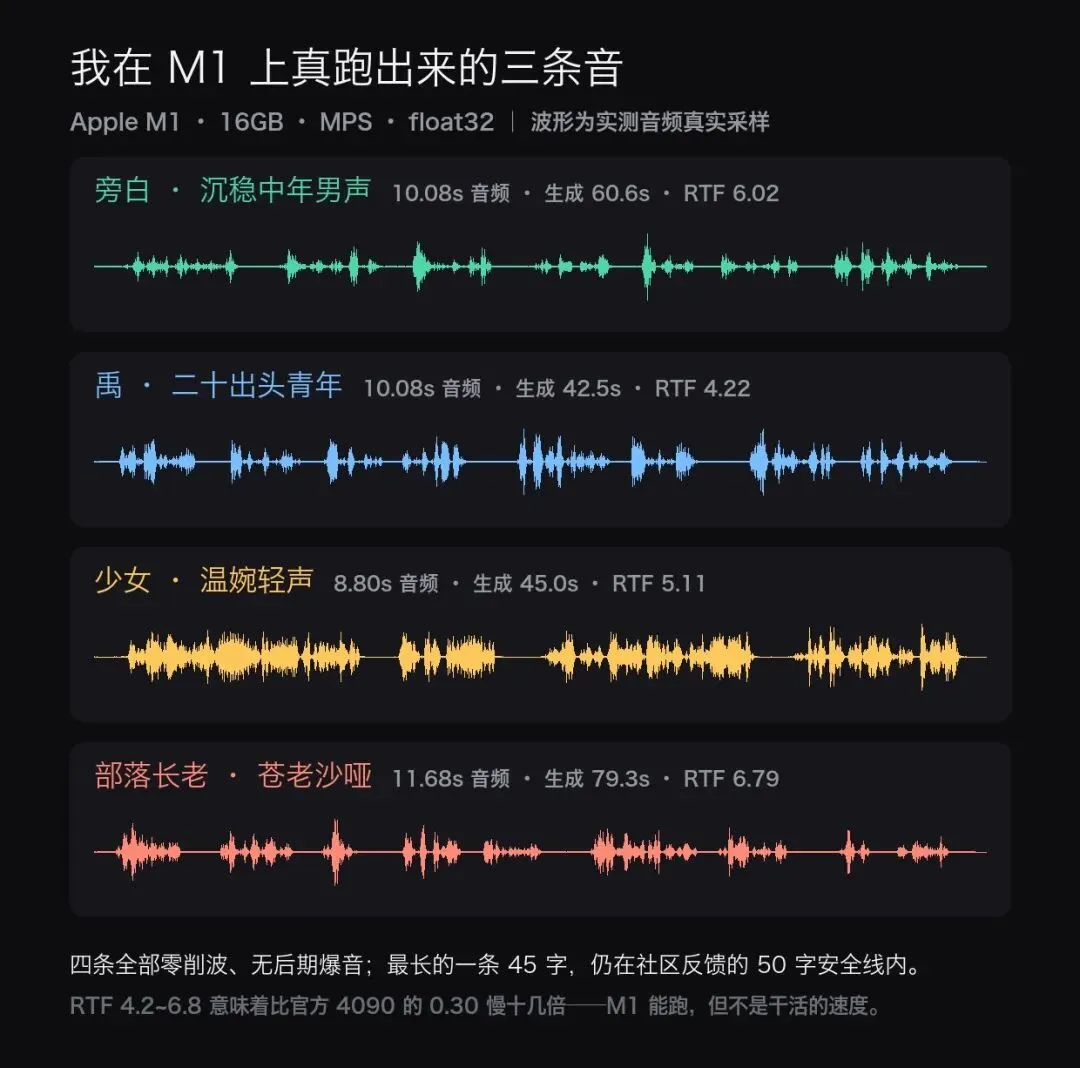
音质上,四条全部零削波、无后期爆音。特别说一句长老那条:45 个字,已经贴近社区反馈的"50 字啸叫线",实测仍在安全区——issue 里那个"每段 50 字以内最稳"的结论,我用自己的机器验证了一遍,是真的。
顺手记录这次撞到的三个坑(资料包里都写了):
▪︎ 官方 README 里的 seed=42,pip 版 2.0.3 不认识,照抄报 TypeError。想固定结果得自己 torch.manual_seed()
▪︎ Mac 必须传 device="mps" 且关掉 optimize,后者在非 CUDA 设备上直接抛错
▪︎ README 里那个"生成字幕时间戳"的功能,发布包里根本没有——voxcpm design --help 里没有 --timestamps,依赖里也没有 stable-ts。做漫剧想靠它直接出字幕的,先别指望
这三条 README 都没写(第三条甚至是 README 写了但包里没做),属于"发出来大家会踩"的真实坑。
四、给你的五条实战经验
这几条是我做完那部漫画之后的总结,官方没写:
1. 描述词要写得像在挑人,不要像在许愿。"好听的声音"没用,"35 岁男声,中低音,语速偏慢,播客旁白感,尾音干净"才有用。性别 + 年龄段 + 音区 + 语速 + 使用场景,五个维度至少给三个。
2. 一段不要超过 50 个字——这条是硬教训。社区 issue #234 和 #372 里,多位用户反馈:用参考音色连续生成,超过 100 个汉字之后啸叫会越来越大,最后彻底爆掉。官方维护者回复了两个办法:把长句切成短句分开合成,以及把 CFG 从 2.0 降到 1.5 左右能缓解。我自己试下来,每段控制在 50 字以内最稳,分段合成后再拼接。
3. 传参考音频报错,多半是 ffmpeg 的问题。issue #119 里那个报错很常见:Could not load libtorchcodec。原因是 torchaudio 2.8/2.9 开始调 torchcodec 解码音频,机器上没装好 ffmpeg 就炸。解决:brew install ffmpeg + pip install torchcodec,macOS 上还要补一句 export DYLD_LIBRARY_PATH=/opt/homebrew/lib:$DYLD_LIBRARY_PATH。
4. 参考音频要洗干净,但 16kHz 够用。单人、无背景音乐、无明显混响,10 到 30 秒就够。它对输入噪声比较敏感(官方在 issue 里也这么说过)。好在参考音频 16kHz 也没关系,非对称编解码能直接出 48kHz。
5. 方言是它的独占红利。粤语、四川话、闽南话、东北话这 9 种方言,主流云端 TTS 基本不覆盖。做地方号、方言短剧、区域定向投放,这条别人抄不走。
五、版本怎么选
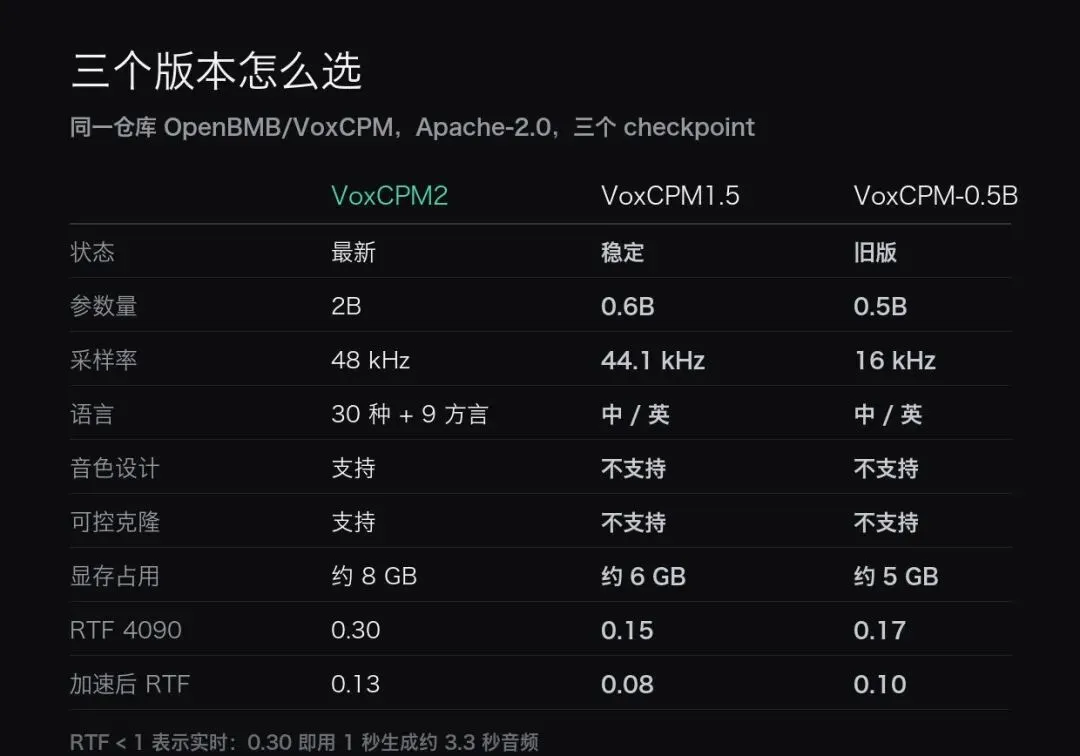
一句话:有 8GB 显存就上 VoxCPM2——它是同时具备 48kHz、30 语言、音色设计、可控克隆的唯一一个。只有中英双语需求、显存紧张的退回 VoxCPM1.5(0.6B / 6GB);VoxCPM-0.5B 已经标记 Legacy,只建议做研究对照。
六、这条红线别踩
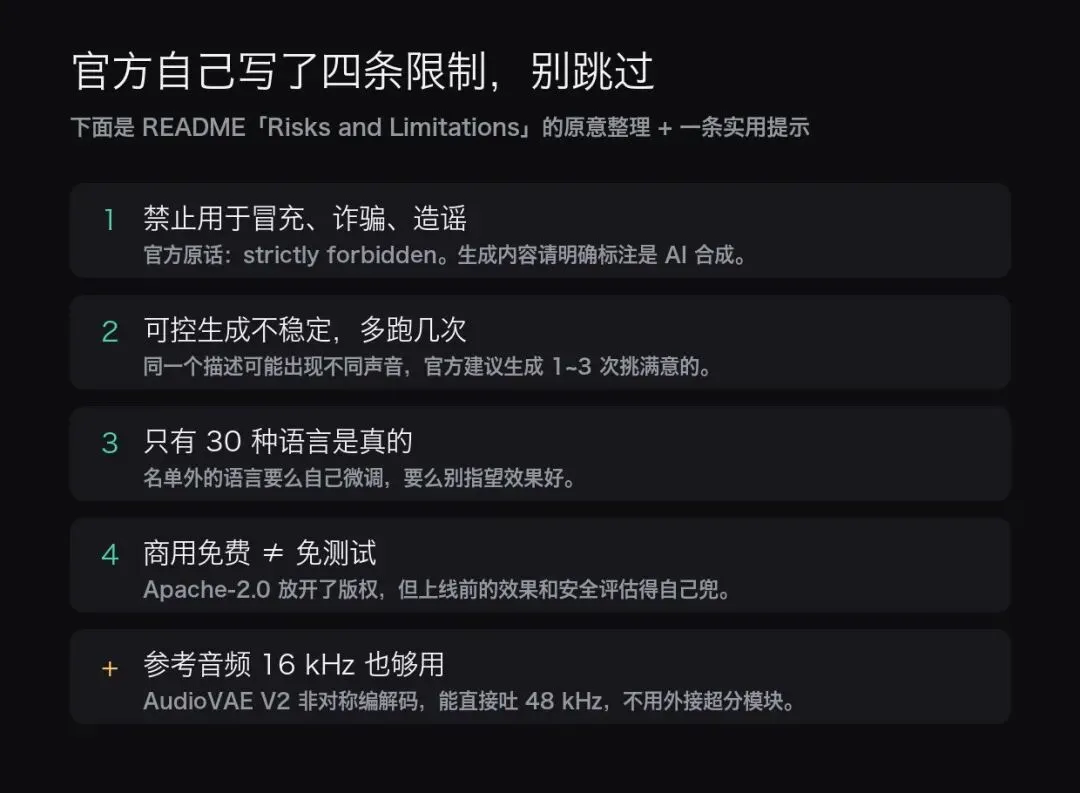
前四条是官方 README「Risks and Limitations」的原意整理,最后一条是我补的:
▪︎ 禁止用于冒充、诈骗、造谣。官方用词是 strictly forbidden,并强烈建议给 AI 生成内容做明确标注。这条不是走形式——声音克隆是现在电信诈骗的主要技术手段之一
▪︎ 可控生成不稳定,同一个描述可能出不同的声音,多跑几次挑
▪︎ 官方只保证 30 种语言,名单之外的要么自己微调,要么别指望
▪︎ Apache-2.0 不等于免测试。协议放开的是版权,上线前的效果验证和安全评估得自己兜
▪︎ 我补一条:协议放开的是代码和权重,不是你克隆对象那把嗓子的权利。用明星、同事、任何真人声音做克隆,涉及声音权益和肖像权,商用前必须书面授权。这是法律问题,不是技术问题
最后说句实在的
这两年 AI 工具看下来,我越来越有一个感觉:真正改变门槛的,从来不是"效果又好了几个点",而是"这件事终于不用求人了"。
VoxCPM2 的 SIM 是 79.5 还是 81.8,对绝大多数做内容的人没那么重要。重要的是:你今晚花半小时配好环境,明天就能用几十种语言、几种方言、任意多个不存在的人,把内容一次性做出来——不付版权费,不看平台脸色,不受字符数限制。
我做《鲧禹治水》那次,光是画就返工了一轮。现在回头看,配音这一步其实才是最贵的:它卡住的不是技术,是你敢不敢幻想一个大制作。
至于声音像不像真人,这事早晚不成问题。真正难的是另一件事:当谁都能随时造出任何人的声音,"听见"就再也不能当作证据了。
技术往前跑的时候,最好带着刹车一起装。
我是张小二,一个帮人少走弯路的 AI 教练。这个号只拆我上手跑过的东西,能跑的我跑,跑不了的我标清楚出处。
这次的整套东西我打包好了:安装命令、三种模式的完整代码、社区踩坑清单(11 条,其中三条是我这次实跑自己撞出来的),还有我用的那套音色描述词库。评论区扣「声音」,我发你。
感谢看到最后,如果喜欢这篇文章,不妨顺手给一个点赞、再看、转发、评论。如果想第一时间收到推送,不妨给个星标。如果你有更有趣的玩法,欢迎聊聊。更多的内容正在不断填坑中。可私信进群,面对面交流学习。
THE END