ARTICLE · 1159241
AI 怎么操作中望 CAD / AutoCAD?TmAgent AI 插件全解析:107 个 · MCP · LISP
AI 怎么操作中望 CAD / AutoCAD?TmAgent AI 插件全解析:107 个工具 · MCP · LISP
从 178 个工具砍到 107 个,再用两个月让 AI 真的「用通」CAD——一个 AI 绘图工具的诞生记。
关键词:AI+CAD、中望 CAD AI 插件、ZWCAD AI 插件、AutoCAD AI 自动化、AI 操作 CAD、CAD AI 智能体、MCP 连接 CAD、CAD MCP 服务端、AI 读图、CAD 几何感知、CAD 批量出图、LISP AI 编程、TmAgent
如果你正在搜「AI 怎么操作 CAD」「中望 CAD 有没有 AI 插件」「AutoCAD 能不能接 AI 智能体」「MCP 怎么连 CAD」——这篇就是给你写的。
TmAgent 是一个装进 中望 CAD(ZWCAD) 和 AutoCAD 里的 .NET 智能体插件,把 CAD 变成 AI 能实时读写、实时感知的数据源。它对外暴露 107 个细粒度 CAD 工具,跑在本机 localhost 上,既能被内置 AI 面板直接调用,也能通过 MCP 端口接进 WorkBuddy / CodeBuddy / Cursor / Claude 等任意外部 AI 智能体。
一句话定位:别人在卷「AI 能不能画出来」,我们解决的是「AI 能不能自己确认画对了」,并且把整张图真正用起来——查、画、改、统计、标注。
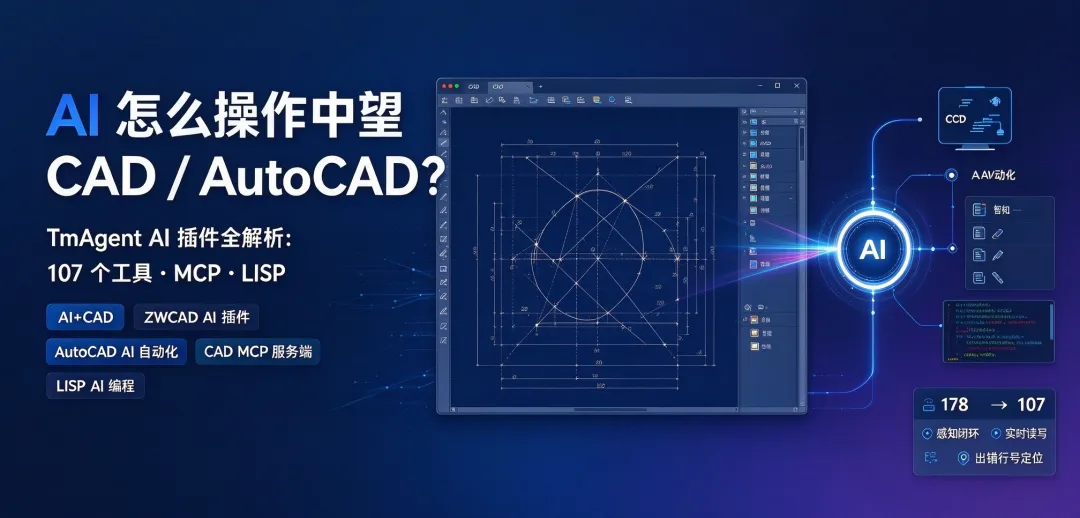
从 178 个工具砍到 107 个——AI 绘图工具的诞生
一、为什么 AI 接手 CAD 总是「原地打转」
让一个没有接 CAD 的大模型写 LISP,剧情几乎固定:它给一段代码 → 你贴进 CAD → 报错 → 你把报错复制回去 → 它改一版 → 又错……来回十几轮,人先崩了。
问题不在模型笨。它对代码逻辑的判断经常是对的,缺的是「现场」:看不见图纸里有什么图元、看不见这次到底选中没有、看不见命令行的提示、也不知道自己那段代码画出来的图长什么样。
这在控制论里叫开环——只有输出、没有反馈,只能靠人在中间一遍遍当「人肉传感器」。
TmAgent 干的第一件事,就是把这个开环硬生生改成闭环:在正在运行的 CAD 进程里驻留,给 AI 装上眼睛、手和耳朵。
二、AI 画图的手段很多,难的是让 AI 读懂图
先把一件事说清楚:让 AI「画」出图形,从来不是瓶颈。
能走的路太多了——直接吐 DXF 文件、走 COM 端口发命令、写 LISP、写脚本、发 CAD 原生命令……手段遍地都是,随便挑一条都能把线画出来。
真正的分水岭在画完之后:AI 知不知道这张图现在是什么样?
我刚画的那条线,跟图里哪些图元相交? 这个块放进去,包住了谁、又被谁挡住? 我要塞的图框,这块空白装得下吗? 上一步操作,到底动了什么——还是根本没生效? 有没有碰撞、有没有孤岛、有没有重复冗余?
这些问题,光靠"能画"回答不了。只会生成、不会核对的方案,在精确工程里根本不敢托付。 CAD 不是画概念图——差一个交点、少一条闭合边、图元跑到图框外,全算错。
所以 TmAgent 把重心压在感知上:不是让 AI 多会画一笔,而是让 AI读懂图、读懂几何关系、读懂空间关系。107 个工具里,感知相关的占了近三分之一。
感知矩阵:四把尺子
| 清点 | query_entitiesentity_info(单图元完整属性与端点)、find_text、get_bounds、get_drawing_fingerprint(整图打指纹:空间聚类 / 重复冗余 / 异常诊断) | |
| 测量 | geo_basicgeo_query(距离、角度、中点、交点、最近点、面积、长度)、calc_area、divide_curve | |
| 空间 | connectedinside(包含)、aligned(对齐)、detect_clash(碰撞重叠)、find_vacant(找空位)、detect_islands(孤岛聚类) | |
| 追踪 | verify_resultentity_track(绘制前建基准,绘制后自动挑出新图元并打标签)、read_commandline(回读 CMDACTIVE/CMDNAMES/LASTPROMPT) |
有了这四把尺子,AI 才从「像素级」升级到「空间关系级」——先读懂图,再动手;动完手,再核对。
一句话卖点:TmAgent 是感知能力最强的 AI+CAD 解决方案——绘图与编程只是它感知地基上的两层楼。
三、178 → 107:一个 AI 绘图工具的收敛史
这个数字不是一开始就有的,是被砍出来的。
故事的开始很轻。 让 AI 能操作 CAD 的核心,写出来只花了一天——接上进程、开个端口、塞几个画图命令,跑通了。
然后是疯狂的扩张期。 跑通之后人会飘:恨不得把所有能想到的操作都做成工具。画、改、查、图层、块、标注、布局、导出……什么都想要,工具数量一路冲到 178 个。当时的想法很朴素——能力越全,AI 越强。
接着撞上两堵墙。
- 第一堵:token 扛不住。
MCP tools/list会把全部工具的 JSON Schema 一次性吐给模型。178 个工具常驻上下文就是十几 k tokens——还没开始干活,模型的注意力已经被工具名吃光了。 - 第二堵:AI 选不对工具。
工具一多,近义的互为干扰项: move和transform选哪个?query_entity和entity_info差在哪?模型在报错和重猜之间反复横跳,比少几个工具更慢。
所以进入收敛期,三把刀:
- 聚合式压缩
——纯扁平(每个动作一个工具)爆炸,纯聚合(一个大工具带 action参数)又会让参数校验失效、模型猜错 action。最后落在两者之间:能让参数自然区分的,合并;语义差异大的,独立。 transform一个工具吃掉 move/copy/rotate/scale/mirror,靠action分发;array自动分发到 array_rect/array_polar;entity_tag收编 add/remove/query/select四个标签动作;layer_manage与 set_layer合并,旧名仍可调用。- 冗余兼并
——同义、重叠的能力并成一条,旧名留转发分支。代码里至今留着 63 处「兼容旧名/已并入」——改名字的成本不能转嫁给用户。 - 删减
——真正说不清价值、或者模型根本用不对的,删掉。
178 → 107。
但收敛完,事情并没有结束。
之后的两个月闲暇时间,几乎全花在"磨"上:系统提示词改过十几个版本(每一版都在调"怎么让不同模型都愿意按同一套方式调用")、工具反复校验雕琢(参数名、返回文案、边界行为一遍遍过)、兼容性不断外扩,最后专门建起一层——模型输出容错层(见第四节)。
判断也在这期间想明白了:工具不是越多越好。多到一定程度,每多一个都在降低整体的准确率。
覆盖范围(19 类,107 工具全清单)
| draw 绘图 | |
| text/dimension/hatch | |
| layer 图层 | |
| dwg 文件管理 | |
| edit 编辑 | |
| block_group 块与组 | |
| query 查询 | |
| geo 几何计算 | |
| spatial 空间感知 | |
| view/selection 视图与选择 | |
| layout 布局与视口 | |
| file/data 文件与数据 | |
| misc 杂项 | |
| lisp LISP/脚本 |
(分类计数以源码 为准:query 19、edit 18、draw 9、selection 9、file 8、misc 7、spatial 6、block_group 5、view 4、geo 4、layout 4、lisp 4、data 3、layer 2、dimension 2、text 1、hatch 1、dwg 1,合计 107。)
四、模型输出容差:工具后台不挑格式,只认意图
做 AI+CAD 最容易被低估的工程量,是模型不会按你教的方式输出。
我们提示词里只教一种格式 ```command 围栏。但真跑起来,不同模型会自带训练痕迹:Claude 爱吐 <invoke name="cmd">,Qwen 爱吐 <tool_call>{"name":...},Gemini 吐 {"functionCall":{...}},DeepSeek 有自己的全角标记,OpenAI 系爱吐 {"name":...,"arguments":{...}},还有模型偷懒直接给裸 JSON、给单引号 JSON、给带注释的 JSON、给尾逗号。
我们没有选择「报错让它重来」——工具后台一层层做兼容,把容差吃在自己身上。 真实实现分三层:
第一层:JSON 缺陷修复(RepairJson),先严格解析试探,过不了再依次修:
转义 JSON 字符串字面量里的真实换行/回车/制表符(模型常把多行报告正文直接塞进字符串); 剥掉 //单行注释和/* */块注释——扫描时跳过双引号内部,不会把"http://x"里的//误删;单引号字符串字面量 → 双引号( "Don't"里的撇号安然无恙);去尾逗号 ,}/,];键名未加引号 { command: "circle" }→ 自动补引号。
修复仍失败就原样返回抛出原始异常,由外层捕获写进执行结果——绝不静默丢弃,否则 AI 会误判「任务完成」直接收工。
第二层:多模型输出格式全兼容,正则矩阵覆盖 <invoke>/<antml:invoke>/<function=cmd>/<tool_use>/<tool_call>/ DeepSeek 全角工具标记 / GeminifunctionCall/ OpenAIname+arguments/ Qwen JSON 体 / 裸围栏,任意命令名 +<parameter>参数都被接受并转成标准命令。防冲突设计:命令名必须存在于工具注册表,正文里的示例 JSON 不会被误当命令执行。
第三层:参数值本身容错(CadCommand):
- 数字
GetDouble:20(数字)/"20"(字符串)/true→1 都收;"3.5"按 Invariant 解析,避开某些区域设置下逗号小数点的坑;"1,200"千分位串也能读。 - 布尔
GetBool:true/false、1/0、yes/no、on/off、y/n,甚至中文的「是/否」都认。 - 数组
GetDoubleArray:[1,2,3,4]、[[x,y],[x,y]]、[{x,y},{x,y}](大小写 X/Y 都行)、字符串"1,2,3,4"(逗号、中文逗号、空格都能切)——四种写法通吃。 - 字符串数组
GetStringArray:单个字符串自动按逗号/中文逗号拆分。
最后一层:绝不静默画垃圾。ValidateRequiredParams 对绘图类命令做必需参数校验——rectangle 缺 width/height 不再被当成 0 静默画出一个 0 尺寸矩形,而是明确回报:rectangle: 缺少必需参数 width、height(正确参数名见 /api/help?command=rectangle)。
五、执行反馈:不回「成功」,回「到底变了什么」
大多数插件级自动化只回报 OK。TmAgent 的反馈内容丰富度是刻意做厚的,因为这是 AI 自驱循环的燃料。
举三个真实返回:
1. 结构变更 diff(verify_result)
验证:
  128→131 (+3) +3 -0 ~1
  有变化
  +新增(3): H:2A7=Line... H:2A8=Line... H:2A9=Circle...
  ~修改(1): H:1F4(...→...) [坐标: (0,0)→(120,45)]
旧数→新数、净增、新增/删除/修改各自计数、逐图元句柄,detail=true 时连哪个字段变了(坐标/文字/图层/颜色)都点出来。
2. 求值超时的语义修复(TimeoutOrErrorText)
LISP 求值「超时」时,它会回读 CMDNAMES 和 LASTPROMPT 做二次判定:如果 CAD 已空闲、命令行里躺着 Error 字样,那根本不是超时,是错误被吞了——于是如实返回 Lisp求值错误: ...,而不是误导性的「超时」。若真是超时,则附上诊断尾巴:
(超时诊断: CMDNAMES=空 CAD空闲⇒求值多半已结束(真实错误看 LASTPROMPT); LASTPROMPT=...)
3. Python 多路退化诊断python 通道会依次尝试 直接调用 → cmd 包装绝对路径 → cmd python → cmd py,专治 Microsoft Store 版 Python 的 App Execution Alias(直接 CreateProcess 返回 9009,经 cmd /c 才能被 Windows 正确解析)。全失败时返回:python启动失败... FindPython解释器=<路径>,尝试=[direct=exit...; cmd(abs)=exit...],把「为什么跑不起来」摊开给 AI 看。
再加上 read_commandline 的 CMDACTIVE(位标志,ZWCAD 空闲时也可能是 128,所以判断「有没有命令在跑」要看 CMDNAMES 非空或 (值 & 1) != 0——这个坑我们踩过并写在返回文案里)、get_drawing_summary 的类型/图层/密度统计、get_drawing_fingerprint 的范围/类型 Top12/图层 Top8/聚类/冗余/异常七段输出。
AI 拿到的不是「成功」两个字,而是一份可以据以决策的现场报告。
六、容错哲学:铁律管不住所有模型,容错可以
写到这儿,该讲讲这套东西背后真正的那条思路。
做多模型适配时,人最容易有的冲动是——把规则写严。参数校验加满、格式只认一种、不按规矩来就报错。听起来很"工程",我们一开始也这么干。
试过之后才发现:铁律管不住所有模型的每一次调用。
原因很直接:不同模型的训练痕迹是刻在权重里的。 你没法用一份提示词把 Claude、GPT、Gemini、Qwen、DeepSeek 的"脾气"全部归正——它们连怎么打工具调用的标签都不一样。你把规则写死,只有那一个"符合规则"的模型能过,其余全被卡在门外。
那怎么办?反过来——在经常出错的地方,把容错做厚。
真实动作有四类:
- 在「输出格式」上做容错
——模型怎么吐都行,后台消化掉(第四节那三层)。这是格式容错。 - 在「调用语义」上做反馈
——参数传错了、坐标给了字符串、缺了必填项,不是回一个冷冰冰的 Error,而是告诉模型错在哪、正确值长什么样,让它下一轮自己改对。这是语义反馈。 - 在「结果判定」上做反馈
——命令执行完不回「成功」,回到底变了什么(第五节)。因为「没报错」不等于「做对了」。这是结果反馈。 - 在「出错定位」上做反馈
——报错了要能告诉模型错在哪一层、哪一行,而不是让它从头猜(第七节)。这是定位反馈。
四类里,前一类是"接住不规范",后三类是"让 AI 自己走回正轨"。
限制只能管住一种模型,容错能接住所有模型。
这句话是这套设计的题眼。与其花力气去"管住"模型,不如把犯错的地方一个个包上缓冲垫——因为你要服务的不是某一个模型,而是此时此刻接进来的那一个。
七、最深的一层反馈:让 AI 读到 LISP 的错误堆栈
前面说的"定位反馈",在 LISP 上做得尤其深——我们让 AI 能读到 LISP 的错误堆栈。
这件事挺关键,因为别的 AI+CAD 工具基本做不到:它们要么在 CAD 外面(只能看代码本身),要么根本没有把 CAD 的错误现场接出来。
TmAgent 做了两条互补的通道,都是在 CAD 进程里拿到的真东西:
vl-bt 反向跟踪 | CAR <- TM:AUX <- TM:MAIN) |
| 旁听官方调试器(DAP) | 出错行号 + 错误原因 + 栈概览 |
通道一:vl-bt 反向跟踪
vl-bt 是 AutoLISP 的反向跟踪函数,但没进公开文档,知道的人不多。用法有三步:
执行前把 *error*换成具名 handler(lambda形式实测会报函数错误: (quote #<SUBR …-lambda->),这个坑踩过才知道);handler 里先 (vl-bt),反向跟踪写进命令行日志(LOGFILEMODE=1落盘,路径取(getvar "LOGFILENAME"));插件读日志尾部,抽 反向跟踪:之后的[n] (FRAME …)行。
拿到原始帧还不够——求值器、错误钩子会混进一堆噪声帧。所以有一张噪声帧过滤表(VL-BT、_CALL-ERR-HOOK、SYS-ERROR、ERROR-BREAK、RTS_TOP、VEVAL-STR-BODY、CALLBACK-ENTRY、ARQ-SUBR-CALLBACK、VL-CATCH-ALL-APPLY,连我们自己的 TM:ACAD-ERR handler 帧都滤掉),只留用户函数。
局限也如实写在代码里:AutoCAD 侧的帧只有函数名、没有行号;用户代码若自己设了 *error* 或吞掉错误,也抓不到。
通道二:旁听官方调试器(DAP)
这是补上"行号"的那条路。插件加载时 spawn 中望官方的 zwlisp-debug.exe(DAP 适配器),attach 到当前 CAD 进程,但只旁听——不干预,只收集"代码崩在哪一行、什么错"。
工程上有三条用血换来的硬约束:
- attach 成功后必须
立刻** configurationDone**——否则 CAD 命令行会被冻结(实测 8 秒不返回)。 - 一个 CAD 实例只接受一个 attach("占用租约")。
用户自己正在 VS Code 里调试时,会被拒绝。这时必须如实回报,不能假装旁听成功,但也绝不能让 lisp_eval失败——降级到只有vl-bt,而不是整个求值挂掉。 - 行号要还原。
因为代码是被包装后送进求值器的,头部多了 WRAP_HEAD_LINES=4行,DAP 报的行号要按FRAME_LINE_OFFSET=3偏移回来。实测:code 文件第 4 行除零,DAP 给出line=8。
还有两个很能说明工程量的细节:
- 冷启动握手约 10 秒,热态只要 0.06 秒
——所以只在需要时激活一次(第一条 stack=true请求),并置位复用。 VLIDE会拉起 VS Code。所以发 VLIDE之前先拍一张code.exe的 PID 快照,结束时只关本次新拉起的那些(取差集)——绝不碰用户自己开的 VS Code。而且 VLIDE走主线程SendStringToExecute是排队的(Idle 返回后才执行),直接 spawn 会冷态超时。解法是先同步把VLIDE发出去(阻塞到它真正执行完),再 spawn/attach——主线程零阻塞。
为什么别的工具不具备这个能力
因为这两条通道都要求"人在 CAD 进程里面":要能改写 *error*、要能读 CAD 命令行日志、要能 send VLIDE、要能 spawn 并 attach 官方调试器。
外部工具——哪怕是最强的代码模型——看不到 CAD 的命令行日志,也 attach 不进 CAD 调试器。它只能看代码本身。所以它只能猜。
它会「学会」被更多工具用
这个能力挂在 lisp_eval 这条公共通道上,不是给某个 Skill 开的特权。
- 今天
:lisp 编程助手在用它,把"写—跑—核"做规范; - 明天
:任何新 Skill,只要用 LISP 实现某项能力,就自动拿到"出错行号级"的反馈,不用自己再造一遍; - 外部
:任何智能体经 MCP 端口调 lisp_eval,同样拿到这套堆栈。
做通道,不做特权。 它不会只服务一个 Skill,而是服务所有未来会用 LISP 的工具。
八、两条端口:单条走 MCP,批量走 REST
TmAgent 在 CAD 进程内起一个本地 HTTP 服务,默认 http://127.0.0.1:9876(被占用会自动递增,真实地址写在 %APPDATA%/TmAgent/api_address.json,所以调用方靠探测而不是猜端口)。
暴露两个同源端口:
| MCP 端口 | POST / api/ mcp | mcp__tm-cad__<命令> 工具 | |
| 批量执行端口 | POST / api/ execute | {"commands":[{"command":"circle","cx":50,"cy":50,"r":20}, ...]},results 数组 1:1 返回 |
辅助端点:GET /api/health 健康检查(cadResponding 用 Win32 探活、不调 CAD 接口,所以 CAD 卡住时健康检查也不会跟着挂)、GET /api/help?command=<名> 实时查命令文档。
为什么批量端口是刚需
想象「布局图框批量导出 PDF」这类活:一个 DWG 里 20 个图框,每个都要切布局、设视口、导出。如果走 MCP 单条调用,就是 60 次来回;走 /api/execute,一个数组发下去,一次执行、结果 1:1 回来。
批量端口还有个更关键的用法:Python 计算与 CAD 操作并发。python 和 web_search 这两类不依赖 CAD 的命令会被单独拎到后台线程跑,不阻塞 CAD 主线程——于是「Python 里跑 numpy 算坐标,同时 CAD 在画图」成为可能。
核心通道:lisp / lisp_eval / script / python / command
/api/execute 与 MCP 端口共用同一套核心执行通道,按语义分五条:
command | |||
lisp_eval | 有 | ||
lisp | |||
script | .scr 文件轮询结果,用于 CAD 原生命令序列 | ||
python |
这里有个真正难啃的工程坑:ZWCAD 的 SendStringToExecute 只在当前命令处理器完全退出后才执行,所以 lisp_eval 的返回值无法在同一次执行里读到。TmAgent 的解法是「两阶段延迟读取」——执行器把结果写进 pending,让出 Win32 原生消息泵让 CAD 处理命令队列,下一轮 AI 调用前消费 pending 并注入 [系统回传],然后才执行后续 CAD 命令。这样才实现「lisp_eval 改完、同轮能查到绘图结果」。
另外,连续的 lisp_eval/script/query 命令会被打包合并成一个 LISP 文件,一次发送、一次轮询,避免 N 次往返。
终极兜底是 COM SendCommand:就算 MCP 和 REST 都没起来、CAD 还开着,也能用 Windows COM 直接发原生命令——TmAgent 自己的 NETLOAD 恰恰就走这条通道。
九、两个配套 Skill:一个负责把 TmAgent 用满,一个只管编程
TmAgent 本体是引擎,两个 Skill 是站在引擎上的操作手册,在 SkillHub / WorkBuddy 技能市场可以搜到。它们是分层依赖,不是并列关系——先把线接好,才谈得上在上面干活。
先钉死一条容易搞混的边界:「接通 + 用通」是绘图助手的职责;lisp 助手只管编程,不承担用通。
CAD-TmAgent 绘图助手tmagent-cad) | TmAgent 的能力总入口 + 操作手册 | |
lisp 编程助手lisp-programming-assistant) | 编程支路 |
CAD-TmAgent 绘图助手:不是"连上就完事",而是让 AI 把引擎用满
别把它当"环境配置 / 连接器管理"看——那只是它的第一步。 它的完整职责有两层:
第一层——接通。 三步把 CAD 接进 AI:
- 跑
setup_tagent.py:自动检测平台、本地缺 DLL 时在线下载(下载后校验文件头必须是 MZ,防止把错误页当 DLL)、NETLOAD进已打开的可见 CAD、等 HTTP 起来、写好连接器。支持--app zwcad|autocad、--launch、--check做版本感知的配置。
刻意设计:只挂已运行的可见实例,绝不另起后台无界面 CAD,避免挂错或凭空多开。 - 连接器页点一次「信任」
:安全闸门,仅首次。记住「写了配置 ≠ 生效」。 - 用
/api/health验证:返回 {"status":"ok","cadResponding":true,"hasActiveDocument":true}即就绪。
中望对应 TmAgent-ZCAD.dll、AutoCAD 对应 TmAgent-ACAD.dll,二者不能同时挂,切平台先关另一端。
第二层——用通:把 107 个工具、五条通道、四层感知能力真正用起来。 这才是它的主战场。工具不是列出来就会用,这层负责引导 AI:
- 动手前先查
:用 query_entities/get_bounds看清图纸现状,别照着口语猜; - 查工具文档
: /api/help?command=<名>实时取参数,别硬编码; - 按场景选工具、分通道
:单条交互走 MCP,多步/批量走 /api/execute,复杂算出走python; - 把能力串成工作流
:不是"调一次工具",而是把「查—画—改—统计—标注」串成一条能交付的活(出图、坐标提取、图纸体检、批量改图); - 用完核对
: verify_result/read_commandline/ 回读文件,确认真的改对了。
不是让 AI 背下 107 个工具,而是让 AI 知道「想干这件事,该去哪查、该调哪个、该怎么串起来、怎么核」。
一句话:它就是把 TmAgent 从"能跑"带到"用通"的那本说明书。
lisp 编程助手:把用户经验落地成 LISP 插件
这条 Skill 只负责编程这一件事,而且不使用 TmAgent 的完整能力。它针对的真实场景是:用户脑子里有一套自己的经验(某种画法、某种提取规则、某种批处理逻辑),想把它变成一个能反复调用的 LISP 插件,而不是每次口头指挥。
它不负责教 AI 怎么查图、怎么统计、怎么标注——那些是绘图助手的事。它只需回答一个问题:这段 LISP 写对了吗、跑通了吗、结果对吗?
① 双模式写法。 主函数只写一份,只在开头「取参数」处分一次叉——交互从 entsel 拿、调试从预设变量拿,分叉之后所有业务逻辑一字不差共用。AI 只需注入两行就能无人值守跑起来。这是写代码时就该定的结构,不是调试技巧。
② 四级报错定位——从便宜到贵,能省钱就不花钱。
Lisp求值错误: … | ||
stack=true | 错误堆栈 | |
第 3 级就是前面那两条堆栈通道。它让"错在哪一行"从猜变成读——这个能力只有驻留在 CAD 进程里的工具才拿得到。
③ 验证「这段代码的结果对不对」——这是它少数几处会用到 TmAgent 感知能力的地方。 一段 LISP 跑完没报错,并不等于跑对了:它可能选错对象、一个交点都没算到、CSV 行数跟返回值对不上。以随包示例 polyint(选中多段线,统计所有相交图元的交点并导出 CSV)为例:写前 query_entities/get_bounds 勘察真实图纸 → 算法本身感知友好(用「全图选候选 + 包围盒粗筛」而不是依赖视野的选法)→ 跑完双向核对:光看返回的交点总数不够,AI 会回读那份 CSV,用行数、句柄、坐标反查——只有「返回值说 N 个」和「CSV 里确实 N 行且几何对得上」两头对齐,才判定真跑通。对不上先怀疑代码,绝不为了让结果好看去偷改期望值。
这里调用感知工具,是服务于「验证这段代码」,不是在做完整的图纸查询作业。验证手段 ≠ 用通能力。
④ 交付红线。 最典型是编码:AI 天然写 UTF-8,可 CAD 的 load 按 ANSI(GBK) 读,直接交付就是乱码。所以调试时自动转一份临时 ANSI 副本加载、用完即删,正式交付前必须把源文件也转 ANSI。另外:路径一律正斜杠;AutoCAD 的 load 要求 .lsp 放在受信任 projects/ 目录(中望不受限);技能进化必须经用户确认,禁止 AI 私自改。
关系说透:绘图助手负责接通,并把 AI 带到"用通"——教它查、教它选、教它串、教它核,覆盖 TmAgent 的完整能力面;lisp 编程助手是一条独立的编程支路,只把用户经验落成 LISP 插件。 lisp 编程助手不带连接能力,完全依赖绘图助手先把线接好,而它验证代码时用的感知工具,正是 TmAgent 本体提供的那批。
十、架构:三点立住
- CAD 进程内的 .NET 插件(闭源引擎)。
只有 CAD 自己的进程才实时持有活的图纸对象模型和主线程;任何外部进程解析磁盘上的 DWG 都只看得到「死快照」。所以通过官方 NETLOAD注入 CAD 进程本体。 - 本地 HTTP / MCP 服务。
插件在 CAD 里起 HTTP 服务并暴露 MCP,于是每个 CAD 操作在智能体里都是一个带参数校验的标准工具。 - 双接入方式。
既可以在 TmAgent 自带的 UI 面板里填 API-Key 直接用;也可以经 MCP 端口交给外部智能体驱动。引擎闭源、集成层免费开放,DLL 走在线分发,Skill 与连接器免费。
十一、它能帮你做什么(场景一句话)
- 让 AI 写/改 LISP 插件,跑通再给你
——不用你当人肉搬运工,AI 自己跑、自己读栈(连出错行号都拿到)、自己核对图纸。 - 布局图框批量导出 PDF
—— layout+find_frame_bounds+create_viewport/set_viewport组合,一次数组批量下发。 - 测绘/土木出图与坐标提取
—— query_entities+entity_info批量取控制点坐标高程,export_csv定量导出。 - 自动化出图 / 批量改图
——一句话意图,合并成一串命令批量执行,改完 verify_result自动 diff 复核。 - 图纸体检
——摘要、图元指纹、碰撞/重叠检测、找重复、量面积,让 AI 先「读懂」这张图再动手。 - 数据双向打通
——CAD ↔ CSV / 表格 / Python 计算(numpy / scipy / shapely),把图形数据拉出来算、再画回去。
十二、常见问题(FAQ)
Q:TmAgent 支持哪些 CAD?
中望 CAD(ZWCAD)和 AutoCAD,分别是 TmAgent-ZCAD.dll / TmAgent-ACAD.dll。不能同时挂,切平台先关另一端。
Q:「跑通」和「用通」的区别?
跑通 = 一条命令真的执行成功;用通 = 查、画、改、统计、标注五件事连起来能完成一件真活,且 AI 自己核对过结果。TmAgent 做的是后者——而这个"用通"职责,在 Skill 层由绘图助手承担。
Q:两个 Skill 分别负责什么?
CAD-TmAgent 绘图助手是 TmAgent 的能力总入口:接通(把 CAD 接进 AI)+ 用通(引导 AI 查工具、选工具、按场景编排、用完核对,覆盖完整能力面)。lisp 编程助手是独立的编程支路:只把用户经验落成 LISP 插件,不承担用通,也不使用 TmAgent 的完整能力。
Q:178 个工具为什么要砍到 107?
工具一多,tools/list 的 JSON Schema 就吃掉十几 k 常驻 token,且近义工具互为干扰项,模型反而选不对。经过聚合式压缩、冗余兼并、删减三把刀收敛到 107——每多一个工具,都在拉低整体准确率。
Q:模型输出格式不对会怎样?
不会报错让它重来。后台三层容差——JSON 缺陷修复(注释/尾逗号/单引号/未加引号键名/字符串内换行)、多模型输出格式全兼容(<invoke>/<tool_call>/functionCall/DeepSeek 标记/裸围栏…)、参数值容错("20"/true→1/"3.5"/"是"/点数组四种写法)。修复失败则原样报错,绝不静默丢弃。
Q:AI 具体怎么调用 CAD?
两条同源通道:单条/交互走 MCP 工具 mcp__tm-cad__<命令>(带参数校验);批量/多步走 REST POST /api/execute。命令细节实时查 /api/help?command=<名>,别硬编码。
Q:lisp_eval 和 lisp 有什么区别?lisp_eval同步返回结果,是 AI 调试主力;lisp 异步不返回,用于批量/人工验收。因为 ZWCAD 的 SendStringToExecute 要等命令处理器退出才执行,lisp_eval 走的是「两阶段延迟读取」——结果先入 pending,下一轮注入 [系统回传]。
Q:怎么知道 LISP 错在哪一行?lisp_eval 带 stack=true 时走两条通道:vl-bt 反向跟踪拿函数调用链,旁听中望官方调试器(DAP)拿到出错行号(需按 WRAP_HEAD_LINES=4/FRAME_LINE_OFFSET=3 还原偏移)。这个能力只有驻留在 CAD 进程里的工具才拿得到——外部工具只能猜。
Q:别的工具能"抄"这套错误堆栈吗?
很难。两条通道都要求"人在 CAD 进程里面":改写 *error*、读 CAD 命令行日志、send VLIDE、spawn 并 attach 官方调试器。外部工具看不到命令行日志、attach 不进调试器,只能看代码本身。
Q:AI 写的 LISP 一 load 就乱码?
编码没转。开发期 UTF-8,CAD 按 ANSI(GBK) 读,交付前必须转 ANSI。
Q:为什么强调「感知」而不是「画图」?
因为让 AI 画图的手段早就够多(DXF / COM / LISP / 脚本 / 原生命令),纯生成方案在精确工程里没法自证正确。先把图纸内容、几何/拓扑、执行前后变化、命令行日志做成 AI 可读数据,AI 才能自己核对「画对了没」。感知是地基,绘图/编程是其上应用。
十三、术语速查
- TmAgent
:中望 CAD / AutoCAD 的 .NET 智能体插件,进程内起本地 HTTP + MCP 服务,是 AI 操作与感知 CAD 的执行引擎。目标是让 AI 跑通 + 用通(查、画、改、统计、标注)。 - 跑通 / 用通
:跑通 = 一条命令真的执行成功;用通 = 五类操作连起来完成一件真活,且 AI 自己核对过——用通由绘图助手承担。 - 感知
:把图纸内容、几何/拓扑、执行前后状态、命令行日志开放为 AI 可读数据的能力,是 TmAgent 的核心差异点。 - tmagent-cad / CAD-TmAgent 绘图助手
:TmAgent 的能力总入口 + 操作手册。负责接通(NETLOAD 加载 DLL、创建/启用 tm-cad连接器)也负责用通(引导 AI 查工具、选工具、按场景编排、用完核对),覆盖完整能力面。 - lisp-programming-assistant / lisp 编程助手
:编程支路 Skill。把用户脑中的经验落地为可复用的 LISP 插件,教模型写对、跑通、核对结果;不承担用通,不使用 TmAgent 的完整能力。 - tm-cad
:MCP 连接器名;连上后每个 CAD 命令即一个 mcp__tm-cad__<命令>工具。 - MCP 端口
: POST /api/mcp,单条/交互式调用,JSON-RPC 2.0。 - 批量执行端口
: POST /api/execute,commands数组进、results数组出,1:1 返回。 - 核心通道
: command(107 工具) /lisp_eval(同步有返回值) /lisp(异步) /script(.scr 轮询) /python(复杂计算)。 - 错误堆栈通道
: lisp_eval取 LISP 报错位置的两条通道——vl-bt反向跟踪(拿函数调用链)+旁听官方调试器(拿出错行号)。 - 旁听(DAP)
:spawn 中望官方 zwlisp-debug.exe调试适配器并 attach 当前 CAD 进程,只读不干预地收集"崩在哪一行、什么错"。需遵守"attach 后立刻configurationDone"与"单实例单 attach 租约"两条硬约束。 vl-bt:AutoLISP 反向跟踪函数(未进公开文档)。配合具名 *error*handler +LOGFILEMODE=1,可把调用链落进命令行日志再由插件读出。- 模型输出容差
:工具后台对模型不规范输出的三层兼容(JSON 修复 / 格式兜底 / 参数强转)。 - 容错哲学
:与其用"铁律"写死规则去管模型,不如在常错处把容错做厚——限制只能管住一种模型,容错能接住所有模型。 - 双向一致
:判定「跑通」的标准——LISP 返回值与图纸实际状态互相对得上。 /api/execute//api/health//api/help:REST 批量执行、健康检查、命令文档实时查询端点。
别人卷 AI 能不能画出来,TmAgent 让 AI 自己确认画对了; 别人只让 AI 猜哪里错,TmAgent 让 AI 读到出错的那一行。 先让 AI 看得见 CAD 的现场,它才不用靠猜。
AI+CAD · 中望 CAD AI · AutoCAD AI 自动化 · AI CAD 智能体 · AI 读图 · MCP 连接 CAD · CAD 批量出图 · LISP AI 编程 · CAD 几何感知 · 107 个 CAD 工具
配套 Skill:CAD-TmAgent 绘图助手(`tmagent-cad`)· lisp 编程助手(`lisp-programming-assistant`)延伸阅读:明经论坛 CAD 板块《TmAgent》介绍文章 · 公众号「TM-CAD插件」· 抖音 @TMTools
扫码关注与交流:抖音 @TMTools | 公众号「TM-CAD插件」| QQ 群 413988234