ARTICLE · 1160079
别再刷 AI 教程了,这 6 本书讲透真 AI 工程
别再刷 AI 教程了,这 6 本书讲透真AI 工程
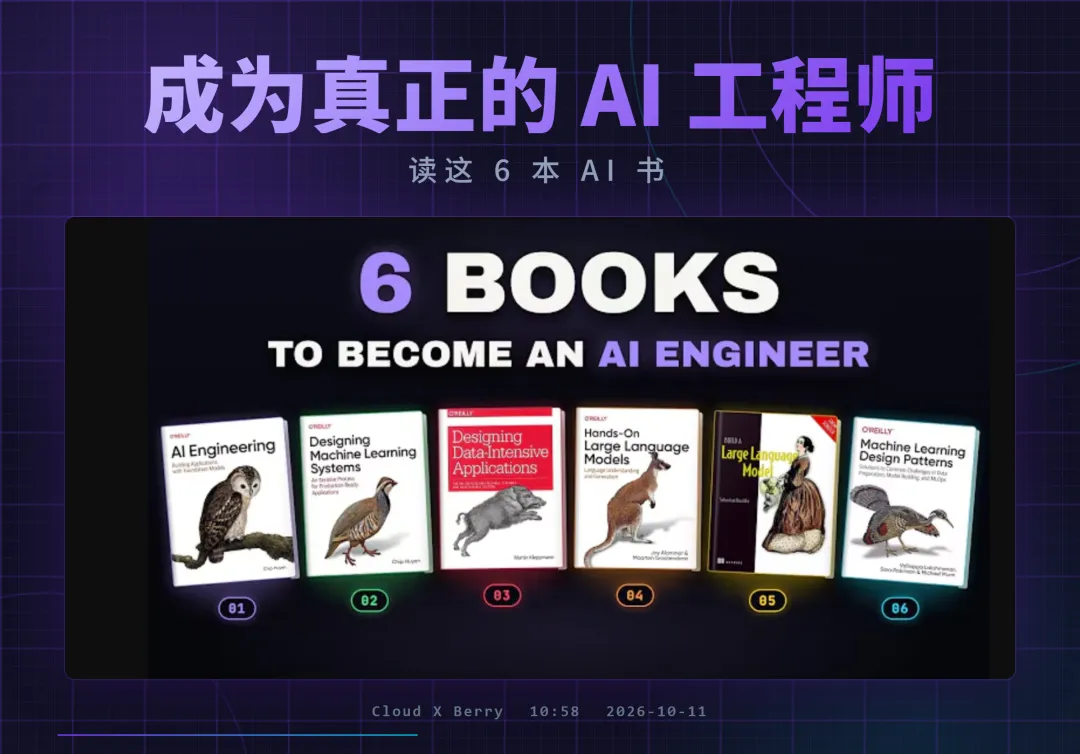
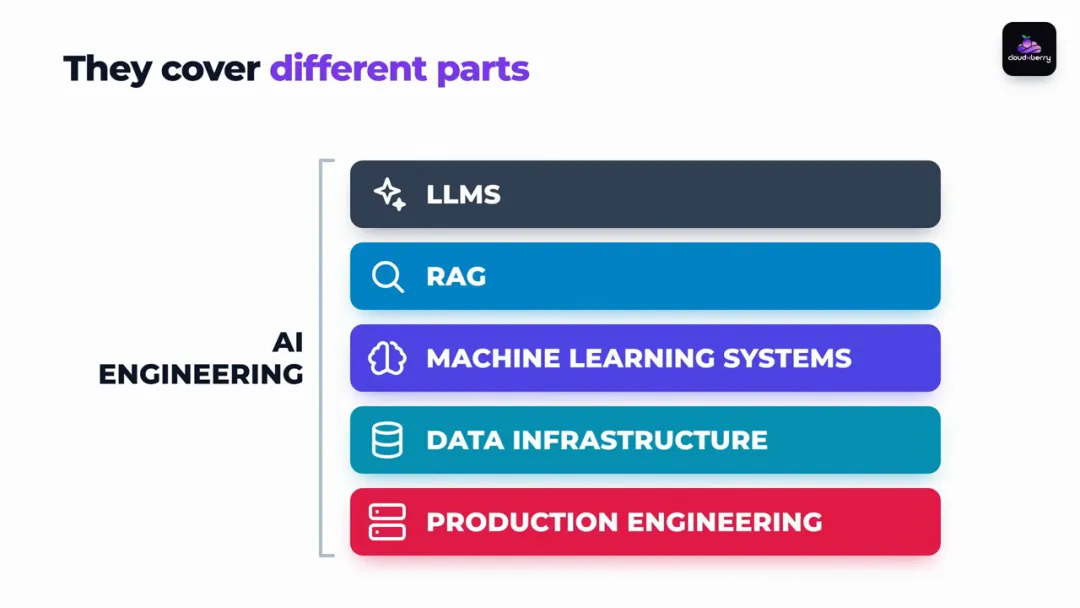
如果读者认真想构建 AI 系统,下面这六本书值得了解。 它们覆盖了 AI 工程的不同部分,从大语言模型和检索增强生成,到机器学习系统、数据基础设施和生产工程。 想先学哪一块,下面会说明该先翻开哪一本。
一、《AI Engineering》:动手之前先定一把尺
第一本,Chip Huyen 的《AI Engineering》,中译本叫《AI 工程:大模型应用开发实战》。
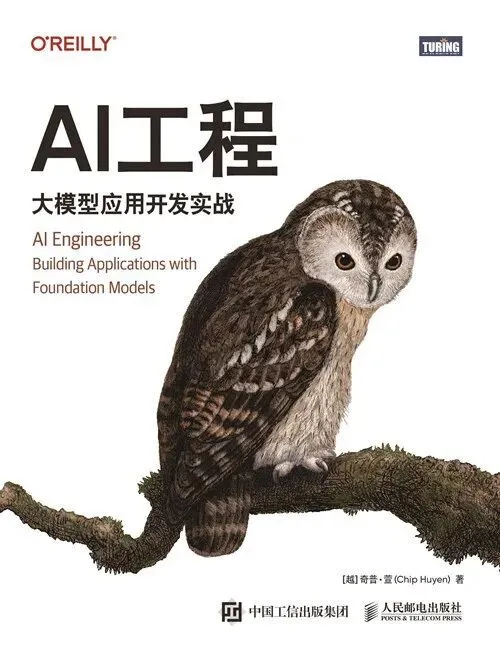
如果读者正在用大语言模型(LLM)或基础模型做应用,这大概是最值得推荐的第一本书。
这本书有价值的地方在于,它不局限于讲模型怎么工作,而是讲真正动手构建 AI 应用时要面对哪些工程决策,包括评估、提示工程、检索增强生成(RAG)、微调、智能体、数据集工程和推理优化。
AI 应用最大的问题之一,是开发者往往太关注让模型给出一个好答案,而不太关注整个系统究竟有没有在工作。
比如做一个客服机器人,拿一百个问题测一遍,一百个里答对了九十个,很容易觉得这个应用可以上线了。可真实用户开始提问之后,才会发现生产环境的数据长得不一样,检索返回的是错的文档,送进模型的上下文也并非原先预期的那一批。
到这一步,问题可能都不在模型身上,而在数据、检索管线、评估流程,或者应用拼接提示词的方式。
所以书中评估那一部分特别有用。在动手改进一个 AI 系统之前,先得知道打算怎么衡量它到底有没有变好。
这本书还讲了检索增强生成、智能体、微调和推理优化,对构建现代 AI 应用的各个组成部分,它能给出一个完整的视角。
谁该读?正在做大模型应用、AI 智能体、检索增强系统或 AI 产品的人,可以把它放在最前面。
要说缺点,是 AI 变化太快,一些具体的工具和例子迟早会过时。不过工程上的原则,能管用的时间要长得多。
二、《Designing Machine Learning Systems》:上线才是起点
第二本还是 Chip Huyen 的《Designing Machine Learning Systems》,中译本叫《机器学习系统设计》。
如果想搞清楚一个机器学习模型从笔记本环境(notebook)搬出来、进入真实生产环境之后会经历什么,推荐这一本。
模型在开发阶段可以表现极好,进了生产环境仍然会表现失常,因为它周围的环境变了。数据可能不一样了,用户行为可能变了,基础设施可能有不一样的限制,模型也可能开始见到一些在原始训练数据里没有出现过的输入。
这本书讲的是更完整的机器学习生命周期,包括数据工程、特征工程、训练、部署、监控和持续学习。
有一个概念特别重要,叫分布漂移。
假设用 2025 年的用户行为训练了一个模型。模型在测试数据上表现很好,于是被部署上去。几个月之后,用户行为变了,产品变了,进入系统的用户类型也变了。模型本身不一定变差了,它在生产里收到的数据,可能只是不再像训练时见过的那些了。
理解这些问题很重要,因为机器学习工程不会在模型部署那一刻结束。还需要监控模型,还要搞清楚它的表现随时间怎么变化。
谁该读?来自数据科学或机器学习背景、想把生产工程的底子打得更扎实的人,这本书很值得一读。
它的面铺得比较宽,而不是在某个领域挖得极深。但这恰恰是它作为基础好用在哪里的原因。
三、《Designing Data-Intensive Applications》:一本不是讲 AI 的书
第三本是 Martin Kleppmann 的《Designing Data-Intensive Applications》,中译本叫《数据密集型应用系统设计》。
这不是一本专门讲 AI 的书,但对任何想成为更强的 AI 工程师的人来说,它是这份书单上最有价值的书之一。
理由很简单,认真的 AI 系统高度依赖数据基础设施。
想想一个典型的检索增强应用。它可能有来自不同来源的文档,有一个摄入管线负责处理,接下来是分块、嵌入管线、向量数据库、检索,最后才是大模型生成回答。在模型拿到请求之前,中间已经牵扯了很多系统。
如果应用突然变慢,问题可能不在大模型,而出在数据库变慢、向量搜索过载、摄入管线延迟,或者网络本身带来了延迟。
这时候,理解数据密集型系统就非常有用。
这本书讲存储、复制、分区、事务、批处理、流处理和分布式系统这些概念,它们都是大规模应用的重要基础。理解了这些概念,就能把系统当成一个整体来推理,而不是一遇到问题就默认是 AI 或模型的问题。
谁该读?来自数据科学或机器学习、想补上后端和分布式系统底子的人,应该把它放进书单。
缺点是它很密,所以不必追求快速读完。慢慢读,把里面的概念和手头真正在做的系统对上。
四、《Hands-On Large Language Models》:把概念接到应用上
第四本,Jay Alammar 和 Maarten Grootendorst 的《Hands-On Large Language Models》,中译本叫《图解大模型:生成式 AI 原理与实战》。
如果读者刚接触大语言模型、想用实操的方式搞懂它们是怎么工作的,这大概是最容易上手的几本之一。
这本书讲分词、嵌入、语义搜索、文本分类、提示工程和检索增强生成这些主题,同时给出能直接运行的代码示例。
这本书值得称道的一点,是它把本来很抽象的概念讲清楚了。
比如,嵌入就是把文本变成向量,这句话大概很多人都听过。可光知道这个定义,并不能说明嵌入有什么用。
假设有一句话是 I want to buy a laptop,另一句是 I'm looking for a new computer。词不一样,意思却相当接近。
嵌入提供了一种把这些文本用数学表示出来的办法,意思相近的文本因此能被放得更近。
一旦理解了这一点,语义搜索和检索增强生成这类概念就好懂得多了。
这本书对初学者的价值就在这里,它把底层概念和实际应用接起来,而不是只给定义。
谁该读?刚接触大语言模型,或者想要一份现代自然语言处理和大模型概念的实操入门,这是个很好的选择。
如果读者已经很懂 Transformer 和现代自然语言处理,会觉得其中一些内容眼熟,但对正在打基础的人来说,这是本非常好的书。
五、《Build a Large Language Model (From Scratch)》:把黑箱拆开一次
第五本,Sebastian Raschka 的《Build a Large Language Model (From Scratch)》,中译本叫《从零构建大模型》。
这本是给想深入大语言模型内部的人看的。
这本书不靠 API 调用现成的模型。它用 PyTorch 从零构建一个 GPT 风格的模型,读者会逐步走过分词、注意力、模型架构、训练和微调这些组件。
知道怎么用大语言模型,和明白它内部发生了什么,差别很大。用 API 的时候,文本发给模型,收到一个回答,但内部的绝大部分过程是看不见的。
当亲手实现模型的一部分之后,注意力、分词、上下文、训练、推理这些概念会开始变得清楚很多,因为这些部件怎么拼到一起,读者能直接看到。
比如,注意力是 Transformer 里重要的一环,这一点本来只是个结论。亲手做过之后,还能看到这套机制是怎么实现的,以及它为什么对模型重要。
这种亲手做过的经验,能带来一个强得多的心智模型,用来理解大语言模型是怎么工作的。
谁该读?想深入理解大语言模型是怎么造出来的,又对 Python 和一些基础机器学习概念不陌生的人,这就是我会选的那本。但它不适合速读。
真的把代码写下来、把例子走一遍,收获会大得多。
六、《Machine Learning Design Patterns》:放在手边当参考
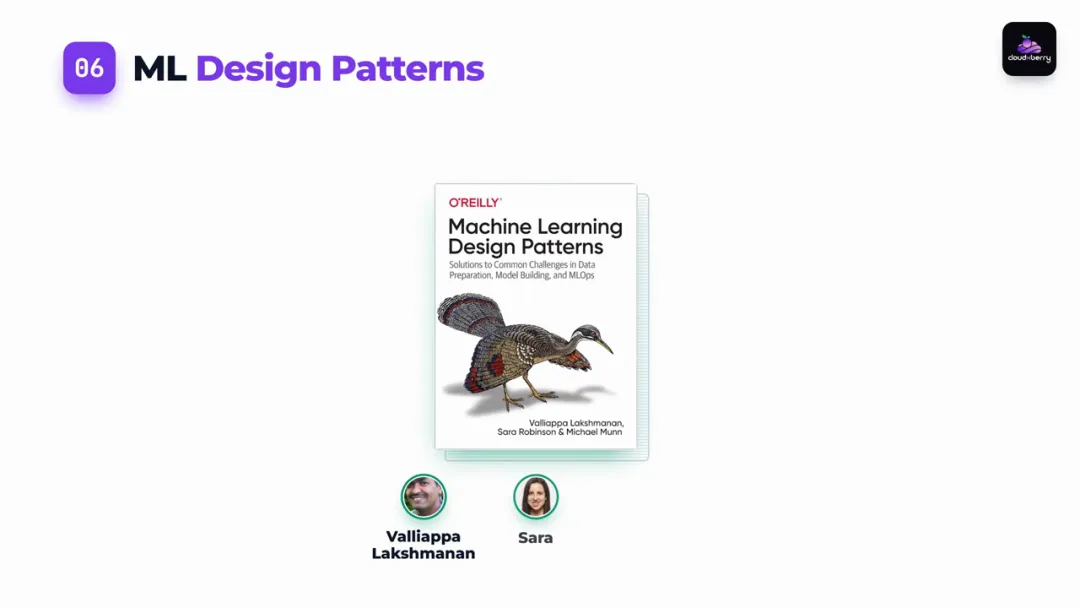
第六本,Valliappa Lakshmanan、Sara Robinson 和 Michael Munn 的《Machine Learning Design Patterns》,中译本叫《机器学习设计模式》。
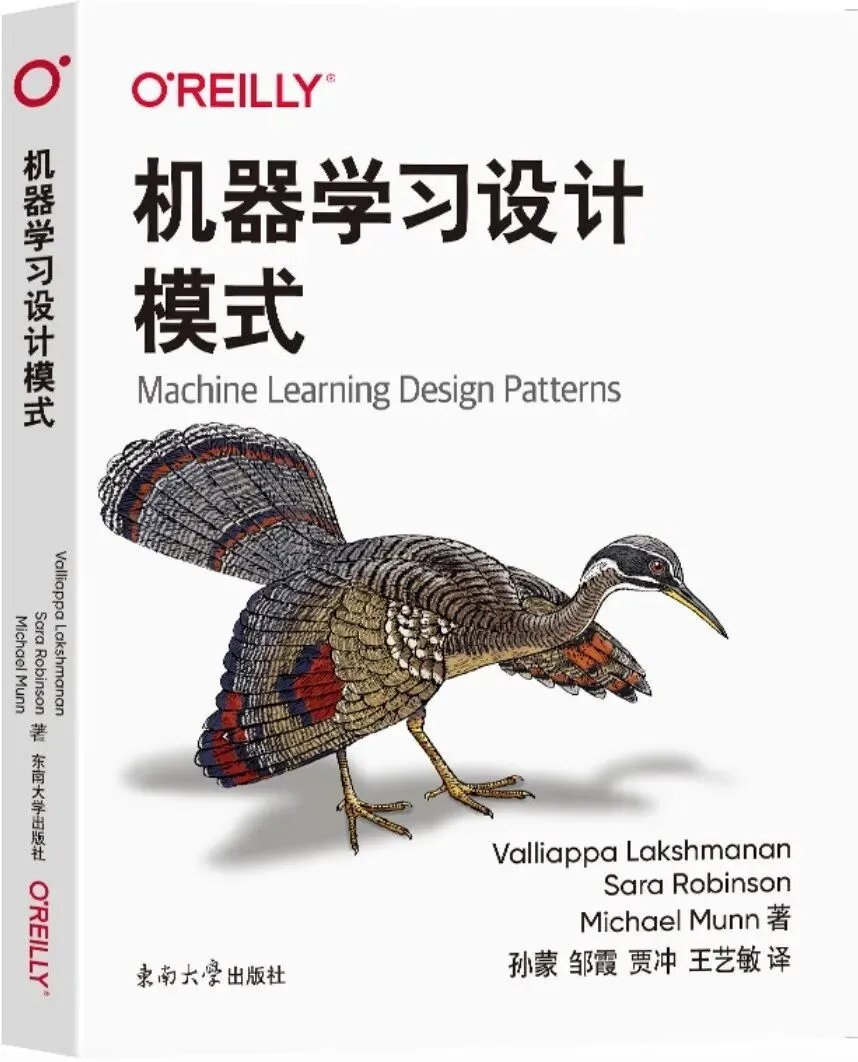
这本书的想法和软件工程里的设计模式类似。
软件工程师会反复遇到某些类型的问题,时间一长,就有了解决它们的常见做法。机器学习系统也有同样反复出现的问题,可能出现在数据表示、可复现性、系统韧性、负责任的 AI,或者机器学习系统各部分之间怎么协作上。
与其把每个问题都当成全新的问题来对待,设计模式提供的是一套办法。它能认出别的工程师早就遇到过的问题,并用已经成熟的做法去解决它们。
比如,如果训练过程不可复现,可以去看那些让机器学习工作流更可靠的做法,而不是自己想一个从零开始的方案。
这本书更适合当成一本参考书,而不是要从头读到尾的书。当撞上某个具体的工程问题时,可以回来翻对应的模式,看看它怎么用。
有一点要留意,这本书早于现在这一波大模型浪潮,所以它替代不了那些更新的、以大模型为主题的书。但工程原则依然有用,尤其是在构建生产级机器学习系统的时候。
谁该读?已经在做机器学习、想要一本常见工程问题的参考的人,这本书值得放在手边。
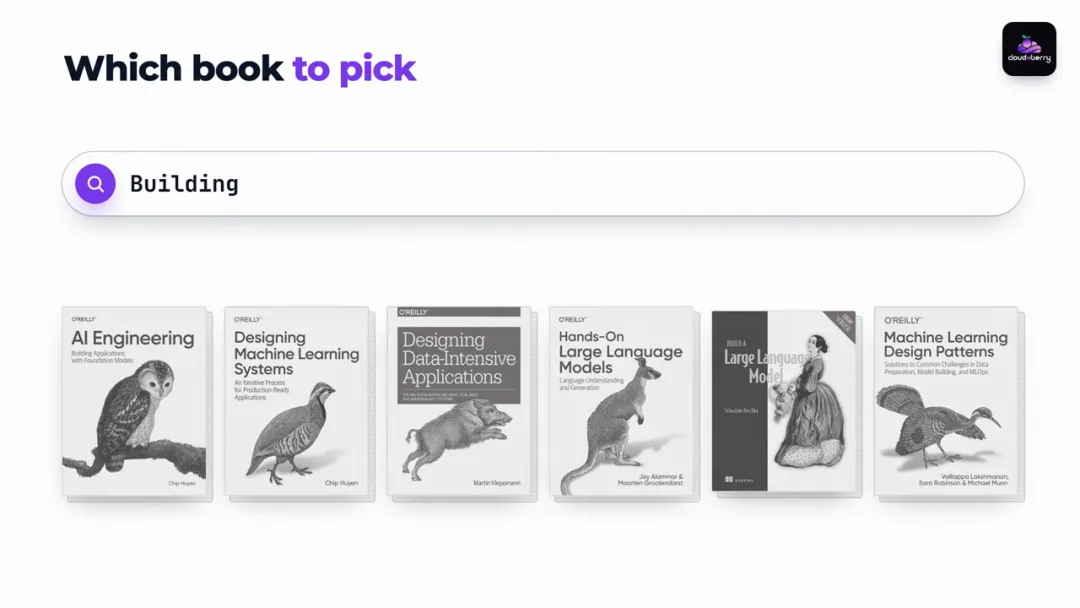
按手上的问题挑
如果拿不准先读哪一本,可以按下面这张表来选:
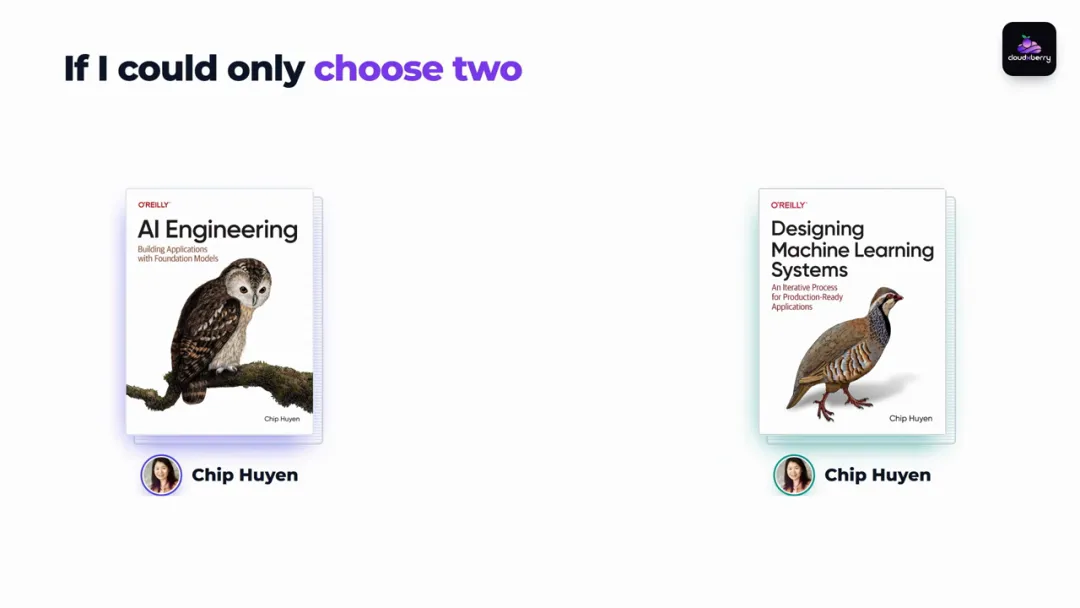
只能留两本
如果只能选两本,我会从《AI Engineering》和《Designing Machine Learning Systems》开始,作者都是 Chip Huyen,因为它们合在一起,对怎么把 AI 当作一个工程系统来思考,能给出扎实的理解,而不只是把它当成一个模型。
书名与作者对照
素材来源:基于 Cloud X Berry 的视频改写,配图为视频关键帧截图。文中书名以英文原名为主,各节首次出现处附中文版书名。
这份书单如果对读者选书有帮助,可以收藏起来,也转给同样在学 AI 工程的朋友。
#AI工程 #技术书单 #大模型入门 #AI工程师 #机器学习 #大模型 #RAG #推荐书单 #程序员书单 #读书笔记