ARTICLE · 1162610
数据篇 -- 【动手】给一份技术文档写出可检索分块
数据篇 -- 【动手】给一份技术文档写出可检索分块
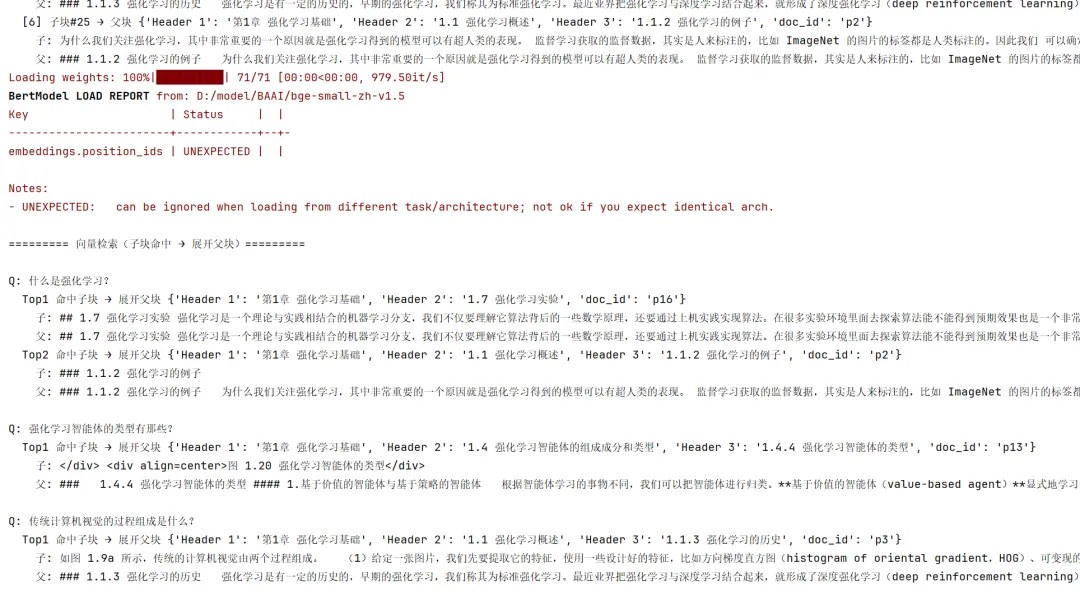
💡 摘要:只切分看不见效果。本文用父子块处理技术 Markdown:标题节当父块、小块入库检索,命中后再取回父块上下文;并用关键词 + 向量 Top-K 验证「问得回」。
目标很具体:拿一份带标题的技术文档,产出可检索的父子结构,并且用代码证明:
子块够尖、父块够全,带标题元数据 人抽查读得懂 给定问题,先命中子块,再展开父块能看到答案原文
不追求一次完美,追求可跑、可验、可迭代。
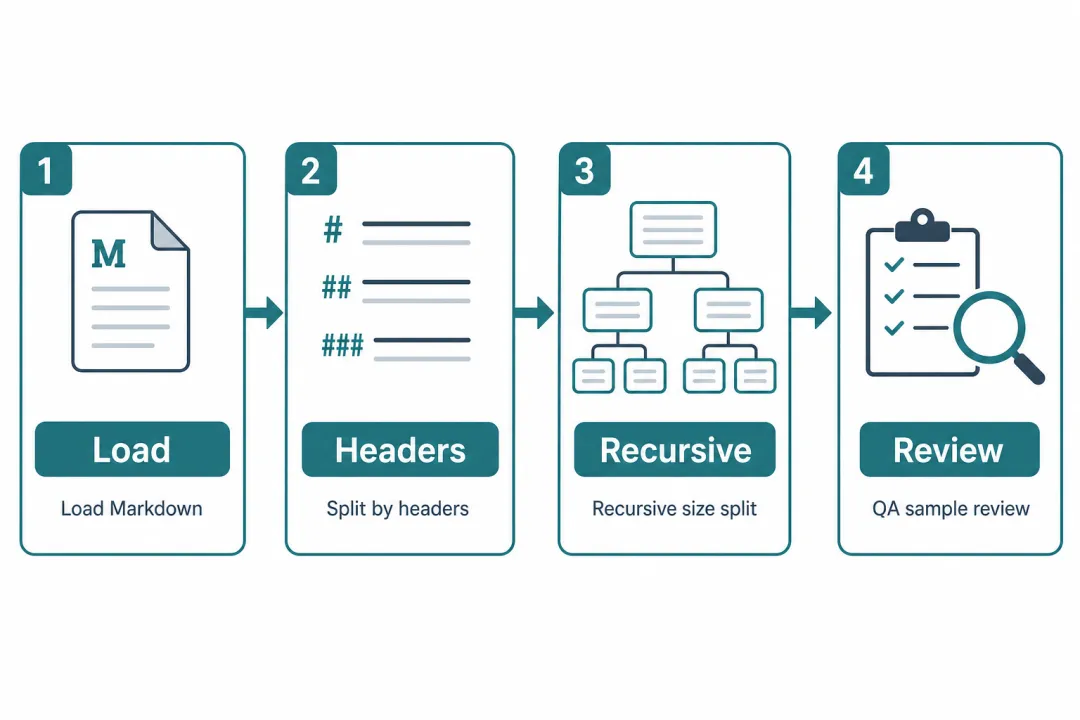 图1|切完不算完:用问题打一遍 Top-K,才知道分块是否合格
准备什么
同目录下的 markdown.md(也可换成你自己的 MD)Python 环境,已装 langchain/langchain-community/langchain-huggingface等嵌入模型 BAAI/bge-small-zh-v1.5(首次会下载;国内慢可设HF_ENDPOINT)
为什么必须有「检索验证」
只打印前几个 chunk,你最多知道「切开了」。真正要回答的是:
用户问 X 时,装答案的那段,会不会被检索打到?打到后上下文够不够生成?
所以验收至少两层:
| 检索验证 |
第二层不过关,调 Prompt、换大模型都是空转。
推荐策略:父子块(Small-to-Big)
父块:MarkdownHeaderTextSplitter(按标题切成完整小节) ↓子块:RecursiveCharacterTextSplitter(小节内再切小,写入 doc_id) ↓检索子块 → 用 doc_id 取回父块(给生成用)子块负责命中,父块负责给足上下文——这就是父子块。下面用 markdown.md 走一遍。
步骤 1–3:加载 → 建父块 → 切子块
from langchain_community.document_loaders import TextLoaderfrom langchain_core.documents import Documentfrom langchain_text_splitters import ( MarkdownHeaderTextSplitter, RecursiveCharacterTextSplitter,)raw = TextLoader("markdown.md", encoding="utf-8").load()[0]# ① 父块:按标题切成逻辑小节(上下文完整)parent_splitter = MarkdownHeaderTextSplitter( headers_to_split_on=[ ("#", "Header 1"), ("##", "Header 2"), ("###", "Header 3"), ], strip_headers=False,)parents = parent_splitter.split_text(raw.page_content)parent_store: dict[str, Document] = {}for i, parent inenumerate(parents): doc_id = f"p{i}" parent.metadata["doc_id"] = doc_id parent_store[doc_id] = parent# ② 子块:在每个父块内再切小(向量检索用)child_splitter = RecursiveCharacterTextSplitter( chunk_size=200, # 子块更小,检索更尖 chunk_overlap=30,)children: list[Document] = []for parent in parents:for child in child_splitter.split_documents([parent]): child.metadata["doc_id"] = parent.metadata["doc_id"] # 指回父块 children.append(child)print(f"父块={len(parents)}, 子块={len(children)}")for i, c inenumerate(children[:3], 1):print(f"\n===== 子块 #{i} | {c.metadata} =====")print(c.page_content) parent = parent_store[c.metadata["doc_id"]]print(f"→ 对应父块长度={len(parent.page_content)}")先确认三件事:doc_id 能从子块指回父块、父块仍是完整小节、子块明显更短。
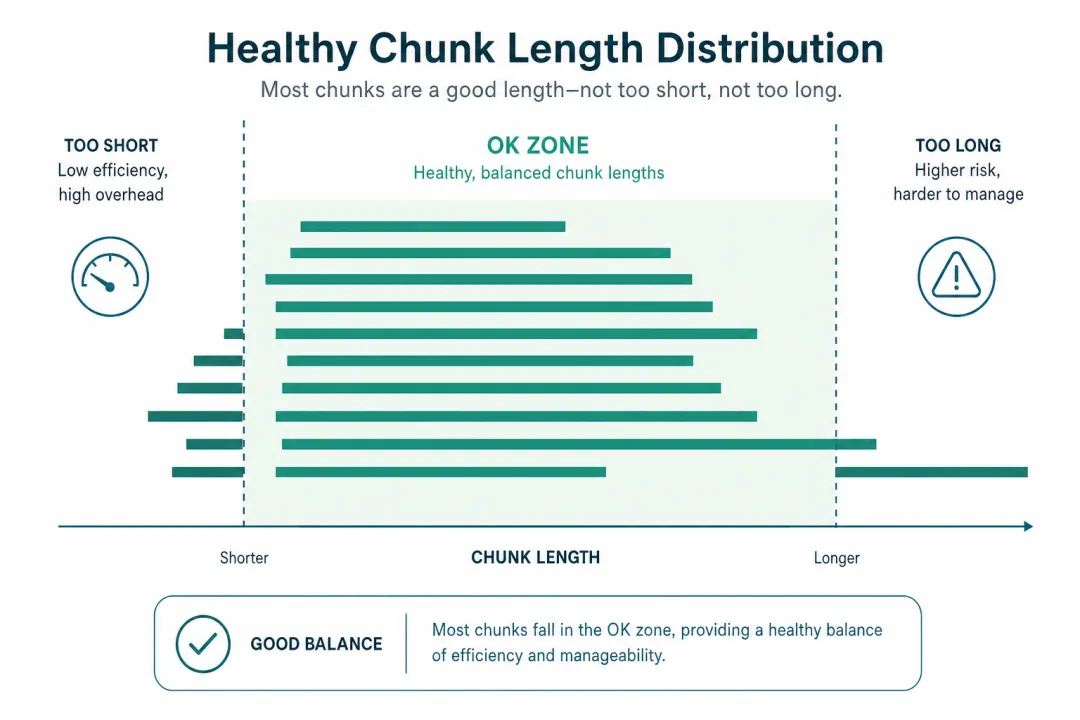 图2|子块宜尖、父块宜全;两者长度分布应明显不同
步骤 4:关键词检索验收(零模型,先过这关)
先在子块上粗排,再展开父块看上下文是否够用:
QUESTIONS = ["什么是强化学习?","强化学习智能体的类型有那些?","传统计算机视觉的过程组成是什么?","2012年,在ImageNet分类比赛中取得冠军的是什么模型?",]defkeyword_search_children(children, query, k=2): hints = ("强化学习", "智能体", "ImageNet", "冠军", "模型", "计算机视觉") scored = []for i, c inenumerate(children): text = c.page_content score = sum(3for h in hints if h in query and h in text) scored.append((score, i, c)) scored.sort(reverse=True)return scored[:k]for q in QUESTIONS:print(f"\nQ: {q}")for score, idx, child in keyword_search_children(children, q): parent = parent_store[child.metadata["doc_id"]]print(f" [{score}] 子块#{idx} → 父块 {parent.metadata}")print(f" 子: {child.page_content.replace(chr(10), ' ')}")print(f" 父: {parent.page_content.replace(chr(10), ' ')}")怎么判:
子块 Top 能点中答案附近 → 边界大体可用 子块命中了,但父块展开后仍缺关键句 → 父块切得过碎(标题层级过细)或 overlap 不够 子块总排不进 Top → 子块太大/太杂,或答案被切散 → 回调子块 chunk_size命中的是目录、页眉噪音 → 加载/清洗问题
步骤 5:向量检索验收(子块入库,返回父块)
# import os# os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"from langchain_huggingface import HuggingFaceEmbeddingsfrom langchain_core.vectorstores import InMemoryVectorStoreembeddings = HuggingFaceEmbeddings( model_name="BAAI/bge-small-zh-v1.5",# 若本地已下载,可改成绝对路径,例如 "E:/model/BAAI/bge-small-zh-v1.5" encode_kwargs={"normalize_embeddings": True},)# 只把子块写入向量库store = InMemoryVectorStore.from_documents(children, embeddings)defretrieve_parents(query, k=2):"""检索子块,按 doc_id 去重后返回父块。""" hits = store.similarity_search(query, k=k) parents_out, seen = [], set()for child in hits: doc_id = child.metadata["doc_id"]if doc_id in seen:continue seen.add(doc_id) parents_out.append((child, parent_store[doc_id]))return parents_outfor q in QUESTIONS:print(f"\nQ: {q}")for rank, (child, parent) inenumerate(retrieve_parents(q, k=2), 1):print(f" Top{rank} 命中子块 → 展开父块 {parent.metadata}")print(f" 子: {child.page_content.replace(chr(10), ' ')}")print(f" 父: {parent.page_content.replace(chr(10), ' ')}")验收口诀:
Top 子块是否点在答案附近? 展开父块后,答案原文是否完整可读? 只改子块或只改父块(标题层级)其中一个变量,再复测同一批问题
这里先不要接 LLM 生成。生成漂亮但父块里没有答案,只是在优雅地胡说;生成差但父块对了,问题在 Prompt/模型,不在分块。
坏 case 怎么回调参
chunk_size / overlap | |
###,或合并父块 | |
doc_id 对不上 | metadata["doc_id"] |
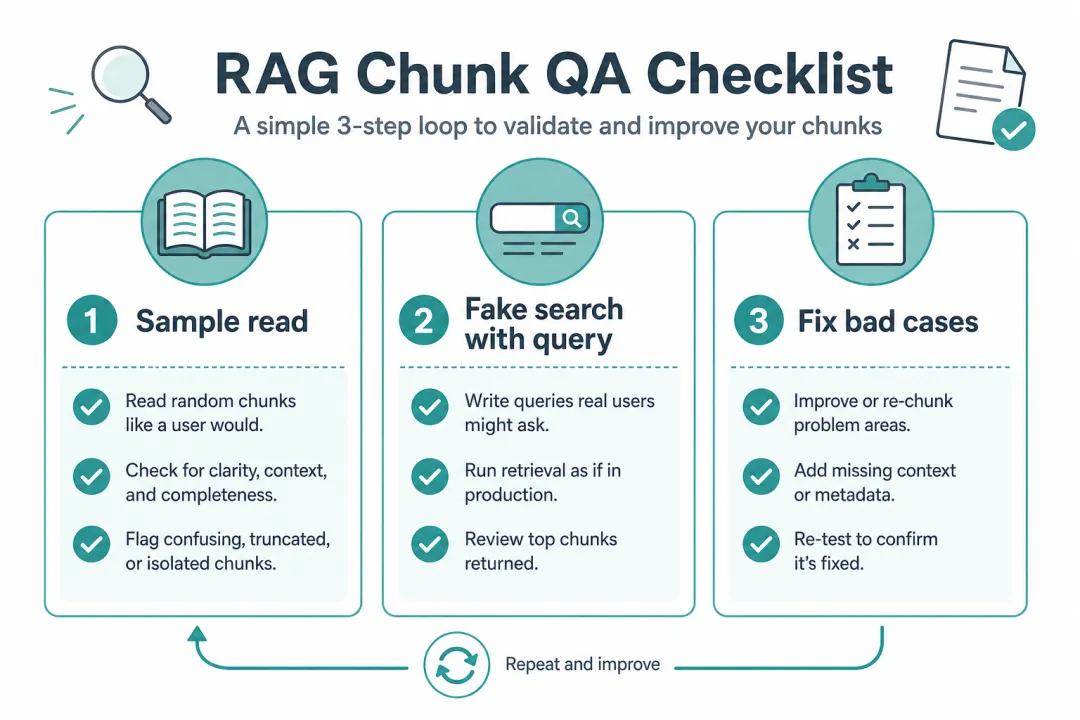 图3|完成标准:子块打得中 + 父块展得开 + 改完能复测
这篇你带走什么
动手默认用父子块:标题节当父、小块检索、命中后取回父块。 切分必须配检索验证:关键词粗检 + 向量 Top-K(看子块,验父块)。 先看召回再谈生成:父块里没有答案,就先改分块,别急着怪大模型。