ARTICLE · 1162615
XRepoSkill: 为软件工程Agent学习可迁移的skill
XRepoSkill: 为软件工程Agent学习可迁移的skill论文题目:XRepoSkill: Learning Transferable Skills for Software Engineering Agents 论文链接:https://arxiv.org/pdf/2609.36807 作者单位:南洋理工大学、清华大学、腾讯、伦敦国王学院 
在软件工程自动化领域,为了赋予 Agent 专家级经验,学术界与工业界日益倾向于使用技能(Skills)——即在推理阶段动态加载的特定领域知识、规则与工作流指南。然而,现有方法面临的核心挑战是:从历史经验中习得的技能极难跨仓库有效迁移。实证研究表明,公开流通的大量软件工程技能在面对真实全新仓库时往往毫无增益,甚至因与目标项目规范冲突而导致严重的性能退步。 导致这一困境的深层原因在于:在成功agent轨迹中观察到的某种行为,并不等价于该行为促成了最终的成功。它可能只是大模型固有的输出习惯,也可能是恰好伴随成功发生、但无因果作用的偶然附带行为(incidental behavior),甚至严重依赖特定仓库的工作流惯例。现有的轨迹学习方法(如 Trace2Skill、STAIR)往往不加区分地全盘总结成功轨迹,无法在统计层面检验行为与成功之间的真实因果关联。 为了解决这一难题,本文提出了XRepoSkill。其核心哲学是:将潜在有效行为的“假设提出(Discovery)”与跨仓库的“实证验证(Verification)”彻底解耦。XRepoSkill 不仅关注单次运行的成功,更通过对比同一任务中执行路径的分歧、引入确定性可执行谓词、并施加严谨的跨仓库统计学因果检验,筛选出真正具备普适性的软件工程通用技能。 设定目标软件工程智能体为A,历史轨迹池为T。T记录了A在使用不同底座模型解决历史软件缺陷时的动作序列与环境观察反馈,同时包含“成功”与“失败”两类标签。 学习目标是构建一个可迁移的技能集合 S。S 由若干结构化规则构成,每条规则严格规范了在何种情境下应采取何种动作。对于任意未见过的全新仓库中的新缺陷 i*,A 能够在 S 的自适应指导下,实现相比无技能基线显著更高的修复成功率。 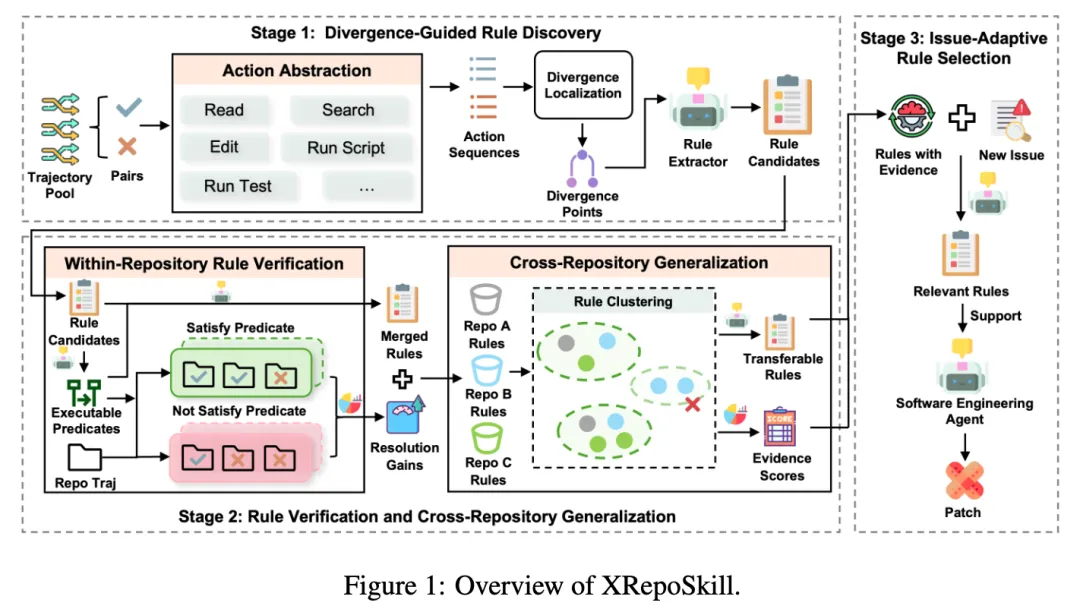
图1展示了XRepoSkill 的端到端流程,由以下三个连续且闭环的阶段构成: 直接汇总成功轨迹不仅计算代价高昂,而且会引入海量噪声。XRepoSkill 从成功/失败轨迹的对比进行切入: 在阶段一生成的候选规则仅仅是“待验证的假设”。阶段二构建了严谨验证机制: 在面对全新缺陷 i* 时,将全部技能一次性塞入上下文窗口会造成严重的注意力稀释与性能退化。XRepoSkill 采用自适应选择机制:由底座 LLM 审视当前任务描述,并结合每条规则在离线验证中沉淀的统计证据(Resolution Gain 和 Z-score),精准挑选与当前缺陷最相关的少量高价值规则,以系统提示的形式指导 Agent 展开排查与修复。 本文设置了4个研究问题: 实验中,离线技能学习轨迹池来自SWE-Bench-Verified公布的高质量轨迹,评估数据集使用SWE-Bench-Pro和DeepSWE。底座agent使用mini-SWE-Agent。 在涵盖两个前沿基准与三个不同厂商底座 LLM 的全部 6 组实验中,XRepoSkill 均取得了最高的缺陷解决率(Resolution Rate)。 在极具挑战的长程交互评测DeepSWE上,XRepoSkill 相比无技能的原生 mini-SWE-agent 实现了高达10.3 个百分点的绝对解决率跃升;相比现有最强技能学习基线(Trace2Skill)亦领先了5.0 个百分点。 在多语言基准SWE-bench Pro上,XRepoSkill 达到了53.8%的平均解决率,相比原生 Agent 提升了 6.0 个百分点,全面超越了表现最好的对比方法 STAIR。 值得注意的是,虽然 XRepoSkill 的规则池完全从 Python 仓库的历史轨迹中挖掘并提炼,但在迁移至 Go、JavaScript、TypeScript 等完全异构的编程语言任务时,依然保持着极其显著的性能正增益。这一现象有力证实了:经过分歧对比与跨仓库统计整合后,模型留存的是通用的高层软件工程方法学(例如“修改代码前必须先复现异常测试”、“单步修改后需立即局部回归”),而非特定语法结构的模式匹配。 在连续 4 次独立重复运行评估(DeepSWE + DeepSeek)中: XRepoSkill 的平均解决率高达58.6%,其 95% 置信区间完全不与 mini-SWE-agent(45.6%)及 Trace2Skill(49.3%)发生重叠; 其 Pass@4 达到89.4%,All@4(四次全部通过)达到32.7%,分别超越最强基准 8.0 和 11.5 个百分点,彻底排除了“偶然单次幸运跑分”的可能性。 消融研究:若移除“分歧引导发现”改用传统轨迹提取,解决率显著下滑至 54.9%;若剔除“统计证据支撑的自适应选择”,性能亦回落至 55.8%。这证明了“因果对比发现”与“实证严谨过滤”缺一不可。 推理成本分析:在 DeepSWE 测试中,XRepoSkill 的平均单任务调用花费仅为$0.25,相较于基线系统的 $0.22 增幅极微,却换取了两位数的解决率提升,具备极佳的工业落地性价比。 随着大模型智能体从单轮问答走向深度交互的复杂系统工程,如何赋予其可累积、可复用、且具备高度泛化性的通用技能库,是下一代自主可进化 Agent 的核心瓶颈。XRepoSkill 打破了传统“全盘总结成功经验”的经验主义框架,以严密的因果分歧分析与跨仓库实证统计检验,提供了一套高度鲁棒、跨语言通用的自动化技能学习范式。
1. 研究背景
2. 研究方法
2.1 问题形式化
2.2 XRepoSkill方法架构
分歧引导的规则发现(Divergence-Guided Rule Discovery):对比同一问题下成败轨迹的行为差异,锁定分歧点并提炼候选规则假设。 规则实证验证与跨仓库泛化(Rule Verification and Cross-Repository Generalization):利用可执行谓词(predicate)在轨迹池上计算统计效益增益,并通过聚类合并多仓库同构行为,沉淀为通用规则。 问题自适应规则选择(Issue-Adaptive Rule Selection):面对全新任务时,基于历史增益与统计证据,动态检索最具价值的规则辅助推理。
2.1 分歧引导的规则发现
动作抽象(Action Abstraction):将具体的底层命令行或 API 调用映射至抽象动作元组(操作类型、操作目标),如将执行相同文件查看的不同命令统一归一化为 read_file(target),消除表层语法噪音。 分歧定位(Divergence Localization):将同一任务下成败序列从头对齐。在此过程中,允许检索、文件查看等探索性动作的顺序微调;而一旦出现修改代码或执行测试等对环境产生实质性影响的操作不一致时,立即判定为分歧点(Divergence Point)。分歧点之前的公共前缀被视作共有背景,分歧点之后的行为差异才是决定成败的真正搜索空间。 候选规则生成(Candidate Rule Generation):为了避免分歧点后单调的逐步对齐受挫,系统从三个互补锚点提取规则假设:
对照成功补丁反思失败轨迹:挖掘失败尝试中由于缺少何种信息探索而走入死胡同; 审查成功轨迹的前置验证:识别成功路径在进行代码修改前所执行的高效信息收集与环境校验; 聚焦分歧点核心动作:直接提取成功轨迹在关键岔路口所采纳的差异化动作。
2.2 规则实证验证与跨仓库泛化
确定性可执行谓词(Executable Predicates):为每条自然语言规则编写一个不依赖 LLM 判读的 Python 可执行谓词程序(如 before(run_test, first_edit))。该谓词能够毫秒级遍历评估海量轨迹,确定该轨迹是否真正遵循了该规则。 仓库内因果关联验证(Within-Repository Verification):为了规避“简单题目容易被修好,且偶然包含了某动作”所带来的伪相关性偏差,XRepoSkill 引入了分层统计学中的 Mantel–Haenszel 估计器,按问题难度进行分层对齐,计算遵守规则所带来的实际解析增益(Resolution Gain)与 Z-score,剔除无法带来统计显著收益的伪规则。 跨仓库聚类与参数汇总(Cross-Repository Generalization):为了消除仓库特异性,一条规则必须在多个不同仓库中独立出现并被验证。系统使用phi相关系数衡量不同仓库中规则谓词的行为重合度,通过层次凝聚聚类将语义或逻辑等价的特异性规则融合成通用抽象规则,并利用逆方差加权合并统计显著性指标,最终沉淀为稳定的可迁移技能库。
2.3 问题自适应的规则选择
3. 实验分析
RQ1(有效性):XRepoSkill 在未见过的全新仓库缺陷修复中表现如何? RQ2(跨语言迁移):仅从 Python 轨迹学到的规则,能否跨越到多语言环境? RQ3(稳定性):在多次重复实验中,方法带来的性能收益是否具有鲁棒性? RQ4(消融分析):分歧发现、统计验证、跨仓库整合等模块的各自贡献几何?