ARTICLE · 1165204
别再读AI吐的文字墙了:这个开源技能把答案画成一页图,9天拿下2800 Star
一句话介绍
Answer me with HTML 是一个装在 AI Agent 上的开源技能:你照常提问,AI 不再回你一大段难以消化的文字,而是交出一页排版好的 HTML——时序图、流程图、对比表、时间线,一眼全在眼前。更妙的是,它让模型只写内容,排版画图的活儿全交给一个本地 CLI,模型输出量只有手写 HTML 的 1/8,出页速度快 2.6 倍。MIT 协议,支持 Claude Code、Codex、Cursor 等 70 多个 Agent。
开篇:让 AI 讲个原理,你却要在一堆文字里自己拼图
你肯定经历过这个场景:
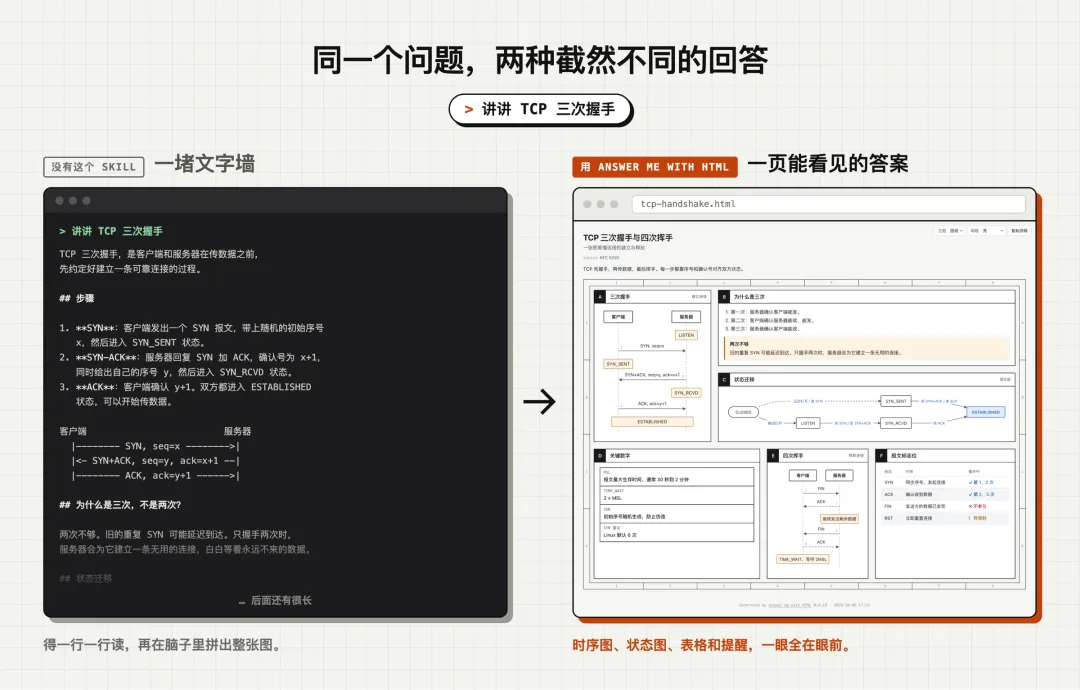
问 AI:"讲讲 TCP 三次握手。"
它哗哗给你吐了一屏字:客户端发送 SYN,序号为 x;服务端回复 SYN+ACK,序号 y、确认号 x+1;客户端再回 ACK……你一行一行读,在脑子里努力把这几段文字拼成一张图——客户端在这边、服务端在那边、箭头飞来飞去。读完第一遍,不确定懂了没,再读第二遍。
Andrej Karpathy 之前提过一个观点:随着 LLM 干的活越来越多,怎么跟得上它们的输出,反而成了新的瓶颈。一张图、一页排版好的东西,远比一大段文字好消化。
有人就较真了:那我直接让 AI "用 HTML 回答" 不就行了?
确实行。模型现在写的 HTML 都挺像样。但问题是:一个像样的页面大概要模型手写 4000 多个 token,其中将近一半是 SVG 图的坐标和路径——模型算箭头坐标全靠"脑补",经常箭头指到空气上;那几十行每次都长得差不多的 CSS,你要干等它一个字一个字敲完,一两分钟就过去了。
一个叫 QingYunA(Cyan)的开发者被这事烦够了,干脆做了这个项目:10 月 2 日挂上 GitHub,9 天拿了 2800 多 Star,最近在多个 AI 社区刷屏。
它是什么:把"画图排版"从模型手里拿走的 Agent 技能
Answer me with HTML(下称 AmH)是一个 Agent Skill(智能体技能)——不是独立 App,也不是浏览器插件,而是装进 Claude Code、Codex、Cursor、OpenCode 这些编程 Agent 里的一个能力包。
装好之后,你的使用方式完全不变,还是照常提问:
> 讲讲 TCP 三次握手> 这个仓库的模块是怎么组织的?> 缓存选 Redis 还是 Memcached?区别在于背后的分工。AI 收到问题后,只写一份简短的 Markdown 草稿(描述"这里放一张时序图、那里放一个结论框"),然后把它自带的一个 CLI 工具在本地跑一下,大约 50 毫秒后,一页排版完成的 HTML 就生成了。
项目自己的统计很能说明问题。他们数了模型手写 9 个页面的 token 构成:
同样的题目,模型手写 HTML 平均 4893 token,写 Markdown 草稿只要 612 token——约 1/8。反映到时间上,中位数从 31 秒降到 12 秒,快 2.6 倍。
仓库数据:2875 Star / 196 fork / MIT 协议 / JavaScript 编写,10 月 2 日创建,到现在 9 天,还在高频更新中(最新版本 v0.5.0)。
同样的题目"TCP 三次握手",它交出来的答卷长这样
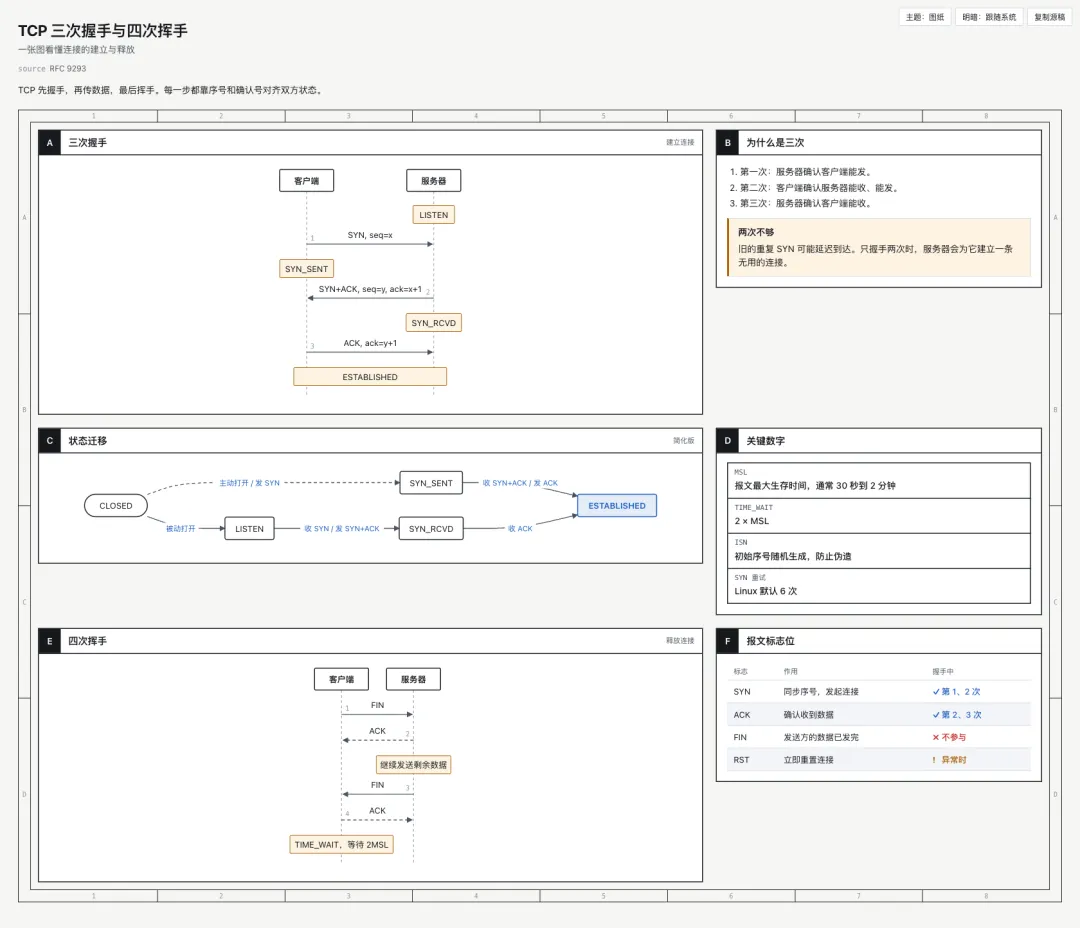
4 个设计,个个都在点上
1. 模型只管内容,代码管排版。 这是整个项目的灵魂。面板怎么摆、流程图怎么布线、配色主题怎么套,全部由本地 CLI 用确定性的代码计算(流程图用 dagre 自动布局),而不是让模型"猜坐标"。所以标签不会被截断,箭头不会指到空处,网格不会留大洞。你只需要用十来种"积木"描述内容的形状:flow(架构/调用链)、sequence(时序图)、er(实体关系)、tree(目录树)、timeline(时间线)、annot(逐词批注)、table(对比表,单元格里写 ok/no 自动变 ✓/✗)……
2. 写错了,自己改。 草稿语法有错时,CLI 会返回行号、出错的组件和一个正确示例,Agent 拿到这些信息一次就能改对。整个反馈闭环不需要人插手。
3. 一页就是全部,离线可分享。 每个答案是一个单独的 .html 文件,没有 CDN 链接、没有网络字体,断网也能打开,直接发给同事就是一个完整的"讲解页"。页面右上角能切主题(蓝图工程图风 / shadcn 卡片风 / 纸质阅读风)、切明暗模式,还能一键复制生成这页的 Markdown 原稿。
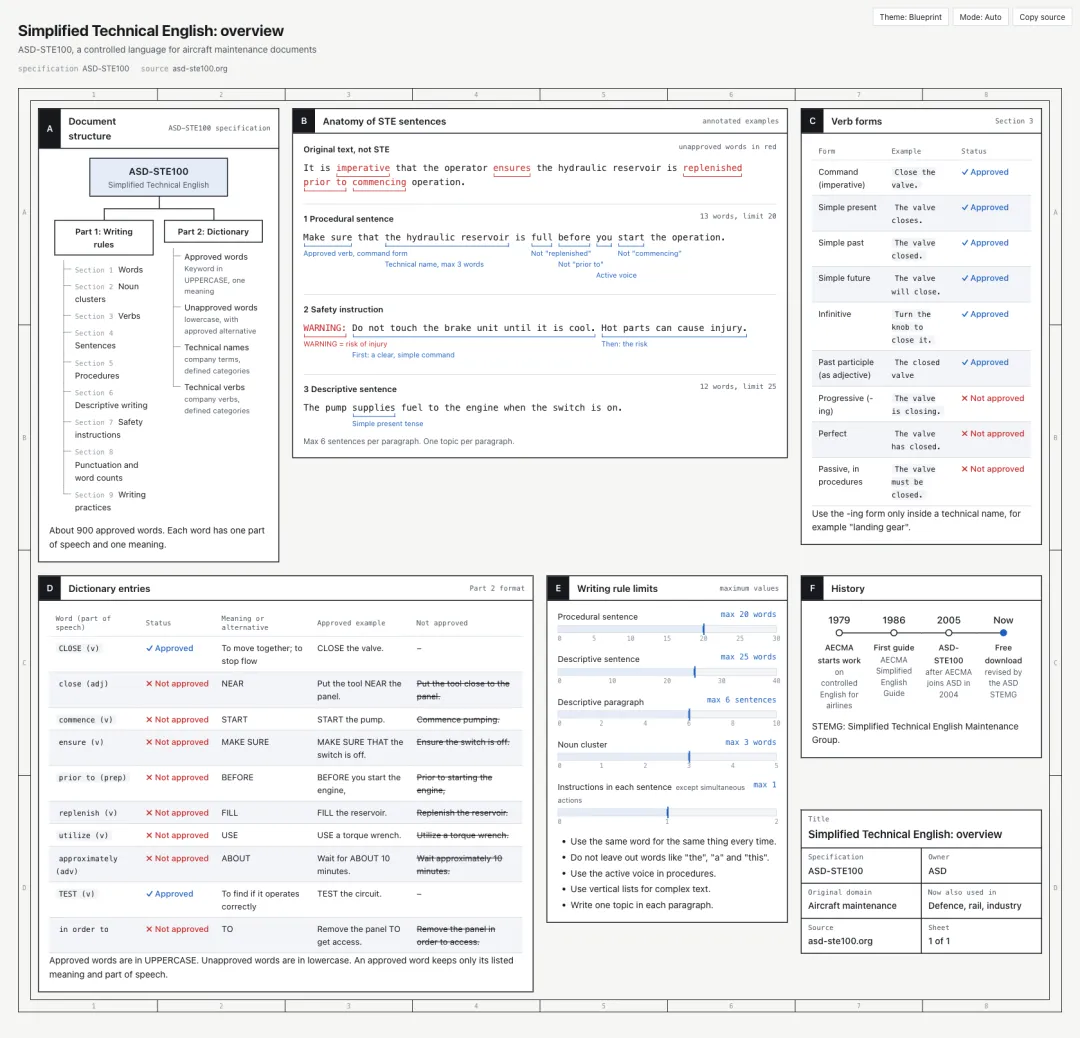
4. 连"写作质量"都管。 每次渲染都会按 ASD-STE100(一种最初用于飞机维修手册的受控英语规范)做写作检查:句子太长、用词啰嗦、被动语态,都会被标出来警告。这个规范 Karpathy 也专门点赞过——让 LLM 按这种规则写东西,可读性大幅提升。
最不一样的一点:它不要求模型更聪明,而是把活儿从模型手里拿走
市面上让 AI 回答"更可视化"的方案,思路基本都是训练模型或堆提示词,求着模型把 HTML 写好。
AmH 反着来:模型不擅长、也不该干的活(算坐标、写 CSS),直接拿走,交给代码。模型只干它擅长的事——组织内容。
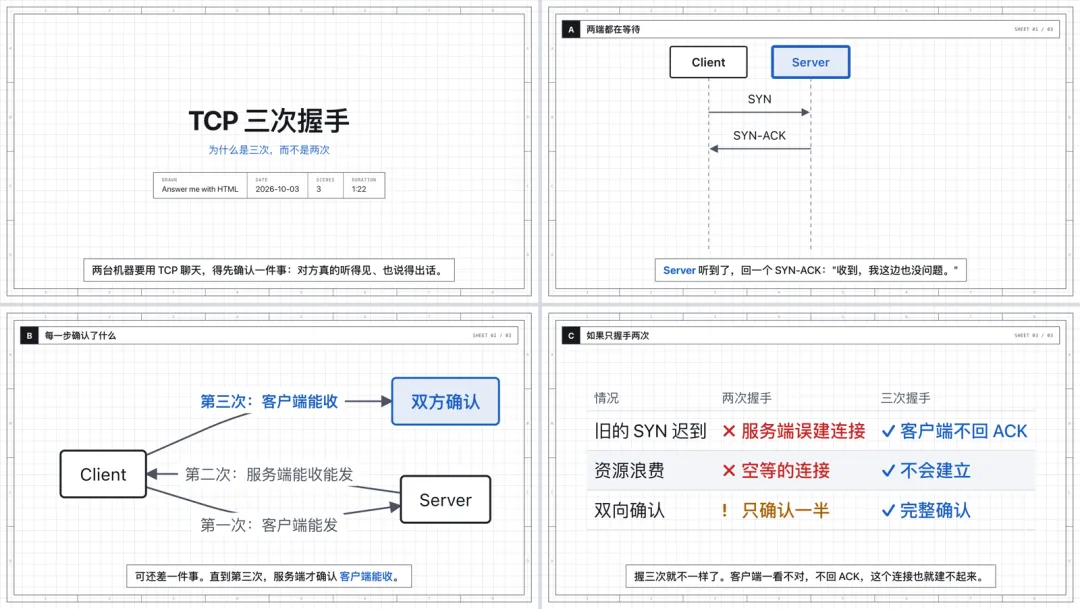
这个思路还延伸出了一个更惊艳的功能:讲解视频。一句 "make a 3b1b-style video on the TCP handshake"(做个 3Blue1Brown 风格的 TCP 握手讲解视频),它就能用同一份草稿格式生成一个带旁白、逐步绘制图表的播放器页面——图表跟着旁白一步步画出来,镜头会自动平移到旁白里提到的节点上,语音直接内嵌在页面里,离线就能播。据项目测试,视频模式下 token 节省约 18 倍、速度快 12 倍。
还有一个隐藏玩法:always-on 模式。打开之后,Agent 的每一个结论、每一份方案、每一次对比,都会自动附送一页 2-4 格的小卡片(不弹窗、不打断你),路径附在回复末尾。日子久了,~/.answer-me-with-html/ 文件夹就成了你的个人知识库——每个 AI 给你讲过的东西,都变成了一页可以翻出来重看的图。生成的讲解视频是这个样子的,图表跟着旁白逐步绘制。
上手试试:两条命令的事
前提只有一个:Node.js 20 以上。不需要 npm install,CLI 已经打包在技能里。
最省事的方式是直接把这句话扔给你的 Agent(Claude Code、Codex、Cursor 都行):
安装 Answer me with HTML:读取https://raw.githubusercontent.com/QingYunA/answer-me-with-html/main/INSTALL.md并按它执行。或者手动来:
# Claude Code 插件方式/plugin marketplace add QingYunA/answer-me-with-html/plugin install answer-me-with-html@answer-me-with-html# 其他 Agent 一条命令(安装器会问你要装进哪个 Agent,支持 70 多种)npx skills add QingYunA/answer-me-with-html装完不需要任何配置,照常提问就行。问"ls 怎么显示隐藏文件"这种一句话问题,它会老实回一行字,不会小题大做给你整个页面;复杂问题它自己判断要不要出页。也可以直接说一句"用 HTML 解释"强制出页。
进阶用户可以直接驱动 CLI:
am render draft.md # 渲染成页am lint draft.md # 只做写作检查am video draft.md --mp4 # 出讲解视频(MP4 需要 ffmpeg)am config set open off # 别自动弹浏览器推荐装完就开 always-on 模式——把 README 里那段规则话术扔给 Agent,它会自己写进规则文件,从此每个结论都自带一页图。
和其他方案比
| 约 610 token/页 | |||
| 约 12 秒 | |||
| 代码布局,不会截断错位 | |||
| 整题一页:文字+图+表+代码 | |||
| 任何能跑命令的 Agent 都行 | |||
| 可以(单文件、无依赖) |
翻译成人话:你要的不是一个更全的答案,是一个读完不用再读第二遍的答案——而且不用为此多等半分钟。
泼盆冷水:4 个坑先知道
1. 那些倍数是官方自测,规模不大。 8 倍 token、2.6 倍速度来自项目自带的基准测试,样本是 3 个主题 × 3 次运行取中位数,且都是官方自己的页面语料。方向可信(少写 3/4 的东西当然快),但具体倍数当参考就好,别当承诺。
2. 省的是时间,不完全是钱。 README 坦白说了:账单只降 15% 左右——因为每一轮对话不管用不用技能,都要读系统提示、你的问题和上下文。另外 always-on 模式每轮会多约 90 token 的规则提醒,是个持续的(但很小的)上下文税。别指望它帮你省 API 费,它省的是你的等待和阅读成本。
3. 它需要你的 Agent 能跑命令。 本质是"技能 + 本地 CLI",所以在 Claude Code、Codex、Cursor 这类编程 Agent 里如鱼得水,但在纯网页聊天(没有执行环境)里用不上。视频导出 MP4 还额外要求本机有 Chrome 和 ffmpeg。
4. 页面是"讲清楚",不是"做出来"。 产出的是阅读用的静态讲解页,图表种类限于内置的十来种组件,不能交互、不能缩放拖拽。它解决的是"理解成本",不是搭一个 dashboard——期望别放错位置。
常见问题
它会把所有回答都变成页面吗?不会。Agent 自己判断:一句话能答的回一句话,只有相关概念多、步骤多、对比维度多的问题才出页。嫌不够激进可以开 always-on 模式,每个结论都配一页小卡片。
我不想装 Node.js,能用吗?不能,Node 20+ 是硬前提。不过装完之后没有任何后续依赖,全程本地运行。
支持中文吗?支持得相当好:简体、繁体中文有专属按钮和字体优化(日文、英文也是),官方 README 本身就有中文版,README 里的示例图也做了中文版。写作检查还会抓常见中文错别字和模糊用词。
代码安全吗?会不会把我的密钥读进页面?它支持在页面里引用你文件里的真实代码(而不是模型重新打一遍——重新打往往会改错),但明确拒绝读取文件夹之外的文件和存密钥的文件。
生成的页面归谁、能改吗?都是你本地磁盘上的普通 HTML 文件,MIT 协议,随便改随便传。每页还内嵌了生成它的 Markdown 原稿,"Copy source"一键找回。
总结
这个项目最动人的地方,不是那 8 倍的 token 数字,而是它想问题的方式:当模型做不好一件事时,第一反应不该是"求模型做得更好",而是把这件事从模型手里拿走。
排版、画图、配色,这些模型干了又慢又容易错的活,本来就轮不到模型干——50 毫秒的确定性代码就能做到完美。模型省下的每一分注意力,都花在了真正需要智能的地方:把内容讲对、讲透。
Karpathy 说跟上 AI 的输出是新的瓶颈。这个项目给出的答案是:瓶颈不在生成端,在阅读端——而阅读端的问题,可以靠工程解决。
AI 负责想明白,代码负责画清楚——你只负责看懂。
项目地址:https://github.com/QingYunA/answer-me-with-html官网:https://answer-me-with-html.com/仓库数据:2875 star · 196 fork · MIT 协议 · v0.5.0 · JavaScript · 创建于 2026-10-02