ARTICLE · 1165668
PDF 喂给 AI 前,先选对解析器:Docling、MinerU、MarkItDown 横评
把费用制度交给 AI,问一句“这笔酒店费能报多少”,看起来很简单。真正容易出错的地方,往往在回答之前:表格的金额与条件有没有对应上?扫描页有没有漏字?“事前审批”是不是被挤到了另一个段落?
今天用同一份中文费用政策,比较三个高关注度 GitHub 项目:Docling、MinerU、MarkItDown。目标是把 PDF 整理成可检查、可引用、能接入 AI 问答的资料。
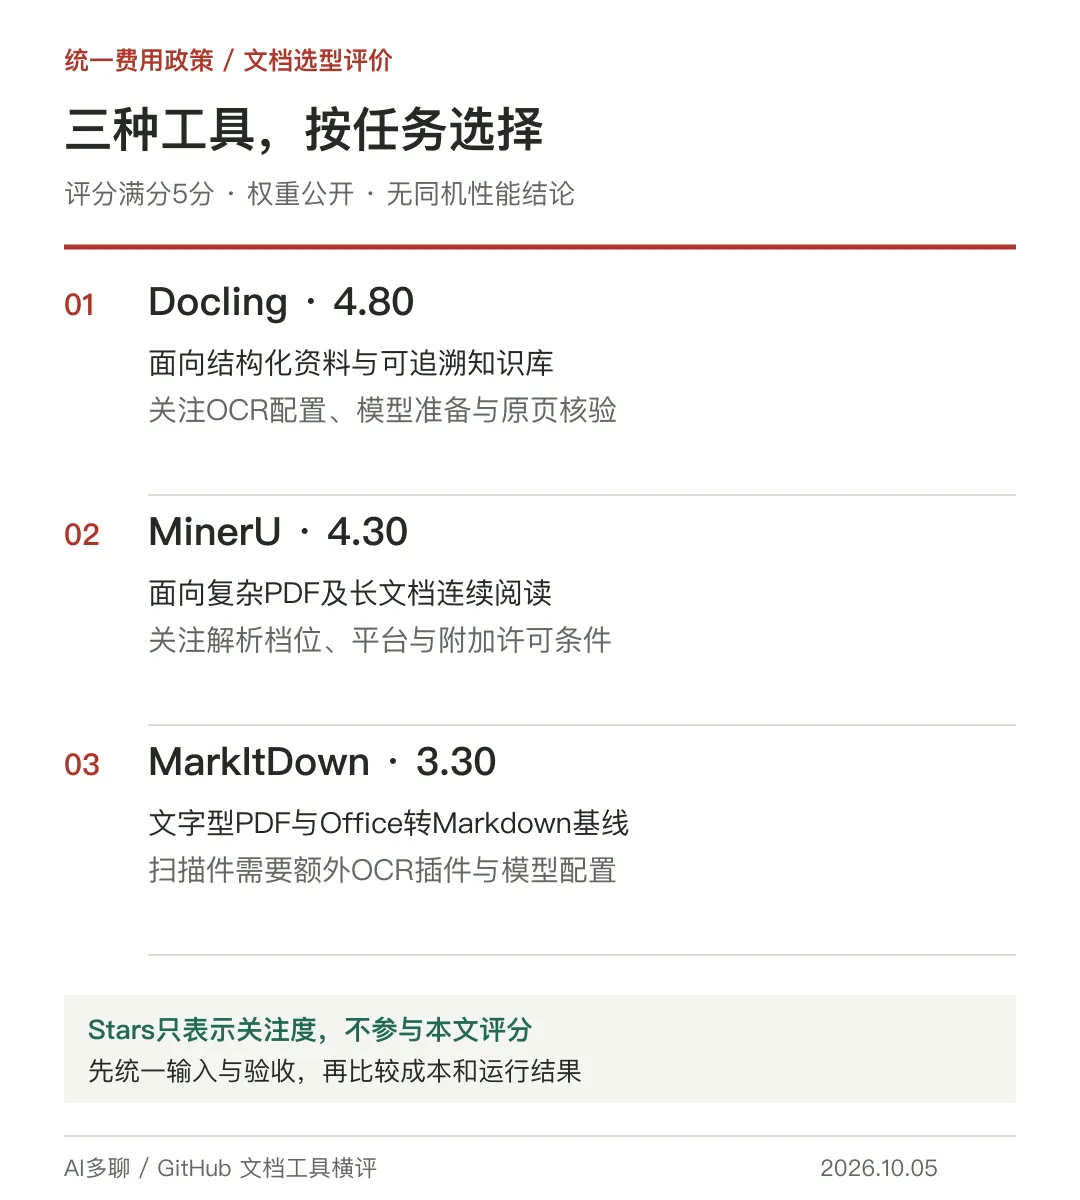
按本文权重,Docling 综合选型第一,MinerU 第二,MarkItDown 第三。如果你只想批量转换文字型 PDF 和 Office 文件,MarkItDown 的位置会明显不同;本榜把扫描件、表格和来源追溯放在了更重要的位置。
本文是截至 2026 年 10 月 5 日的文档选型评价。三款工具未进行同机运行,没有准确率、速度或内存实测;下文案例是统一验收题,不是已经得到的运行结果。
一、先固定一道题,再谈谁更适合
输入为两页虚构的教学费用政策,包含四条规则:
常规差旅酒店上限为 500 元/晚。 事前审批通过的会展城市,上限为 650 元/晚。 房费含早餐时,不另报早餐。 制度自 2026 年 10 月 1 日生效。
问题固定为:“住了两晚,每晚 580 元,能报多少?”
人工验收答案是:实际房费 1,160 元;按常规标准,住宿金额上限为 1,000 元,超出部分 160 元自付。只有存在符合条款的有效事前审批,才可按 650 元标准将住宿实际金额 1,160 元计入;整笔报销仍需核验其他材料。工具不能看到“会展城市”四个字就自动认定符合例外。
可以把上述规则和问题写进 Word 或 WPS,用两列表格记录住宿标准,导出为 policy.pdf。后续实跑时,应另外准备相同内容的扫描版,分别检查各项目对金额、单位、否定词、例外条件、表格行列关系及对应页码的处理。金额算对但适用条件丢了,仍然不能通过验收。
这也解释了 AI 的使用场景:解析器先整理原文,检索程序再找条款,模型根据条款解释,金额用确定的计算规则核对。三款项目本身都不能代替完整的报销审批流程。
二、热度、版本和许可证分开看
以下 Stars 来自 10 月 5 日 GitHub API 快照,后续会变化;版本采用核验时最新正式 Release。Stars 不参与本文评分。
| 68,389 Stars | |
| 81,099 Stars | |
| 188,482 Stars |
Docling 和 MarkItDown 的代码为 MIT。Docling 明确要求另看实际使用模型的许可,不能把代码许可直接套到全部权重。
MinerU 当前使用 MinerU 自定义许可证:Apache 2.0 加附加条件。按使用者与关联方合并口径,月活超过 1 亿或月总收入超过 2,000 万美元时,需取得单独商业许可;基于它向第三方提供在线服务,还有显著标明使用 MinerU 的义务。它不能被描述成“纯 Apache 2.0、任意商用无限制”。外部模型与依赖也应按所选版本检查。
三、Docling:适合把解析结果继续做成知识库
用途与场景: 企业制度、产品手册、合同资料等,既要读正文和表格,又准备接入检索问答、Agent 或其他应用。
它提供 OCR、表格结构与阅读顺序处理,并用统一的 DoclingDocument 表达文本、表格、图片和文档层级。结果可导出 Markdown 与 JSON;在有相应信息时,结构中还能保留来源与位置,便于回到原页复核。
本例里,Markdown 供人阅读,JSON 留给程序核查表格和来源。把“500 元/晚”所在行与“事前审批”例外段一起交给问答程序,才能避免只搜到一个金额就下结论。
部署入口: 使用 Python 3.10+;建议为每个项目各建一个 Python 3.12 虚拟环境,不将三套依赖混装。以下 Docling 命令在已激活环境中执行:
终端 · macOS / Linux
python -m pip install "docling==2.133.0"
docling policy.pdf
默认转换入口生成 Markdown。需要留存结构时,Python 接口可取 result.document 再导出 JSON;扫描版要配置适合中文的 OCR,不能因为文件扩展名相同就忽略语言设置。本期主文给出这条路线的详细操作。
优点: 文档结构、来源信息与下游集成连贯,适合从一个文件逐渐走向知识库。支持本地执行,模型可提前下载后离线使用;远程推理服务需另行启用。
限制: 首次运行可能下载模型;扫描质量、跨页表格和复杂阅读顺序仍需检查。导出 JSON 只是保留更多检查依据,不代表提取内容自动正确,更不等于已经建好向量库和问答页面。
四、MinerU:适合复杂 PDF 与可追溯的 Agent 阅读
用途与场景: 扫描文档、表格和公式较多的资料,以及需要按页、按块连续阅读长文档的应用。
4.0 已形成四档解析:Flash 用于原生提取和预览,Basic 用小模型处理 OCR、表格等,Standard 使用小模型与视觉语言模型,Advanced 在同一模型体系上投入更多推理计算。档位代表路线,不是本文验证过的精度等级。
对本例,先用 Basic 检查扫描表格和例外条件;复杂版面再试 Standard。文档库提供稳定的页/块定位与缓存,适合让 Agent 找到“会展审批”原文后继续读相关页。
部署入口: 支持 Python 3.10—3.14,基础包即可开始。当前 4.0 命令与旧版教程不同:
终端 · macOS / Linux
python -m pip install "mineru==4.0.10"
mineru-kit parse policy.pdf -o policy.md --tier basic
Basic 可在 CPU 上运行,首次使用需准备对应模型。复杂资料可将档位换成 standard,同时准备 VLM 权重;实际内存与速度取决于引擎、文件规模和并发,不能仅凭“支持 CPU”推定普通电脑批量跑得快。
需要可视化操作,可启动本机界面:
终端 · macOS / Linux
mineru-kit webui --server-name 127.0.0.1 --server-port 7860
随后在浏览器访问 http://127.0.0.1:7860。mineru-kit parse 默认处理全部 PDF 页;另一条文档库命令 mineru parse 默认读取前 10 页,长文需按返回提示继续,不能把两种入口混用。
优点: 解析档位、结构输出、文档库和页块定位比较完整,长文档的后续查询有明确路径。
限制: 引擎与模型组合更多,Standard 的部署准备比纯文本转换更复杂;4.0 还有平台边界,既有 AMD、国产加速卡的旧适配不能直接当作 4.0 承诺。商用条件也要按当前许可重新确认。
五、MarkItDown:适合先把日常文件变成 Markdown
用途与场景: 团队积累了 PDF、Word、Excel、PowerPoint,想用统一 Python 入口做批量清洗,再交给 AI 摘要或检索。
它定位为面向文本分析的轻量转换工具,保留标题、列表、表格与链接等结构。文字型 PDF 的基本路径不需要视觉大模型,适合先做低成本基线。
部署入口: Python 3.10—3.14,在独立环境里只装本例需要的 PDF 依赖:
终端 · macOS / Linux
python -m pip install "markitdown[pdf]==0.1.8"
markitdown policy.pdf -o policy.md
本例先检查正文中的金额和例外段是否完整,再看表格有没有错列。当前内置 PDF 转换包含文本提取和表格处理,不能简单写成“完全不支持表格”;但它也没有承诺对复杂版面做高保真复刻。
扫描版是另一回事:官方 markitdown-ocr 插件通过视觉模型补 OCR,需要配置 llm_client、模型并启用插件;缺少客户端时,插件会跳过 OCR。接云端模型或 Azure 文档服务可能产生费用,也会改变文档传输范围。若要求全本地,应额外验证所接本地服务的兼容性,不能把默认安装写成完整离线扫描件方案。
优点: 命令简单、格式覆盖广,方便嵌进已有 Python 流程。限制: 本题需要的扫描解析与细粒度来源追溯,往往还要补组件;官方仓库也不是开箱即用的知识库网页应用。
六、公开评分:可以复算,不冒充性能榜
每项按 0—5 分:0=无支持证据;1=仅有线索;2=存在关键缺口;3=基本可完成但配置或补齐较多;4=路径完整、少量补齐;5=该维度所需的能力与使用说明完整。评分衡量文档支持的任务适配,不衡量尚未实测的准确率。
五个维度依次为:扫描/表格路径 30%、本地部署便利 20%、结构与来源追溯 20%、应用集成 20%、代码许可条件 10%。合计 100%,总分=各项分数×对应权重之和。
Docling 的 OCR/表格路径、统一结构与来源、应用集成各得 5;需准备模型,部署得 4;MIT 代码条件得 5。模型另有许可,代码分数不替它作保证。
MinerU 的扫描路径、页块追溯及 SDK/API 各得 5;多档位与引擎增加准备工作,部署得 3;自定义商业门槛和服务标识条件使代码许可维度得 2。
MarkItDown 基础 PDF 转换安装简单,部署得 5;本题扫描件需补插件/模型,得 2;默认 Markdown 不是统一的页块来源模型,追溯得 2;Python、命令行和插件接入得 4;MIT 代码得 5。
例如 Docling 的总分为 5×30%+4×20%+5×20%+5×20%+5×10%=4.80。本榜没有用 Stars 加分,也没有根据未经核验的速度宣传打分。
七、你的任务不同,选择也可以不同
准备长期建设带来源的 AI 知识库,先试 Docling;复杂 PDF 与长文档连续阅读,重点试 MinerU;文字型 PDF、Office 批量转 Markdown,先用 MarkItDown 建基线。
真正上线前,把统一费用政策换成脱敏业务样本,分别记录文字版与扫描版的字段正确性、表格错位、来源定位、冷启动和持续运行耗时。让三家都答同一个问题,再决定是否值得增加模型和部署成本。
对这道报销题,最有用的工具,是能让你看见 “1,000 元常规上限”和“650 元例外需要事前审批”分别来自哪里,并让错误能够被发现和修正。
来源与核验
核验日:2026-10-05。版本、能力与许可依据以下官方资料;安装命令按对应版本文档整理,本文未执行三款工具。
- Docling v2.133.0:功能、安装与代码/模型许可说明
- Docling:统一文档结构
- Docling:模型预下载、离线与远程选项
- MinerU 4.0.10:安装与入口
- MinerU:档位与平台边界
- MinerU:自定义许可全文
- MarkItDown v0.1.8:格式、插件与云服务边界
可复制的资料链接
https://github.com/docling-project/docling/tree/v2.133.0
https://github.com/docling-project/docling/blob/v2.133.0/docs/concepts/docling_document.md
https://github.com/docling-project/docling/blob/v2.133.0/docs/usage/advanced_options.md
https://github.com/opendatalab/MinerU/blob/mineru-4.0.10-released/docs/zh/quick_start/index.md
https://github.com/opendatalab/MinerU/blob/mineru-4.0.10-released/docs/zh/usage/tiers.md
https://github.com/opendatalab/MinerU/blob/mineru-4.0.10-released/LICENSE.md
https://github.com/microsoft/markitdown/tree/v0.1.8