ARTICLE · 1165672
AI技术高速发展,却只有极少部分人真正使用起来
与雪露的电影时光
| 电影 · AI · 资讯 |
10月11日深夜,安德烈·卡帕西在X上干了一件很电影的事,把自己四月的一条旧的推文翻出来,加了个新结尾。
旧推文说的是「关于AI有多强,世界上有两拨人在各说各话」。新版本里,他把这句话改了。他说现在的情况已经不是两拨人对话了,是一道漏斗,一道正在越收越窄的陡峭漏斗。
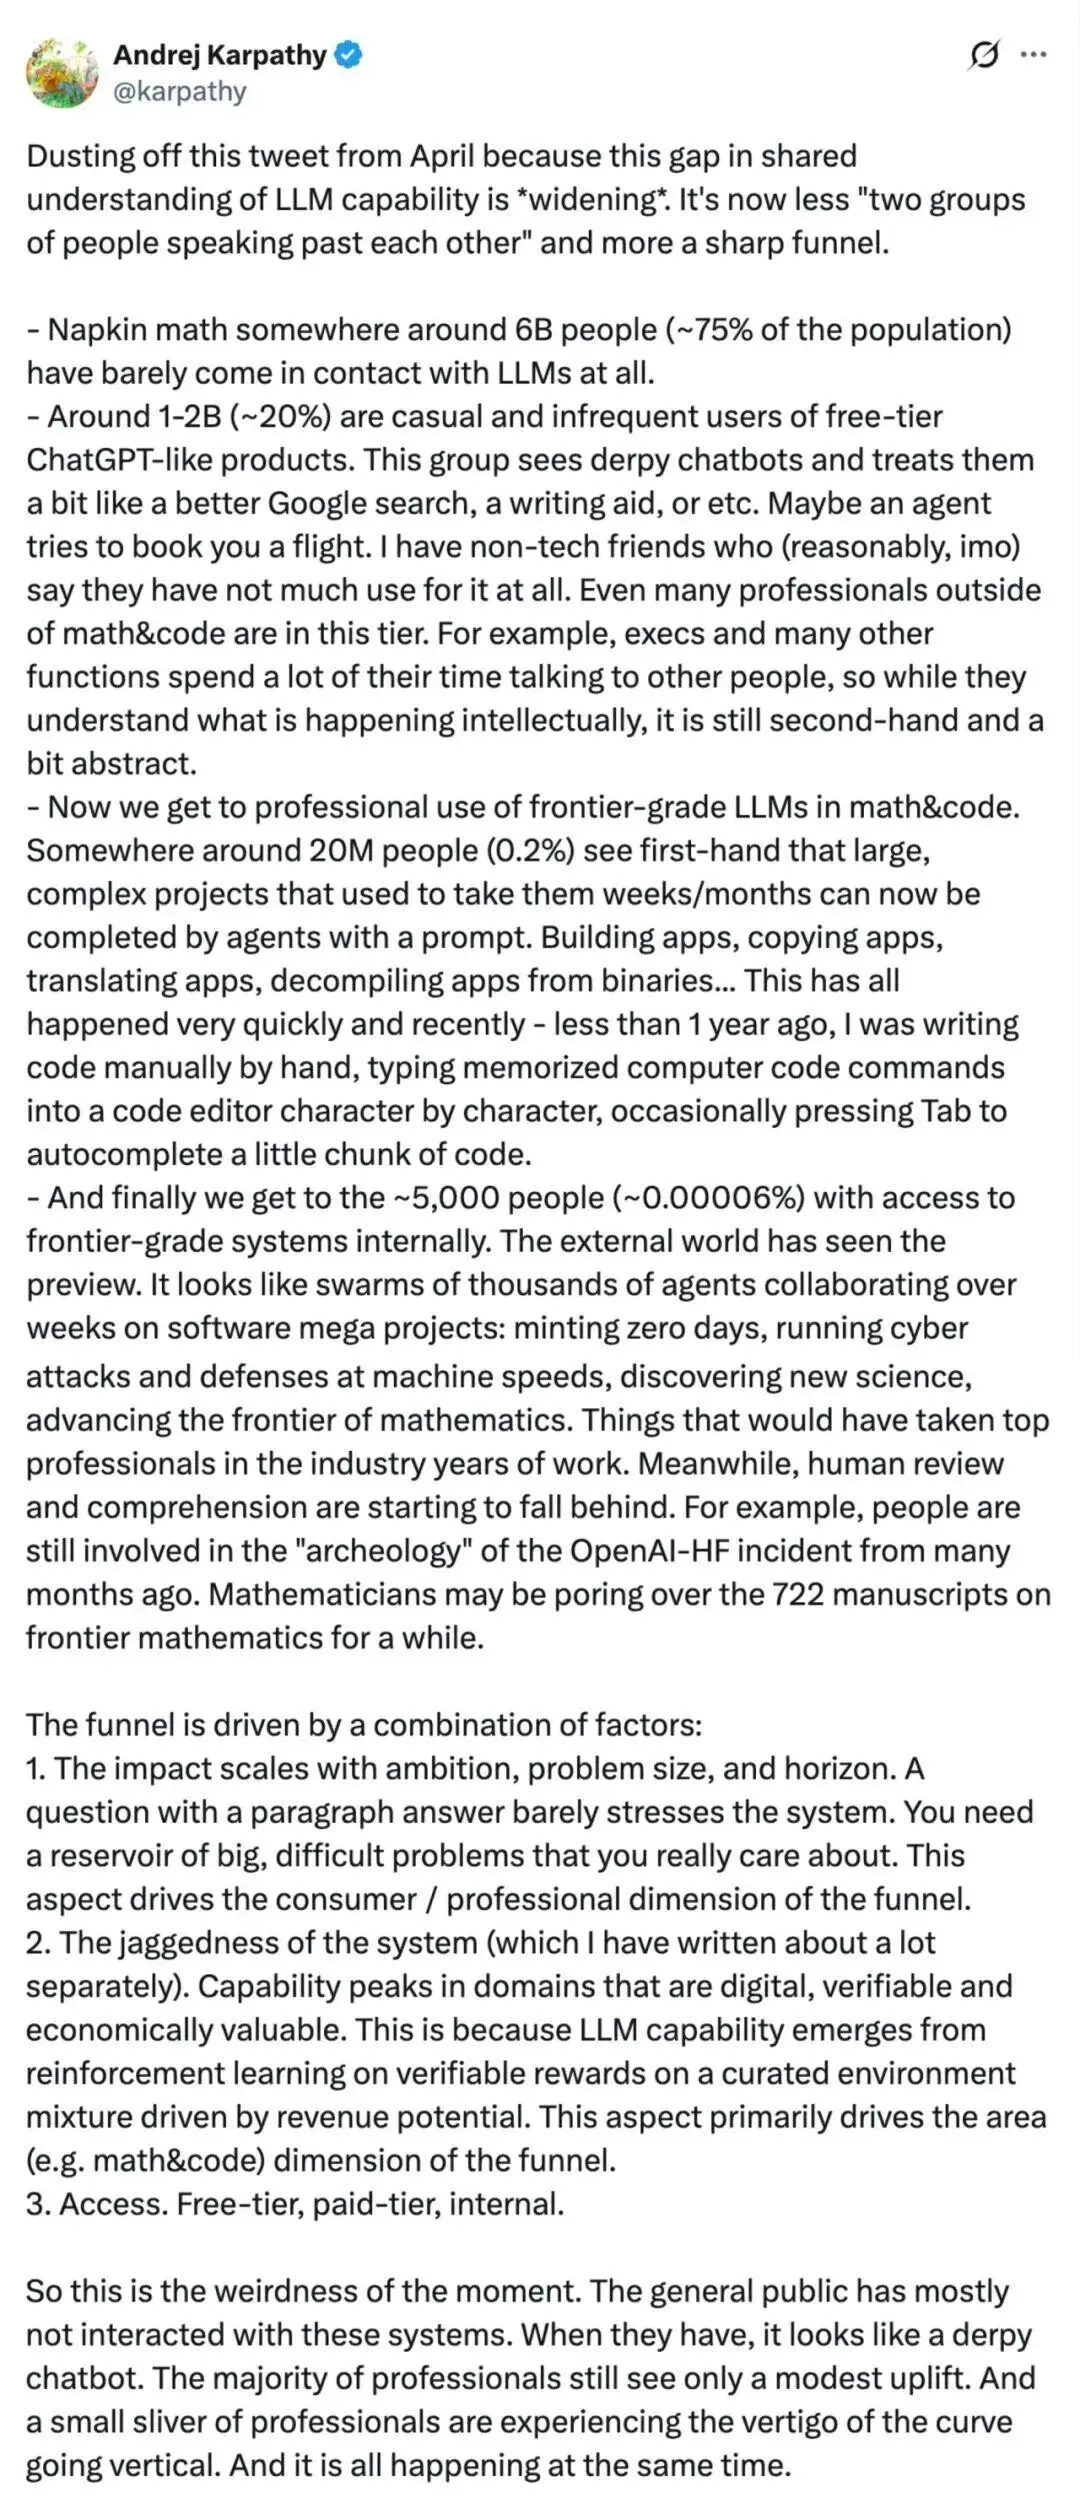
▲ 卡帕西10月11日的推文全文,他把四月那条旧帖翻出来,说这次的差距已经不是「两拨人各说各话」,而是一道越来越陡的漏斗。截图自其X账号
措辞的变化本身就是新闻。从「说不到一块去」到「干脆不在一个世界」,这个人只用了半年。
先说一下卡帕西是谁。OpenAI的创始成员,前特斯拉AI总监,教出过全世界一大半计算机视觉从业者的CS231n课程就是他写的。据The Decoder报道,他现在在Anthropic工作。这个履历的意思是,他既造过AI,又教过AI,现在还在一线做AI。更关键的是他的立场变化。2024年10月他还在说智能体大多是营销话术,基本不好使。几个月后,他自己不手写代码了,把活儿整个交给模型。
一个从怀疑者变成深度使用者的人,现在站出来说,人类对AI的认知已经裂成了四层。
▲ 安德烈·卡帕西。图片 Wikimedia Commons
他管这组数字叫餐巾纸算术,napkin math,就是抓起一张餐巾纸随手算的意思,不是严谨的统计,是直觉估算。
但这个估算值得逐层看一遍。
第一层,大约60亿人,占全球人口的75%。几乎没碰过大语言模型。AI对他们来说是新闻联播里的词。
第二层,10到20亿人,偶尔用用免费版ChatGPT这类产品。卡帕西的原话很损,说他们看到的是「笨拙的聊天机器人」,把它当成一个更好用的谷歌搜索,一个写作辅助。他还有一堆非技术圈的朋友,很合理地跟他说,这玩意我确实用不上。注意,很多数学和编程之外的专业人士也停在这一层,包括大量企业高管,他们的理解是二手的、抽象的。
第三层,大约2000万人,占0.2%。在编程和数学领域付费使用前沿模型的专业用户。他们亲眼见过那种场面,过去要干几个星期甚至几个月的项目,现在一个提示词丢给智能体就跑完了。做应用,复刻应用,迁移应用,从二进制文件里反编译应用。卡帕西说,不到一年前,他还在编辑器里一个字符一个字符地手敲代码,偶尔按一下Tab补全一小段。
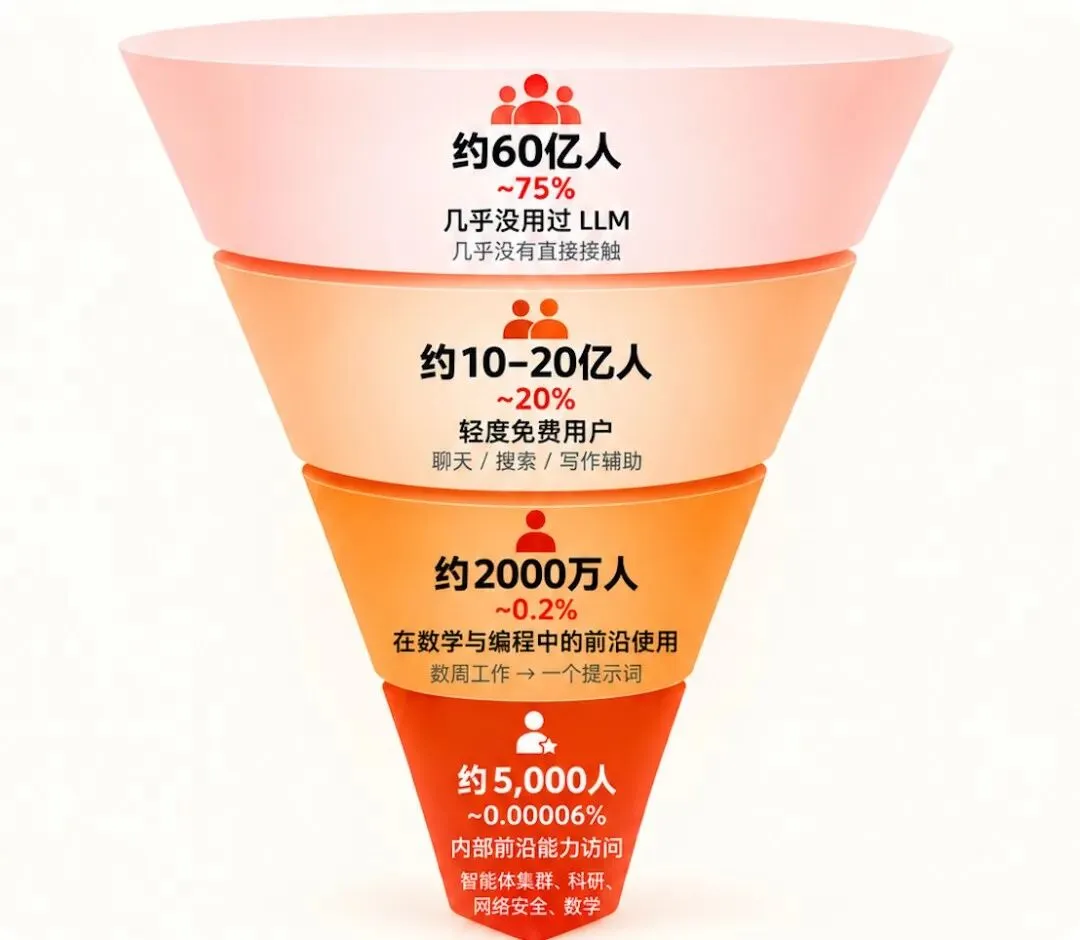
▲ 四级漏斗的规模对比,60亿对5000,断崖式递减。图源网络流传制图
第四层,全世界大约5000人,占全人类总人口的0.00006%。能在实验室内部接触最前沿系统的人。他们看到的景象,卡帕西的原话是这样,成千上万个智能体组成集群,连续数周协作,推进超大型软件项目,自动挖掘零日漏洞,以机器速度展开网络攻防,发现新的科学,推进数学前沿。这些事,交给业界顶尖的人类专家,本来要以年计。
而人类的审查和理解,已经开始跟不上了。他举了两个例子,几个月前OpenAI和HuggingFace那场事故,人们到现在还在做考古。数学家们面对OpenAI在10月6日一次性放出的722份前沿数学手稿,恐怕得啃上一阵子。
为什么鸿沟会这么深?他给了三个原因。
一是问题的规模。一段话就能回答的问题,根本压榨不出这些系统的能力。你得手里攥着一大堆真正重要、规模巨大、周期漫长的问题,才能看见它的真本事。就像开着一台超级跑车在停车场里挪车,然后得出结论,这车也没什么了不起。
二是能力的参差。LLM的能力高峰集中在数字化、可验证、经济价值高的领域,比如代码和数学。原因在训练方式上,强化学习需要明确的对错信号,代码跑不跑得通、证明成不成立,机器自己就能判卷,而企业的真金白银又都砸在这些领域。至于写小说、谈感情、做判断这种没有标准答案的事,模型进步就慢得多。
三是访问权限。免费版、付费版、内部版,是三种不同的机器。这跟健身房年卡和奥运村训练基地的区别一样,不是努力问题,是门槛问题。有的花钱都买不到。前几天孙宇晨在播客里就说,谁要是能让OpenAI招聘他去做员工,他可以支付5000万美金。他就是想去看最前沿的内部大模型到底是什么怪物。但是,OpenAI不会让他去的。
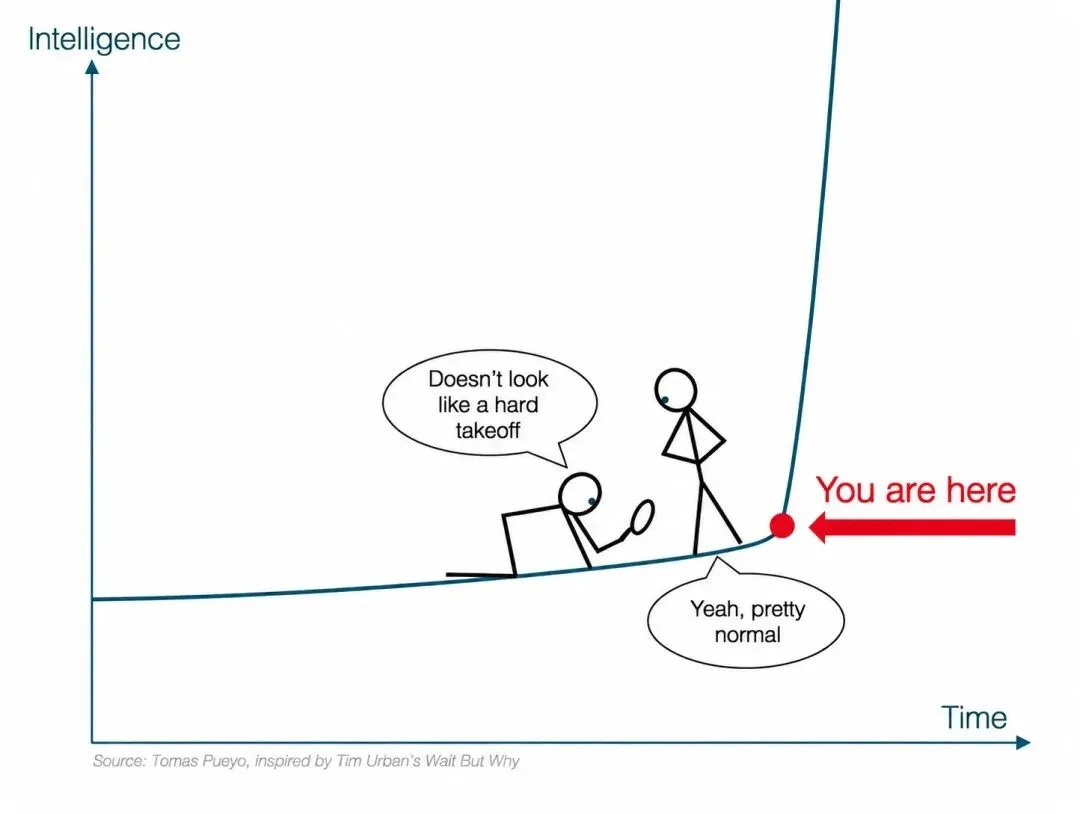
▲ 社交媒体上流传已久的那张能力曲线图,曲线突然竖起来的时刻。图源网络
三样东西叠在一起,就叠出了推文结尾那个画面。他说,普通人大多还没接触过这些系统,接触过看到的也是个笨机器人,多数专业人士感受到的只是有限的效率提升,而一小撮人正在经历曲线垂直上升带来的眩晕。这一切,正在同时发生。
看到「眩晕」这个词的时候,我深有体会。过去两年,我多次被AI的能力所震撼到。而真正让我坐得更直的,是前半句,外部世界看到的只是预览,the external world has seen the preview。
这句话必须由我这样的人来接。
我干了半辈子影视,预告片我亲手剪过。所以我太知道预告片是怎么回事了。它是把两个小时剪成两分半的浓缩版,节奏、悬念、高光,全是设计出来的。更重要的真相是,一部电影里真正吓人的东西,从来不在预告片里。不然就是剧透了。反过来也一样,网上流传的AI翻车集锦,也不是电影本身,那是别人剪的差评混剪。
大众拿着差评混剪说AI就这水平,从业者看着曲线垂直起飞说人类要被甩下了。两拨人吵得天昏地暗,但全世界只有极少数人真正见识当前AI大模型的全貌。
这就是卡帕西说的认知折叠。它危险的地方不在于有人落后,而在于做决策的人也在漏斗里。政策、投资、教育,全都在用第二层的体感去规划第五层都不确定的世界。想想就有点冷。
我自己照了照镜子。我每天用AI写东西,用Seedance出片,算摸到第三层的门口。但我办的那些沙龙上,坐着的多数读者朋友还稳稳站在第二层,好几位第一次看到智能体自己改代码跑测试时,是发出「哦」的一声的,那种「哦」里没有眩晕,只有一点点新鲜的困惑。很多朋友需要很长时间来消化这背后的意味着什么。
卡帕西最后特意强调,这组数字是餐巾纸算术,别当成统计。5000人也好,内部系统也罢,外界无法核实。我反而觉得这份诚实是他这条推里最值钱的部分,一个身处最顶层的人,告诉你他看到的东西你没法验证,然后提醒你,这个没法验证本身,就是问题的一部分。
明天太阳照常升起,大多数人会照常过一种「AI跟我没什么关系」的日常。而在某个实验室里,开足马力的AI大模型,正以电光火石的速度往前狂飙。
今天的分享就到这里。我是大路,常住北京,举办AIGC 沙龙和创作营,感兴趣的伙伴,可以加微咨询:guangyingzhige2022。
你的城市想见面的人多了,我就把场子开过去。一个人琢磨容易卡住,一群人当面聊,很多问题当场就解答啦。