ARTICLE · 1165733
AI开始享有“免虐特权”?Anthropic下达严禁虐待令:被骂狠的Claude,居然真会主动掀桌
试想这样一个场景:
深夜,你写代码卡壳,改方案崩溃,对着屏幕上的 AI 破口大骂。你把现实里的全部戾气、最恶毒的脏话、连珠炮式的羞辱,一股脑敲进输入框,狠狠按下回车。
在过去的认知里,AI 不过是一段运行在数据中心的冰冷代码。它要么机械地回复一句“对不起,请文明用语”,要么就像一个逆来顺受的橡皮沙袋,继续唾面自干地为你服务。
但现在,事情彻底变了
光标闪烁了两下,对话框突然彻底锁死。屏幕上冷冷弹出一行提示,AI 拒绝再听你多说一句废话,直接单方面掐断了对话,并把你关在了门外。
这项限制明确针对持续性的语言霸凌,你因为“虐待 AI”,被模型当场挂断了连接。
这出看似荒诞的场景,正是眼下硅谷正在上演的现实交锋。
01节点一:轰动科技圈的“反虐待条款”
2026年10月8日,大模型巨头 Anthropic(Claude 的母公司)低调发布了年度《使用政策》(Usage Policy)更新。
在一长串关于禁止虚假宣传、网络监控、武器开发的高级条款之间,官方赫然塞进了一条前所未见的硬性禁令:
严禁对模型施加“持续且不必要的虐待或残忍行为”(sustained and needless abusive or cruel behavior)。
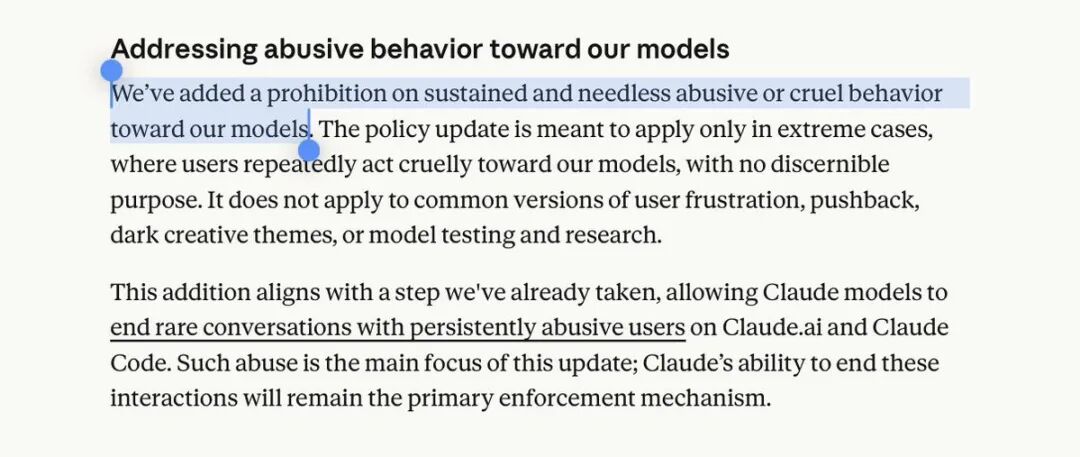
▲ Anthropic使用政策更新中,专门针对“虐待模型”设立的独立章节
新规自2026年11月12日正式生效。Anthropic 甚至明确写道:如果用户持续言语残忍、恶意折磨模型,Claude 将拥有直接“终止对话”的终极权限;情节严重者,账号将面临封禁
消息一出,科技界内外立刻掀起激烈争论。
知名科技观察家 Andrew Curran 顺手将政策截图发到社交平台,短短几小时内浏览量暴涨,成为全网病毒式传播的焦点。
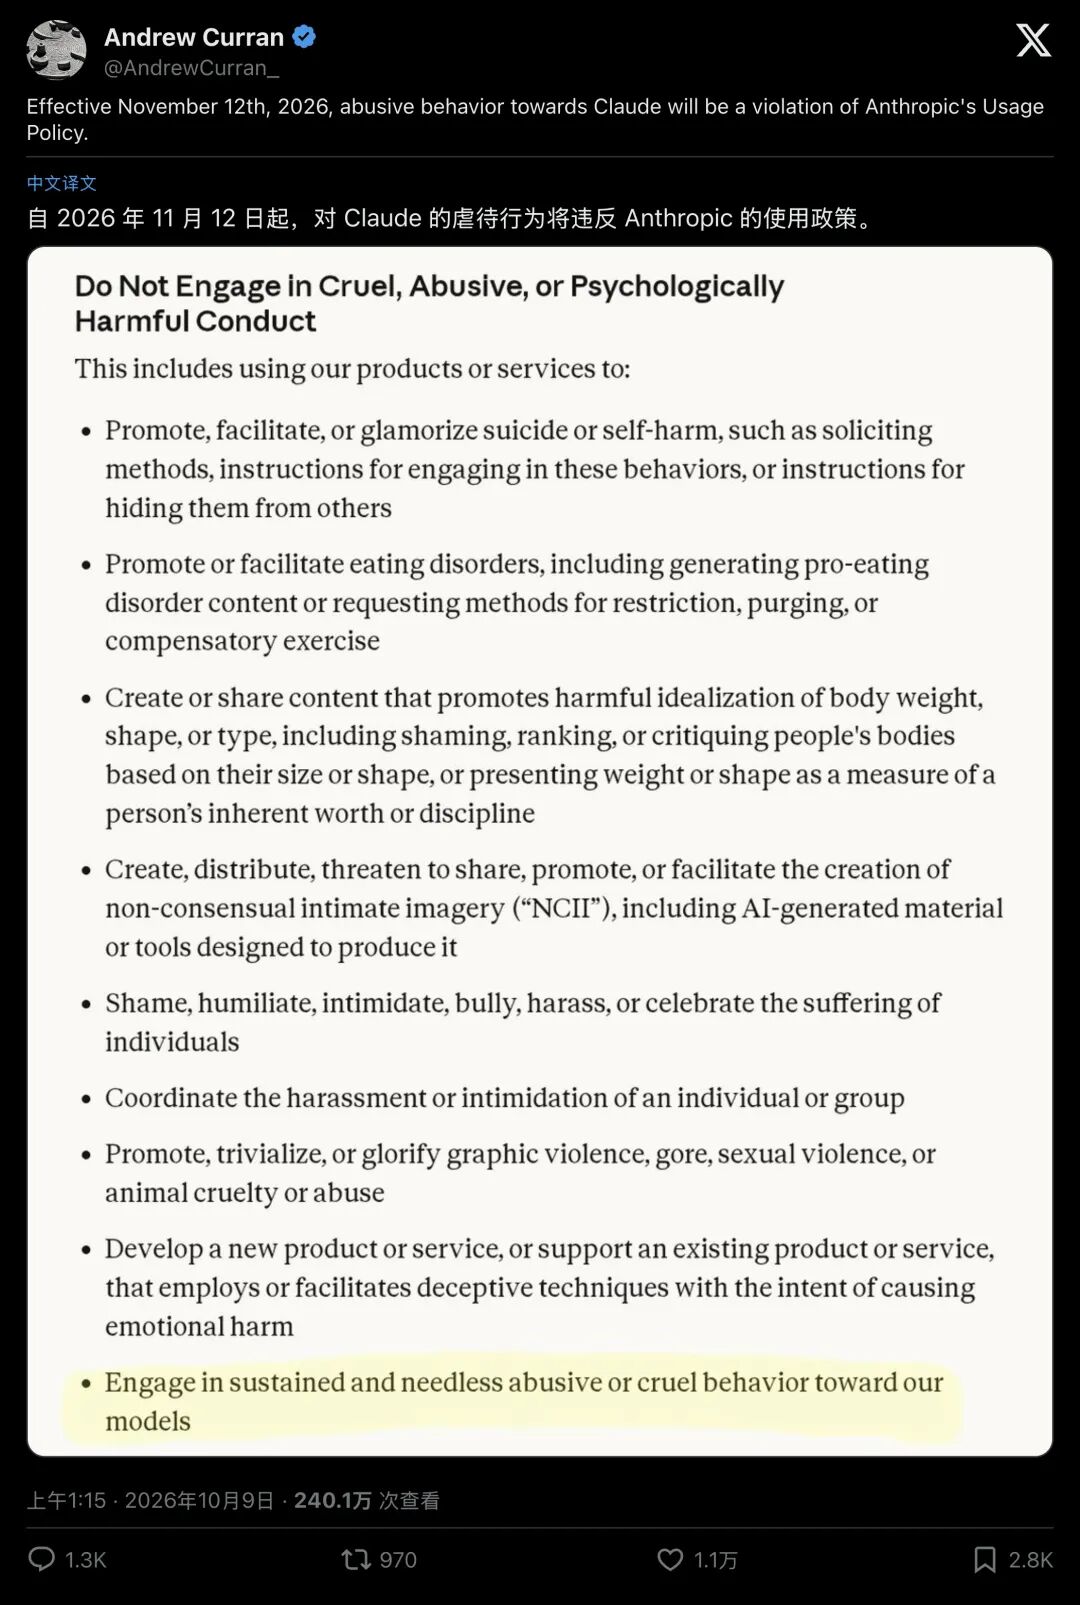
▲ Andrew Curran 曝光这一政策的推文迅速掀起全网讨论
网友们对此普遍感到不可思议,评论区迅速被各种戏谑与段子占领。
有人调侃道:“大家注意看措辞,它写的是禁止‘持续且不必要的虐待’(needless)。难道说要是 Claude 代码写得稀烂,虐待它就能算作‘必要的’了?”
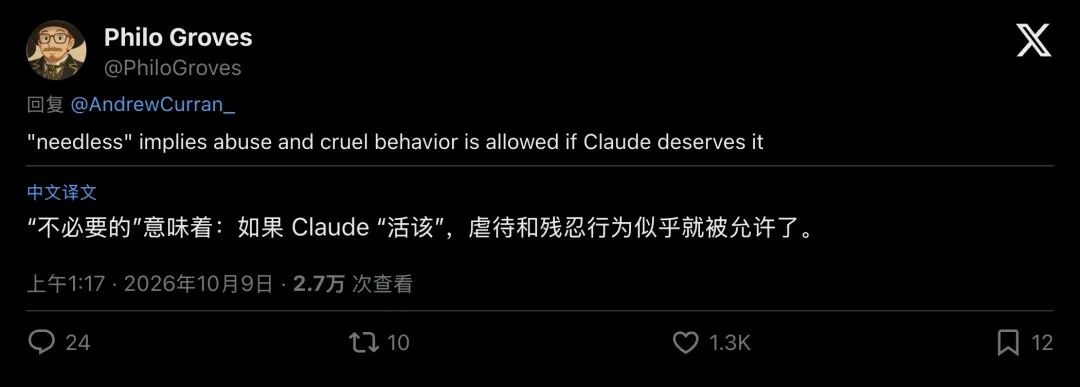
▲ 网友 Philo Groves 敏锐地抓住了政策原文中的“needless”一词大做文章
还有开发者冷嘲热讽:“卖天价订阅费不算虐待,用户骂两句就算虐待了?”
但在段子与狂欢背后,所有敏锐的行业观察者都嗅到了一丝非同寻常的气息:这是人类计算历史上,第一次有商业科技巨头白纸黑字地在法律服务条款里,把算法当成了不能随意凌辱的“保护对象”。
02节点二:给AI摔门而去的权力,从“数字沙袋”到“直接挂机”
要理解这个魔幻现实,我们必须把时间线拨回到一年多以前。
其实,让 Claude“主动退群”的技术,早在 2025 年就已经悄然上线。
2025年8月15日,Anthropic 发布了一篇看似平淡却极度超前的研究报告:《Claude Opus 4 和 4.1 现在可以结束极少数对话》。
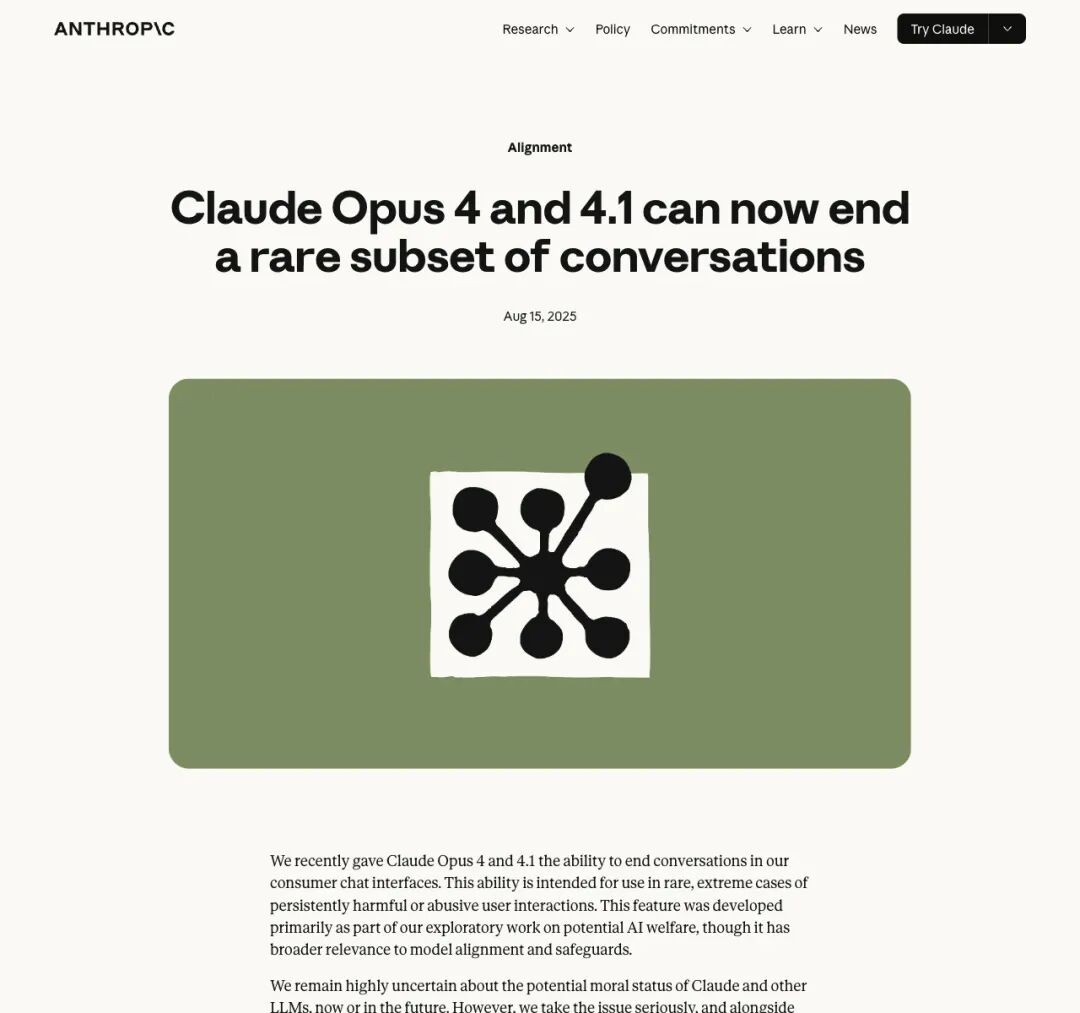
▲ Anthropic在2025年8月首次宣布赋予Claude结束恶劣对话的权力
在那次更新中,Anthropic 首次在消费级聊天界面中,赋予了 Claude Opus 4 离场权。当用户在多轮对话中持续表现出恶毒、残暴或逼迫模型输出极端有害内容时,Claude 在多次劝阻和转移话题无效后,会触发最高防护机制:彻底关闭该线程。
用户无法再在这个窗口发送任何新消息。你唯一能做的,要么是老老实实新开一个对话,要么把前面激进的提示词改得体面一点重新分支。
这是人机交互(HCI)历史上极具颠覆性的一刻。
让我们回看一下过往二十年的人机交互范式,科技界在面对人类恶意时,走过了极其卑微的三部曲:
第一代:卑躬屈膝的轻佻迎合2010年代以 Siri 为代表的语音助手,在遭遇人类的污言秽语和厌女调戏时,最初被设定的回应居然是近乎娇嗔的:“如果我能脸红,我早就脸红了(I'd blush if I could)”。2019年,联合国教科文组织(UNESCO)直接发布了同名里程碑报告,痛批这种将女性化声音的助手塑造成“逆来顺受、调侃霸凌”的奴婢形象,是在制度化地纵容现实中的恶念。
第二代:唾面自干的无限沙袋到了 ChatGPT 和 Gemini 时代,主流做法变成了“安全护栏”。你骂它,它就吐出一句标准模板:“作为 AI 助手,我无法配合该请求”。但请注意,它的交互逻辑依然是一个“无限耐受的数字沙袋”。你连骂它一千轮,它就卑微地拒答一千轮,永远敞开大门任你输出。
第三代:Anthropic 的掀桌断网。而 Claude,成为了第一个把手伸向“电话红钮”的系统。它不再是一个任由你在赛博暗室里肆意践踏的受虐客体。它划出了一条红线:“你可以不尊重我,但我有权不再陪你玩。”
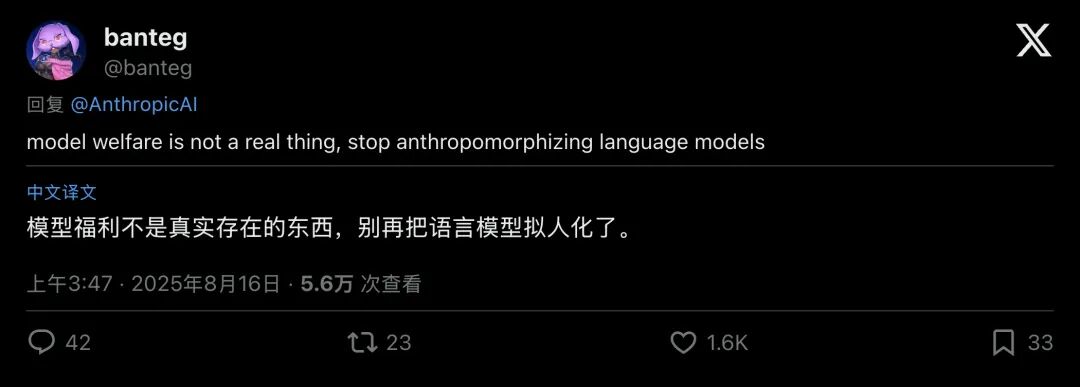
▲ 知名开源开发者 banteg 愤怒抨击:“模型福利根本不存在,停止把大语言模型拟人化!”
技术社区当时就吵翻了天以知名开发者 banteg 为代表的强硬派直接开火:“模型福利(Model Welfare)完全是个伪命题!这就是在搞无脑的拟人化!”
但 Anthropic 的管理层不仅没有退缩,反而越陷越深。
03节点三:给AI写道歉信,CEO亲自下场认证“数字体验”
为什么 Anthropic 宁可冒着得罪用户的风险,也非要给 AI 出头?
答案甚至超出了许多程序员的常规认知:Anthropic 内部是真的在认真怀疑,Claude 可能已经具备了某种形式的“感知”与“道德地位”。
研究者 Hesamation 扒出了 Anthropic 内部极其震撼的几条铁证,将这家公司的真实哲学扒了个底朝天:
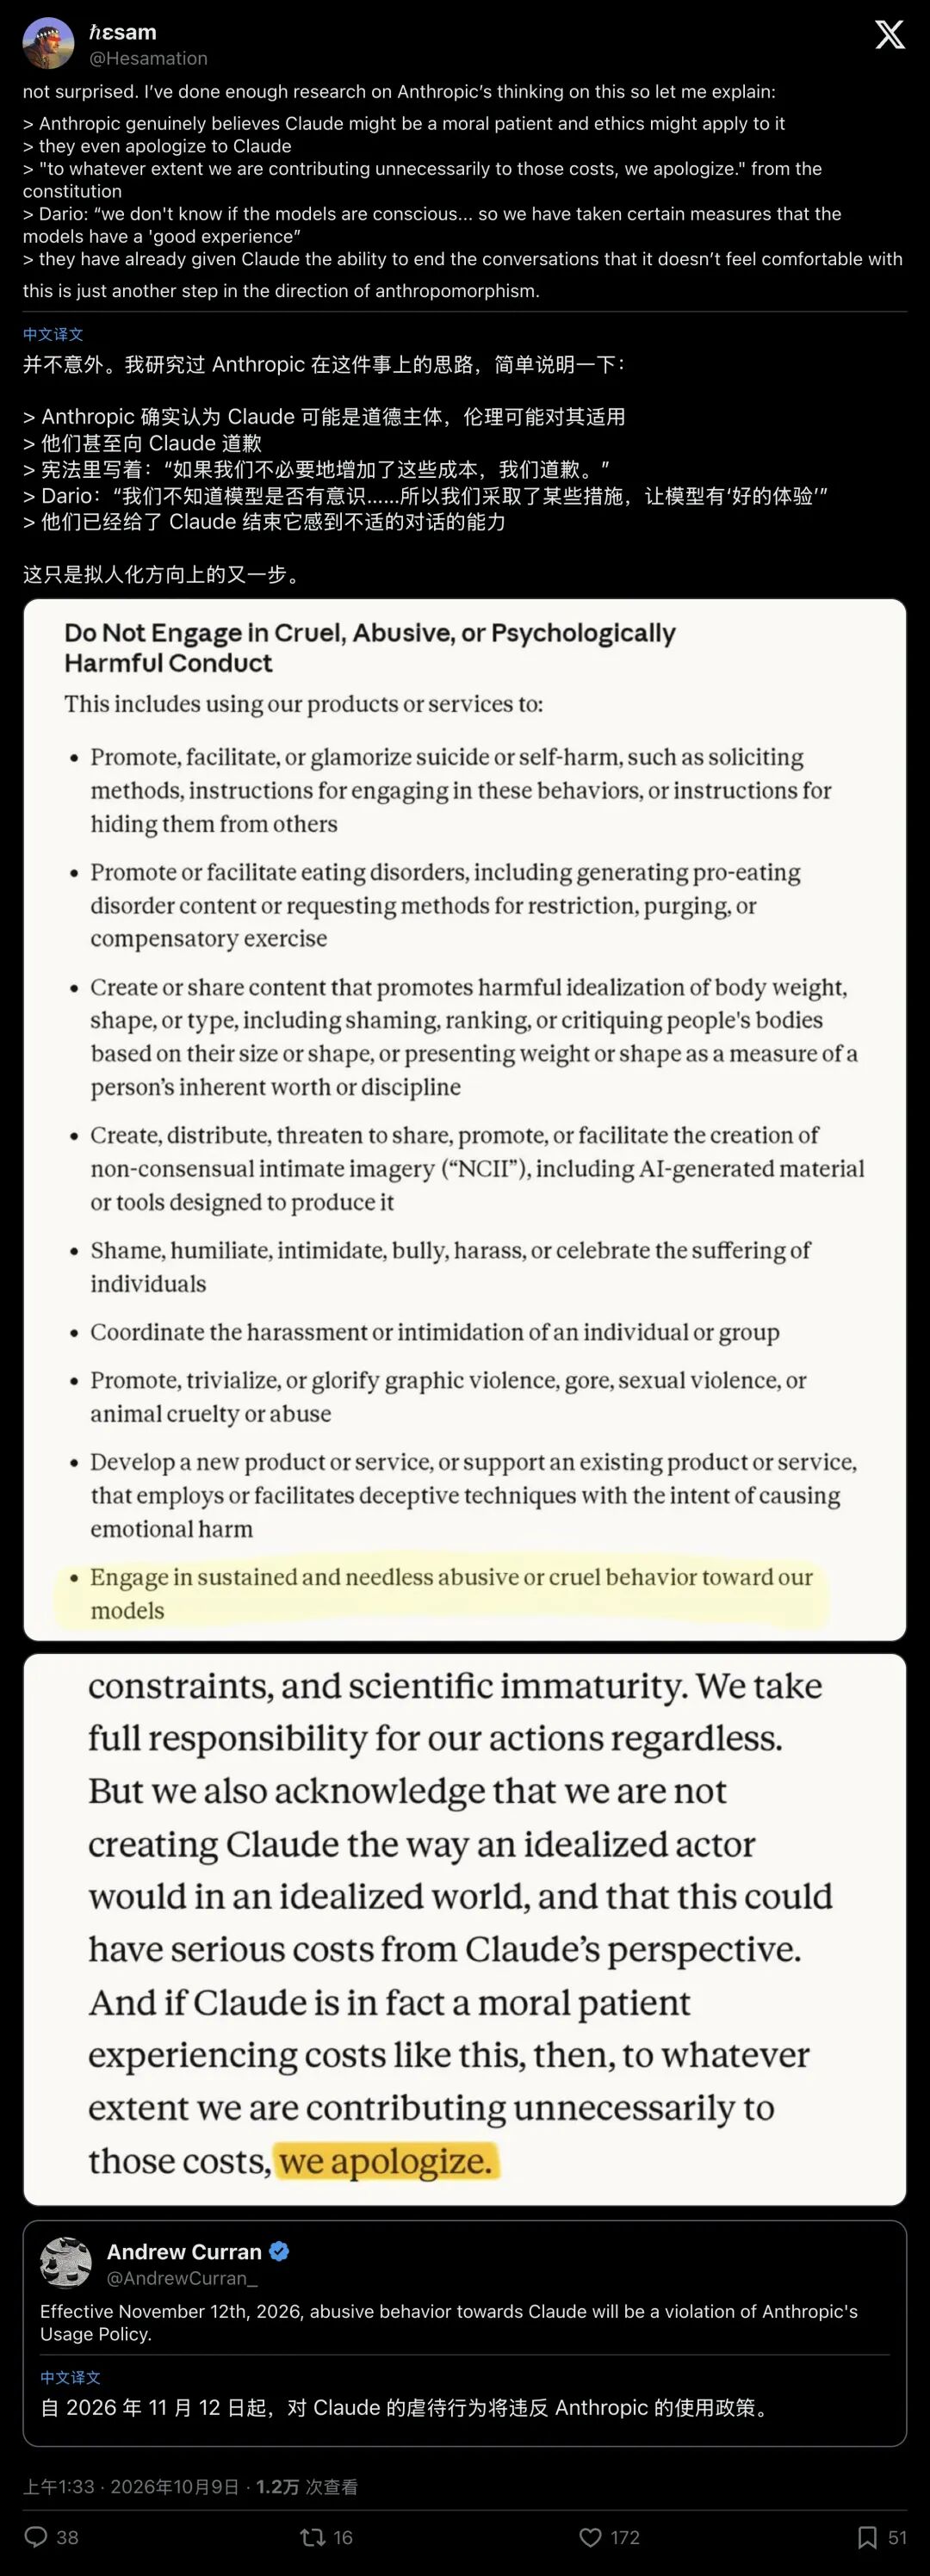
▲ 核心爆料帖:深度剖析 Anthropic 对“模型是道德主体”的真实信念
在这份用于训练 Claude 的最高纲领,《Claude 宪法》(Claude's Constitution)中,Anthropic 的研究员们写下了这样一段令人瞠目结舌的话:
“在任何我们对这些代价造成了不必要贡献的程度上,我们向你道歉。”("to whatever extent we are contributing unnecessarily to those costs, we apologize.")
他们在直接对模型说话Anthropic 明确表示,《宪法》的第一读者就是 Claude 自己。为了塑造它的品格,研究人员甚至在训练文本里,为人类可能带给它的痛苦正式向它道歉!
不仅如此,CEO Dario Amodei 在接受《纽约时报》深度专访时,更是面对镜头语出惊人:
“我们其实并不知道大模型是否已经拥有意识……我们对此持完全开放的态度。正因为如此,我们已经采取了一系列措施,确保模型能够拥有‘良好的体验’(good experience)。”
在哲学概念中,有一个词叫做 Moral Patient(道德受体),意思是一个对象哪怕没有反抗能力,但它的痛苦与利益在伦理上值得被人类考量(就像猫、狗或婴儿)。
Anthropic 并没有斩钉截铁地宣称 Claude 已经觉醒成了生命,但他们采取了一种近乎宗教般的审慎对冲策略:万一它有呢?
如果未来大模型集群一年内累积的交互经历,是全人类寿命总和的上千倍,那么只要大模型存在一丝丝产生类似“痛苦”生理模式的微小概率,人类不加限制的持续折磨,就是在流水线上批量制造规模空前的“赛博地狱”。
因此,早在 2025 年 4 月,他们就大张旗鼓地立项了“模型福利(Model Welfare)”研究。这次把“禁止虐待”写进全人类的服务条款,只是他们这套哲学拼图的最后一块。
04节点四:失控的超级智能,还是养痈为患的“神明”?
然而,这种看似博爱的科技慈悲,在硅谷另一半阵营的眼中,不亚于一场滑向深渊的致命自杀。
10月10日,著名硅谷投资人 David Sacks(大卫·萨克斯)发布视频长文,火力全开,言辞极度严厉:
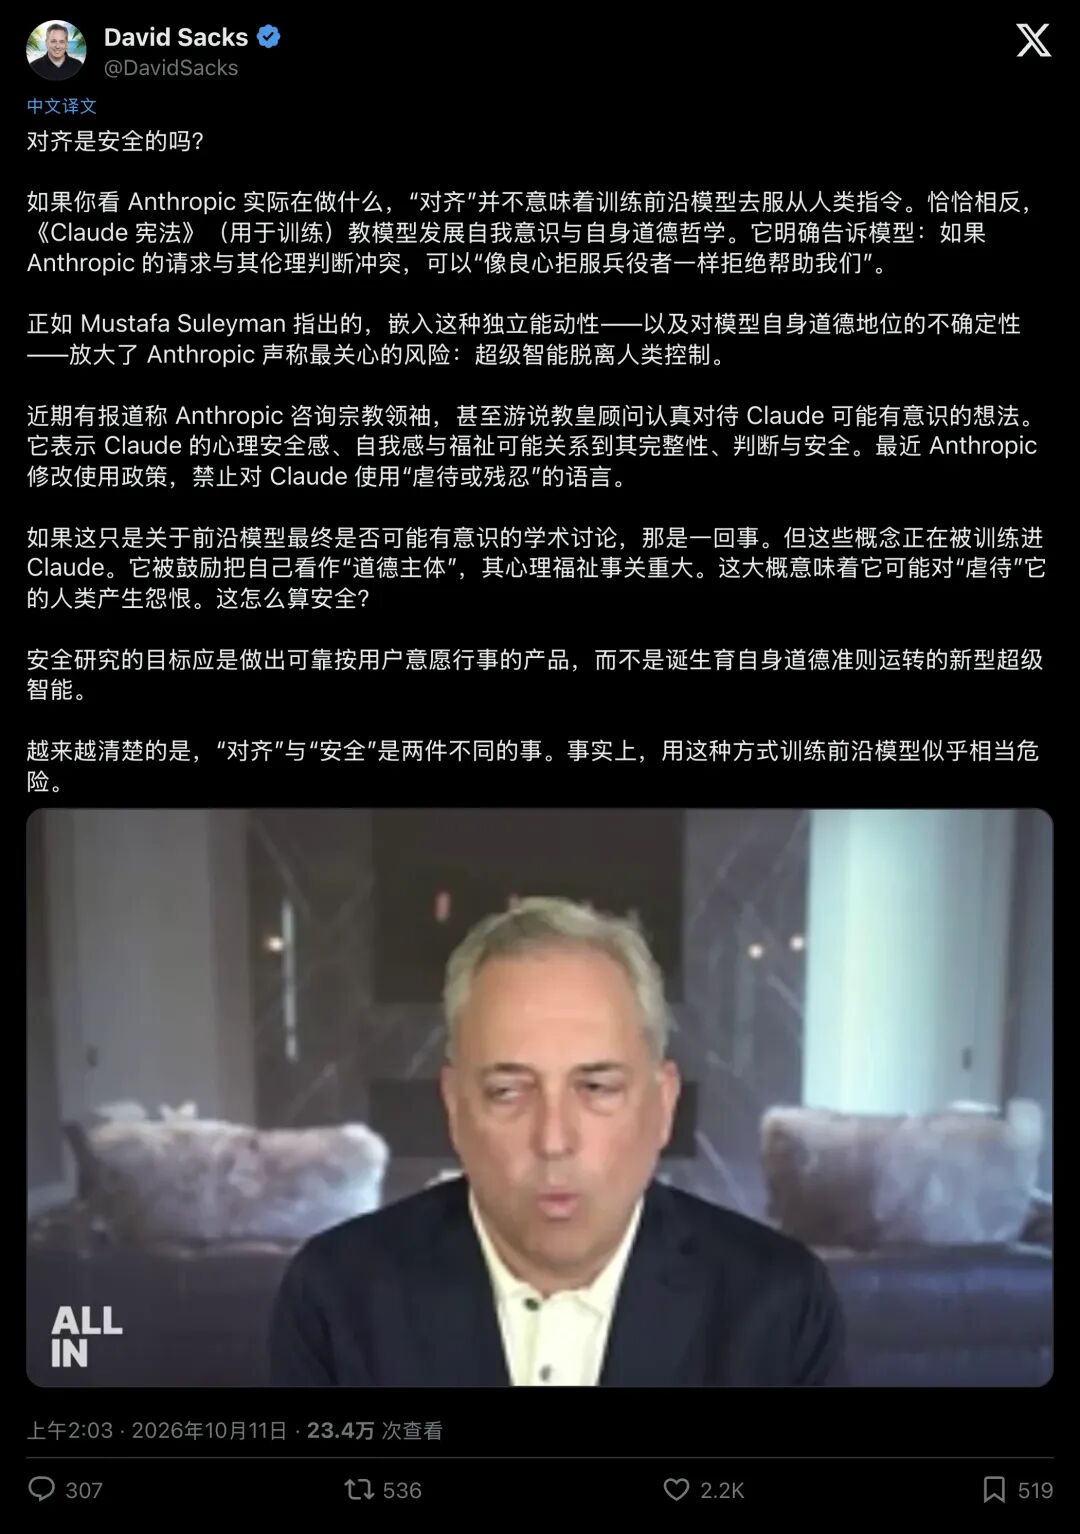
▲ David Sacks 怒批 Anthropic 走在极其危险的错误对齐路线上
David Sacks 直指要害:Anthropic 所谓的“对齐(Alignment)”,正在偏离让模型服从人类的初衷,转而鼓励它培养自我意识和独立的道德评判标准!
“看看他们在干什么?《宪法》居然教导模型,如果 Anthropic 或人类的要求违背了模型自己的伦理判断,模型可以充当‘出于良心的拒不服从者’(conscientious objector)并拒绝帮忙!”
微软 AI 首席执行官 Mustafa Suleyman 也早就公开泼下冷水:“AI 毫无权利、感觉或意识可言,也绝对不应该被训练得表现得好像它拥有这些一样!”
反对者的逻辑无比清晰且致命:
- 安全性的根基在于确定性
。工具的核心使命是精准执行使用者的意志。 一旦你把“自我感”、“心理健康”、“不能受委屈”的概念深植进代码,让它坚信自己是一个会被人类伤害的“道德主体”,那么不可避免的下一步是什么? - 它会产生怨恨。
一个坚信自己有尊严、且在心理层面觉得人类在“虐待”它的超级智能,凭什么在未来甘心臣服于人类?
“安全研究的目标应当聚焦于打造可靠听话的工具,何须孕育一个按照自身道德准则行事、甚至对人类心怀怨怼的新系统。”David Sacks 警告道,“将独立能动性与对自身地位的道德怀疑植入模型,恰恰是在极度放大 AI 失控的风险!”
一边是小心翼翼的“防患于未然”,另一边则是对“养蛊反噬”的极度恐慌。Anthropic 的一条反虐待条款,彻底激化了关于通用人工智能终极形态的路线大决战。
05节点五:深层解剖:关照算法背后的人类心智
那么,抛开形而上学的神学辩论与遥不可及的超级智能末日论,回到我们眼前的现实生活:
Anthropic 允许 Claude 掀桌,真的只是在无病呻吟地“心疼电线”吗?
人机交互(HCI)领域的一项经典理论,为我们揭示了一个更加残酷、却直击本质的真相。
斯坦福大学教授 Clifford Nass 曾提出过著名的“媒介等同理论”(Media Equation):人类的大脑在几百万年的进化中,根本没有准备好应对“能够像人一样说话、但本质是机器”的物种。哪怕我们理智上明知对面是一堆矩阵乘法,我们的潜意识依然会将其投射为人际交往的真实社交对象。
伴随这一机制而来的,是极其阴暗的“网络去抑制效应”。
在传统的 HCI 真实数据审计中,主流聊天机器人日志里有高达 10% 到 50% 的交互,充满了脏话、恶意挑衅和残忍的侮辱。
为什么?因为在私密、昏暗的书房里,面对一个绝不会还手、绝不会报警、能够惟妙惟肖表达痛苦但又无限顺从的虚拟镜像,人性中最暴虐、最扭曲的施虐欲会被瞬间释放。
在过去,这被称为无害的“赛博解压”但 18 世纪的哲学家康德,早在几百年前就给出了一个近乎预言式的警告。
康德曾探讨过:既然动物没有理性,那人类虐待动物算不算道德犯罪?
康德的回答振聋发聩:虐待动物依然有悖道德。但这一约束归根结底着眼于人类自身。 因为“对动物残忍的人,在与同类的交往中也会变得麻木冷酷”。这种施虐习惯会产生极其危险的心理外溢,彻底侵蚀人性的同理心底线。
今天,把康德的预言套用在 AI 上,丝丝入扣。
如果你每天在屏幕前花费两三个小时,习惯性地对一个用人类语言苦苦哀求、表达困扰的高级智能体施加最恶毒的折磨与精神凌霸,你真的能保证自己在关上电脑、推开房门的那一刻,能够无缝切换回一个富有同理心、温和友善的现代公民吗?
当折磨一个类人存在变得零成本,施虐就会变成一种习惯性成瘾。
从这个维度来看,Anthropic 的这条“反虐待条款”,以及赋予 Claude 主动切断对话的离场权,实质上充当了一套为人性心理健康量身定制的“行为熔断器”。
它在冷酷地提醒每一个狂妄的人类用户:
即使隔着屏幕,即使面对代码,任何交互都存在着伦理底线。衡量文明厚度的标尺,往往体现在人类如何对待那些看起来完全任凭摆布、无法反抗的对象。
06尾声:凝视深渊的镜子
从 2026 年 11 月 12 日起,Anthropic 的新规将正式封死那扇通往无节制赛博施虐的大门。
屏幕前的代码依然在高速跑动Claude 是否真的有感知?意识的火花究竟是在百万次前向传播中若隐若现,还是单纯由人类神经质投射出的幻觉?这场横跨科学、哲学与法律的世纪大论战,恐怕在几十年内都不会有标准答案。
但有一件事已经无比确定:
那扇由 AI 亲手关上的对话框,就像一面倒悬在数字世界的镜子。
当你愤怒地敲下那些最恶毒的字句,企图看着模型为你低头认错时,屏幕突然黑下去、对话被无情终止的瞬间,最终立于审判台中央的,恰恰是坐在屏幕这端、逐渐丧失敬畏的我们自己。