ARTICLE · 1166578
Kardome Presence AI
大语言模型(LLM)的爆发,无疑将人工智能的“大脑智商”推向了前所未有的高度。
无论是在云端解答复杂的科学难题、编写精密的程序代码,还是进行深度的逻辑推理,现在的 AI 表现得就像一位无所不知的学者。
然而,一个极其尴尬的残酷现实是:一旦我们将这种强大的 AI 落地到真实的硬件设备中——无论是在智能客厅里对着电视讲话,还是在会议室里对着大屏发令——交互体验却依然极其笨拙。
在日常场景中,我们依然被迫遵循着十年前的机械规则:必须提高嗓门喊出固定的“唤醒词”(Wake Word);一旦背景音乐稍大或者有人插嘴,AI 便陷入盲区;每次对话后,还要经历数秒令人窒息的云端传输延迟。这种“云端大脑万能,端侧交互低能”的巨大落差,让无数用户对所谓的“语音助手”失去了耐心。
智力明明已经飞跃,为什么设备依然显得不够聪明?问题究竟出在哪里?前沿语音AI创新厂商 Kardome 提出了关于“上下文感知语音 AI(Context-Aware Voice AI)”,彻底拆解了这一困扰人机交互(HCI)多年的核心瓶颈。
AI不缺智力,缺的是“存在感”(Presence)
当前的语音 AI 难以融入人类自然流畅的对话,其根本症结并不在于云端大模型缺乏逻辑推理能力,而在于设备端的 AI 在物理世界上完全缺乏必要的“存在感”(Presence)。
传统设备端的语音 AI 长期处于一种“失明且失聪”的状态。它就像一个陷入深度昏迷的患者,只有在被唤醒词强制“电击”后,才能短暂地接收一段孤立的语音指令。
它无法感知物理环境中的声场变化,也无法理解设备正在发生什么。这种无状态(Stateless)的交互模式,直接构成了现阶段 AI 的三大原生缺陷:
必须被显式提示/唤醒(No presence until explicitly prompted):AI 无法自主感知对话的起始,完全处于“叫一下、动一下”的被动应答状态。
缺乏环境音场上下文(No ambient context):AI 无法识别声音来自哪个方向、谁在说话、周围是否存在电视杂音或风噪等复杂声场环境。
缺乏设备操作上下文(No operational context):AI 盲目接收语音文本,却对设备屏幕当前播放的内容、软件处于何种运行状态一无所知。
因为缺乏对环境与设备状态的持续感知,AI 无法在人类需要时实现“心领神会”的无缝对接。“AI 极其出色,但它依然缺乏存在感。”
为什么“全盘依赖云端”是一条走不通的死胡同?
既然设备本地缺乏感知能力,能否通过“把设备采集到的所有音频与环境数据,24小时不间断实时传输回云端”来解决问题?答案是:完全行不通。
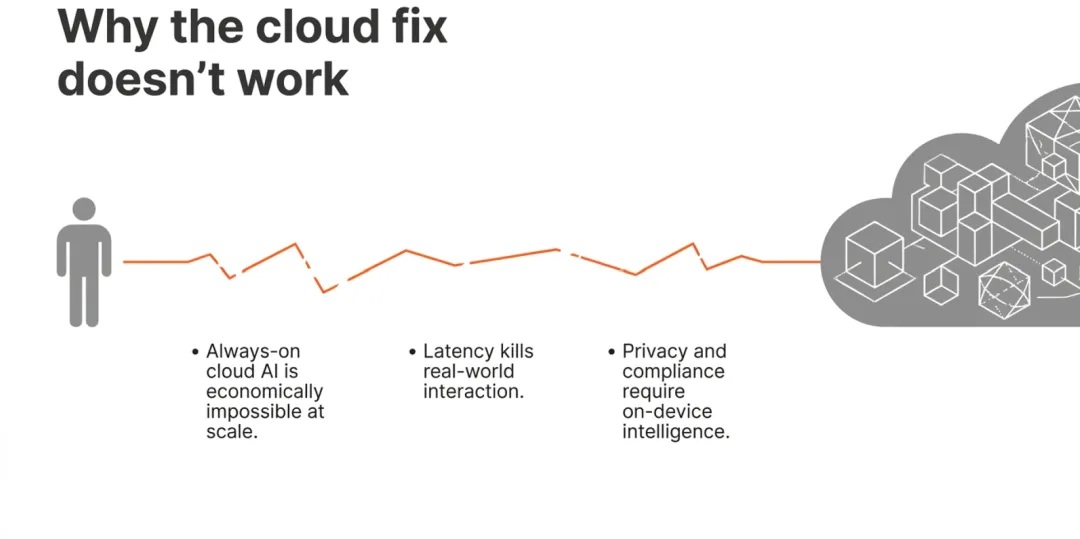
将“永远在线(Always-on)”的感知任务全盘寄托于云端,在真实物理世界中面临着三座无法逾越的死胡同壁垒:
经济成本(Economically impossible at scale):让亿万级别的消费级终端设备保持 24/7 不间断的云端音频流传输与实时模型推理,其产生的带宽与云端算力成本在商业规模化推广时是不可承受的。
交互延迟(Latency):数据在本地与云端之间的往返传输(RTT),不可避免地带来数百毫秒甚至秒级的延迟。在真实的人际交互中,超过 200 毫秒的停顿就会彻底摧毁自然流利的对话节奏。
隐私与合规(Privacy and compliance):将用户家庭或办公室的环境背景音无间断上传至云端,严重触犯了全球严苛的数据隐私法规(如 GDPR),这倒逼设备必须在本地实现设备端智能(On-device intelligence)。
因此,单靠云端加码无法突破交互体验的墙角,真正的破局点必须落在边缘端(Edge)。
未来语音AI的终极形态——边缘“系统1”与云端“系统2”的分工
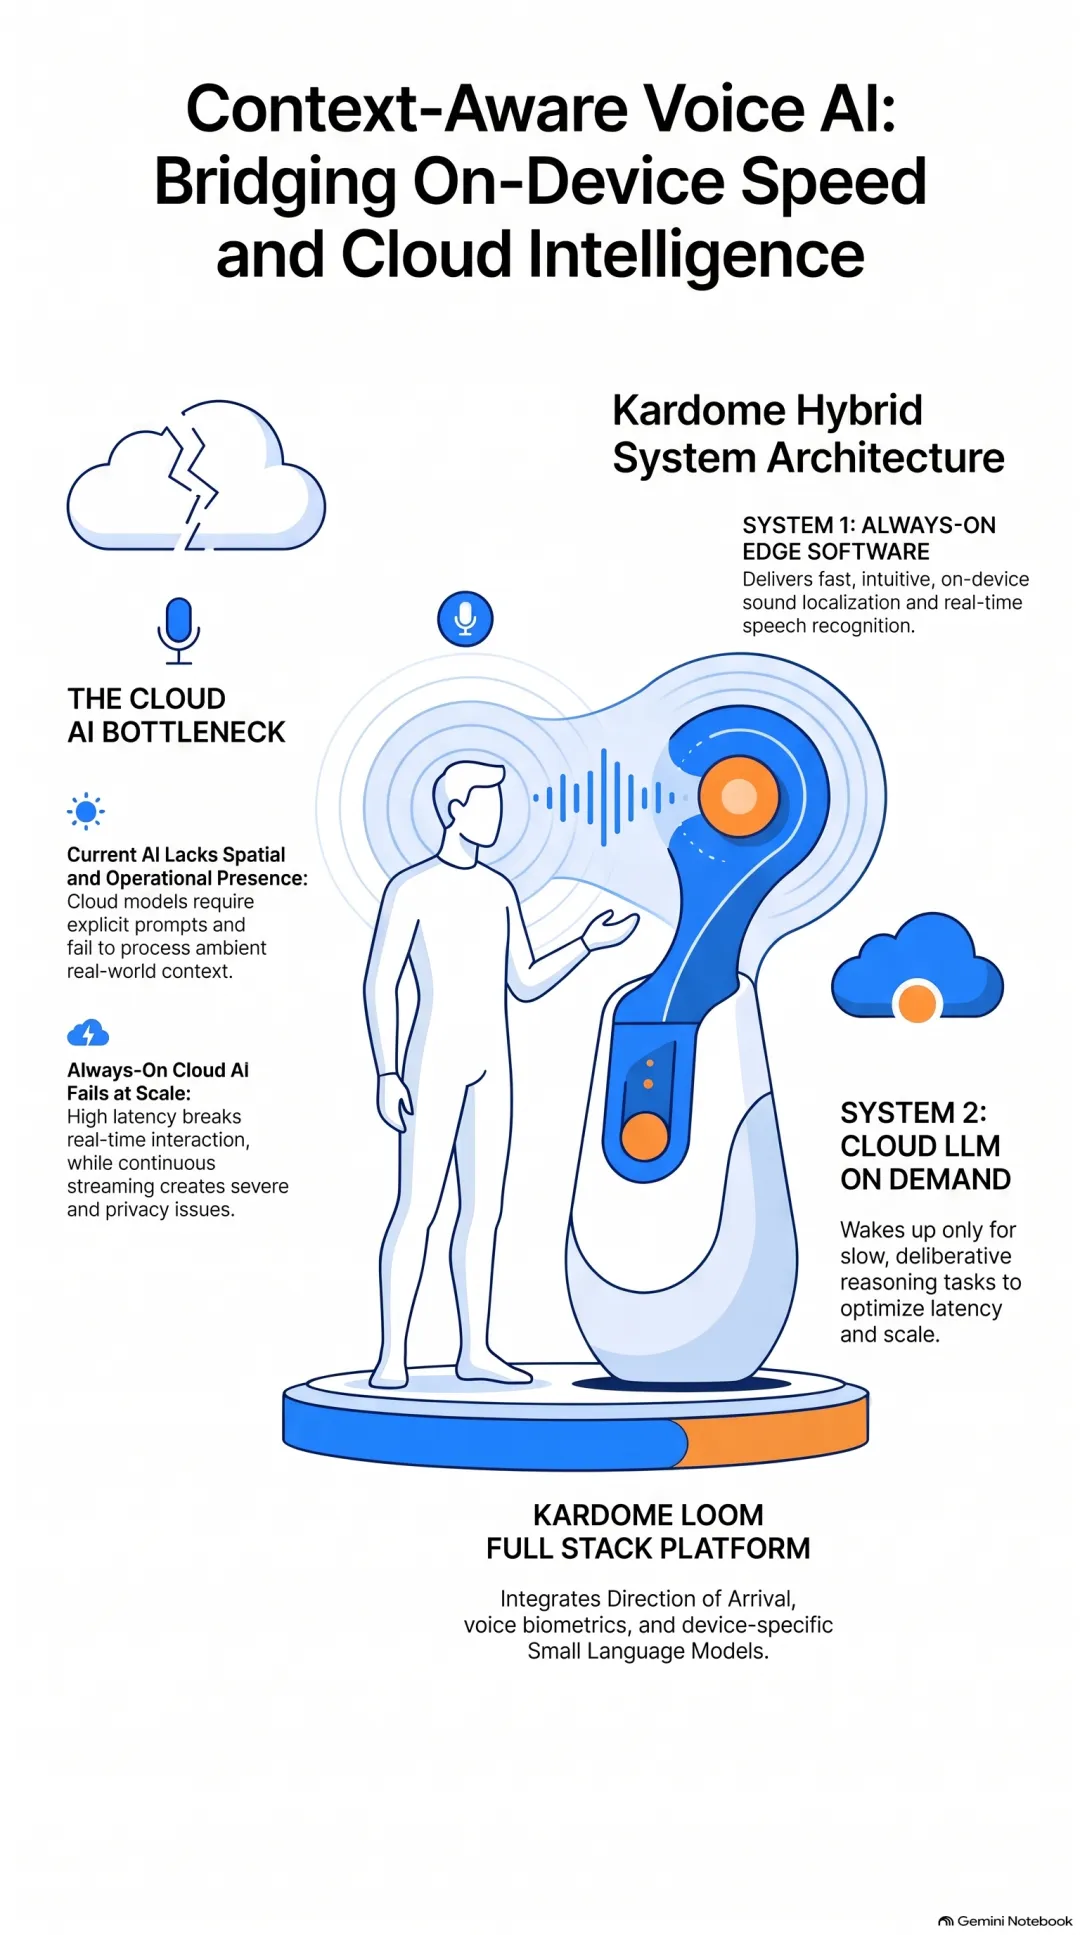
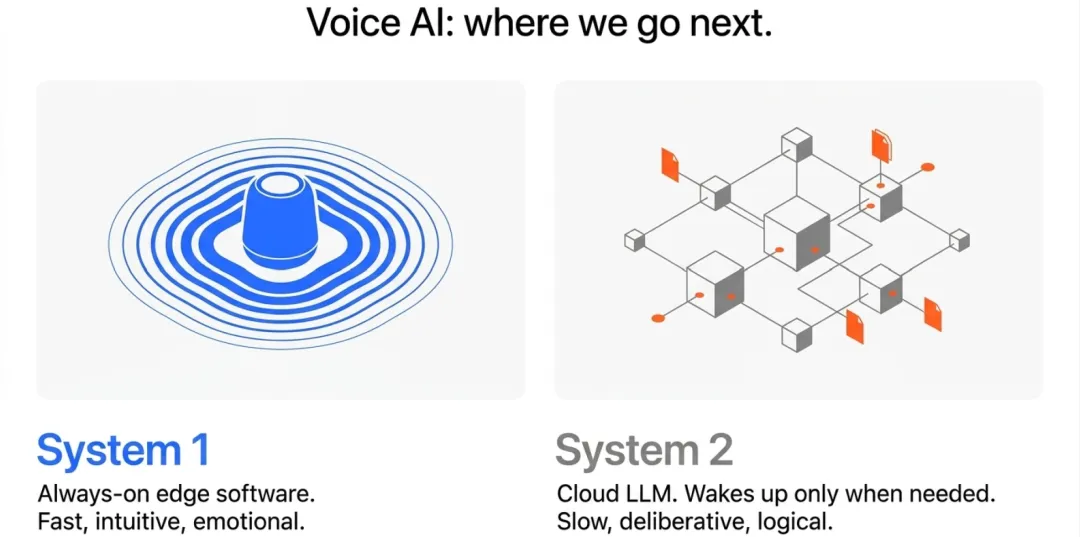
针对这一挑战,Kardome 提出了借鉴人类大脑双系统思考机制的全新架构(System 1 & System 2),为未来的语音 AI 明确了演进路径:
System1:快速、直觉化、情感化(Fast, intuitive, emotional),实时提取声场环境上下文、捕获音色与情感微态、感知设备操作状态
System2:慢速、深思熟虑、逻辑化(Slow, deliberative, logical),处理高阶逻辑推理、长文本生成、复杂知识库检索
在此架构中,边缘“系统 1”承担着极其关键的防护门禁与环境感知角色。
之所以具备“情感化(Emotional)”特质,是因为设备端模型能在零延迟的情况下,实时捕捉说话者的语调变化、情绪起伏以及声源方位,并结合设备当前状态完成即时响应;只有当遇到需要深思熟虑的复杂难题时,才会去唤醒云端“系统 2”。
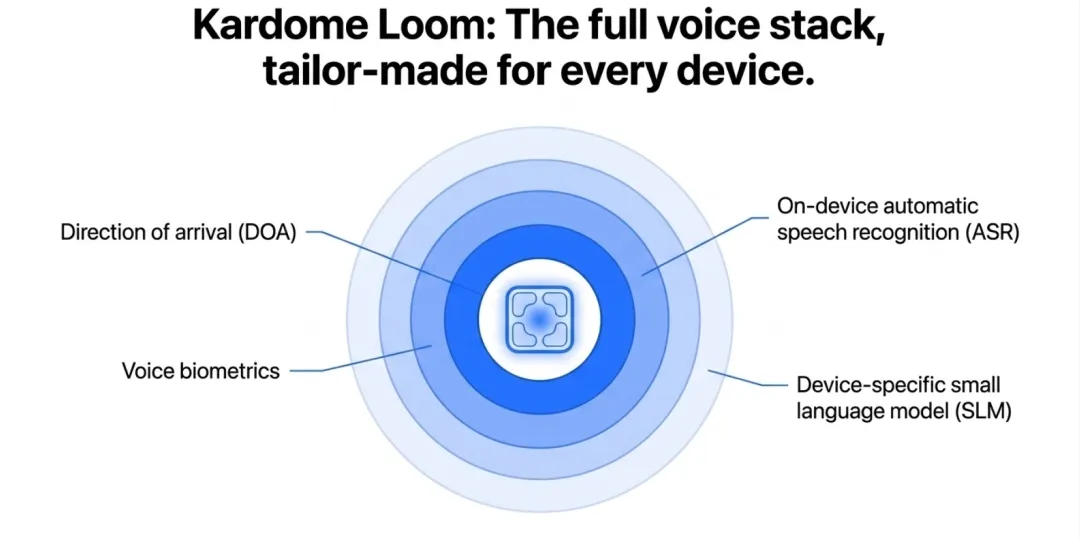
Kardome Loom 平台应运而生。作为一个全栈式开发与部署平台,Kardome Loom 将环境音场上下文、语音理解、设备操作上下文与端侧实时语音 AI 模型完美融为一体:
量身定制端侧全语音栈:为每一台硬件设备提供定制化的本地语音栈(Full voice stack on-device)。
快速部署(Fast to deploy):能够极其敏捷地实现并适配于任何硬件设备平台。
赋能生产力(Supercharges human productivity):通过极速的本地响应与深度情境理解,从根本上释放人机协作的效率。
真正的“上下文感知”如何在真实场景中发威?
当边缘端“系统 1”赋予了设备真正的上下文感知能力后,语音交互将告别机械的命令行模式。以下两个真实场景,直观展示了这种体验上的飞跃:
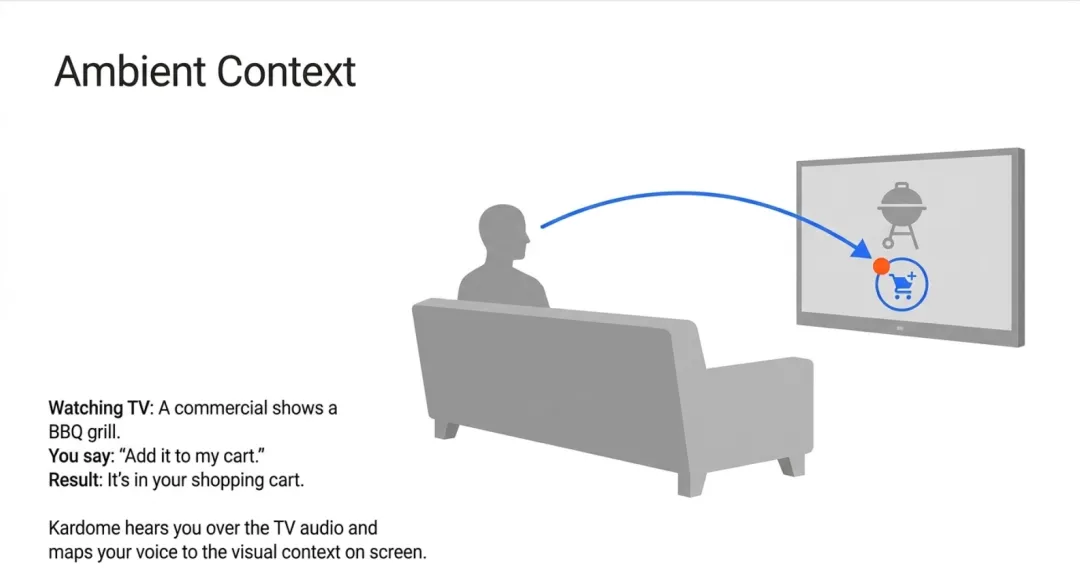
场景一:家庭电视与边看边买
指令: “把它加入购物车”结果: 目标商品(烧烤架)成功加入购物车 \rightarrow 技术原理: 人声与电视背景音的高精度声场分离 (Ambient Context) + 电视屏幕当前播放内容及元数据关联 (Operational Context)
技术深度拆解:以往电视正在高音量播放广告时,用户说话很容易被电视声音掩盖;且 AI 根本不知道代词“它”指的是什么。Kardome 解决了双重难题:后台技术首先在声场层面将用户人声从高分贝的电视背景音中精准剥离(环境上下文),同时直接读取电视屏幕当前正在播出的烧烤架(BBQ grill)广告信息(操作上下文),从而瞬间完成准确加购。
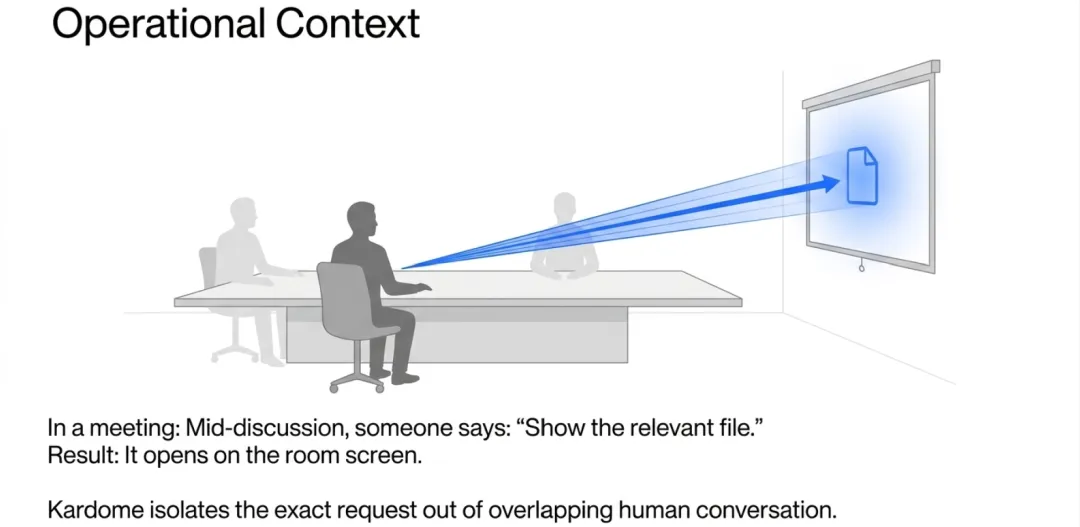
场景二:多人会议室协作
指令: “显示相关文件”结果: 会议室大屏精准打开正在讨论的对应文档 技术原理: 多人嘈杂交谈中的定向人声提取 (Directional Voice Extraction) + 会议软件当前工作区运行状态匹配 (Operational Context)
技术深度拆解:在多方热烈讨论的会议室中,环境充斥着交谈声与噪音。Kardome 能够在纷乱嘈杂的声场中,锁定特定发言人的声音方向并提取出有效的操作指令,同时联动会议软件当前正在讨论的议题状态(操作上下文),直接在公用大屏上调出目标文件,无需中断会议节奏。
通过“环境音场”与“操作状态”的双重结合,设备从“被动接收明确指令”升级为“真正结合情境理解意图”。
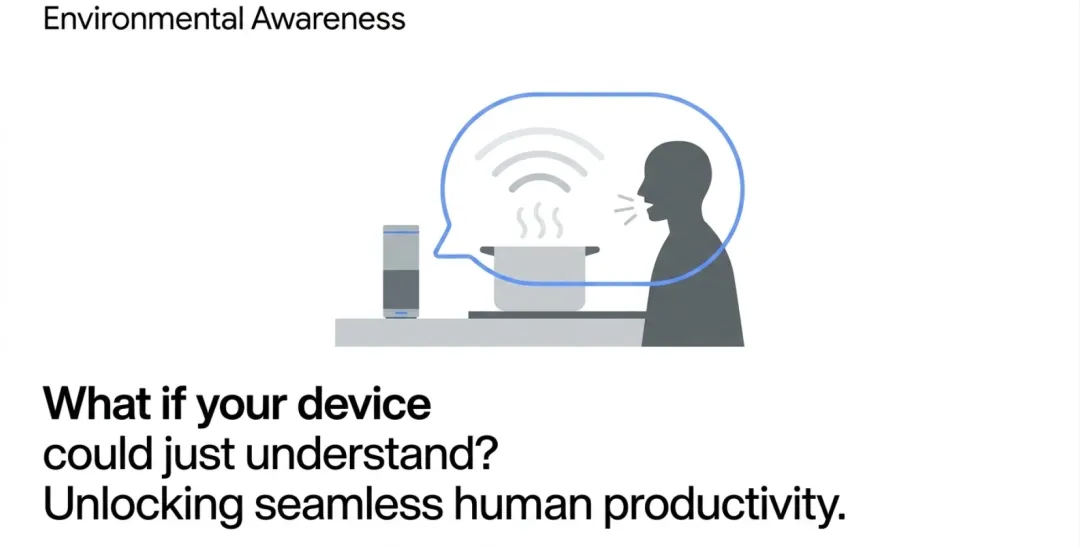
当设备真正“懂”你之后...
人机交互的终极理想,是让技术隐形。
过去二十年里,人类一直在被迫学习机器的规则——记忆繁琐的唤醒词、在安静环境下机械发令、忍受卡顿与理解偏差。
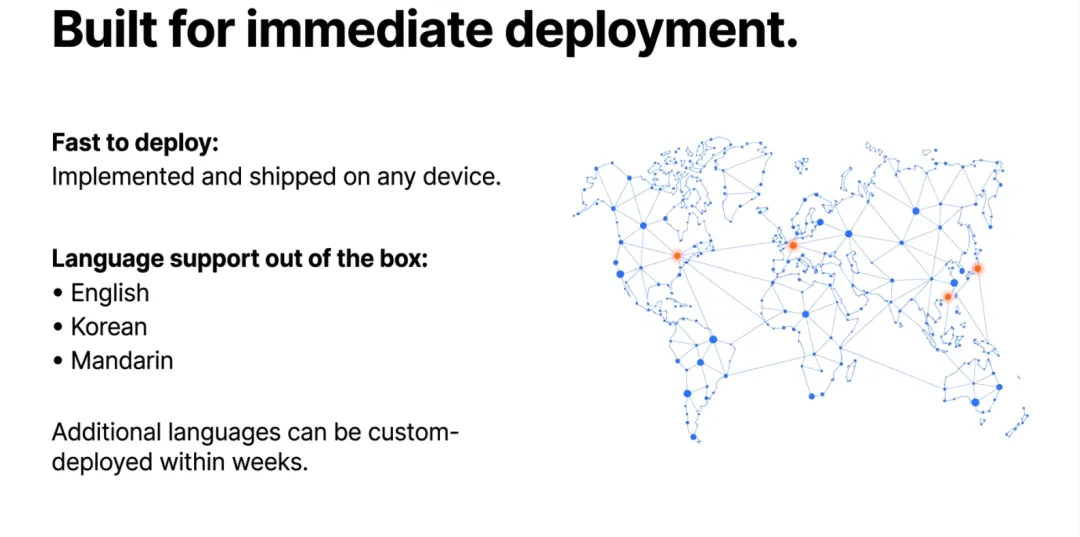
随着边缘计算能力的增强与 Kardome Loom 这类平台的推进,语音 AI 正在经历一场根本性的范式转变:通过将边缘端灵活、敏捷的“系统 1”与云端深邃的“系统 2”有机结合,设备终于拥有了感知周围物理世界与操作情境的“存在感”。
当未来的每一台设备都具备了这种“懂环境、看懂状态、听懂意图”的上下文感知能力,语音助手终将摆脱那个需要频繁叫醒的“被动工具”角色,蜕变为无处不在、润物细无声的“无形助手”。
而在那一天到来时,我们或许再也不需要去刻意记忆任何唤醒词了。