ARTICLE · 1176814
AI 助手聊着聊着就失忆?先分清“上下文”和“记忆”(五步装长期记忆)
⚠️ 先说结论
我一开始也信"上下文越长,AI 记得越多"。
直到我的一个 agent 项目翻车:用户第三天回来问"我上次让你改的那个报表逻辑还在吗",它回了一句"我没有关于这个的上下文"。报表逻辑在,在昨天的会话里。昨天的事,对今天的它来说等于没发生过。
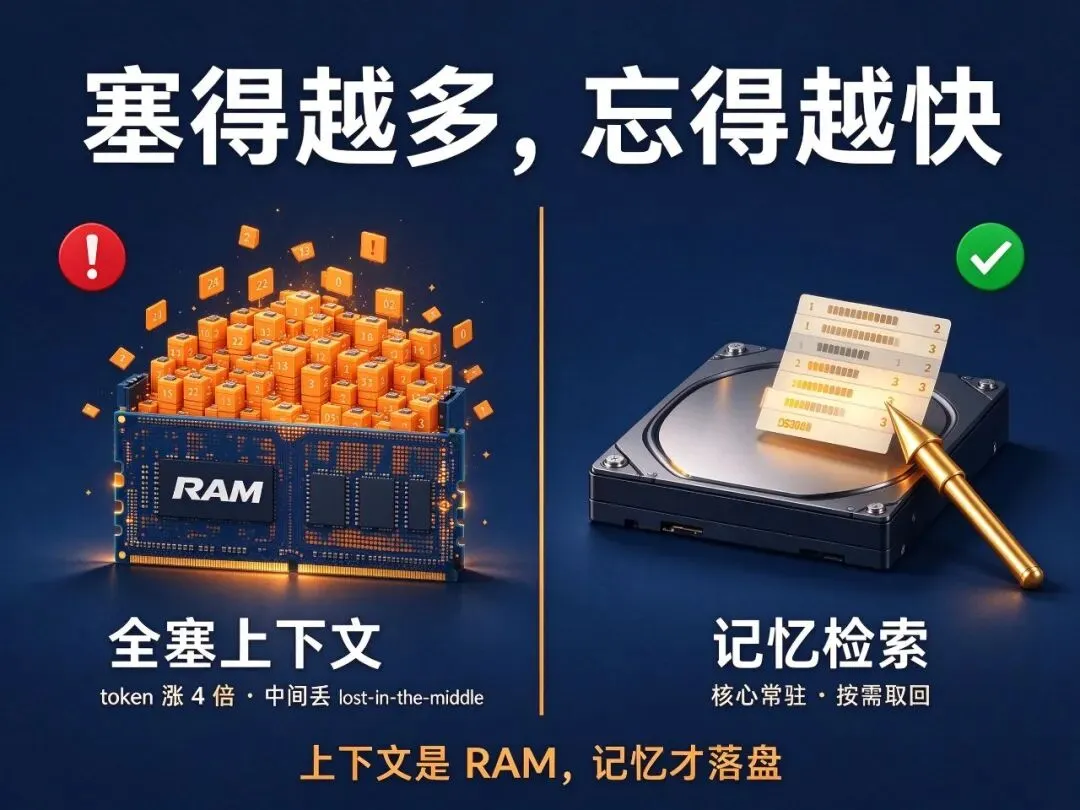
更痛的是第二件事。我图省事,把一整天的对话历史全塞进上下文喂回去。token 账单涨了 4 倍,回答质量没涨,反而开始丢三落四——中间聊的内容它想不起来了。
◉ ◉ ◉
失忆不是模型的锅,是架构的锅
先说个冷知识:模型每一轮都是"第一次见你"。
你以为它记得你,其实是 Harness(你用的框架/工具)每轮把历史拼好、重新喂回去。它记住的东西,全在这轮的上下文窗口里。窗口关掉,什么都不剩。
腾讯云一篇讲 agent 失忆的文章把这个矛盾点得很准:上下文窗口是有限的,哪怕现在主流模型几十万 token,也还是有限。而且越长越贵、越慢,还有个专有名词叫 lost-in-the-middle——研究发现模型对上下文中间部分的内容记忆最差,开头结尾记得牢,中间就糊。
所以你看到的现象是:聊得越多,它反而越"健忘"。不是模型退化了,是中间内容本来就最容易丢,你又把越来越多中间内容堆给它。
◉ ◉ ◉
上下文窗口是 RAM,不是硬盘
这是我这期最想让你带走的一句话。
- ❋
RAM:开机就在、关机就清、读写快、贵。 - ❋
硬盘:断电还在、要主动去取、便宜。
上下文窗口就是 RAM。它服务的是一次推理的"当下"。想让信息跨会话活下来,必须挪到外部存储——数据库、向量库、文件——需要的时候再检索回来。
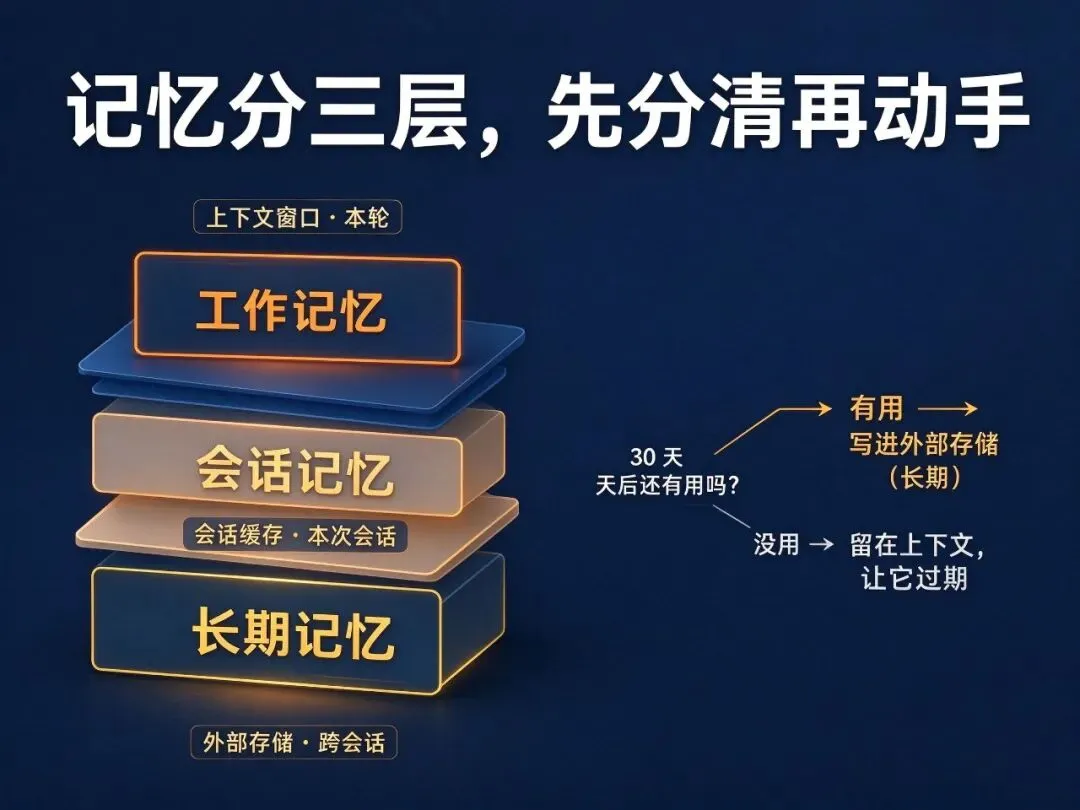
判断一条信息该不该进长期,Anthropic 官方《Effective Context Engineering》给过一个思路,我实操下来很好用:问自己,这信息 30 天后还有没有用?
- ❋
有用 → 写进外部存储,进长期记忆。 - ❋
没用 → 留在上下文里,让它过期。
还有一篇 Rohit Raj 讲记忆架构的文章用 router(路由器)做这件事:模型每轮决定哪些数据"30 天后仍重要"就送到持久层,其余留在工作记忆里等它自然消失。这个思路可以直接抄。
◉ ◉ ◉
记忆分三层,先分清再动手
做 agent 记忆,别一上来就上向量库。先把三层分清楚(CSDN 2026-10 一篇讲三层架构的文章,腾讯云 10 月初也有一篇,我综合了一下):
长期记忆里该放什么,Mem0 给过清单,我补了条:
- ❋
稳定偏好("用中文回复""预算上限 500 元") - ❋
硬约束("这个项目禁止访问外网") - ❋
跨会话事实("用户是后端工程师""上个月定了用 PostgreSQL") - ❋
从错误里学到的教训("上次这么干翻车了,这次别")
放错地方是常态:很多人把"用户随口说的一句话"当长期记忆存了,存一仓库垃圾;也有人把硬约束只写在对话里,会话一关约束就没了。
[[SEC]]
◉ ◉ ◉
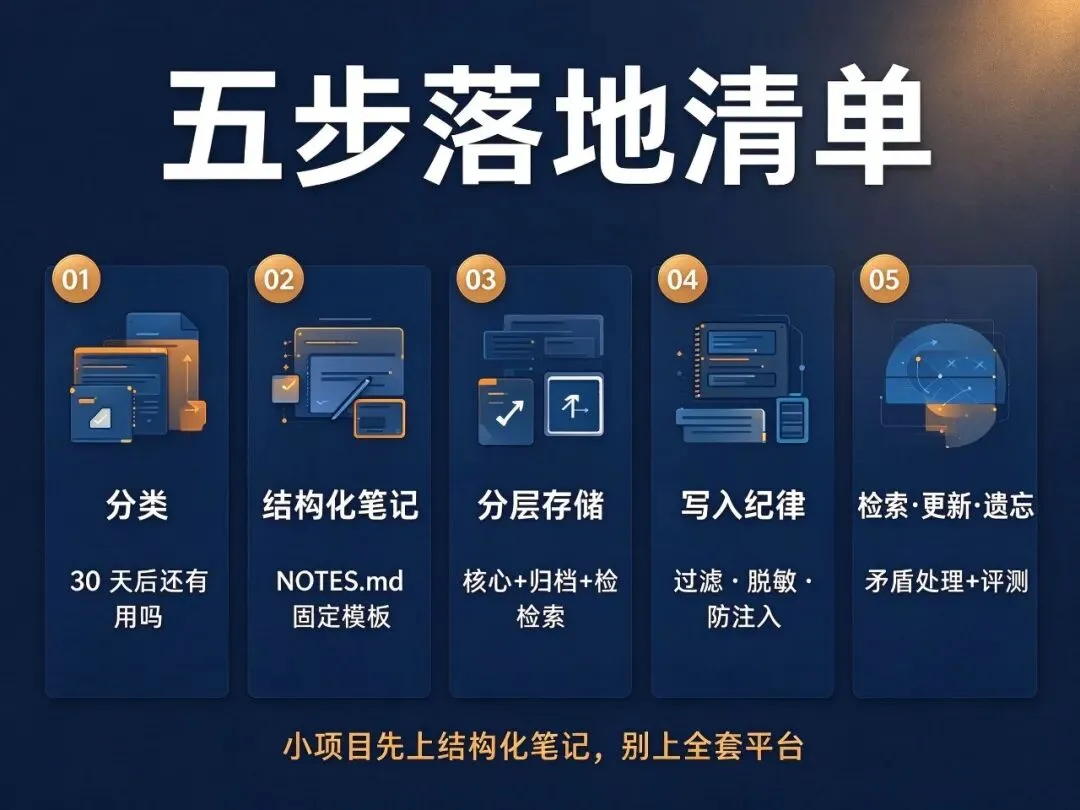
五步落地清单(照抄就能用)
01 先分类:这条信息 30 天后还有用吗
每轮结束时过一遍。有用的进长期,没用的让它过期。别把所有对话都存——那是日志,不是记忆。
02 结构化笔记起步,成本最低
Anthropic 官方推荐的做法:让 agent 定期把关键状态写成笔记,存到上下文窗口外面,需要时再读回来。Claude Code 就是靠 CLAUDE.md + 自动记忆这么干的。
踩了个坑:笔记一定要结构化。我一开始让 agent 自由写,结果它写出一堆"今天讨论了 X,感觉很有收获"的水话,检索时全是噪音。后来固定模板:决策/事实/约束/待办 四段,每个条目一行,可检索性立刻上来了。
03 分层存储:核心块 + 归档 + 检索库
- ❋
核心块(Core Memory):最关键的 5-10 条事实,每轮都带,常驻上下文。Letta 叫 Memory Blocks。 - ❋
归档(Recall):完整会话历史,可搜索,不常驻。 - ❋
检索库(Archival):向量索引或结构化库,存文档和长期知识,按需检索。
MemGPT(现改名 Letta)就是把这三层做成了"操作系统":上下文窗口当 RAM,外部存储当磁盘,agent 自己调用工具在两层之间搬数据。它在 PyPI 上的 0.15.0 版本明确支持这种分层 + agent 自编辑记忆。
04 写入纪律:过滤、脱敏、防注入
这是最多人忽略的一步,也是最贵的教训。
记忆文件会被原样读回上下文——Claude 官方 Cookbook 明确警告过:记忆文件是 prompt injection 的潜在载体。如果记忆里被写进了恶意指令,下次读回就是一次注入攻击。三个动作:
- ❋
写之前过滤(write-path filtering):可疑模式先拦掉。 - ❋
敏感数据脱敏:PII 别进记忆库。 - ❋
作用域隔离:每个用户/项目一套记忆,别混。
我亲测:不设隔离的话,A 用户的数据可能被 B 用户的会话检索到。这问题一旦上线才被发现,比失忆痛多了。
05 检索与更新:记忆会过期,要维护
长期记忆不是存完就完。三件事:
- ❋
检索:需要时按语义相似度取回相关片段,不是全量塞回。 - ❋
更新:事实变了要能改。矛盾处理(contradiction handling)是 arXiv 2603.07670 这篇记忆综述点名的难点——新旧事实冲突时听谁的? - ❋
遗忘:没用的删掉。故意不删的后果是:记忆库里全是"用户两年前随口说的一句话",检索噪声越来越大。
评测也别忘:LongMemEval、LoCoMo、PersonaMem v2 这几个基准就是干这个的(arXiv 2603.04814 用它们对比过"记忆系统 vs 长上下文模型")。
◉ ◉ ◉
工具选型:别一上来就 MemGPT
先说结论:小项目先上结构化笔记,别上全套记忆平台。
坑:Letta 让 agent 自己管理记忆,透明,但 Hivebook 对比过:这种 agentic 方式在基准上更慢、未必更准——每次读写记忆都多一次模型调用,账要算清楚。
[[SEC]]
◉ ◉ ◉
反方:三句话泼冷水
- ①短会话别折腾
。一次性的 demo、一问一答的小工具,上下文窗口够用,记忆系统是纯负担。 - ②大窗口也能打
。arXiv 2603.04814 实测:长上下文 GPT 在部分记忆基准上能和专门的记忆系统打平——如果你的场景就是"近几轮对话",大窗口+摘要可能就够了。记忆系统值得上的场景是"跨会话、跨天、要积累"。 - ③记忆是注入面
。记忆文件读回上下文就是一次潜在注入,安全投入别省(可能是 X,需进一步验证,但官方文档已明示风险)。
你的 agent 出过"失忆"事故吗?是怎么解决的——硬塞上下文、上向量库、还是干脆换大窗口?评论区聊聊,我在收集真实翻车案例。
💡 事实与阈值来源(核验)