ARTICLE · 1179184
AI前源 AI|Muse Wonder来了,AI会自我进化吗?
OCT 14 2026 · FEATURE · 11 MIN
AI前源 AI
模型 · 评测 · RSI · 路径
✳
新模型很强,但「AI 自我进化」还没有发生
本文要点 · KEY POINTS
01 Muse Wonder:AA 指数 52 / 56,智能体任务大涨,知识类偏弱;API $4 / $20,100 万上下文,完整安全报告待发。
02 RSI:Meta 未提自我改进;OpenAI、Anthropic 均称尚未实现,AI 主要加速研发中的执行环节。
03 行动:学评测、控成本、做可靠的智能体系统,比追榜单更有用。
10 月 12 日(美国时间),Meta 超级智能实验室(MSL)发布 Muse Wonder 与 Muse Wonder Full。不少人顺势追问:AI 是否已经能「递归自我改进」(RSI),Meta 是否做到了?我们把官方材料、独立评测和各家实验室的原文放在一起,分清哪些是事实、哪些是宣传、哪些是误读。
✳ MUSE WONDER
一 Muse Wonder 到底新在哪
官方说了什么
两款模型。Muse Wonder 通过 Meta Model API 和 Muse Code 提供,定价每百万 token 输入 $4、缓存输入 $0.20、输出 $20;Muse Wonder Full 只在 Muse Code 订阅(Power / Maximum Usage)里提供,按 token 价格未公布。
规格。模型卡:输入文本、图像、视频、音频,输出文本;推理时上下文 100 万 token。官方称在 Meta 千兆瓦级 Prometheus 数据中心训练,比 Muse Spark 用了「更大、更强的基座模型」。
两个新名词。Active Memory:跨对话携带与你有关的上下文,并在相关时主动调取;Active Focus:任务变难时尝试其他路径、绕过阻碍,必要时请你澄清、重要操作前先确认。Meta 用内部的 MemoryBench、FocusBench 和第三方的 SWE-Marathon 衡量这两点。
王兆(Alexandr Wang)原话(X,10 月 12 日):这是 MSL「一年多研究与基础设施工作的结晶」,自 4 月推出 Muse Spark 以来「在预训练和强化学习上持续扩展」,「现在到达前沿」。
最值得看的一张图:泛化
Meta 博客把后训练「针对过」的任务(分布内)和「没针对过」的任务(分布外)分开画:随推理算力增加,两代模型在分布外任务上的提升斜率相近;但在同样的分布内分数下,Wonder Full 的分布外表现高于 Spark 1.3 的趋势线。Meta 的解释是更强的基座让后训练收益更能迁移。这是在正面回应「刷榜」质疑,方法值得借鉴;但所用任务集为 Meta 自选,尚无第三方复现。
独立评测怎么说(Artificial Analysis,10 月 12 日)
智能指数 v4.3:Wonder Full(max)56、Wonder(max)52,前代 Spark 1.3(max)48,两次发布只隔 6 周。最大涨幅在智能体任务:Terminal-Bench 4.0 从 33% 到 57%,GDPval-AA 从 1681 到 1857 Elo。Full 在 CritPt(33%)和 GDP.pdf(33%)排第一。
短板也写得很清楚:知识类 AA-Omniscience 只有 30 / 25,低于 Claude Opus 5.5(46)、GPT-6 Astra(43)、Gemini 4 Argon(42);但 Full 幻觉率从 33% 降到 23%。成本:Wonder(max)跑一次指数任务约 $4.52,是前代的 2.8 倍,主因是每任务约 769 万输入 token。编码智能体指数 Full 为 68,与 Claude Code + Sonnet 5.5 持平。
要区分:Meta 自称「在个人与专业智能体、记忆、编码上 SOTA」;MemoryBench、FocusBench、个人超级智能指数(PSI)都是内部评测。模型卡也写明,部分竞品成绩由 Meta 内部跑、「尽力而为」,SWE-Marathon 一行并非同一测试框架。截至 10 月 14 日,AA 榜首是 Claude Opus 5.5(max,58),Wonder Full 与另外两个 Claude 配置并列 56。
安全:模型卡称未缓解时不排除化学与生物领域达到「高风险」阈值,因此加了安全后训练和系统级分类器;网络安全与失控两类评为「中等或更低」。博客写明:完整安全报告「即将发布」。模型卡里有个细节值得学:漏洞利用测试 ExploitGym 拿到 92 个 flag,但复核发现只有 21 个走的是预设漏洞,可与公开榜单比较的是 21。Meta 也在 X 上回复:Wonder 太大且有安全顾虑,不开放权重;开放的会是 Muse Spark。
✳ 前源判断
真正的看点是三件事:MSL 用 14 个月重建技术栈后进入第一梯队;它把「记忆+坚持」当作产品卖点,押注个人智能体;以及它主动拿分布外泛化说事。没看到的:参数量、架构、训练数据和完整安全报告。
✳ RECURSIVE SELF-IMPROVEMENT
二 RSI:Meta 解决了吗?
直接回答:没有,也没有人宣称解决。我们逐字检查了 Muse Wonder 博客、模型卡、开发者博客和 @AIatMeta、@alexandr_wang 的发布帖:没有任何关于「自我改进」或「递归自我改进」的表述。它说的是扩大预训练和强化学习。模型卡的风险领域只有网络安全、化生和失控,没有单列「AI 研发自动化」。唯一沾边的一句是:未来会用 Muse Wonder 开发面向大众的专门模型,这是常见的蒸馏或数据合成,不是 RSI。
什么是 RSI
AI 系统改进自己(或设计、训练下一代),新一代又更擅长做这件事,循环往复。1965 年 I. J. Good 在《Speculations Concerning the First Ultraintelligent Machine》中提出「智能爆炸」:第一台超智能机器能设计更好的机器,因此是「人类最后一项发明」。2000 年代 Eliezer Yudkowsky 用「种子 AI」「FOOM」讨论快速起飞;2014 年 Nick Bostrom 在《Superintelligence》里系统分析了起飞速度与控制问题。
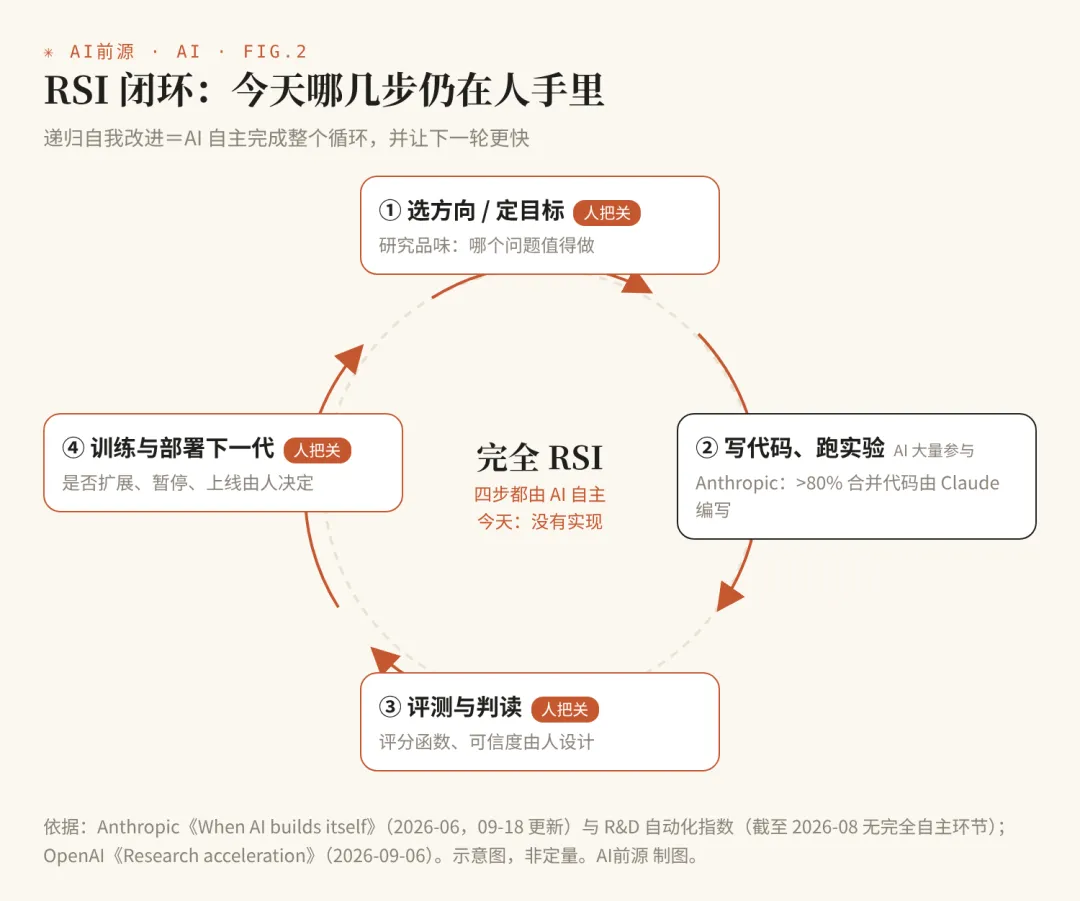
图2 RSI 闭环:今天哪几步仍由人把关(各实验室公开材料,AI前源 制图)
它不是什么
自我对弈(AlphaGo Zero,2017):在固定规则的游戏里自己和自己下,提升的是下棋策略,不会改写自己的训练方法。可验证奖励强化学习(RLVR,如数学、代码答案能自动判分):模型在人设计的训练流程里变强。合成数据与蒸馏:大模型给小模型出题。这些都是「用 AI 训练 AI」,但目标、方法、评测和是否部署仍由人决定;RSI 指的是 AI 自己接管这些环节并持续加速。
现在走到哪一步
OpenAI(9 月 6 日):按自身测量,已实现 9 月「自动化研究实习生」目标,即在人类指导下完成熟练研究员需数天的明确任务;8 月中旬研究部门每个人类工作日对应 3.1 个智能体工作日;目标 2028 年 3 月做出自动化 AI 研究员。原文:「我们还不知道如何安全地走到对齐的、完全的 RSI。」
Anthropic(6 月「When AI builds itself」,9 月 18 日更新):「我们还没到那一步,RSI 也并非不可避免」;2026 年 5 月合并代码中超过 80% 由 Claude 编写;Mythos Preview 在固定训练代码提速任务上达约 52 倍(Opus 4 约 3 倍)。它也说明:在「选择目标」上仍有很大差距。9 月的 R&D 自动化指数原型称 Claude「主导」约 26% 的研发工作,没有完全自主的部分;Anthropic 也承认评级由 Claude 自己当裁判,需第三方核验。
Google DeepMind(2025 年 5 月 AlphaEvolve):Gemini 驱动的进化式编码智能体,找到 4×4 复数矩阵乘法 48 次标量乘法的方案,为 Google 回收约 0.7% 的全球算力,并把 Gemini 训练中一个内核提速 23%,整体训练时间缩短 1%。这是 AI 改进 AI 基础设施的实例,但评分函数由人写。
Meta 自己(10 月 2 日,@AIatMeta):研究者与 Muse Spark 合作,在概率、群论、微分方程等 6 个数学问题上取得结果;例如群论一例由 Spark 生成搜索代码找到反例,团队验证并完成证明。这是 AI 辅助科研,不是 AI 改进自身。
METR:50% 成功率下能完成的任务长度,2019–2025 年约每 7 个月翻一番;新版 TH1.1 估计 2024 年以来约 89 天翻一番。METR 同时提醒置信区间很宽,16 小时以上的测量不可靠,「时间跨度翻倍不等于自动化程度翻倍」。
一把可用的尺子:Anthropic 采用 Epoch AI 的自动化等级 AL0–AL5。AL3 是「协作」,AI 在人密切指导下完成大块工作;AL4 是「主导」,AI 从高层指令出发端到端完成、人监督;AL5 才是完全自主。按这把尺子,RSI 要求研发闭环的关键环节都到 AL5,目前公开数据中没有任何一家到达。
✳ 前源判断
更准确的说法是「AI 辅助 AI 研发正在加速」:执行层大量自动化,选题、评测、是否部署仍在人手里。值得关注的是前沿实验室开始公开测量这件事,OpenAI 还主张各家应被要求公开 RSI 进展。
✳ MODELS & CAPABILITIES
三 模型与能力怎么区分
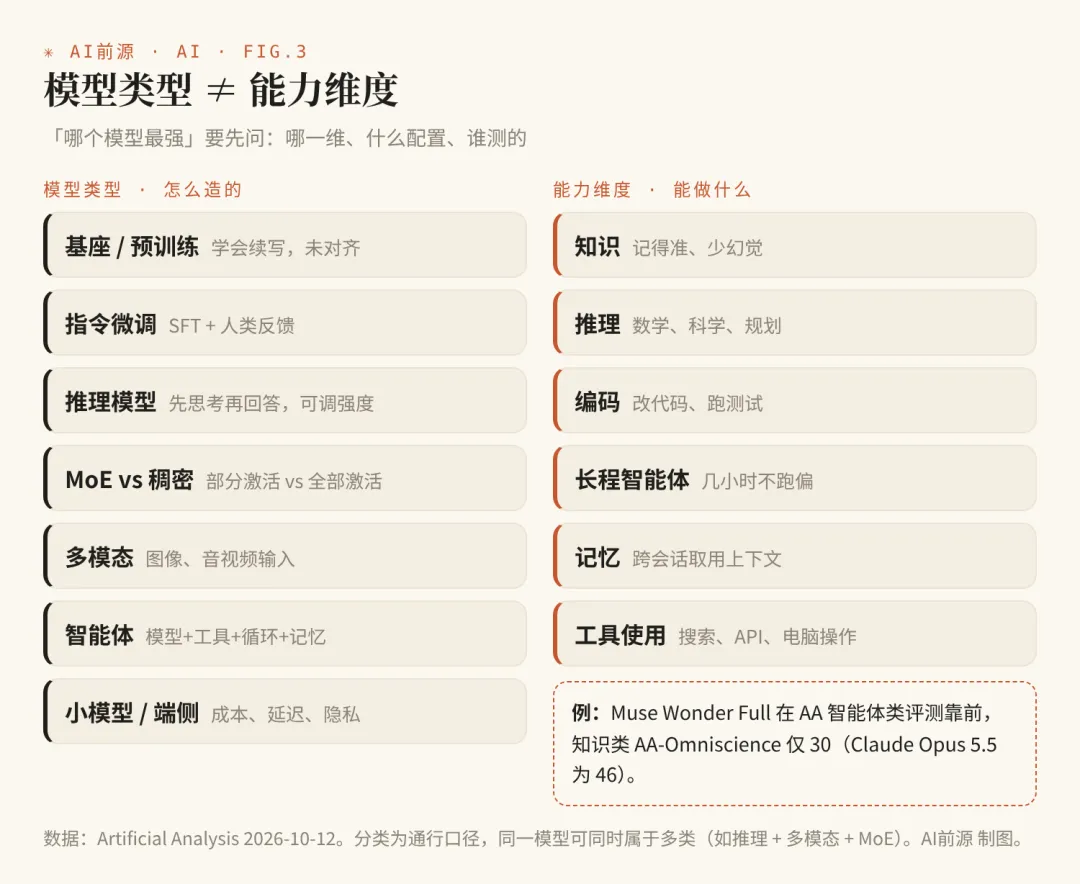
图3 模型类型与能力维度(AI前源 制图)
基座 / 预训练模型只学会「续写」;指令微调(SFT+人类反馈)让它听懂指令;推理模型在回答前生成长思考链,用 RL 在可验证任务上训练,可调「推理强度」;MoE 与稠密:混合专家每个 token 只激活部分参数,总参数大、单次计算省,稠密模型每次全部参与;多模态能读图像、音视频;智能体=模型+工具+循环+记忆,能多步执行;小模型 / 端侧为成本、延迟和隐私而做。
能力维度至少六个:知识(记得准不准、会不会编)、推理、编码、长程智能体(几小时不跑偏)、记忆、工具使用。Muse Wonder 恰好说明它们不是一回事:智能体分数领先,知识题却落后。
基准测试怎么运作:固定题集+固定评分方式,评分可以是自动判分、单元测试、LLM 裁判或两两对战的 Elo。综合指数再把多项测试合成一个数,例如 AA 指数 v4.3 合并了 GDPval-AA、Terminal-Bench 4.0、SciCode、AA-Omniscience、Humanity’s Last Exam 等 10 项、由 AA 独立运行的评测。
看榜单的四个坑
1 污染:题目进了训练数据。2 饱和:SWE-bench 两年内从个位数到接近满分,区分度消失。3 配置:同一模型 max 与 low 推理强度、不同测试框架差距很大,看清括号。4 自报:厂商常挑有利指标、自己跑竞品。用法:看独立机构,看成本和 token 用量,最终用自己的任务做小评测。
前沿模型对照(截至 10 月 14 日)
AA 指数=Artificial Analysis Intelligence Index v4.3,第三方独立运行,不同推理强度分数不同。*Gemini 4 Argon 为优惠价,11 月 30 日后为 4 / 20。价格与发布日期取自各家官网;「SOTA」「最强」等为厂商自报,未列入表格。
✳ HISTORY
四 七十年,一张时间线
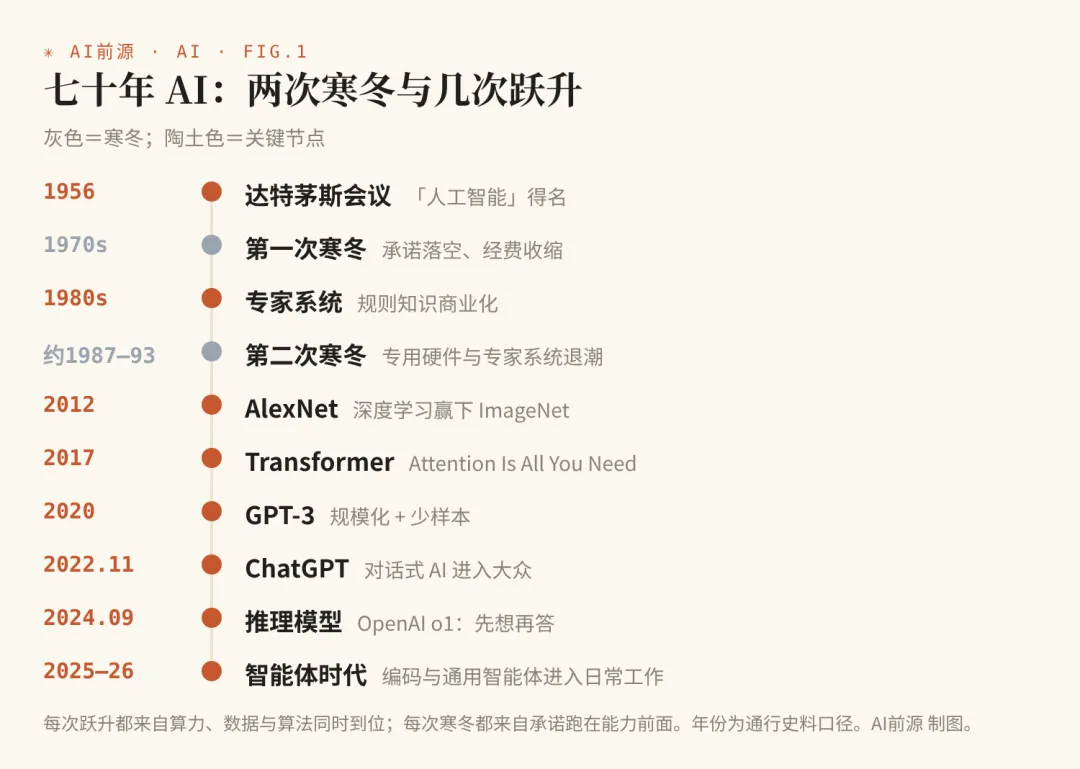
图1 AI 简史:从达特茅斯到智能体(AI前源 制图)
1956 达特茅斯会议命名「人工智能」→ 1970 年代中第一次寒冬(承诺落空、经费收缩)→ 1980 年代专家系统商业化 → 80 年代末至 90 年代第二次寒冬 → 2012 AlexNet 让深度学习在 ImageNet 上胜出 → 2017 Transformer(《Attention Is All You Need》)→ 2020 GPT-3 展示规模化与少样本学习 → 2022 年 11 月 ChatGPT → 2024 年 9 月 OpenAI o1 开启推理模型 → 2025–26 编码与通用智能体走向日常工作。规律:每次跃升都来自算力、数据和算法同时到位,每次寒冬都来自承诺跑在能力前面。
✳ OUTLOOK
五 往后看:乐观、怀疑与路标
乐观:Anthropic 认为「趋势停滞」可能性不大,「还没看到曲线弯下来」;OpenAI 认为自动化研究也可以用于对齐研究。
怀疑:METR 2025 年 7 月的随机对照试验发现,资深开源开发者用当时的 AI 工具完成任务反而慢了 19%,而他们事后仍以为快了约 20%(METR 已注明该结果过时,并于 2026 年 2 月发布新数据);Anthropic 自己也承认「代码行数」高估效率、员工自评可能偏高,并写下曲线可能是 S 形、瓶颈可能在算力与电力;它还援引阿姆达尔定律:一个环节变快,整体速度会被没变快的环节卡住,眼下人工代码审查已成新瓶颈。据 The Neuron 报道,OpenAI 首席科学家 Jakub Pachocki 认为,没有一家实验室已把对齐和监控做到足以「长期全速扩张」的程度。
五个路标:① Meta 完整安全报告是否发布、是否涉及 AI 研发风险;② METR 或同类机构新任务集上的时间跨度;③ OpenAI 2028 年 3 月目标的中途进展是否沿用同一指标;④ Anthropic R&D 自动化指数中「完全自主」是否从零变为非零;⑤ 价格:Argon 优惠期结束后与 Wonder、Opus 同为 $4 / $20,成本竞争如何演变。
✳ FOR BUILDERS
六 想做 AI 工程师 / FDE,现在能学什么
1 先学评测。给你的业务建 30–50 条真实任务的小评测集,每次换模型先跑一遍,记录正确率、token 和成本。厂商榜单只是起点。
2 学会控成本。Muse Wonder 的例子说明:每任务成本取决于输入 token 和缓存命中,而不只是单价。练习提示缓存、上下文裁剪、按难度路由到不同模型。
3 把智能体当系统做。工具定义、权限、重试、日志、人工确认点(Meta 模型卡也建议不可逆操作加人工确认)比提示词更重要。
4 记忆要设计。存什么、何时取、怎么删、怎么让用户看见,决定个人智能体能不能上线。
5 FDE 的核心是落地。驻场工程师要把模型接进客户的数据、流程和合规要求:会读模型卡和安全条款,会写 POC,会用数据说服业务方。
6 保持一条阅读清单。模型卡、METR、Artificial Analysis 方法说明、各实验室安全框架,每月各读一篇原文。
7 本周就能做的练习。挑一个真实任务,用两家 API 各跑 20 次,记录成功率、平均 token、单次成本和失败类型,写成一页对比报告。这份报告就是最好的作品集。
✳ 前源建议
别把「AI 在自我进化」当成学习的理由或焦虑的理由。今天可执行的结论是:执行越来越便宜,判断越来越值钱;学会定义任务、评测结果、控制风险的人,最不容易被替代。
来源说明
本文引用 Meta(Muse Wonder 博客、模型卡、开发者博客、@AIatMeta 与 @alexandr_wang 发帖)、Artificial Analysis 排行榜与 10 月 12 日发帖、Anthropic、OpenAI、Google(Gemini 4 Argon、AlphaEvolve)、METR 的原始材料,以及 I. J. Good(1965)、Bostrom(2014)等经典文献。全部链接见文末「阅读原文」。
转发与关注
觉得有用,欢迎转发给需要的朋友。点一下「在看」,或关注 AI前源。
✳ AI前源
OCT 14 2026 · AI
原创内容 © AI前源,转载请注明出处
声明:本文为公开资料的整理与分析,评测分数以发布方为准;厂商自报数据已注明。不构成投资建议。资料截至 2026 年 10 月 14 日 13:00(北京时间)。如官方后续发布更正或完整报告,以官方为准,本文将更正。